
Guide RH pour l'évaluation IA vs Humaine : Pilote 30–90 Jours + 4 Étapes TEVV
La notation par IA fonctionne bien pour les tests de compétences structurés et spécifiques à un rôle : elle évalue plus rapidement qu'une personne et aboutit à des notes moyennes très proches. Elle ne devrait pas fonctionner seule pour des décisions à enjeux élevés ou ambiguës. Les cadres de référence de la SIOP et l'approche de test TEVV du NIST existent pour une bonne raison, et des plateformes comme Talent Approved sont conçues pour associer la notation par IA à une révision humaine, et non pour la remplacer entièrement.
En bref :
- La notation par IA est la plus fiable pour les évaluations structurées telles que les tests de codage et les quiz de connaissances standardisés, où il existe des réponses clairement correctes ou incorrectes.
- Un modèle hybride combinant l'IA pour le présélection initiale et la révision humaine pour les tâches nuancées ou ambiguës offre le meilleur équilibre entre rapidité et précision.
- Les évaluateurs humains et les systèmes d'IA font tous deux preuve d'incohérences dans la notation de soumissions identiques, ce qui souligne la nécessité d'une validation et d'un suivi continu.
- Les risques de biais incluent le biais de mesure et le biais prédictif, qui peuvent être atténués grâce à des tests approfondis, à la transparence et à une conception inclusive des grilles d'évaluation.
- La conduite de petits programmes pilotes et la comparaison des scores d'évaluation avec la performance réelle au poste permettent de s'assurer que les outils d'IA sont prédictifs et équitables dans le recrutement.
Table des matières
- Comment fonctionnent la notation par IA et la notation humaine dans le recrutement
- Points forts et limites : précision, rapidité, cohérence et biais
- Validation, tests et gouvernance que les équipes RH doivent mettre en place
- Liste de contrôle pour la mise en œuvre : règles de décision et indicateurs
- Impact de la notation par IA sur la qualité des retours pour les candidats
- Des tests papier à la notation par IA : une brève histoire
- Considérations éthiques propres à la notation par IA ou par l'humain
- Pourquoi les résultats de la notation par IA sont plus difficiles à interpréter
- La notation par IA selon les rôles et les types de compétences
- Une voie pragmatique pour faire travailler ensemble la notation humaine et la notation par IA
- Prêt à piloter la notation assistée par IA ? Commencez ici
- Sources
- FAQ
Comment fonctionnent la notation par IA et la notation humaine dans le recrutement
Les outils de notation par IA évaluent le travail des candidats en le confrontant à une grille construite à partir d'étiquettes d'entraînement, de critères structurés ou d'une description de poste intégrée au système. Certaines plateformes d'évaluation par IA proposent des fonctionnalités permettant de créer en quelques minutes des évaluations et des structures de notation spécifiques à un rôle à partir des descriptions de poste, puis de générer des synthèses des performances de chaque candidat afin que les recruteurs puissent examiner les résultats sans lire chaque soumission ligne par ligne. L'avantage réside dans le débit : un tel système peut noter des centaines d'extraits de code ou de réponses écrites dans le temps qu'un seul expert en la matière en examinerait quelques-uns.
La notation humaine fonctionne différemment. Un expert en la matière applique une grille d'évaluation en faisant appel à son jugement, son contexte et son expérience, ce qui est précieux pour saisir les nuances, mais coûteux à grande échelle. Deux facteurs la ralentissent systématiquement : le coût par candidat et la variabilité inter-évaluateurs, c'est-à-dire la possibilité que deux réviseurs qualifiés attribuent des scores différents à la même réponse selon leur humeur, leur fatigue ou leur interprétation de la grille.
La plupart des employeurs adoptent un modèle hybride plutôt que de choisir un seul camp. Les schémas courants incluent :
- IA en premier avec vérifications humaines ponctuelles : l'IA note chaque soumission, et un recruteur examine un échantillon ou les scores limites.
- Humain en premier pour les tâches complexes : les questions ouvertes ou à forte charge de jugement sont transmises directement à une personne, tandis que les tâches structurées (tests de codage, problèmes mathématiques, logique à choix multiples) sont confiées à l'IA.
- Synthèse mécanique : les scores des évaluateurs humains et des algorithmes sont combinés en un résultat unique, une méthode qui s'est révélée capable de préserver la précision prédictive tout en améliorant l'adhésion des responsables du recrutement souhaitant un contrôle humain du processus.
Points forts et limites : précision, rapidité, cohérence et biais
Une comparaison examinée par des pairs entre la notation par IA et des experts humains dans le recrutement en informatique n'a révélé aucune différence significative dans les scores moyens entre les deux. L'IA a noté beaucoup plus rapidement, mais l'étude a également mis en évidence quelque chose de moins flatteur pour les deux parties : aucune n'était pleinement cohérente. L'IA produisait des scores variables lorsqu'on lui demandait de renoter la même soumission, et les évaluateurs humains présentaient la même manque de fiabilité inter-évaluateurs documentée depuis des décennies dans la recherche sur le recrutement.
Là où chaque approche tend à l'emporter :
- L'IA l'emporte en termes de vitesse brute et de cohérence sur de grands groupes de candidats lorsque la tâche est structurée (tests de code, séries de problèmes standardisés).
- Les humains l'emportent sur le contexte : reconnaître une réponse non conventionnelle mais valide, appliquer des aménagements, ou repérer un candidat qui a résolu le problème d'une manière différente mais tout aussi correcte.
- Aucun des deux ne s'impose clairement en matière de répétabilité. Les évaluateurs humains comme les systèmes d'IA peuvent produire des scores différents pour le même travail lors d'une deuxième évaluation.
Vérification de la cohérence : la même étude qui a constaté que l'IA égalait les scores moyens humains a également révélé que la notation par IA et la notation humaine montraient toutes deux une incohérence mesurable lors d'une évaluation répétée de soumissions identiques, ce qui explique pourquoi une seule passe de notation, quelle qu'en soit la source, est une base risquée pour une décision de recrutement définitive.
Le biais mérite une analyse séparée, car le terme « biaisé » est utilisé de manière approximative. La SIOP le distingue en deux concepts distincts et testables : le biais de mesure, où un test donne des résultats différents selon les groupes malgré une compétence sous-jacente égale, et le biais prédictif, où un score de test prédit la performance au poste différemment selon les groupes. Traiter ces deux notions comme un problème vague unique est la façon dont les employeurs passent à côté de risques réels. Un mode d'échec courant est la fuite de la variable cible, où un modèle s'entraîne sur une variable proxy qui est corrélée à une caractéristique protégée plutôt qu'à la compétence elle-même. L'absence d'aménagements pour les candidats en situation de handicap en est un autre exemple : une grille d'évaluation par IA construite sans tenir compte des dispositions de l'ADA peut pénaliser une approche alternative légitime qu'un évaluateur humain reconnaîtrait immédiatement.
Validation, tests et gouvernance que les équipes RH doivent mettre en place
Déployer un outil de notation par IA sans plan de test, c'est risquer de se retrouver à défendre une action en justice plutôt qu'une décision de recrutement. L'approche TEVV-Athlon du NIST fournit une structure pratique pour cela, articulée autour de quatre étapes :
- Définir les objectifs. Déterminer précisément ce que l'outil de notation doit mesurer et à quoi ressemble une « bonne performance » pour le poste.
- Validation de construction. Confirmer que le test mesure réellement la compétence qu'il prétend mesurer, et non un substitut vaguement lié.
- Tests utilisateurs et sur le terrain. Faire fonctionner l'outil sur de vraies soumissions de candidats, y compris des tentatives de red-teaming pour identifier ses points de défaillance ou d'évaluation inéquitable.
- Synthétiser les résultats. Combiner l'ensemble des éléments en un jugement documenté sur la disponibilité de l'outil pour une utilisation en conditions réelles.
Une liste de contrôle d'audit à effectuer avant le lancement et de manière récurrente par la suite devrait inclure des vérifications de validité de construction et pratique, des tests d'impact préjudiciable sur les groupes démographiques, la documentation des sources d'étiquettes et de la conception de la grille, des tailles d'échantillon adéquates avant de tirer des conclusions, ainsi qu'un calendrier de suivi fixe plutôt qu'une révision unique. Le guide d'aide aux tests d'impact préjudiciable intégré à Talent Approved explique comment effectuer ce type de vérification sans avoir de formation en statistiques.
L'étape la plus souvent négligée est l'intégration des retours d'expérience : relier les scores de présélection à ce qui se passe réellement après l'embauche. Comparer les scores d'évaluation aux données de rétention et de performance transforme un test de sélection en un véritable instrument prédictif, plutôt qu'en un filtre dont on espère qu'il fonctionne.
Conseil pratique : Effectuez votre premier cycle de validation sur un poste pour lequel vous recrutez déjà fréquemment. Vous disposerez de suffisamment de données de performance historiques pour vérifier si le score d'évaluation a réellement prédit quelque chose, plutôt que de supposer.
Liste de contrôle pour la mise en œuvre : règles de décision et indicateurs
Tous les tests n'appartiennent pas au même panier. Une règle de décision applicable ressemble à ceci :
- Utilisez la notation uniquement par IA ou IA en premier pour les tests de codage structurés, les séries de problèmes standardisés et le présélection initiale à volume élevé.
- Exigez une révision humaine pour les réponses en texte libre ambiguës, l'évaluation de portfolios et toute décision en phase finale affectant une offre d'emploi.
- Optez par défaut pour une notation hybride chaque fois que le poste est à enjeux élevés, mais que le format du test est suffisamment structuré pour que l'IA puisse effectuer une première passe.
Une fois les règles établies, suivez-les avec de vrais indicateurs plutôt qu'au feeling :
- Accord inter-évaluateurs — kappa de Cohen pour les comparaisons à deux évaluateurs, ou kappa de Fleiss lorsque davantage d'évaluateurs sont impliqués, appliqué aux comparaisons IA-humain et humain-humain.
- Distributions des scores par sous-groupe — régulièrement ventilées par catégorie démographique pour détecter rapidement les biais de mesure.
- Corrélations de validité prédictive — dans quelle mesure les scores avant embauche correspondent réellement à la performance après embauche.
- Temps de traitement et taux d'erreur — combien de temps prend la notation et à quelle fréquence les résultats nécessitent une correction manuelle.
Les contrôles opérationnels sont aussi importants que les indicateurs eux-mêmes : informez les candidats là où la loi de l'État l'exige, créez un circuit d'escalade pour les scores aberrants, documentez chaque audit pour la revue de conformité, et définissez un déclencheur fixe de réentraînement plutôt que d'attendre qu'une plainte force la main. La notation d'évaluation instantanée de Talent Approved est conçue avec ce type de grille transparente et auditable à l'esprit.
Impact de la notation par IA sur la qualité des retours pour les candidats
Une notation plus rapide modifie l'expérience des candidats, pas seulement ce que voient les recruteurs. Un candidat qui termine un test de compétences et reçoit un résultat en quelques heures plutôt qu'en deux semaines reste engagé dans votre processus au lieu d'accepter une offre concurrente. Les synthèses générées par l'IA peuvent donner aux recruteurs une présentation lisible des points forts et des lacunes de chaque candidat presque immédiatement après la soumission, ce qui réduit le délai entre l'évaluation et les étapes suivantes.
La qualité des retours est une question distincte de leur rapidité, cependant, et c'est là que l'IA a encore de réelles limites. Une synthèse générée peut signaler que le code d'un candidat a échoué à certains cas de test ou qu'une réponse écrite a manqué des critères clés de la grille. Elle peine à expliquer le « pourquoi » avec la même profondeur qu'un évaluateur humain compétent, surtout pour les tâches créatives ou à forte charge de jugement où la bonne réponse n'est pas unique.
La solution pratique sur laquelle la plupart des processus hybrides s'alignent est un retour en couches : l'IA génère immédiatement la synthèse de première passe, et un recruteur ou un responsable de recrutement ajoute du contexte avant qu'elle ne parvienne au candidat ou au comité de recrutement. Cela préserve l'avantage de rapidité de la notation automatisée sans perdre la nuance interprétative qu'une personne apporte. Cela protège également contre un risque plus subtil : des candidats qui font confiance à une synthèse d'IA comme si elle était plus fiable qu'elle ne l'est réellement, simplement parce qu'elle est arrivée rapidement et paraît soignée.
Des tests papier à la notation par IA : une brève histoire
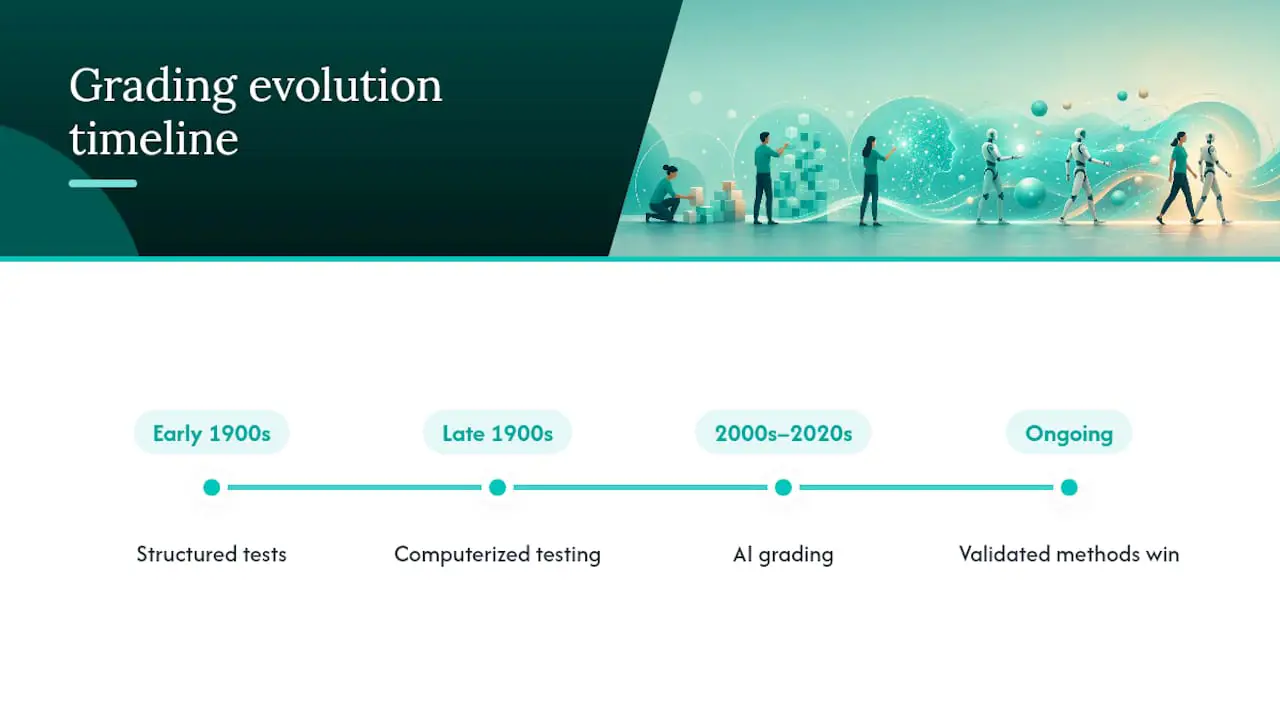
L'évaluation des candidats n'a pas commencé avec les logiciels. L'évaluation structurée du recrutement remonte au début du XXe siècle, lorsque les employeurs ont commencé à standardiser les tests pour réduire la dépendance à l'intuition et aux recommandations personnelles. Des décennies de recherche depuis lors montrent de manière constante que les méthodes structurées et pertinentes pour le poste — notamment les échantillons de travail et les entretiens structurés — produisent le lien le plus fort avec la performance réelle au poste, surpassant de loin les entretiens non structurés ou la présélection de CV seuls.
Le prochain grand changement est venu avec les tests informatisés à la fin du XXe siècle, qui ont permis aux employeurs de standardiser la notation et de réduire certaines incohérences inter-évaluateurs pour les évaluations à choix multiples et numériques. Mais les tâches ouvertes — rédactions, révisions de code, réponses à des scénarios — nécessitaient toujours un humain pour les lire et les juger, ce qui maintenait la notation lente et coûteuse à grande échelle.
La notation par IA est la prochaine étape dans cette même trajectoire, et non une rupture avec elle. Ce qui a changé, c'est la capacité d'appliquer une grille cohérente aux réponses non structurées (réponses écrites, code, même vidéo) à une vitesse qu'aucun panel humain ne peut égaler. Les recherches sur la combinaison des méthodes de sélection qui précèdent de plusieurs décennies l'IA moderne conservent toujours la leçon fondamentale : les tests validés et pertinents pour le poste surpassent le jugement informel, que l'évaluateur soit une personne ou un modèle. L'IA n'a pas inventé ce principe. Elle a simplement rendu son application à grande échelle enfin pratique.
Considérations éthiques propres à la notation par IA ou par l'humain
Les questions éthiques autour de la notation par IA ne portent pas vraiment sur le fait qu'une machine « comprenne » l'équité. Elles portent sur le fait que les humains qui la déploient ont intégré suffisamment de responsabilité dans le processus. Trois problèmes reviennent régulièrement.
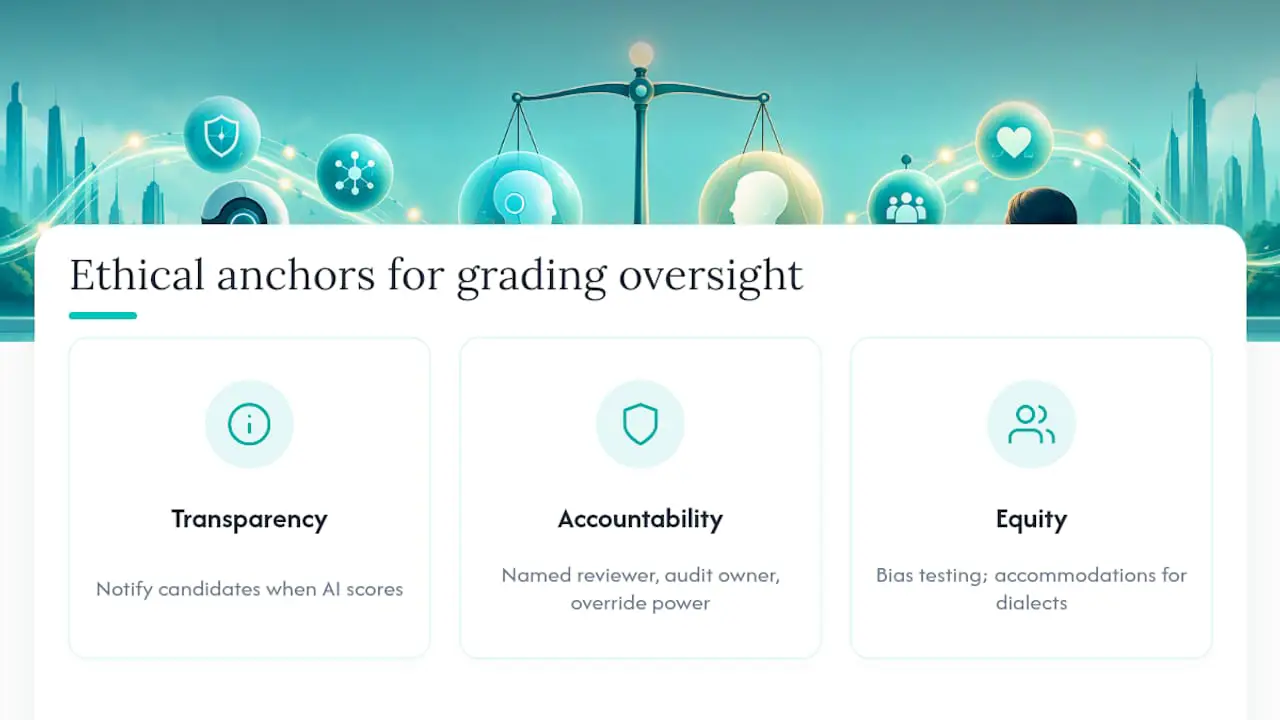
Transparence. Les candidats méritent de savoir quand l'IA est impliquée dans la notation de leur travail, et un nombre croissant de lois d'État exigent exactement ce type de notification. Les employeurs qui enfouissent cette information dans les petits caractères créent une exposition juridique, pas seulement un problème éthique.
Responsabilité en cas d'erreurs. Lorsqu'un évaluateur humain commet une erreur, il existe une personne à qui faire remonter le problème. Lorsqu'un système d'IA attribue une mauvaise note à une réponse, la chaîne de responsabilité doit être tout aussi claire : qui examine les scores aberrants, qui est responsable de l'audit, et qui a l'autorité pour annuler un score.
Équité entre les candidats. Un système de notation entraîné sans attention aux aménagements, aux variations dialectales dans les réponses écrites, ou aux approches non conventionnelles de résolution de problèmes peut silencieusement désavantager des candidats qualifiés sans que personne ne s'en aperçoive jusqu'à ce qu'un audit d'impact préjudiciable le détecte. Les évaluateurs humains portent leur propre version de ce risque à travers les biais inconscients, ce qui explique précisément pourquoi la SIOP traite les tests de biais comme une exigence technique pour l'une ou l'autre méthode de notation, et non comme une case éthique à cocher une seule fois.
Aucun de ces points ne plaide contre l'utilisation de l'IA. Ils plaident pour traiter la notation — quelle qu'en soit la forme — comme un système nécessitant une supervision, et non comme un outil que l'on déploie et oublie.
Pourquoi les résultats de la notation par IA sont plus difficiles à interpréter
Un évaluateur humain peut généralement expliquer un score en une phrase : « la solution du candidat fonctionnait, mais utilisait une approche inefficace. » Un score généré par IA est souvent plus difficile à déchiffrer, surtout lorsque le modèle sous-jacent pondère des dizaines de signaux qu'un recruteur ne voit jamais directement.
Cela crée un problème d'interprétation spécifique : un score sans justification claire est difficile à défendre si un candidat le conteste ou si un régulateur demande comment une décision a été prise. Il est également plus difficile de savoir si un score faible reflète un réel manque de compétence ou une particularité dans la formulation de la réponse du candidat.
La réponse pratique n'est pas de se méfier de chaque score d'IA. C'est d'exiger l'explicabilité comme fonctionnalité de base, et non comme une réflexion après coup. Une synthèse utile générée par IA devrait indiquer quels critères spécifiques un candidat a satisfaits ou manqués, et pas seulement un chiffre composite unique. Ce niveau de détail permet à un recruteur de vérifier le raisonnement de l'IA de la même manière qu'il contrôlerait les notes d'un évaluateur humain, et transforme un score opaque en quelque chose qu'un responsable de recrutement peut réellement défendre dans une décision finale.
La notation par IA selon les rôles et les types de compétences
La notation par IA n'est pas un outil appliqué de manière uniforme. Son efficacité varie selon ce qui est évalué.
Les évaluations techniques et de codage sont celles où la notation par IA est la plus fiable. Les cas de test réussissent ou échouent, le temps d'exécution est mesurable et les métriques de qualité du code peuvent être notées selon des critères clairs — c'est précisément l'environnement structuré que l'étude sur le recrutement informatique mesurait lorsqu'elle a constaté que l'IA égalait les scores moyens humains à une vitesse bien supérieure.
Les tests de connaissances structurées — quiz de conformité, tests d'aptitude, tests de jugement situationnel avec des réponses correctes définies — sont presque aussi bien adaptés, car la logique de notation diffère à peine d'un examen à choix multiples bien conçu.
Les tâches de réponse écrite et de communication se situent entre les deux. L'IA peut signaler la grammaire, la structure et si une réponse aborde le sujet, mais juger le ton, le pouvoir de persuasion ou la résolution créative de problèmes bénéficie encore d'un second regard humain.
Les tâches liées aux rôles de vente, service client et relationnels restent pour l'instant largement dans le domaine humain. Ces rôles dépendent de la lecture des signaux émotionnels et de l'adaptation en cours de conversation — un territoire où une grille peine à saisir ce qui prédit réellement le succès au poste.
Le guide de conception de tests spécifiques aux rôles de Talent Approved est conçu pour faire correspondre le format d'évaluation à la compétence testée, ce qui constitue le véritable levier pour décider du poids à accorder à la notation par IA pour un rôle donné.
Une voie pragmatique pour faire travailler ensemble la notation humaine et la notation par IA
Évitez le débat du tout ou rien. Effectuez un pilote sur un seul rôle, combinez les scores d'IA avec le jugement humain par synthèse mécanique plutôt que de choisir l'un ou l'autre, et auditez un petit échantillon avant de passer à grande échelle sur quoi que ce soit à enjeux élevés. Les fonctionnalités de la plateforme qui soutiennent cela — génération de grille structurée, surveillance anti-triche, synthèses générées par IA — existent pour accélérer l'étape de révision humaine, pas pour la remplacer. Suivez la performance après embauche par rapport aux scores avant embauche et ajustez la grille quand les données vous le disent, et pas avant.
— Jimmie
Prêt à piloter la notation assistée par IA ? Commencez ici
Talent Approved est conçu précisément pour le modèle hybride recommandé dans cet article : l'IA fait le gros du travail de notation, et vous gardez la décision finale. Magic Create transforme une description de poste en évaluation spécifique au rôle en quelques minutes, la surveillance anti-triche intégrée (vérifications d'écran et de webcam, relectures de session) protège l'intégrité de ce que vous notez, et les synthèses générées par IA vous donnent une présentation lisible par candidat au lieu d'un simple chiffre brut. La tarification fonctionne sur un modèle à l'usage à 5 $ par évaluation de candidat complétée, sans abonnement requis.
Si vous êtes prêt à tester cela correctement, lancez un pilote de 30 à 90 jours : choisissez un rôle, générez l'évaluation avec Magic Create, notez chaque soumission avec la synthèse IA et un évaluateur humain en parallèle, effectuez une vérification d'impact préjudiciable sur les résultats, et comparez les recrues pilotes aux données de performance une fois en poste. Consultez la page de tarification pour estimer votre pilote avant de vous engager dans un déploiement complet.
Sources
Avant de déployer la notation par IA à grande échelle, consultez les recommandations de validation de la SIOP, le cadre TEVV-Athlon du NIST et l'étude sur le recrutement informatique comparant la notation par IA et humaine. Pour les obligations légales en évolution, le résumé de K&L Gates sur l'évolution des directives fédérales mérite une lecture.
- ChatGPT vs human expertise in the context of IT recruitment
- Considerations and Recommendations for the Validation and Use of AI-Based Assessments for Employee Selection (SIOP)
- NIST ARIA 0.1 pilot report
- The validity and utility of selection methods in personnel psychology
FAQ
L'IA peut-elle remplacer entièrement les évaluateurs humains ?
Non. Les recherches comparant la notation par IA et la notation humaine dans le recrutement informatique ont trouvé une précision moyenne similaire mais une vitesse d'IA supérieure, tandis que les deux ont montré des incohérences lors de notations répétées. La révision humaine reste importante pour les tâches ambiguës et les décisions en phase finale.
La notation par IA est-elle juridiquement défendable pour les décisions de recrutement ?
Elle peut l'être, si vous validez l'outil et documentez le processus. La SIOP recommande une validation psychométrique formelle, et plusieurs États exigent désormais que les candidats soient informés ou donnent leur consentement lorsque l'IA est utilisée dans la notation.
Combien coûte Talent Approved ?
Talent Approved facture 5 $ par évaluation de candidat complétée sur un modèle à l'usage, sans abonnement requis.
Quelle est la différence entre le biais de mesure et le biais prédictif ?
Le biais de mesure signifie qu'un test attribue des scores différents selon les groupes malgré une compétence sous-jacente égale. Le biais prédictif signifie que le score prédit la performance au poste différemment selon les groupes. La SIOP traite ces deux notions comme des problèmes distincts et testables, et non comme un problème général d'équité.
Quels tests de compétences sont les plus sûrs à noter uniquement par IA ?
Les tests structurés à notation objective — défis de codage, quiz de connaissances standardisés et tests de jugement situationnel avec des réponses correctes définies — sont les plus adaptés à la notation uniquement par IA. Les réponses écrites ouvertes et les évaluations de rôles interpersonnels bénéficient encore d'une révision humaine.
Recommandé
- Créer des grilles d'évaluation que les formateurs peuvent piloter et mettre à l'échelle avec l'IA
- Guide RH américain pour les tests d'impact préjudiciable : réaliser, lire, corriger
- Pilote à 5 $ Talent Approved : scores d'étalonnage des candidats pour les RH
- Le rôle de l'IA dans la présélection en masse de candidats : guide 2026