
Manuale HR per Valutazione AI vs Umana: Pilot 30-90 Giorni + 4 Step TEVV
La valutazione tramite IA funziona bene per test di competenze strutturati e specifici per ruolo: assegna i punteggi più velocemente di una persona e si avvicina agli stessi voti medi. Non dovrebbe operare da sola su decisioni ad alto rischio o ambigue. I framework di SIOP e l'approccio di test TEVV di NIST esistono per una ragione, e piattaforme come Talent Approved sono costruite intorno all'abbinamento della valutazione IA con la revisione umana, non per sostituirla del tutto.
In sintesi:
- La valutazione tramite IA è più affidabile per assessment strutturati come test di programmazione e quiz di conoscenza standardizzati, dove esistono risposte chiaramente giuste o sbagliate.
- Un modello ibrido con l'IA nella selezione iniziale e la revisione umana per compiti sfumati o ambigui offre il miglior equilibrio tra velocità e precisione.
- Sia i valutatori IA che quelli umani mostrano incongruenze nel punteggio di invii identici, sottolineando la necessità di validazione e monitoraggio continuo.
- I rischi di pregiudizio includono il bias di misurazione e il bias predittivo, che possono essere mitigati attraverso test approfonditi, trasparenza e una progettazione inclusiva delle rubriche.
- L'esecuzione di piccoli programmi pilota e il confronto dei punteggi dell'assessment con le prestazioni lavorative effettive aiuta a garantire che gli strumenti IA siano predittivi ed equi nelle assunzioni.
Indice dei contenuti
- Come funzionano la valutazione IA e quella umana nelle assunzioni
- Punti di forza e limiti: accuratezza, velocità, coerenza e pregiudizio
- Validazione, test e governance che i team HR devono eseguire
- Checklist di implementazione: regole decisionali e metriche
- Impatto della valutazione IA sulla qualità del feedback per i candidati
- Dai test cartacei alla valutazione IA: una breve storia
- Considerazioni etiche specifiche sulla valutazione IA vs umana
- Perché i risultati della valutazione IA sono più difficili da interpretare
- La valutazione IA in diversi ruoli e tipi di competenza
- Un percorso pragmatico per far lavorare insieme la valutazione umana e quella IA
- Pronto a sperimentare la valutazione assistita dall'IA? Inizia qui
- Fonti
- FAQ
Come funzionano la valutazione IA e quella umana nelle assunzioni
Gli strumenti di valutazione IA assegnano punteggi al lavoro dei candidati in base a una rubrica costruita a partire da etichette di addestramento, criteri strutturati o una descrizione del lavoro inserita nel sistema. Alcune piattaforme di assessment IA offrono funzionalità che costruiscono assessment e strutture di punteggio specifici per ruolo a partire dalle descrizioni del lavoro in pochi minuti, generando poi riepiloghi delle prestazioni di ciascun candidato in modo che i recruiter possano esaminare i risultati senza leggere ogni invio riga per riga. Il vantaggio è il volume: un sistema come questo può valutare centinaia di campioni di codice o risposte scritte nel tempo che un singolo esperto della materia impiega per esaminarne una manciata.
La valutazione umana funziona in modo diverso. Un esperto della materia applica una rubrica usando giudizio, contesto ed esperienza, il che è prezioso per le sfumature ma costoso da scalare. Due fattori la rallentano ogni volta: il costo per candidato e la variabilità inter-valutatore, ovvero due revisori qualificati possono valutare la stessa risposta in modo diverso a seconda dell'umore, della stanchezza o dell'interpretazione della rubrica.
La maggior parte dei datori di lavoro opta per un modello ibrido piuttosto che scegliere un solo approccio. I modelli comuni includono:
- IA prima con controlli umani a campione: l'IA valuta ogni invio e un recruiter esamina un campione o qualsiasi punteggio borderline.
- Umano prima per compiti complessi: i prompt aperti o ad alto contenuto di giudizio vanno direttamente a una persona, mentre i compiti strutturati (test di programmazione, problemi matematici, logica a scelta multipla) vanno all'IA.
- Sintesi meccanica: i punteggi dei valutatori umani e quelli algoritmici vengono combinati in un unico output, un metodo che si è dimostrato in grado di preservare l'accuratezza predittiva migliorando al tempo stesso il consenso da parte dei responsabili delle assunzioni che desiderano un controllo umano sul processo.
Punti di forza e limiti: accuratezza, velocità, coerenza e pregiudizio
Un confronto peer-reviewed tra la valutazione IA e quella di esperti umani nel reclutamento IT non ha trovato differenze significative nei punteggi medi tra i due approcci. L'IA ha valutato molto più velocemente, ma lo studio ha anche rilevato qualcosa di meno lusinghiero per entrambe le parti: nessuna era pienamente coerente. L'IA ha prodotto punteggi variabili quando le è stato chiesto di rivalutare lo stesso invio, e i revisori umani hanno mostrato la stessa inaffidabilità inter-valutatore documentata nella ricerca sulle assunzioni da decenni.
Dove tende a vincere ciascun approccio:
- L'IA vince in velocità bruta e coerenza su grandi pool di candidati quando il compito è strutturato (test di codice, set di problemi standardizzati).
- Gli esseri umani vincono nel contesto: riconoscere una risposta non convenzionale ma valida, applicare accomodamenti, o individuare un candidato che ha risolto il problema in modo diverso ma ugualmente corretto.
- Nessuno vince nettamente sulla ripetibilità. Sia i valutatori IA che quelli umani possono produrre punteggi diversi per lo stesso lavoro in una seconda valutazione.
Controllo di coerenza: lo stesso studio che ha rilevato come l'IA corrispondesse ai punteggi medi umani ha anche riscontrato che sia la valutazione IA che quella umana mostravano un'incongruenza misurabile nella rivalutazione di invii identici, motivo per cui un singolo passaggio di valutazione da entrambe le fonti è una base rischiosa per una decisione finale di assunzione.
Il pregiudizio merita un'analisi separata, perché "distorto" viene usato in modo generico. SIOP lo separa in due concetti distinti e verificabili: il bias di misurazione, in cui un test funziona diversamente per gruppi diversi nonostante uguale competenza sottostante, e il bias predittivo, in cui il punteggio di un test prevede le prestazioni lavorative in modo diverso tra i gruppi. Trattare questi come un unico problema vago è il modo in cui i datori di lavoro mancano il rischio reale. Una modalità di fallimento comune è la perdita di target, in cui un modello si addestra su una variabile proxy che correla con una caratteristica protetta piuttosto che con la competenza stessa. La mancanza di accomodamenti per i candidati con disabilità è un altro esempio: una rubrica IA costruita senza considerare l'ADA può penalizzare un approccio alternativo legittimo che un revisore umano riconoscerebbe immediatamente.
Validazione, test e governance che i team HR devono eseguire
Implementare uno strumento di valutazione IA senza un piano di test è il modo in cui i datori di lavoro finiscono a dover difendere una causa legale invece di una decisione di assunzione. L'approccio TEVV-Athlon di NIST fornisce una struttura pratica per questo, costruita intorno a quattro fasi:
- Definire gli obiettivi. Decidere esattamente cosa deve misurare lo strumento di valutazione e come appare una "buona prestazione" per il ruolo.
- Validazione del costrutto. Confermare che il test misuri effettivamente la competenza che dichiara di misurare, e non un proxy vagamente correlato.
- Test utente e sul campo. Eseguire lo strumento su invii reali di candidati, inclusi tentativi di red-teaming per trovare dove si rompe o valuta in modo iniquo.
- Sintetizzare i risultati. Combinare tutto in un giudizio documentato sull'idoneità dello strumento per l'uso in produzione.
Una checklist di audit da eseguire prima del lancio e con cadenza ricorrente successivamente dovrebbe includere: controlli di validità del costrutto e pratica, test di impatto avverso tra gruppi demografici, documentazione delle fonti delle etichette e della progettazione della rubrica, dimensioni campionarie adeguate prima di trarre conclusioni e un calendario fisso di monitoraggio piuttosto che una revisione una tantum. La guida al test di impatto avverso integrata in Talent Approved illustra come eseguire questo tipo di verifica senza una formazione in statistica.
Il passaggio più trascurato è l'integrazione del feedback: collegare i punteggi pre-assunzione a ciò che accade effettivamente dopo l'assunzione. Confrontare i punteggi dell'assessment con i dati di fidelizzazione e prestazioni trasforma un test di selezione in uno strumento genuinamente predittivo, piuttosto che in un filtro di cui si spera funzioni.
Consiglio pro: Esegui il tuo primo ciclo di validazione su un ruolo per cui assumi già frequentemente. Avrai abbastanza dati storici sulle prestazioni per verificare se il punteggio dell'assessment abbia effettivamente previsto qualcosa, invece di fare supposizioni.
Checklist di implementazione: regole decisionali e metriche
Non ogni test appartiene allo stesso contenitore. Una regola decisionale praticabile è la seguente:
- Usa la valutazione solo IA o IA prima per test di programmazione strutturati, set di problemi standardizzati e screening iniziale ad alto volume.
- Richiedi la revisione umana per risposte in testo libero ambigue, valutazione del portfolio e qualsiasi decisione in fase finale che influenzi un'offerta.
- Prediligi il punteggio ibrido ogni volta che il ruolo è ad alto rischio ma il formato del test è ancora abbastanza strutturato da consentire all'IA di gestire un primo passaggio.
Una volta stabilite le regole, monitrale con metriche reali invece di affidarti all'istinto:
- Accordo inter-valutatore — kappa di Cohen per confronti tra due valutatori, o kappa di Fleiss quando sono coinvolti più valutatori, applicato sia ai confronti IA-vs-umano che umano-vs-umano.
- Distribuzioni dei punteggi per sottogruppo — suddivise regolarmente per categoria demografica per individuare precocemente il bias di misurazione.
- Correlazioni di validità predittiva — quanto bene i punteggi pre-assunzione tracciano effettivamente le prestazioni post-assunzione.
- Tempi di elaborazione e tasso di errore — quanto tempo richiede la valutazione e con quale frequenza gli output necessitano di correzione manuale.
I controlli operativi contano quanto le metriche stesse: informare i candidati dove la legge statale lo richiede, costruire un percorso di escalation per i punteggi anomali, documentare ogni audit per la revisione della conformità e impostare un trigger fisso di ri-addestramento piuttosto che aspettare che un reclamo forzi la questione. Il punteggio istantaneo degli assessment di Talent Approved è costruito con questo tipo di rubrica trasparente e verificabile in mente.
Impatto della valutazione IA sulla qualità del feedback per i candidati
Una valutazione più rapida cambia l'esperienza dei candidati, non solo ciò che vedono i recruiter. Un candidato che completa un test di competenze e riceve un risultato in ore invece di due settimane rimane coinvolto nel tuo processo invece di accettare un'offerta concorrente. I riepiloghi generati dall'IA possono fornire ai recruiter una panoramica leggibile dei punti di forza e delle lacune di ciascun candidato quasi immediatamente dopo l'invio, accorciando il divario tra l'assessment e i passi successivi.
La qualità del feedback è però una questione separata dalla velocità del feedback, ed è qui che l'IA ha ancora limiti reali. Un riepilogo generato può segnalare che il codice di un candidato non ha superato certi test o che una risposta scritta ha mancato criteri chiave della rubrica. Fatica a spiegare il "perché" con la stessa profondità che porta un revisore umano esperto, specialmente per compiti creativi o ad alto contenuto di giudizio dove la risposta giusta non è univoca.
La soluzione pratica su cui atterrano la maggior parte dei workflow ibridi è il feedback a strati: l'IA genera il riepilogo del primo passaggio immediatamente, e un recruiter o un responsabile delle assunzioni aggiunge contesto prima che raggiunga un candidato o una commissione di selezione. Questo mantiene il vantaggio di velocità della valutazione automatizzata senza perdere la sfumatura interpretativa che aggiunge una persona. Protegge anche da un rischio più sottile: candidati che si fidano di un riepilogo IA come più autorevole di quanto non sia effettivamente, semplicemente perché è arrivato velocemente e sembra ordinato.
Dai test cartacei alla valutazione IA: una breve storia
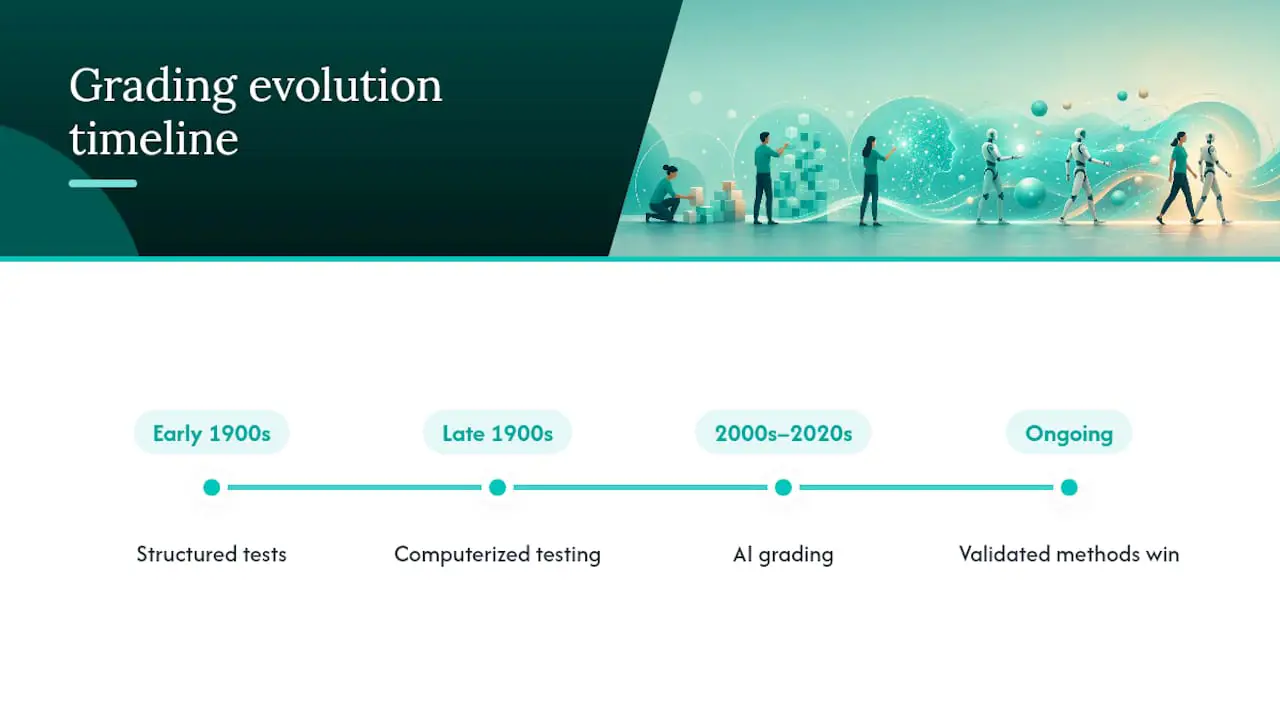
La valutazione dei candidati non è iniziata con il software. La valutazione strutturata nelle assunzioni risale alla psicologia del personale dell'inizio del XX secolo, quando i datori di lavoro hanno iniziato a standardizzare i test per ridurre la dipendenza dall'istinto e dalle referenze personali. Decenni di ricerca da allora dimostrano costantemente che i metodi strutturati e pertinenti al lavoro — i campioni di lavoro e i colloqui strutturati in particolare — producono il legame più forte con le prestazioni lavorative effettive, superando di gran lunga i colloqui non strutturati o lo screening del curriculum da solo.
Il grande cambiamento successivo è arrivato con i test computerizzati alla fine del XX secolo, che hanno permesso ai datori di lavoro di standardizzare il punteggio e ridurre alcune incongruenze inter-valutatore per le valutazioni a scelta multipla e numeriche. Ma i compiti aperti — campioni di scrittura, revisione del codice, risposte a scenari — richiedevano ancora una persona per leggerli e giudicarli, il che manteneva la valutazione lenta e costosa su scala.
La valutazione IA è il passo successivo in quella stessa traiettoria, non una rottura con essa. Ciò che è cambiato è la capacità di applicare una rubrica coerente a risposte non strutturate (risposte scritte, codice, persino video) a una velocità che nessun panel umano può eguagliare. La ricerca sulla combinazione di metodi di selezione che precede l'IA moderna di decenni mantiene ancora la lezione sottostante: i test validati e pertinenti al lavoro battono il giudizio informale, che il valutatore sia una persona o un modello. L'IA non ha inventato questo principio. Ha solo reso finalmente pratico applicarlo su scala.
Considerazioni etiche specifiche sulla valutazione IA vs umana
Le questioni etiche relative alla valutazione IA non riguardano davvero se una macchina "comprenda" l'equità. Riguardano se gli esseri umani che la implementano abbiano integrato abbastanza responsabilità nel processo. Tre problemi emergono ripetutamente.
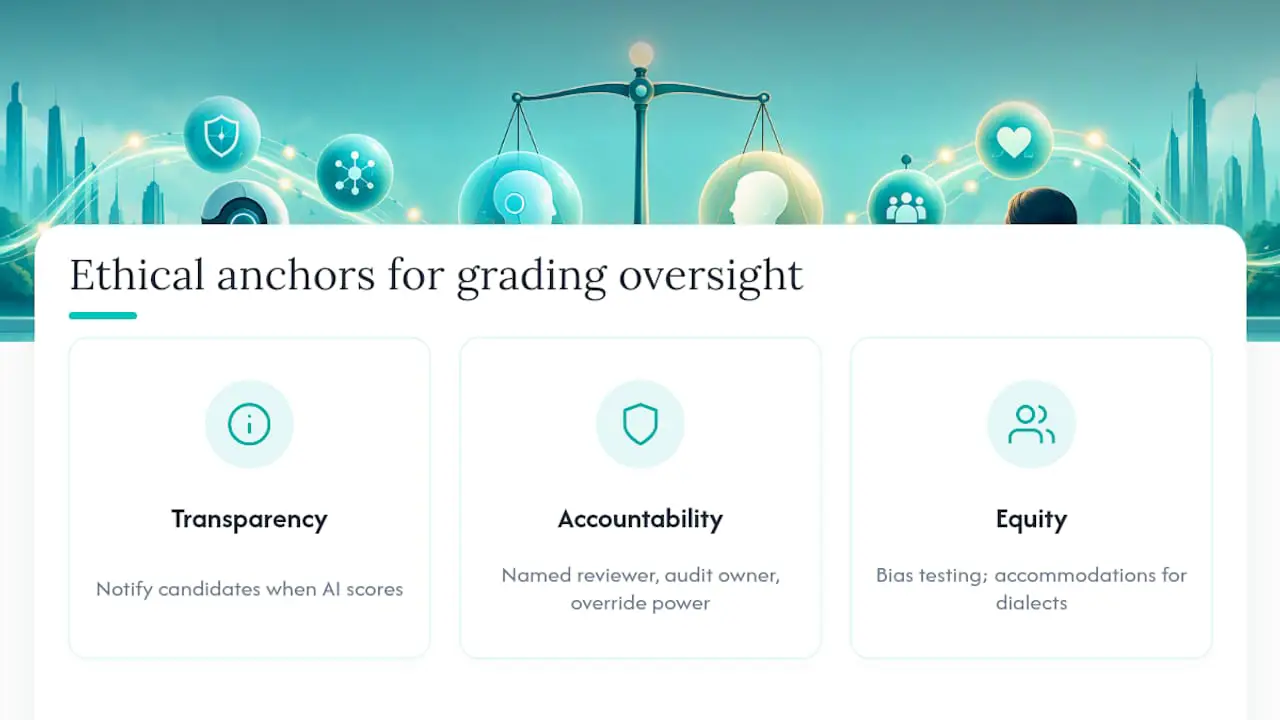
Trasparenza. I candidati meritano di sapere quando l'IA è coinvolta nella valutazione del loro lavoro, e un numero crescente di leggi statali richiede esattamente questo tipo di comunicazione. I datori di lavoro che nascondono questo nelle note a piè di pagina stanno creando un'esposizione legale, non solo un problema etico.
Responsabilità per gli errori. Quando un valutatore umano commette un errore, c'è una persona a cui rivolgersi. Quando un sistema IA valuta male una risposta, la catena di responsabilità deve essere altrettanto chiara: chi esamina le anomalie, chi possiede l'audit e chi ha l'autorità di annullare un punteggio.
Equità tra i candidati. Un sistema di valutazione addestrato senza attenzione agli accomodamenti, alle variazioni di dialetto nelle risposte scritte o agli approcci non tradizionali alla risoluzione dei problemi può svantaggiare silenziosamente candidati qualificati senza che nessuno se ne accorga finché un audit di impatto avverso non lo rileva. I valutatori umani portano la propria versione di questo rischio attraverso il pregiudizio inconscio, che è esattamente il motivo per cui SIOP tratta il test dei bias come un requisito tecnico per entrambi i metodi di valutazione, non come un segno di spunta etico una tantum.
Niente di tutto questo argomenta contro l'uso dell'IA. Argomenta per trattare la valutazione, di qualsiasi tipo, come un sistema che necessita di supervisione, non come uno strumento che si implementa e si dimentica.
Perché i risultati della valutazione IA sono più difficili da interpretare
Un valutatore umano di solito può spiegare un punteggio in una frase: "la soluzione del candidato funzionava ma usava un approccio inefficiente." Un punteggio generato dall'IA è spesso più difficile da analizzare, specialmente quando il modello sottostante pesa dozzine di segnali che un recruiter non vede mai direttamente.
Questo crea un problema specifico di interpretazione: un punteggio senza una motivazione chiara è difficile da difendere se un candidato lo contesta o un regolatore chiede come è stata presa una decisione. È anche più difficile sapere se un punteggio basso riflette una reale lacuna di competenze o una peculiarità nel modo in cui il candidato ha formulato una risposta.
La risposta pratica non è diffidare di ogni punteggio IA. È esigere la spiegabilità come funzionalità di base, non come un pensiero successivo. Un riepilogo utile generato dall'IA dovrebbe mostrare quali criteri specifici un candidato ha soddisfatto o mancato, non solo un singolo numero composito. Questo livello di dettaglio permette a un recruiter di verificare il ragionamento dell'IA nello stesso modo in cui verificherebbe le note di un revisore umano, e trasforma un punteggio opaco in qualcosa che un responsabile delle assunzioni può effettivamente sostenere in una decisione finale.
La valutazione IA in diversi ruoli e tipi di competenza
La valutazione IA non è uno strumento unico applicato uniformemente. Il suo funzionamento varia a seconda di ciò che viene testato.
Le valutazioni tecniche e di programmazione sono dove la valutazione IA funziona in modo più affidabile. I test case o passano o falliscono, il tempo di esecuzione è misurabile e le metriche di qualità del codice possono essere valutate rispetto a criteri chiari — esattamente l'ambiente strutturato che lo studio sul reclutamento IT ha misurato quando ha rilevato che l'IA eguagliava i punteggi medi umani a velocità molto maggiore.
I test di conoscenza strutturata, i quiz di conformità, i test attitudinali e i test di giudizio situazionale con risposte corrette definite sono quasi altrettanto adatti, poiché la logica di punteggio differisce a malapena da un esame a scelta multipla ben costruito.
I compiti di risposta scritta e comunicazione si collocano nel mezzo. L'IA può segnalare grammatica, struttura e se una risposta ha affrontato il prompt, ma giudicare il tono, la persuasività o la risoluzione creativa dei problemi beneficia ancora di un secondo sguardo umano.
I compiti per ruoli di vendita, servizio clienti e interpersonali si orientano maggiormente verso il valutatore umano per ora. Questi ruoli dipendono dalla lettura dei segnali emotivi e dall'adattamento a metà conversazione — un territorio in cui una rubrica fatica a catturare ciò che effettivamente predice il successo nel lavoro.
La guida alla progettazione di test specifici per ruolo di Talent Approved è costruita intorno alla corrispondenza del formato dell'assessment alla competenza testata — che è la vera leva per decidere quanto peso dare alla valutazione IA per un determinato ruolo.
Un percorso pragmatico per far lavorare insieme la valutazione umana e quella IA
Salta il dibattito tutto-o-niente. Esegui un pilota su un ruolo, mescola i punteggi IA con il giudizio umano attraverso la sintesi meccanica piuttosto che scegliere l'uno o l'altro, e verifica un piccolo campione prima di scalare a qualcosa ad alto rischio. Le funzionalità della piattaforma che supportano questo — generazione di rubriche strutturate, monitoraggio anti-imbroglio, riepiloghi generati dall'IA — esistono per rendere il passaggio di revisione umana più veloce, non per sostituirlo. Monitora le prestazioni post-assunzione rispetto ai punteggi pre-assunzione e adatta la rubrica quando i dati te lo indicano, non prima.
— Jimmie
Pronto a sperimentare la valutazione assistita dall'IA? Inizia qui
Talent Approved è costruito esattamente per il modello ibrido che questo articolo raccomanda: l'IA si occupa del lavoro pesante nella valutazione, e tu mantieni la decisione finale. Magic Create trasforma una descrizione del lavoro in un assessment specifico per ruolo in pochi minuti, il monitoraggio anti-imbroglio integrato (controlli dello schermo e della webcam, replay delle sessioni) protegge l'integrità di ciò che stai valutando, e i riepiloghi generati dall'IA ti forniscono una panoramica leggibile per candidato invece di un numero grezzo. Il prezzo si basa su un modello pay-as-you-go a $5 per assessment candidato completato, senza abbonamento richiesto.
Se sei pronto a testarlo correttamente, esegui un pilota da 30 a 90 giorni: scegli un ruolo, genera l'assessment con Magic Create, valuta ogni invio sia con il riepilogo IA che con un revisore umano in parallelo, esegui un controllo di impatto avverso sui risultati e confronta le assunzioni del pilota con i dati sulle prestazioni una volta che sono operative. Controlla la pagina dei prezzi per pianificare il tuo pilota prima di impegnarti in un rollout completo.
Fonti
Prima di implementare la valutazione IA su scala, esamina le linee guida di validazione di SIOP, il framework TEVV-Athlon di NIST e lo studio sul reclutamento IT che confronta la valutazione IA e quella umana. Per gli obblighi legali in evoluzione, vale la pena leggere il riepilogo di K&L Gates sulle mutevoli linee guida federali.
- ChatGPT vs competenza umana nel contesto del reclutamento IT
- Considerazioni e raccomandazioni per la validazione e l'uso di assessment basati sull'IA per la selezione dei dipendenti (SIOP)
- Rapporto pilota NIST ARIA 0.1
- La validità e l'utilità dei metodi di selezione nella psicologia del personale
FAQ
L'IA può sostituire completamente i valutatori umani?
No. La ricerca che confronta la valutazione IA e quella umana nel reclutamento IT ha riscontrato un'accuratezza media simile ma una velocità IA superiore, mentre entrambe hanno mostrato incongruenze nella valutazione ripetuta. La revisione umana è ancora importante per i compiti ambigui e le decisioni in fase finale.
La valutazione IA è legalmente difendibile per le decisioni di assunzione?
Può esserlo, se si valida lo strumento e si documenta il processo. SIOP raccomanda una validazione psicometrica formale, e diversi stati richiedono ora la comunicazione o il consenso del candidato quando l'IA viene utilizzata nella valutazione.
Quanto costa Talent Approved?
Talent Approved addebita $5 per assessment candidato completato su base pay-as-you-go, senza abbonamento richiesto.
Qual è la differenza tra bias di misurazione e bias predittivo?
Il bias di misurazione significa che un test valuta diversamente tra i gruppi nonostante uguale competenza sottostante. Il bias predittivo significa che il punteggio prevede le prestazioni lavorative in modo diverso per gruppo. SIOP li tratta come problemi separati e verificabili, non come un unico problema generale di equità.
Quali test di competenza sono più sicuri da valutare solo con l'IA?
I test strutturati e valutati oggettivamente — sfide di programmazione, quiz di conoscenza standardizzati e test di giudizio situazionale con risposte corrette definite — sono i più adatti per la valutazione solo IA. Le risposte scritte aperte e le valutazioni di ruoli interpersonali beneficiano ancora della revisione umana.
Consigliati
- Costruisci rubriche di punteggio per l'assessment che i formatori possono sperimentare e scalare con l'IA
- Manuale HR USA per il test di impatto avverso: esegui, leggi, correggi
- Pilota da $5 di Talent Approved: punteggi di benchmarking dei candidati per l'HR
- Il ruolo dell'IA nella selezione massiva dei candidati: guida 2026