
HR-руководство по оценке ИИ против человека: пилот 30–90 дней + 4 шага TEVV
Оценка с помощью ИИ хорошо работает для структурированных тестов по конкретным профессиональным навыкам: она выставляет оценки быстрее человека и даёт результаты, близкие к тем же средним показателям. Тем не менее ИИ не должен работать самостоятельно при принятии ответственных или неоднозначных решений. Рекомендации SIOP и методология тестирования TEVV от NIST существуют не зря, а такие платформы, как Talent Approved, созданы на основе сочетания оценки ИИ с экспертной проверкой человека, а не полной её замены.
Коротко о главном:
- Оценка с помощью ИИ наиболее надёжна для структурированных заданий, таких как тесты по программированию и стандартизированные тесты знаний, где существуют чёткие правильные и неправильные ответы.
- Гибридная модель, при которой ИИ выполняет первичный отбор, а человек проверяет неоднозначные или сложные задания, обеспечивает наилучший баланс скорости и точности.
- И ИИ, и человек-оценщик демонстрируют непоследовательность при проверке одинаковых работ, что подчёркивает необходимость валидации и постоянного мониторинга.
- Риски предвзятости включают предвзятость измерения и предвзятость прогнозирования, которые можно снизить с помощью тщательного тестирования, прозрачности и инклюзивного проектирования критериев оценки.
- Проведение небольших пилотных программ и сравнение результатов оценки с реальной эффективностью работы помогают убедиться, что инструменты ИИ дают предсказательные и справедливые результаты при найме.
Содержание
- Как работает оценка с помощью ИИ и оценка человеком при найме
- Сильные стороны и ограничения: точность, скорость, последовательность и предвзятость
- Валидация, тестирование и управление, которые должны проводить HR-команды
- Контрольный список внедрения: правила принятия решений и метрики
- Влияние оценки ИИ на качество обратной связи для кандидатов
- От бумажных тестов к оценке с помощью ИИ: краткая история
- Этические соображения, специфичные для оценки ИИ и человека
- Почему результаты оценки ИИ сложнее интерпретировать
- Оценка с помощью ИИ для разных должностей и типов навыков
- Прагматичный путь к совместной работе человека и ИИ в оценке
- Готовы запустить пилот оценки с помощью ИИ? Начните здесь
- Источники
- Часто задаваемые вопросы
Как работает оценка с помощью ИИ и оценка человеком при найме
Инструменты оценки на основе ИИ проверяют работы кандидатов по критериям, созданным на основе обучающих меток, структурированных критериев или описания должности, введённого в систему. Некоторые платформы оценки на базе ИИ предоставляют функции, которые позволяют за несколько минут создавать оценочные структуры под конкретную роль на основе описания вакансии, а затем формировать сводки по результатам каждого кандидата, чтобы рекрутеры могли просматривать итоги, не читая каждую работу построчно. Преимущество заключается в пропускной способности: такая система может проверить сотни образцов кода или письменных ответов за то время, пока один эксперт просматривает лишь несколько.
Оценка человеком работает иначе. Профильный эксперт применяет критерии, используя суждение, контекст и опыт — это ценно для понимания нюансов, но дорого в масштабировании. Каждый раз её замедляют два фактора: стоимость на одного кандидата и вариативность между оценщиками, то есть два квалифицированных проверяющих могут по-разному оценить один и тот же ответ в зависимости от настроения, усталости или трактовки критериев.
Большинство работодателей выбирают гибридную модель, а не один из вариантов. Распространённые подходы включают:
- ИИ — первичный проверяющий с выборочным контролем человека: ИИ оценивает все работы, а рекрутер просматривает выборку или пограничные оценки.
- Человек — первичный проверяющий для сложных заданий: открытые или требующие суждения задания сразу передаются человеку, а структурированные задания (тесты по программированию, математические задачи, вопросы с вариантами ответов на логику) — ИИ.
- Механический синтез: оценки людей-экспертов и алгоритмов объединяются в единый совокупный результат — метод, который, как было показано, сохраняет прогностическую точность и при этом повышает доверие со стороны руководителей по найму, желающих видеть человеческий контроль в процессе.
Сильные стороны и ограничения: точность, скорость, последовательность и предвзятость
Рецензируемое сравнение оценки ИИ с экспертами-людьми в сфере IT-рекрутинга не выявило существенной разницы в средних оценках между двумя подходами. ИИ работал значительно быстрее, однако исследование также обнаружило кое-что не очень лестное для обеих сторон: ни одна из них не была полностью последовательна. ИИ выставлял разные оценки при повторной проверке одной и той же работы, а эксперты-люди демонстрировали ту же ненадёжность межэкспертных оценок, которая задокументирована в исследованиях найма на протяжении десятилетий.
Где каждый подход, как правило, выигрывает:
- ИИ выигрывает по чистой скорости и последовательности при работе с большими пулами кандидатов, когда задание структурировано (тесты по программированию, стандартизированные наборы задач).
- Человек выигрывает в контексте: распознавании нестандартного, но верного ответа, применении особых условий или выявлении кандидата, решившего задачу другим, но в равной мере правильным способом.
- Ни один не побеждает однозначно в воспроизводимости. И оценщики-люди, и ИИ могут выставить разные оценки за одну и ту же работу при повторной проверке.
Проверка последовательности: то же исследование, которое установило, что ИИ совпадает с человеческими средними оценками, также показало, что как оценка ИИ, так и оценка человека демонстрировали измеримую непоследовательность при повторном оценивании идентичных работ, — именно поэтому единственный проход оценки из любого источника является рискованной основой для окончательного решения о найме.
Предвзятость заслуживает отдельного рассмотрения, поскольку это понятие используется слишком широко. SIOP разделяет её на два отдельных, поддающихся проверке понятия: предвзятость измерения, когда тест по-разному работает для разных групп, несмотря на одинаковый базовый уровень навыков, и предвзятость прогнозирования, когда результат теста по-разному предсказывает производительность труда в разных группах. Воспринимать их как одну расплывчатую проблему — верный способ упустить реальный риск. Распространённый вид ошибки — утечка целевой переменной, когда модель обучается на прокси-переменной, коррелирующей с защищённой характеристикой, а не с самим навыком. Другой пример — отсутствие специальных условий для кандидатов с ограниченными возможностями: критерии оценки ИИ, разработанные без учёта требований ADA, могут штрафовать за законный альтернативный подход, который эксперт-человек мгновенно распознал бы.
Валидация, тестирование и управление, которые должны проводить HR-команды
Внедрение инструмента оценки на базе ИИ без плана тестирования — верный путь к тому, чтобы вместо защиты решения о найме оказаться на скамье ответчиков. Подход TEVV-Athlon от NIST предлагает практическую структуру для этого, основанную на четырёх этапах:
- Определите цели. Чётко решите, что именно должен измерять инструмент оценки и как выглядит «хорошая работа» для данной должности.
- Конструктная валидация. Убедитесь, что тест действительно измеряет заявленный навык, а не слабо связанную с ним прокси-переменную.
- Пользовательское и полевое тестирование. Запустите инструмент на реальных работах кандидатов, включая red-teaming для выявления случаев некорректной или несправедливой оценки.
- Синтез результатов. Объедините всё в задокументированное заключение о готовности инструмента к реальному использованию.
Контрольный список аудита, который стоит проводить перед запуском и на регулярной основе после него, должен включать: проверки конструктной и практической валидности, тестирование на неблагоприятное воздействие по демографическим группам, документирование источников меток и дизайна критериев оценки, достаточный объём выборки перед формулированием выводов и фиксированный график мониторинга вместо единовременной проверки. Встроенное в Talent Approved руководство по тестированию на неблагоприятное воздействие поясняет, как проводить такую проверку без статистического образования.
Наиболее упускаемый из виду шаг — интеграция обратной связи: сопоставление оценок до найма с тем, что происходит после. Сравнение результатов оценки с данными об удержании и производительности превращает скрининговый тест в подлинно прогностический инструмент, а не в фильтр, который вы просто надеетесь, что работает.
Совет профессионала: Проведите первый цикл валидации на должности, на которую вы уже часто набираете сотрудников. У вас будет достаточно исторических данных о производительности, чтобы проверить, действительно ли результат оценки что-то предсказывал, а не просто догадываться об этом.
Контрольный список внедрения: правила принятия решений и метрики
Не каждый тест принадлежит к одной категории. Практичное правило принятия решений выглядит следующим образом:
- Используйте оценку только ИИ или ИИ в первую очередь для структурированных тестов по программированию, стандартизированных наборов задач и первичного отбора при большом объёме кандидатов.
- Требуйте проверки человека для неоднозначных ответов в свободной форме, оценки портфолио и любого финального решения, влияющего на предложение о работе.
- По умолчанию используйте гибридную оценку всякий раз, когда роль ответственная, но формат теста достаточно структурирован для первичной обработки ИИ.
После установления правил отслеживайте их с помощью реальных метрик, а не субъективных ощущений:
- Согласованность между оценщиками — каппа Коэна для сравнений двух оценщиков или каппа Флейса при большем числе оценщиков, применяемые как для сравнений «ИИ против человека», так и «человек против человека».
- Распределение оценок по подгруппам — регулярно разбивайте по демографическим категориям, чтобы своевременно выявлять предвзятость измерения.
- Корреляции прогностической валидности — насколько хорошо оценки до найма отражают производительность после найма.
- Время обработки и частота ошибок — сколько времени занимает оценка и как часто результаты требуют ручной корректировки.
Операционные средства контроля не менее важны, чем сами метрики: уведомляйте кандидатов там, где этого требует законодательство штата, создайте пути эскалации для аномальных оценок, документируйте каждый аудит для проверки соответствия нормативным требованиям и установите фиксированный триггер переобучения, а не ждите, пока жалоба вынудит вас действовать. Мгновенная оценка в Talent Approved создана с учётом такого прозрачного, поддающегося аудиту подхода к критериям.
Влияние оценки ИИ на качество обратной связи для кандидатов
Более быстрая оценка меняет опыт кандидатов, а не только то, что видят рекрутеры. Кандидат, который прошёл тест по навыкам и получил результат через несколько часов, а не через две недели, остаётся вовлечённым в ваш процесс, а не принимает конкурирующее предложение. Сводки, сгенерированные ИИ, могут давать рекрутерам читаемое описание сильных сторон и пробелов каждого кандидата практически сразу после сдачи, что сокращает разрыв между оценкой и следующими шагами.
Качество обратной связи — это отдельный вопрос от скорости обратной связи, и именно здесь у ИИ по-прежнему есть реальные ограничения. Сгенерированная сводка может указать, что код кандидата не прошёл определённые тест-кейсы или что письменный ответ упустил ключевые критерии. Однако ИИ с трудом объясняет «почему» с той же глубиной, которую привносит опытный эксперт-человек, особенно для творческих или требующих суждения заданий, где правильный ответ не единственный.
Практическое решение, к которому приходит большинство гибридных рабочих процессов, — многоуровневая обратная связь: ИИ немедленно генерирует первичную сводку, а рекрутер или руководитель по найму добавляет контекст, прежде чем она достигнет кандидата или комитета по найму. Это сохраняет преимущество в скорости автоматической оценки, не теряя интерпретативных нюансов, которые добавляет человек. Это также защищает от более тонкого риска: кандидаты могут воспринять сводку ИИ как более авторитетную, чем она есть на самом деле, просто потому что она появилась быстро и выглядит аккуратно.
От бумажных тестов к оценке с помощью ИИ: краткая история
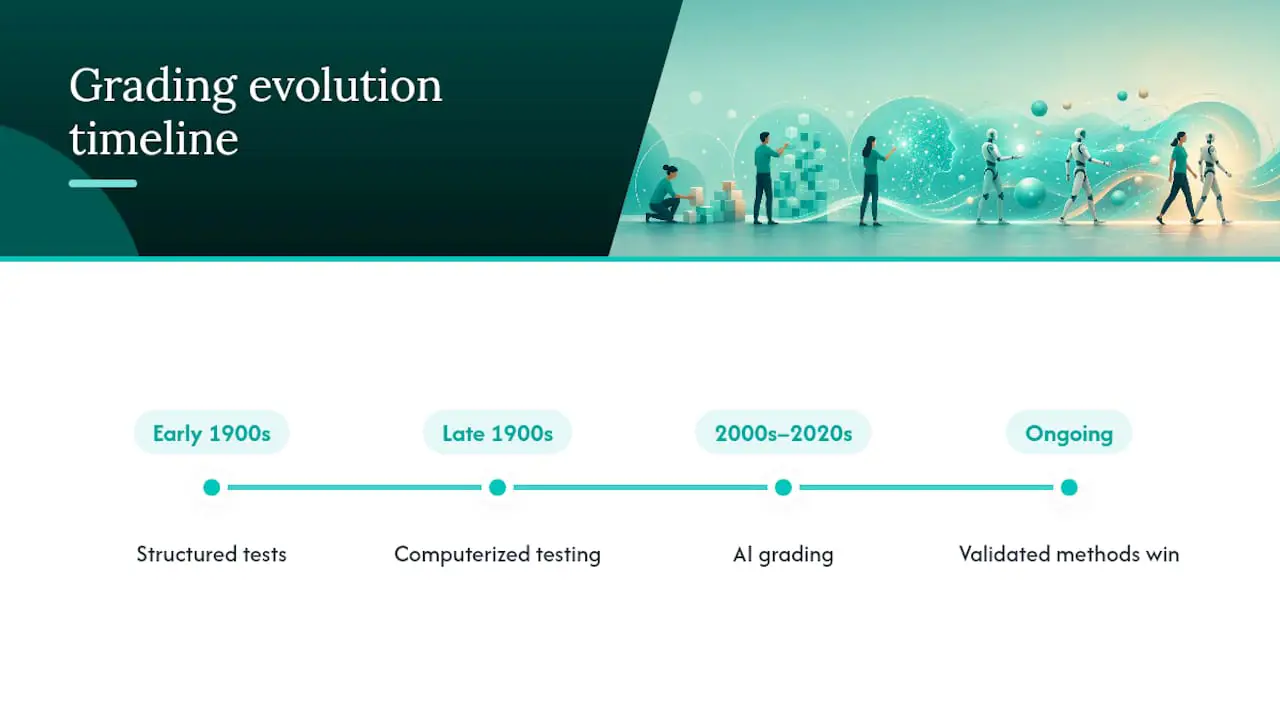
Оценка кандидатов началась не с программного обеспечения. Структурированная оценка при найме восходит к психологии персонала начала XX века, когда работодатели впервые попытались стандартизировать тесты, чтобы снизить зависимость от интуиции и личных рекомендаций. Десятилетия последующих исследований неизменно показывают, что структурированные, связанные с должностью методы — особенно рабочие образцы и структурированные интервью — обеспечивают наиболее прочную связь с реальной производительностью труда, значительно превосходя неструктурированные интервью или отбор по резюме в одиночку.
Следующий крупный сдвиг произошёл с появлением компьютерного тестирования в конце XX века, что позволило работодателям стандартизировать оценку и снизить часть межэкспертной непоследовательности для тестов с вариантами ответов и числовых оценок. Однако открытые задания — письменные образцы, проверка кода, ответы на сценарные вопросы — по-прежнему требовали человека для чтения и оценки, что делало проверку медленной и дорогостоящей в масштабе.
Оценка с помощью ИИ — следующий шаг в той же траектории, а не разрыв с ней. Что изменилось — так это возможность применять последовательные критерии к неструктурированным ответам (письменным ответам, коду и даже видео) со скоростью, недостижимой для любой комиссии из людей. Исследования по сочетанию методов отбора, предшествующие современному ИИ на десятилетия, по-прежнему сохраняют основной урок: валидированные, связанные с должностью тесты превосходят неформальное суждение — будь то оценщик человек или модель. ИИ не изобрёл этот принцип. Он лишь наконец сделал его практически применимым в масштабе.
Этические соображения, специфичные для оценки ИИ и человека
Этические вопросы вокруг оценки с помощью ИИ — это не о том, «понимает» ли машина справедливость. Они о том, выстроили ли люди, внедряющие её, достаточную систему ответственности в процессе. Три проблемы возникают снова и снова.
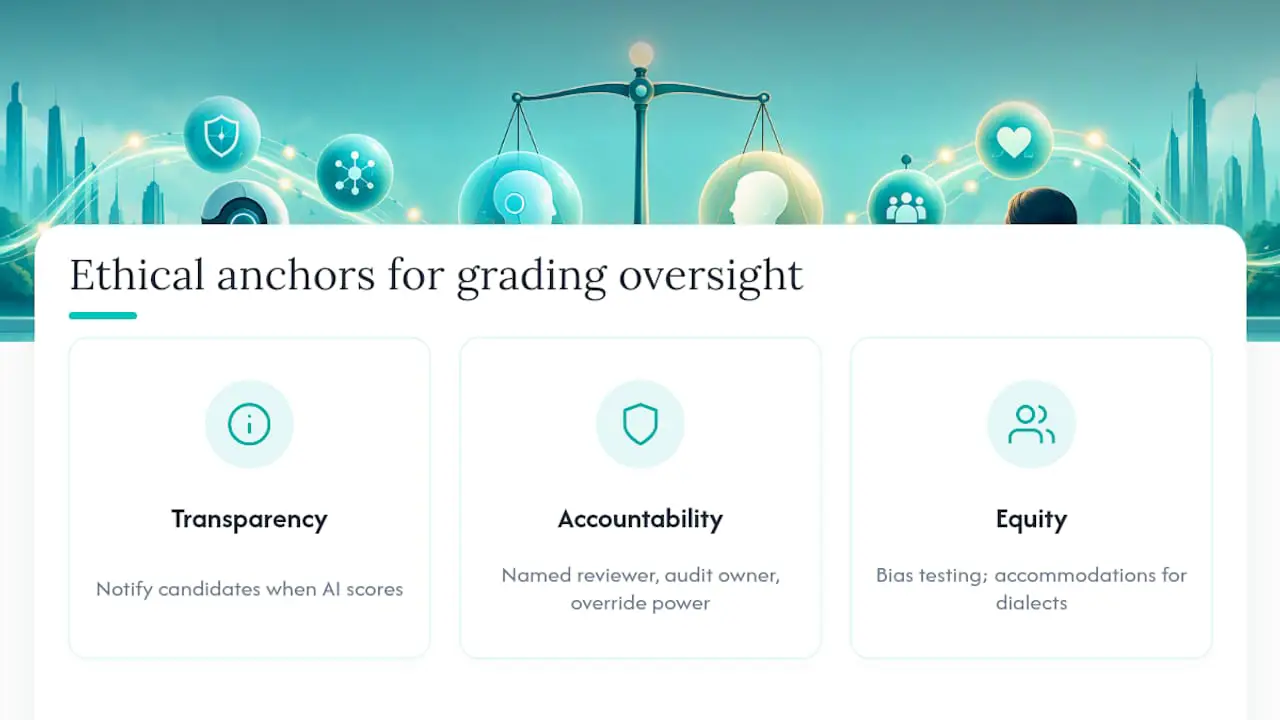
Прозрачность. Кандидаты заслуживают знать, когда ИИ участвует в оценке их работы, и всё большее число законов штатов требует именно такого уведомления. Работодатели, закапывающие это в мелкий шрифт, создают себе юридические риски, а не только этическую проблему.
Ответственность за ошибки. Когда эксперт-человек совершает ошибку, есть конкретное лицо для эскалации. Когда система ИИ неверно оценивает ответ, цепочка ответственности должна быть столь же чёткой: кто проверяет аномальные оценки, кто отвечает за аудит и кто имеет полномочия отменить оценку.
Равенство для кандидатов. Система оценки, обученная без учёта особых условий, диалектных вариаций в письменных ответах или нетрадиционных подходов к решению задач, может незаметно ставить в невыгодное положение квалифицированных кандидатов — и никто не заметит этого, пока аудит на неблагоприятное воздействие не выявит проблему. Оценщики-люди несут свою версию этого риска в виде неосознанной предвзятости — именно поэтому SIOP рассматривает тестирование на предвзятость как техническое требование к любому методу оценки, а не как разовую этическую галочку.
Всё это не аргумент против использования ИИ. Это аргумент в пользу того, чтобы относиться к оценке — любого вида — как к системе, требующей надзора, а не к инструменту, который можно внедрить и забыть.
Почему результаты оценки ИИ сложнее интерпретировать
Эксперт-человек обычно может объяснить оценку одним предложением: «решение кандидата работает, но использует неэффективный подход». Оценку, сгенерированную ИИ, зачастую сложнее разобрать, особенно когда базовая модель взвешивает десятки сигналов, которые рекрутер никогда не видит напрямую.
Это создаёт конкретную проблему интерпретации: оценку без чёткого обоснования трудно отстоять, если кандидат её оспаривает или регулятор спрашивает, как было принято решение. Кроме того, труднее понять, отражает ли низкая оценка реальный пробел в навыках или особенность формулировки ответа кандидата.
Практический ответ — не недоверять каждой оценке ИИ. Нужно требовать объяснимости как базовой функции, а не запоздалого дополнения. Полезная сводка, сгенерированная ИИ, должна показывать, какие конкретные критерии кандидат выполнил или упустил, а не только единое сводное число. Такой уровень детализации позволяет рекрутеру перекрёстно проверить рассуждения ИИ так же, как он проверяет примечания эксперта-человека, и превращает непрозрачную оценку во что-то, за чем руководитель по найму может уверенно стоять при принятии окончательного решения.
Оценка с помощью ИИ для разных должностей и типов навыков
Оценка с помощью ИИ — не единый инструмент, применяемый одинаково везде. Насколько хорошо она работает, зависит от того, что именно тестируется.
Технические оценки и тесты по программированию — область, где оценка с помощью ИИ работает наиболее надёжно. Тест-кейсы либо проходят, либо нет, время выполнения измеримо, а метрики качества кода можно оценивать по чётким критериям — именно та структурированная среда, которую измеряло исследование IT-рекрутинга, когда установило, что ИИ совпадает с человеческими средними оценками при значительно большей скорости.
Структурированные тесты знаний — тесты на соответствие требованиям, тесты на способности, ситуационные тесты суждений с определёнными правильными ответами — почти столь же хорошо подходят для ИИ, поскольку логика оценки практически не отличается от хорошо составленного теста с вариантами ответов.
Задания на письменный ответ и коммуникацию занимают промежуточное положение. ИИ может выявить грамматические ошибки, оценить структуру и то, ответил ли кандидат на вопрос, но суждение о тоне, убедительности или творческом подходе к решению задач всё равно выигрывает от повторного взгляда человека.
Задания для должностей в сфере продаж, обслуживания клиентов и межличностного взаимодействия пока сильно зависят от человека. Эти роли предполагают считывание эмоциональных сигналов и адаптацию по ходу разговора — территория, где критерии оценки с трудом улавливают то, что действительно предсказывает успех на работе.
Руководство Talent Approved по проектированию тестов под конкретную роль создано с учётом соответствия формата оценки тестируемому навыку — именно это и является реальным рычагом при принятии решения о том, какой вес придавать оценке ИИ для той или иной должности.
Прагматичный путь к совместной работе человека и ИИ в оценке
Откажитесь от дискуссии «всё или ничего». Запустите пилот на одной должности, объедините оценки ИИ с экспертным суждением человека через механический синтез, а не выбирайте одно, и проверьте небольшую выборку перед масштабированием на что-либо высокоответственное. Функции платформы, поддерживающие это, — структурированная генерация критериев оценки, мониторинг против списывания, сводки, сгенерированные ИИ, — существуют для того, чтобы ускорить этап проверки человека, а не заменить его. Отслеживайте производительность после найма относительно оценок до найма и корректируйте критерии, когда данные говорят об этом, а не раньше.
— Jimmie
Готовы запустить пилот оценки с помощью ИИ? Начните здесь
Talent Approved создан именно для той гибридной модели, которую рекомендует эта статья: ИИ берёт на себя основную работу по оценке, а финальное решение остаётся за вами. Magic Create превращает описание вакансии в оценку под конкретную роль за несколько минут, встроенный мониторинг против списывания (проверка экрана и веб-камеры, воспроизведение сессии) защищает целостность проверяемого материала, а сводки, сгенерированные ИИ, дают вам читаемую разбивку по каждому кандидату вместо сырых чисел. Ценообразование строится по модели оплаты за использование: $5 за завершённую оценку кандидата, подписка не требуется.
Если вы готовы проверить это должным образом, запустите пилот на 30–90 дней: выберите одну должность, создайте оценку с помощью Magic Create, проверьте каждую работу параллельно с помощью сводки ИИ и эксперта-человека, проведите проверку на неблагоприятное воздействие по результатам и сравните пилотных нанятых сотрудников с данными об их производительности, когда они приступят к работе. Проверьте страницу цен, чтобы оценить масштаб пилота перед тем, как переходить к полному развёртыванию.
Источники
Перед масштабным внедрением оценки с помощью ИИ изучите руководство SIOP по валидации, структуру TEVV-Athlon от NIST и исследование IT-рекрутинга, сравнивающее оценку ИИ и человека. Для понимания меняющихся правовых обязательств стоит прочитать обзор K&L Gates об изменениях в федеральном регулировании.
- ChatGPT против экспертизы человека в контексте IT-рекрутинга
- Соображения и рекомендации по валидации и использованию оценок на основе ИИ для отбора сотрудников (SIOP)
- Пилотный отчёт NIST ARIA 0.1
- Валидность и полезность методов отбора в психологии персонала
Часто задаваемые вопросы
Может ли ИИ полностью заменить оценщиков-людей?
Нет. Исследование, сравнивавшее оценку ИИ и человека в IT-рекрутинге, выявило схожую среднюю точность при более высокой скорости ИИ, тогда как оба показали непоследовательность при повторной оценке. Проверка человека по-прежнему важна для неоднозначных заданий и финальных решений.
Является ли оценка с помощью ИИ юридически защищаемой при принятии решений о найме?
Это возможно, если вы валидируете инструмент и документируете процесс. SIOP рекомендует формальную психометрическую валидацию, а ряд штатов теперь требует уведомления кандидата или его согласия при использовании ИИ в оценке.
Сколько стоит Talent Approved?
Talent Approved взимает $5 за завершённую оценку кандидата по модели оплаты за использование, подписка не требуется.
В чём разница между предвзятостью измерения и предвзятостью прогнозирования?
Предвзятость измерения означает, что тест оценивает разные группы по-разному, несмотря на одинаковый базовый уровень навыков. Предвзятость прогнозирования означает, что результат теста по-разному предсказывает производительность труда в разных группах. SIOP рассматривает их как отдельные, поддающиеся проверке проблемы, а не как одну общую проблему справедливости.
Какие тесты навыков наиболее безопасно оценивать только с помощью ИИ?
Структурированные, объективно оцениваемые тесты — задания по программированию, стандартизированные тесты знаний и ситуационные тесты суждений с определёнными правильными ответами — наилучшим образом подходят для оценки только с помощью ИИ. Открытые письменные ответы и оценки для должностей, требующих межличностного взаимодействия, по-прежнему выигрывают от проверки человека.
Рекомендуемое
- Создание критериев оценки, которые педагоги могут пилотировать и масштабировать с помощью ИИ
- Руководство HR по тестированию на неблагоприятное воздействие в США: запустить, прочитать, исправить
- Пилот Talent Approved за $5: оценки для сравнительного анализа кандидатов для HR
- Роль ИИ в массовом отборе кандидатов: руководство 2026