
HR-playbook for AI vs menneskelig vurdering: 30–90 dagers pilot + 4 TEVV-trinn
AI-vurdering fungerer godt for strukturerte, rollespesifikke ferdighetstester: det gir karakterer raskere enn en person og lander nær de samme gjennomsnittskarakterene. Det bør ikke brukes alene på høyinnsats- eller tvetydige beslutninger. Rammeverk fra SIOP og NISTs TEVV-testtilnærming finnes av en grunn, og plattformer som Talent Approved er bygget rundt å kombinere AI-vurdering med menneskelig gjennomgang, ikke å erstatte den fullstendig.
TL;DR:
- AI-vurdering er mest pålitelig for strukturerte tester som kodingstester og standardiserte kunnskapsquizer, der det finnes klare riktige eller gale svar.
- En hybrid modell med AI i innledende screening og menneskelig gjennomgang for nyanserte eller tvetydige oppgaver gir den beste balansen mellom hastighet og nøyaktighet.
- Både AI og menneskelige sensorer viser inkonsistens ved vurdering av identiske besvarelser, noe som understreker behovet for validering og løpende overvåking.
- Biasrisiko inkluderer målingsbiasog prediktivt bias, som kan reduseres gjennom grundig testing, åpenhet og inkluderende rubrikk-design.
- Å kjøre små pilotprogrammer og sammenligne vurderingsscore med faktisk jobbprestasjon bidrar til å sikre at AI-verktøy er prediktive og rettferdige i ansettelser.
Innholdsfortegnelse
- Slik fungerer AI-vurdering og menneskelig vurdering i ansettelser
- Styrker og begrensninger: Nøyaktighet, hastighet, konsistens og bias
- Validering, testing og styring HR-team må gjennomføre
- Implementeringssjekkliste: Beslutningsregler og måleparametere
- AI-vurderingens innvirkning på kvaliteten på tilbakemeldinger til kandidater
- Fra papirtester til AI-vurdering: En kort historikk
- Etiske betraktninger spesifikt for AI- kontra menneskelig vurdering
- Hvorfor AI-vurderingsresultater er vanskeligere å tolke
- AI-vurdering på tvers av ulike roller og ferdighetstyper
- En pragmatisk vei til samarbeid mellom menneskelig og AI-vurdering
- Klar til å pilotere AI-assistert vurdering? Start her
- Kilder
- FAQ
Slik fungerer AI-vurdering og menneskelig vurdering i ansettelser
AI-vurderingsverktøy bedømmer kandidatarbeid opp mot en rubrikk bygget på treningsetiketter, strukturerte kriterier eller en stillingsbeskrivelse matet inn i systemet. Noen AI-vurderingsplattformer tilbyr funksjoner som bygger rollespesifikke vurderinger og scoringsstrukturer fra stillingsbeskrivelser på minutter, og genererer deretter sammendrag av hver kandidats prestasjoner slik at rekrutterere kan gjennomgå resultatene uten å lese hver innlevering linje for linje. Fordelen er gjennomstrømming: et slikt system kan vurdere hundrevis av kodeeksempler eller skriftlige svar i den tiden én fagekspert gjennomgår en håndfull.
Menneskelig vurdering fungerer annerledes. En fagekspert anvender en rubrikk ved hjelp av skjønn, kontekst og erfaring, noe som er verdifullt for nyanser, men kostbart å skalere. To ting bremser det hver gang: kostnad per kandidat og inter-rater-variabilitet, det vil si at to kvalifiserte sensorer kan score det samme svaret forskjellig avhengig av humør, tretthet eller tolkning av rubrikken.
De fleste arbeidsgivere ender opp med en hybrid modell i stedet for å velge én side. Vanlige mønstre inkluderer:
- AI-først med menneskelige stikkprøver: AI vurderer hver innlevering, og en rekrutterer gjennomgår et utvalg eller eventuelle grensescorer.
- Menneskelig-først for komplekse oppgaver: åpne eller skjønnstunge oppgaver går rett til en person, mens strukturerte oppgaver (kodingstester, matteproblemer, flervalgsspørsmål i logikk) går til AI.
- Mekanisk syntese: menneskelige vurderinger og algoritmiske scorer blandes til ett kombinert resultat, en metode som er vist å bevare prediktiv nøyaktighet samtidig som den øker aksepten hos ansettelsesansvarlige som ønsker en menneskelig sjekk på prosessen.
Styrker og begrensninger: Nøyaktighet, hastighet, konsistens og bias
En fagfellevurdert sammenligning av AI-vurdering og menneskelige eksperter i IT-rekruttering fant ingen signifikant forskjell i gjennomsnittlige score mellom de to. AI vurderte langt raskere, men studien fant også noe mindre flatterende for begge sider: ingen av dem var fullt ut konsistente. AI produserte varierende score når den ble bedt om å revurdere den samme innleveringen, og menneskelige sensorer viste den samme inter-rater-upåliteligheten som har vært dokumentert i ansettingsforskning i tiår.
Hvor hver tilnærming tenderer til å vinne:
- AI vinner på ren hastighet og konsistens på tvers av store kandidatpuljer når oppgaven er strukturert (kodetester, standardiserte oppgavesett).
- Mennesker vinner på kontekst: å gjenkjenne et ukonvensjonelt, men gyldig svar, anvende tilrettelegginger, eller fange opp en kandidat som løste problemet på en annen, men like korrekt måte.
- Ingen vinner fullt ut på repeterbarhet. Både AI og menneskelige sensorer kan gi forskjellige score for det samme arbeidet ved en ny gjennomgang.
Konsistenssjekk: den samme studien som fant at AI matchet menneskelige gjennomsnittsscore, fant også at både AI og menneskelig vurdering viste målbar inkonsistens ved gjentatt evaluering av identiske innleveringer, noe som er grunnen til at en enkelt vurderingsrunde fra en av kildene er et risikabelt grunnlag for en endelig ansettelsesavgjørelse.
Bias fortjener sin egen gjennomgang, fordi «partisk» brukes løst. SIOP skiller det i to distinkte, testbare konsepter: målingsbiasog, der en test presterer ulikt for ulike grupper til tross for lik underliggende ferdighet, og prediktivt bias, der en testscore predikerer jobbprestasjon ulikt på tvers av grupper. Å behandle disse som ett vagt problem er slik arbeidsgivere overser reell risiko. En vanlig feilmodus er mållekkasje, der en modell trenes på en proxyvariabel som korrelerer med et beskyttet kjennetegn fremfor selve ferdigheten. Manglende tilrettelegging for kandidater med nedsatt funksjonsevne er en annen: en AI-rubrikk bygget uten ADA-hensyn kan straffe en legitim alternativ tilnærming som en menneskelig sensor ville gjenkjenne umiddelbart.
Validering, testing og styring HR-team må gjennomføre
Å ta i bruk et AI-vurderingsverktøy uten en testplan er slik arbeidsgivere ender opp med å forsvare et søksmål i stedet for en ansettelsesavgjørelse. NISTs TEVV-Athlon-tilnærming gir en praktisk struktur for dette, bygget rundt fire faser:
- Definer mål. Bestem nøyaktig hva vurderingsverktøyet trenger å måle og hva «god prestasjon» innebærer for rollen.
- Konstruksjonsvalidering. Bekreft at testen faktisk måler ferdigheten den hevder å måle, ikke en løst relatert proxy.
- Bruker- og felttesting. Kjør verktøyet mot virkelige kandidatinnleveringer, inkludert red-teaming-forsøk for å finne hvor det svikter eller scorer urettferdig.
- Syntese av resultater. Kombiner alt til en dokumentert vurdering av om verktøyet er klart for aktiv bruk.
En revisjonssjekkliste verdt å kjøre før lansering og på jevnlig basis etterpå bør inkludere konstruksjons- og praktiske validitetskontroller, testing av uønsket innvirkning på tvers av demografiske grupper, dokumentasjon av etikettekilder og rubrikk-design, tilstrekkelige utvalgsstørrelser før man trekker konklusjoner, og en fast overvåkingsplan snarere enn en engangsgjennomgang. Talent Approveds innebygde veiledning for testing av uønsket innvirkning gir en gjennomgang av hvordan man kjører denne typen sjekk uten statistikkbakgrunn.
Det mest oversette trinnet er integrering av tilbakemeldinger: å koble score fra før ansettelse til hva som faktisk skjer etter ansettelsen. Å sammenligne vurderingsscore med data om opphold og prestasjon gjør en screeningtest til et genuint prediktivt instrument, fremfor et filter man håper virker.
Proffips: Kjør din første valideringssyklus på en rolle du allerede ansetter til ofte. Du vil ha nok historiske prestasjonsdata til å sjekke om vurderingsscoren faktisk predikerte noe, i stedet for å gjette.
Implementeringssjekkliste: Beslutningsregler og måleparametere
Ikke alle tester hører hjemme i samme kategori. En brukbar beslutningsregel ser slik ut:
- Bruk kun AI eller AI-først vurdering for strukturerte kodingstester, standardiserte oppgavesett og høyvolums innledende screening.
- Krev menneskelig gjennomgang for tvetydige fritekst-svar, porteføljeevaluering og enhver avgjørelse i sluttfasen som påvirker et tilbud.
- Bruk hybrid scoring som standard når rollen er høyinnsats, men testformatet fortsatt er strukturert nok til at AI kan håndtere en første gjennomgang.
Når reglene er satt, spor dem med reelle måleparametere i stedet for magefølelse:
- Inter-rater-enighet — Cohens kappa for to-sensor-sammenligninger, eller Fleiss' kappa når flere sensorer er involvert, anvendt på både AI-versus-menneske og menneske-versus-menneske-sammenligninger.
- Undergruppescore-distribusjoner — jevnlig brutt ned etter demografisk kategori for å fange opp målingsbiasog tidlig.
- Prediktive validitetskorrelasjoner — hvor godt score fra før ansettelse faktisk sporer prestasjon etter ansettelse.
- Behandlingstid og feilrate — hvor lang tid vurdering tar og hvor ofte resultater trenger manuell korrigering.
Operasjonelle kontroller er like viktige som måleparametrene i seg selv: gi kandidater varsel der delstatslovgivning krever det, bygg en eskaleringsvei for avvikende score, dokumenter hver revisjon for samsvargjennomgang, og sett en fast omskolingsutløser i stedet for å vente på at en klage tvinger frem saken. Talent Approveds umiddelbare vurderingsscore er bygget med denne typen transparente, revisjonsvennlige rubrikker i tankene.
AI-vurderingens innvirkning på kvaliteten på tilbakemeldinger til kandidater
Raskere vurdering endrer hva kandidater opplever, ikke bare hva rekrutterere ser. En kandidat som fullfører en ferdighetstest og får et resultat i løpet av timer i stedet for to uker, forblir engasjert i prosessen din i stedet for å akseptere et konkurrerende tilbud. AI-genererte sammendrag kan gi rekrutterere en lesbar oversikt over styrker og svakheter per kandidat nesten umiddelbart etter innlevering, noe som forkorter gapet mellom vurdering og neste steg.
Kvaliteten på tilbakemeldingen er et separat spørsmål fra hastigheten på tilbakemeldingen, og det er der AI fortsatt har reelle begrensninger. Et generert sammendrag kan flagge at en kandidats kode feilet visse testtilfeller, eller at et skriftlig svar manglet nøkkelkriterier fra rubrikken. Det sliter med å forklare «hvorfor» med samme tekstur som en dyktig menneskelig sensor bringer, særlig for kreative eller skjønnstunge oppgaver der det riktige svaret ikke er entydig.
Den praktiske løsningen de fleste hybride arbeidsflyter lander på er lagdelte tilbakemeldinger: AI genererer første-gangs-sammendraget umiddelbart, og en rekrutterer eller ansettelsesansvarlig legger til kontekst før det når en kandidat eller ansettelseskomité. Dette bevarer hastighetsfordelen ved automatisert vurdering uten å miste den tolkende nyansen en person tilfører. Det beskytter også mot en mer subtil risiko: at kandidater stoler på et AI-sammendrag som mer autoritativt enn det faktisk er, rett og slett fordi det kom raskt og ser ryddig ut.
Fra papirtester til AI-vurdering: En kort historikk
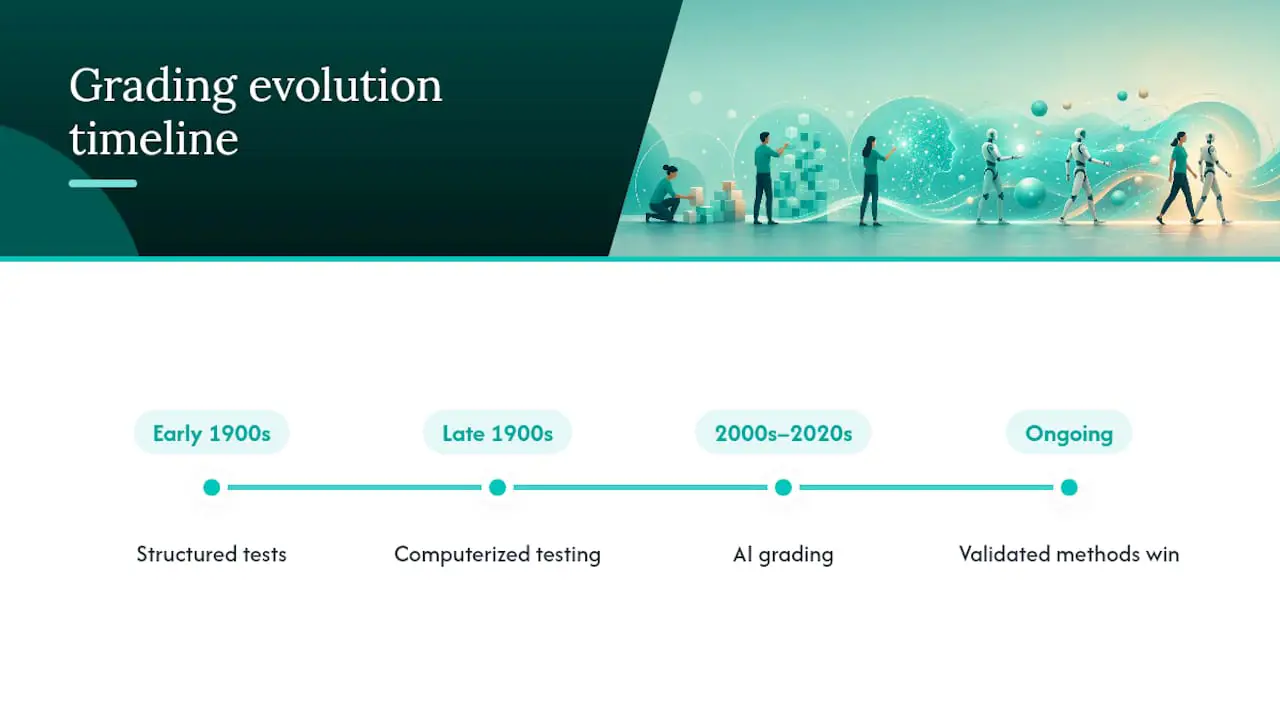
Vurdering av kandidater startet ikke med programvare. Strukturert ansettelsestesting kan spores tilbake til tidlig 1900-talls personellpsykologi, da arbeidsgivere for første gang forsøkte å standardisere tester for å redusere avhengigheten av magefølelse og personlige anbefalinger. Tiår med forskning siden den gang viser konsekvent at strukturerte, jobbrelevante metoder – arbeidseksempler og strukturerte intervjuer spesielt – gir den sterkeste koblingen til faktisk jobbprestasjon, langt overlegent ustrukturerte intervjuer eller CV-screening alene.
Det neste store skiftet kom med datastyrt testing på slutten av 1900-tallet, som lot arbeidsgivere standardisere scoring og redusere noe inter-rater-inkonsistens for flervalgsspørsmål og numeriske vurderinger. Men åpne oppgaver – skriveeksempler, kodegjennomgang, scenariosvar – trengte fortsatt et menneske til å lese og bedømme dem, noe som holdt vurdering langsom og kostbar i stor skala.
AI-vurdering er neste steg i den samme trajektorien, ikke et brudd fra den. Det som endret seg er evnen til å anvende en konsistent rubrikk på ustrukturerte svar (skriftlige svar, kode, til og med video) med en hastighet intet menneskelig panel kan matche. Forskningen på å kombinere utvelgelsesmetoder som er eldre enn moderne AI med tiår, holder fortsatt den underliggende lærdommen: validerte, jobbrelevante tester slår uformelt skjønn, enten det er en person eller en modell som vurderer. AI fant ikke opp dette prinsippet. Den gjorde det bare endelig praktisk å anvende det i stor skala.
Etiske betraktninger spesifikt for AI- kontra menneskelig vurdering
De etiske spørsmålene rundt AI-vurdering handler egentlig ikke om hvorvidt en maskin «forstår» rettferdighet. De handler om hvorvidt menneskene som tar den i bruk, har bygget nok ansvarlighet inn i prosessen. Tre problemer dukker opp gjentatte ganger.
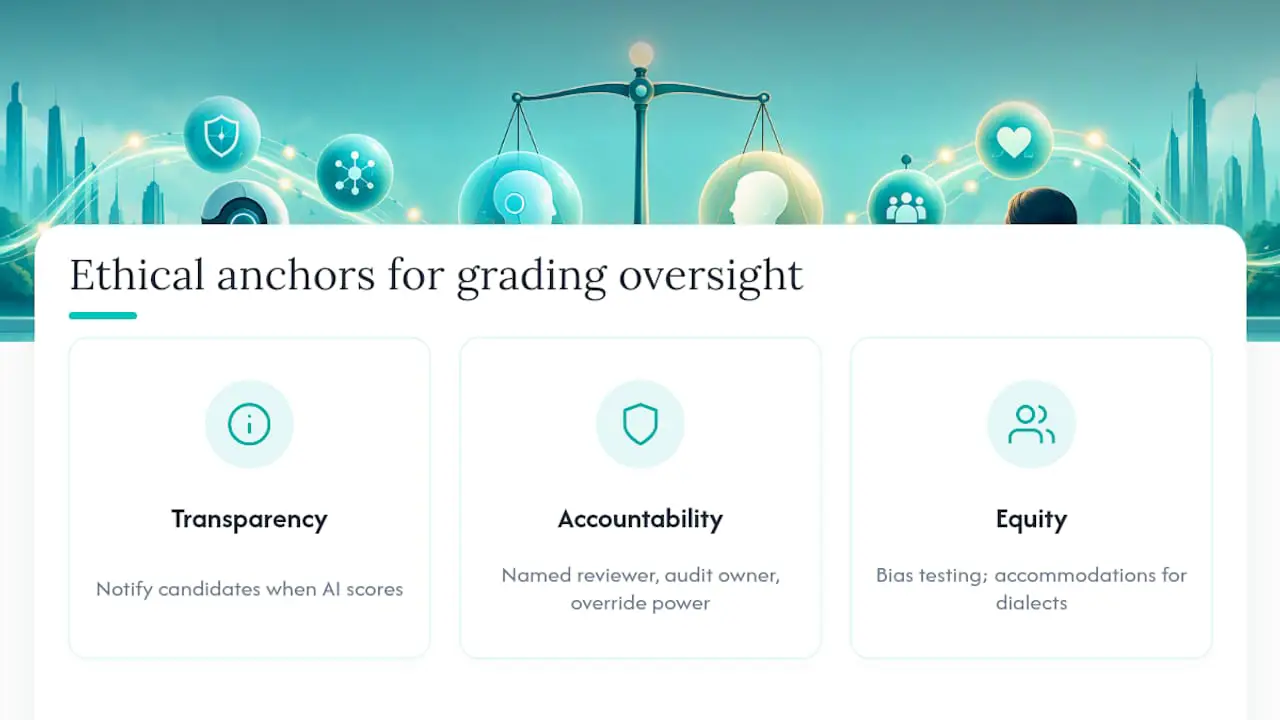
Åpenhet. Kandidater fortjener å vite når AI er involvert i vurderingen av arbeidet deres, og et voksende antall delstatslover krever nettopp denne typen varsel. Arbeidsgivere som begravde dette i liten skrift, skaper juridisk eksponering, ikke bare et etisk problem.
Ansvarlighet for feil. Når en menneskelig sensor gjør en feil, er det en person å eskalere til. Når et AI-system feilvurderer et svar, må ansvarsfordelingen være like klar: hvem gjennomgår avvikere, hvem eier revisjonen, og hvem har myndighet til å overstyre en score.
Likeverd på tvers av kandidater. Et vurderingssystem trent uten oppmerksomhet på tilrettelegging, dialektvariasjon i skriftlige svar, eller utradisjonelle problemløsningstilnærminger, kan stille dyktige kandidater i en stille ulempe uten at noen legger merke til det, inntil en revisjon av uønsket innvirkning avdekker det. Menneskelige sensorer bærer sin egen versjon av denne risikoen gjennom ubevisst bias, noe som er nøyaktig grunnen til at SIOP behandler biastesting som et teknisk krav for begge vurderingsmetoder, ikke en engangs etisk avkryssing.
Ingenting av dette argumenterer mot å bruke AI. Det argumenterer for å behandle vurdering, av begge slag, som et system som trenger tilsyn, ikke et verktøy man tar i bruk og glemmer.
Hvorfor AI-vurderingsresultater er vanskeligere å tolke
En menneskelig sensor kan vanligvis forklare en score i en setning: «kandidatens løsning fungerte, men brukte en ineffektiv tilnærming.» En AI-generert score er ofte vanskeligere å pakke opp, særlig når den underliggende modellen veier dusinvis av signaler en rekrutterer aldri ser direkte.
Dette skaper et spesifikt tolkningsproblem: en score uten en klar begrunnelse er vanskelig å forsvare hvis en kandidat utfordrer den, eller en regulator spør om hvordan en beslutning ble tatt. Det er også vanskeligere å vite om en lav score gjenspeiler et reelt ferdighetsgap eller en særegenhet i måten kandidaten formulerte et svar på.
Det praktiske svaret er ikke å mistre tilliten til enhver AI-score. Det er å kreve forklarbarhet som en grunnleggende funksjon, ikke en ettertanke. Et nyttig AI-generert sammendrag bør vise hvilke spesifikke kriterier en kandidat oppfylte eller ikke oppfylte, ikke bare ett enkelt sammensatt tall. Det detaljeringsnivået lar en rekrutterer kryssjekke AI-ens resonnement på samme måte som de ville kontrollere en menneskelig sensors notater, og det gjør en ugjennomsiktig score til noe en ansettelsesansvarlig faktisk kan stå inne for i en endelig beslutning.
AI-vurdering på tvers av ulike roller og ferdighetstyper
AI-vurdering er ikke ett verktøy anvendt uniformt. Hvor godt det fungerer, varierer avhengig av hva som testes.
Tekniske og kodingsvurderinger er der AI-vurdering presterer mest pålitelig. Testtilfeller består eller feiler enten, utføringstid er målbar, og kodekvalitetsmålinger kan scores opp mot klare kriterier, noe som er nøyaktig det strukturerte miljøet IT-rekrutteringsstudien målte da den fant at AI matchet menneskelige gjennomsnittsscore med langt høyere hastighet.
Strukturerte kunnskapstester, samsvarquizer, evnetester, situasjonelle vurderingstester med definerte riktige svar, er nesten like godt egnet, siden scoringslogikken knapt skiller seg fra en godt bygget flervalgsprøve.
Skriftlige svar og kommunikasjonsoppgaver befinner seg i midten. AI kan flagge grammatikk, struktur og om et svar adresserte spørsmålet, men å bedømme tone, overbevisningskraft eller kreativ problemløsning har fortsatt nytte av en menneskelig andregjennomgang.
Salg, kundeservice og mellommenneskelige rolleoppgaver lener seg tungt mot mennesker foreløpig. Disse rollene avhenger av å lese emosjonelle signaler og tilpasse seg midt i en samtale, et område der en rubrikk sliter med å fange opp hva som faktisk predikerer suksess i jobben.
Talent Approveds veiledning for rollespesifikk testdesign er bygget rundt å matche vurderingsformatet med ferdigheten som testes, noe som er den reelle spaken for å avgjøre hvor mye vekt man skal legge på AI-vurdering for en gitt rolle.
En pragmatisk vei til samarbeid mellom menneskelig og AI-vurdering
Hopp over alt-eller-ingenting-debatten. Kjør en pilot på én rolle, bland AI-score med menneskelig skjønn gjennom mekanisk syntese fremfor å velge én, og revider et lite utvalg før du skalerer til noe høyinnsats. Plattformfunksjoner som støtter dette – strukturert rubrikk-generering, anti-juks-overvåking, AI-genererte sammendrag – eksisterer for å gjøre det menneskelige gjennomgangstrinnet raskere, ikke for å erstatte det. Spor prestasjon etter ansettelse mot score fra før ansettelse og juster rubrikken når dataene forteller deg det, ikke før.
— Jimmie
Klar til å pilotere AI-assistert vurdering? Start her
Talent Approved er bygget for nøyaktig den hybride modellen denne artikkelen anbefaler: AI gjør den tunge løftingen på scoring, og du beholder den endelige avgjørelsen. Magic Create gjør en stillingsbeskrivelse om til en rollespesifikk vurdering på minutter, innebygd anti-juks-overvåking (skjerm- og webkamerasjekker, øktavspillinger) beskytter integriteten til det du vurderer, og AI-genererte sammendrag gir deg en lesbar oversikt per kandidat i stedet for et råtall. Prissettingen kjøres på en betal-per-bruk-modell til $5 per fullført kandidatvurdering, uten abonnement nødvendig.
Hvis du er klar til å teste dette skikkelig, kjør en pilot på 30 til 90 dager: velg én rolle, generer vurderingen med Magic Create, score hver innlevering med både AI-sammendrag og en menneskelig sensor parallelt, kjør en sjekk for uønsket innvirkning på tvers av resultatene, og sammenlign pilotansettelser mot prestasjonsdata når de er i jobben. Sjekk prissiden for å planlegge piloten din før du forplikter deg til en full utrulling.
Kilder
Før du ruller ut AI-vurdering i stor skala, gjennomgå SIOPs valideringsveiledning, NISTs TEVV-Athlon-rammeverk og IT-rekrutteringsstudien som sammenligner AI og menneskelig vurdering. For utviklende juridiske forpliktelser er K&L Gates' sammendrag av skiftende føderal veiledning verdt en lesning.
- ChatGPT vs menneskelig ekspertise i konteksten av IT-rekruttering
- Betraktninger og anbefalinger for validering og bruk av AI-baserte vurderinger for ansettelse av ansatte (SIOP)
- NIST ARIA 0.1 pilotrapport
- Gyldigheten og nytten av utvelgelsesmetoder i personellpsykologi
FAQ
Kan AI erstatte menneskelige sensorer fullstendig?
Nei. Forskning som sammenligner AI og menneskelig vurdering i IT-rekruttering fant lignende gjennomsnittlig nøyaktighet, men raskere AI-hastighet, mens begge viste inkonsistens ved gjentatt scoring. Menneskelig gjennomgang er fortsatt viktig for tvetydige oppgaver og avgjørelser i sluttfasen.
Er AI-vurdering juridisk forsvarlig for ansettelsesavgjørelser?
Det kan det være, hvis du validerer verktøyet og dokumenterer prosessen. SIOP anbefaler formell psykometrisk validering, og flere delstater krever nå varsel eller samtykke fra kandidater når AI brukes i scoring.
Hva koster Talent Approved?
Talent Approved tar $5 per fullført kandidatvurdering på betal-per-bruk-basis, uten abonnement nødvendig.
Hva er forskjellen mellom målingsbiasog og prediktivt bias?
Målingsbiasog betyr at en test scorer ulikt på tvers av grupper til tross for lik underliggende ferdighet. Prediktivt bias betyr at scoren predikerer jobbprestasjon ulikt etter gruppe. SIOP behandler disse som separate, testbare problemer, ikke ett generelt rettferdighetsproblem.
Hvilke ferdighetstester er tryggest å vurdere med AI alene?
Strukturerte, objektivt scorede tester – kodingsutfordringer, standardiserte kunnskapsquizer og situasjonelle vurderingstester med definerte riktige svar – er den sikreste egnetheten for AI-enkel vurdering. Åpne skriftlige svar og mellommenneskelige rollevurderinger har fortsatt nytte av menneskelig gjennomgang.