
دليل HR لتقييم الذكاء الاصطناعي مقابل البشر: تجربة 30-90 يومًا و4 خطوات TEVV
يعمل التصحيح بالذكاء الاصطناعي بشكل جيد في الاختبارات المهارية المهيكلة والخاصة بأدوار محددة: فهو يُصحح بسرعة أكبر من الإنسان ويُقرب من المتوسطات ذاتها في الدرجات. غير أنه لا ينبغي أن يعمل منفرداً في القرارات الحساسة أو الغامضة. وإطارات العمل الصادرة عن SIOP ومنهج اختبار TEVV الصادر عن NIST موجودة لسبب وجيه، والمنصات مثل Talent Approved مبنية على مبدأ إقران التصحيح بالذكاء الاصطناعي مع المراجعة البشرية، لا على الاستغناء عن الإنسان كلياً.
ملخص سريع:
- التصحيح بالذكاء الاصطناعي أكثر موثوقية في التقييمات المهيكلة كاختبارات البرمجة والاختبارات المعرفية الموحدة، حيث تكون الإجابات الصحيحة والخاطئة واضحة تماماً.
- النموذج الهجين الذي يوظف الذكاء الاصطناعي في الفرز الأولي ومراجعة الإنسان للمهام الدقيقة أو الغامضة يوفر أفضل توازن بين السرعة والدقة.
- يُظهر كل من الذكاء الاصطناعي والمصححين البشريين تفاوتاً في تصحيح الإجابات المتطابقة، مما يؤكد ضرورة التحقق والمراقبة المستمرة.
- مخاطر التحيز تشمل التحيز في القياس والتحيز التنبؤي، ويمكن التخفيف منهما من خلال الاختبار الشامل والشفافية وتصميم معايير تصحيح شاملة.
- تشغيل برامج تجريبية صغيرة ومقارنة درجات التقييم بالأداء الوظيفي الفعلي يساعد في ضمان عدالة أدوات الذكاء الاصطناعي وقدرتها التنبؤية في عملية التوظيف.
جدول المحتويات
- كيف يعمل التصحيح بالذكاء الاصطناعي والتصحيح البشري في التوظيف
- نقاط القوة والقيود: الدقة، والسرعة، والاتساق، والتحيز
- التحقق والاختبار والحوكمة التي يجب على فرق الموارد البشرية تطبيقها
- قائمة تحقق التنفيذ: قواعد القرار والمقاييس
- أثر التصحيح بالذكاء الاصطناعي على جودة التغذية الراجعة للمرشحين
- من الاختبارات الورقية إلى التصحيح بالذكاء الاصطناعي: تاريخ موجز
- الاعتبارات الأخلاقية الخاصة بالتصحيح بالذكاء الاصطناعي مقابل التصحيح البشري
- لماذا يصعب تفسير نتائج التصحيح بالذكاء الاصطناعي
- التصحيح بالذكاء الاصطناعي عبر الأدوار وأنواع المهارات المختلفة
- مسار عملي لتعاون التصحيح البشري والذكاء الاصطناعي معاً
- هل أنت مستعد لتجربة التصحيح بمساعدة الذكاء الاصطناعي؟ ابدأ من هنا
- المصادر
- الأسئلة الشائعة
كيف يعمل التصحيح بالذكاء الاصطناعي والتصحيح البشري في التوظيف
تُصحح أدوات الذكاء الاصطناعي أعمال المرشحين وفق معايير تصحيح مبنية على تسميات التدريب أو معايير مهيكلة أو وصف وظيفي يُغذَّى في النظام. توفر بعض منصات التقييم بالذكاء الاصطناعي ميزات تبني تقييمات خاصة بكل دور وهياكل تصحيح مستخرجة من الأوصاف الوظيفية في دقائق، ثم تُنشئ ملخصات لأداء كل مرشح حتى يتمكن المجندون من مراجعة النتائج دون الحاجة إلى قراءة كل تقديم سطراً بسطر. الميزة تكمن في الإنتاجية: يستطيع نظام كهذا تصحيح مئات من نماذج الكود أو الإجابات الكتابية في الوقت الذي يراجع فيه خبير واحد في الموضوع حفنة منها.
يعمل التصحيح البشري بشكل مختلف. يُطبّق خبير في الموضوع معايير التصحيح مستخدماً حكمه وسياقه وخبرته، وهو أمر ذو قيمة للدقة في الفروق الدقيقة لكنه مكلف التوسع. شيئان يُبطئانه في كل مرة: التكلفة لكل مرشح وتباين المقيّمين، أي أن مراجعَين مؤهلَين قد يمنحان الإجابة ذاتها درجات مختلفة بحسب المزاج أو التعب أو تفسير معيار التصحيح.
يلجأ معظم أصحاب العمل إلى نموذج هجين بدلاً من اختيار جانب واحد. تشمل الأنماط الشائعة:
- الذكاء الاصطناعي أولاً مع فحوصات بشرية دورية: يُصحح الذكاء الاصطناعي كل تقديم، ويراجع المجند عيّنة منها أو أي درجات حدية.
- الإنسان أولاً للمهام المعقدة: تذهب الأسئلة المفتوحة أو تلك التي تتطلب تقديراً مباشرةً إلى شخص، بينما تذهب المهام المهيكلة (اختبارات البرمجة، ومسائل الرياضيات، والأسئلة المنطقية متعددة الاختيارات) إلى الذكاء الاصطناعي.
- التوليف الآلي: تُمزج تقييمات المقيّمين البشريين والدرجات الخوارزمية في مخرج مشترك واحد، وهو أسلوب يُثبت الحفاظ على الدقة التنبؤية مع تحسين قبول مديري التوظيف الذين يريدون رقابة بشرية على العملية.
نقاط القوة والقيود: الدقة، والسرعة، والاتساق، والتحيز
وجدت مقارنة محكّمة بين التصحيح بالذكاء الاصطناعي والخبراء البشريين في مجال التوظيف في تقنية المعلومات أنه لا يوجد فرق جوهري في متوسط الدرجات بين الطرفين. وقد صحّح الذكاء الاصطناعي بسرعة أكبر بكثير، لكن الدراسة كشفت أيضاً عن شيء أقل إطراءً لكلا الجانبين: لم يكن أيٌّ منهما متسقاً تماماً. أنتج الذكاء الاصطناعي درجات متباينة عند إعادة تصحيح التقديم ذاته، وأظهر المراجعون البشريون عدم الموثوقية بين المقيّمين ذاتها التي وُثّقت في أبحاث التوظيف لعقود.
أين يتفوق كل نهج:
- يتفوق الذكاء الاصطناعي على صعيد السرعة الخام والاتساق عبر مجموعات كبيرة من المرشحين حين تكون المهمة مهيكلة (اختبارات الكود، ومجموعات المسائل الموحدة).
- يتفوق البشر على صعيد السياق: التعرف على إجابة غير تقليدية لكنها صحيحة، وتطبيق التيسيرات، أو اكتشاف مرشح حلّ المسألة بطريقة مختلفة لكن صحيحة بالقدر ذاته.
- لا يتفوق أيٌّ منهما بشكل قاطع على صعيد القابلية للتكرار. يمكن أن يُنتج كل من مصحح الذكاء الاصطناعي والمصحح البشري درجات مختلفة للعمل ذاته في مرور ثانٍ.
التحقق من الاتساق: الدراسة ذاتها التي وجدت أن الذكاء الاصطناعي يُطابق متوسط الدرجات البشرية وجدت أيضاً أن كلاً من التصحيح بالذكاء الاصطناعي والتصحيح البشري أظهر تفاوتاً ملحوظاً عند إعادة تقييم التقديمات المتطابقة، وهو السبب في أن مرور تصحيح واحد من أي مصدر يُشكّل أساساً محفوفاً بالمخاطر لقرار توظيف نهائي.
يستحق التحيز تحليلاً خاصاً به، لأن مصطلح "متحيز" يُستخدم باتساع. تُفصّل SIOP بين مفهومين مختلفين وقابلَين للاختبار: التحيز في القياس، حيث يؤدي الاختبار بشكل مختلف لمجموعات مختلفة رغم تساوي المهارة الجوهرية، والتحيز التنبؤي، حيث تتنبأ درجة الاختبار بالأداء الوظيفي بشكل مختلف عبر المجموعات. التعامل مع هذين المفهومين بوصفهما مشكلة واحدة غامضة هو كيف يُغفل أصحاب العمل المخاطر الحقيقية. نمط الإخفاق الشائع هو تسرب الهدف، حيث يتدرب النموذج على متغير بديل يرتبط بخاصية محمية بدلاً من المهارة ذاتها. إغفال التيسيرات للمرشحين ذوي الإعاقة مثال آخر: معيار تصحيح مبني بالذكاء الاصطناعي دون مراعاة اعتبارات ADA يمكن أن يُعاقب نهجاً بديلاً مشروعاً سيتعرف عليه المراجع البشري على الفور.
التحقق والاختبار والحوكمة التي يجب على فرق الموارد البشرية تطبيقها
نشر أداة تصحيح بالذكاء الاصطناعي دون خطة اختبار هو الطريق الذي ينتهي به أصحاب العمل إلى الدفاع عن دعوى قضائية بدلاً من قرار توظيف. يمنح نهج NIST TEVV-Athlon هيكلاً عملياً لذلك، مبنياً على أربع مراحل:
- تحديد الأهداف. حدد بدقة ما تحتاج أداة التصحيح إلى قياسه وكيف يبدو "الأداء الجيد" للدور.
- التحقق من البناء. تأكد أن الاختبار يقيس فعلاً المهارة التي يدّعيها، لا متغيراً بديلاً ذا صلة فضفاضة.
- اختبار المستخدم والميداني. شغّل الأداة على تقديمات مرشحين حقيقيين، بما في ذلك محاولات الاختبار الحمراء للعثور على حالات الإخفاق أو التصحيح غير العادل.
- تجميع النتائج. ادمج كل شيء في حكم موثق حول ما إذا كانت الأداة جاهزة للاستخدام الفعلي.
قائمة التدقيق الجديرة بالتطبيق قبل الإطلاق وبصفة دورية بعده ينبغي أن تشمل: فحوصات صلاحية البناء والصلاحية العملية، واختبار الأثر السلبي عبر الفئات الديموغرافية، وتوثيق مصادر التسميات وتصميم معيار التصحيح، وأحجام عينات كافية قبل استخلاص الاستنتاجات، وجدول مراقبة ثابت بدلاً من مراجعة لمرة واحدة. يشرح دليل اختبار الأثر السلبي المدمج في Talent Approved كيفية إجراء هذا النوع من الفحوصات دون الحاجة إلى خلفية إحصائية.
الخطوة الأكثر إغفالاً هي دمج التغذية الراجعة: ربط الدرجات قبل التوظيف بما يحدث فعلاً بعد التوظيف. مقارنة درجات التقييم ببيانات الاحتفاظ والأداء تحوّل اختبار الفرز إلى أداة تنبؤية حقيقية، بدلاً من مرشح تأمل أنه يعمل.
نصيحة احترافية: أجرِ دورة التحقق الأولى على دور تُوظّف له بانتظام. ستمتلك بيانات أداء تاريخية كافية للتحقق مما إذا كانت درجة التقييم تنبأت بشيء فعلاً، بدلاً من التخمين.
قائمة تحقق التنفيذ: قواعد القرار والمقاييس
ليس كل اختبار ينتمي إلى الفئة ذاتها. قاعدة قرار عملية تبدو هكذا:
- استخدم التصحيح بالذكاء الاصطناعي حصراً أو أولاً لاختبارات البرمجة المهيكلة، ومجموعات المسائل الموحدة، والفرز الأولي عالي الحجم.
- اشترط المراجعة البشرية للردود النصية الحرة الغامضة، وتقييم المحافظ، وأي قرار في المرحلة النهائية يؤثر على عرض وظيفة.
- افترض التصحيح الهجين كلما كان الدور حساساً لكن تنسيق الاختبار مهيكل بما يكفي لمعالجة الذكاء الاصطناعي للمرحلة الأولى.
بمجرد وضع القواعد، تتبعها بمقاييس حقيقية بدلاً من الحدس:
- الاتفاق بين المقيّمين — كابا كوهين لمقارنات المقيّمَين الاثنين، أو كابا فليس عند تعدد المقيّمين، مُطبَّقاً على مقارنات الذكاء الاصطناعي مقابل الإنسان والإنسان مقابل الإنسان على حد سواء.
- توزيعات درجات المجموعات الفرعية — تُقسَّم بانتظام حسب الفئة الديموغرافية لرصد التحيز في القياس مبكراً.
- ارتباطات الصلاحية التنبؤية — مدى تتبع درجات ما قبل التوظيف للأداء الفعلي بعد التوظيف.
- وقت المعالجة ومعدل الخطأ — كم يستغرق التصحيح وكم مرة تحتاج المخرجات إلى تصحيح يدوي.
الضوابط التشغيلية لا تقل أهمية عن المقاييس ذاتها: أخطر المرشحين حيث يستوجب قانون الولاية ذلك، وابنِ مساراً للتصعيد للدرجات الشاذة، ووثّق كل عملية تدقيق لمراجعة الامتثال، وحدد إطاراً زمنياً ثابتاً لإعادة التدريب بدلاً من انتظار شكوى تُجبرك على التحرك. التصحيح الفوري للتقييمات في Talent Approved مبني على هذا النوع من معيار التصحيح الشفاف والقابل للتدقيق.
أثر التصحيح بالذكاء الاصطناعي على جودة التغذية الراجعة للمرشحين
التصحيح الأسرع يُغيّر ما يمر به المرشحون، لا ما يراه المجندون فحسب. المرشح الذي يُنهي اختبار مهارات ويحصل على نتيجته في غضون ساعات بدلاً من أسبوعين يبقى منخرطاً في عمليتك بدلاً من قبول عرض منافس. يمكن أن تمنح الملخصات التي يُنشئها الذكاء الاصطناعي المجندين تحليلاً مقروءاً لنقاط القوة والثغرات لكل مرشح تقريباً فور التقديم، مما يُقصّر الفجوة بين التقييم والخطوات التالية.
جودة التغذية الراجعة سؤال منفصل عن سرعتها، وهنا لا يزال الذكاء الاصطناعي يواجه قيوداً حقيقية. يمكن للملخص المُنشأ أن يُشير إلى أن كود المرشح فشل في بعض حالات الاختبار أو أن الرد الكتابي أغفل معايير رئيسية من معيار التصحيح. لكنه يُكافح لشرح "السبب" بالعمق ذاته الذي يمنحه مراجع بشري ماهر، لا سيما للمهام الإبداعية أو تلك التي تتطلب تقديراً حيث لا تكون الإجابة الصحيحة واحدة.
الحل العملي الذي تصله معظم سير العمل الهجينة هو التغذية الراجعة الطبقية: يُنشئ الذكاء الاصطناعي ملخص المرحلة الأولى فوراً، ويُضيف المجند أو مدير التوظيف السياق قبل أن يصل إلى المرشح أو لجنة التوظيف. يحافظ هذا على ميزة السرعة للتصحيح الآلي دون فقدان الدقة التفسيرية التي يمنحها الإنسان. كما يحمي من مخاطرة أدق: ثقة المرشحين في ملخص الذكاء الاصطناعي بوصفه أكثر موثوقية مما هو عليه فعلاً، ببساطة لأنه وصل بسرعة ويبدو مرتباً.
من الاختبارات الورقية إلى التصحيح بالذكاء الاصطناعي: تاريخ موجز
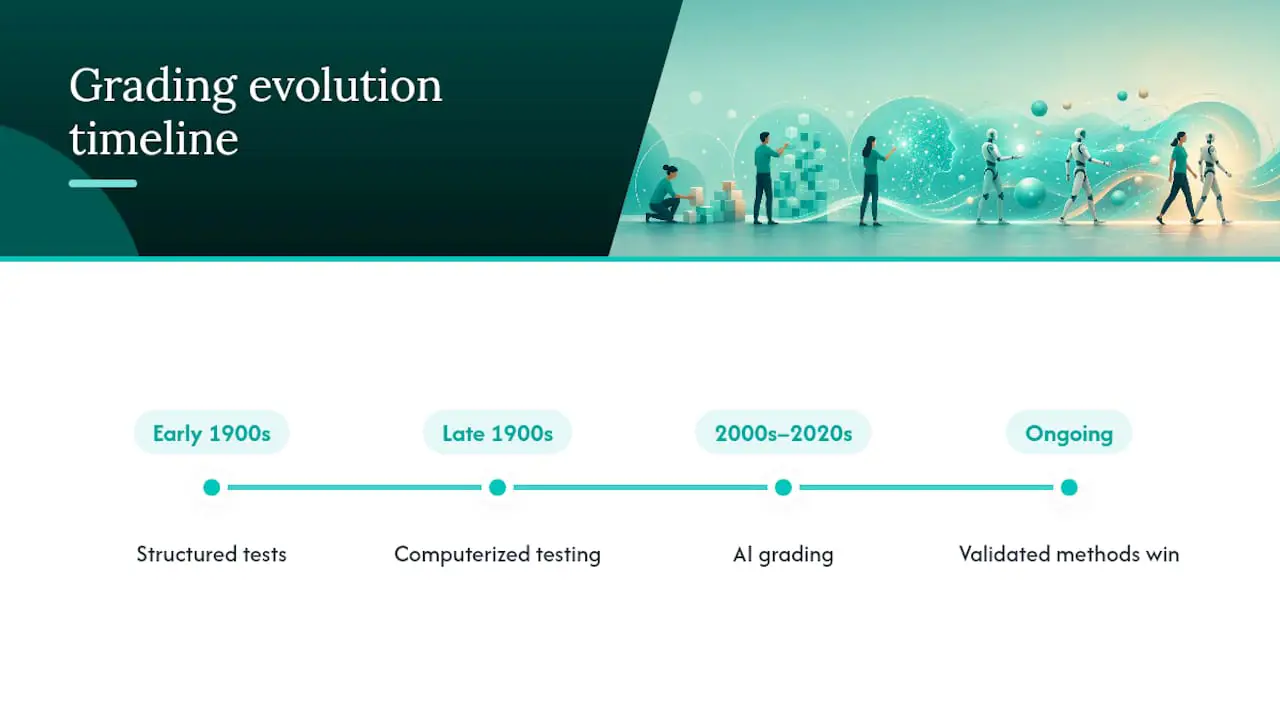
لم يبدأ تصحيح المرشحين مع البرمجيات. يعود تقييم التوظيف المهيكل إلى علم نفس الموظفين في أوائل القرن العشرين، حين حاول أصحاب العمل لأول مرة توحيد الاختبارات للحد من الاعتماد على الحدس وعلاقات التوصية الشخصية. عقود من الأبحاث منذ ذلك الحين تُظهر باستمرار أن الأساليب المهيكلة ذات الصلة بالوظيفة، لا سيما نماذج العمل والمقابلات المهيكلة، تُنتج أقوى صلة بالأداء الوظيفي الفعلي، وتتفوق بفارق كبير على المقابلات غير المهيكلة أو فرز السير الذاتية وحدها.
جاء التحول الكبير التالي مع الاختبارات المحوسبة في أواخر القرن العشرين، مما أتاح لأصحاب العمل توحيد التصحيح والحد من بعض التفاوت بين المقيّمين في تقييمات الاختيار من متعدد والأرقام. لكن المهام المفتوحة، عينات الكتابة ومراجعة الكود وردود السيناريوهات، لا تزال تحتاج إلى إنسان يقرأها ويحكم عليها، مما أبقى التصحيح بطيئاً ومكلفاً على نطاق واسع.
التصحيح بالذكاء الاصطناعي هو الخطوة التالية في هذا المسار ذاته، وليس قطيعة معه. ما تغيّر هو القدرة على تطبيق معيار تصحيح متسق على الردود غير المهيكلة (الإجابات الكتابية، والكود، وحتى الفيديو) بسرعة لا يمكن لأي لجنة بشرية مجاراتها. الأبحاث حول الجمع بين أساليب الاختيار التي سبقت الذكاء الاصطناعي الحديث بعقود لا تزال تحمل الدرس الجوهري: الاختبارات الموثقة ذات الصلة بالوظيفة تتفوق على الحكم غير الرسمي، سواء كان المصحح إنساناً أو نموذجاً. الذكاء الاصطناعي لم يخترع هذا المبدأ. بل جعل تطبيقه على نطاق واسع ممكناً أخيراً.
الاعتبارات الأخلاقية الخاصة بالتصحيح بالذكاء الاصطناعي مقابل التصحيح البشري
الأسئلة الأخلاقية المحيطة بالتصحيح بالذكاء الاصطناعي لا تتعلق حقاً بما إذا كانت الآلة "تفهم" العدالة. بل تتعلق بما إذا كان البشر الذين ينشرونها بنوا قدراً كافياً من المساءلة في العملية. ثلاث مسائل تطفو مراراً.
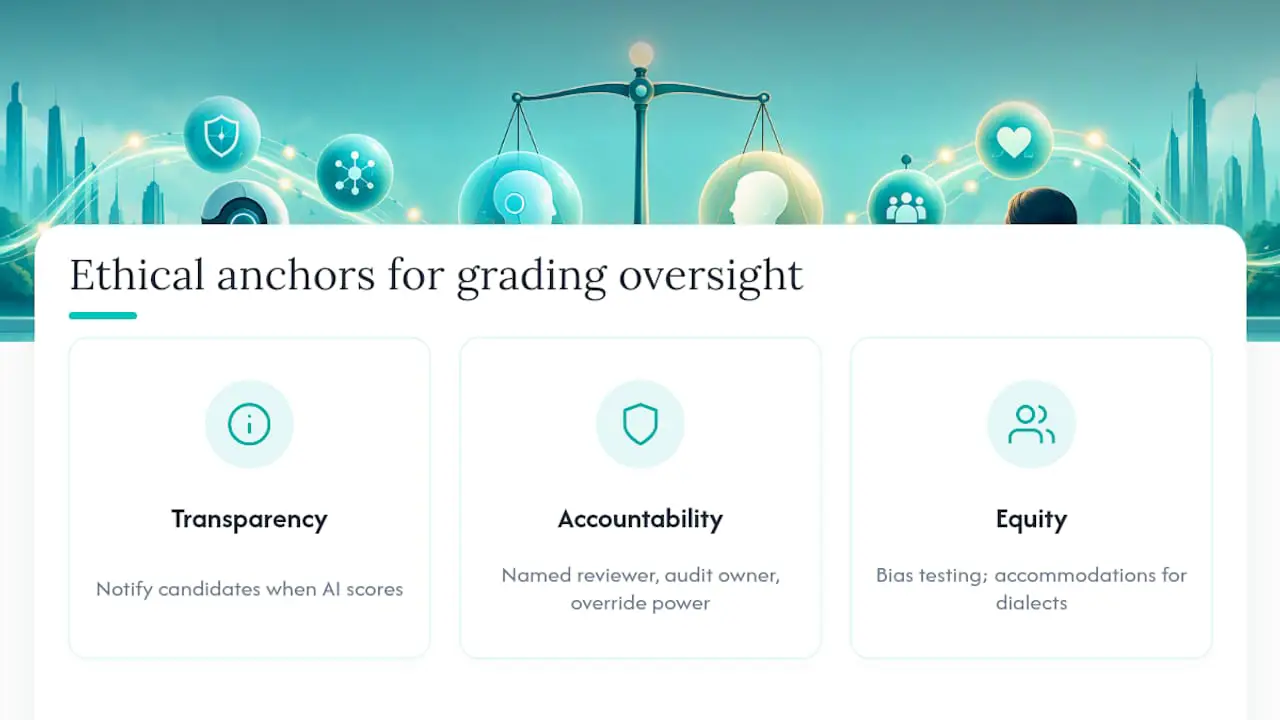
الشفافية. يستحق المرشحون معرفة متى يكون الذكاء الاصطناعي متورطاً في تصحيح أعمالهم، وعدد متزايد من قوانين الولايات يستوجب بالضبط هذا النوع من الإخطار. أصحاب العمل الذين يدفنون هذا في الحروف الدقيقة يخلقون تعرضاً قانونياً، لا مجرد مشكلة أخلاقية.
المساءلة عن الأخطاء. حين يرتكب مصحح بشري خطأً، ثمة شخص يمكن التصعيد إليه. حين يُخطئ نظام ذكاء اصطناعي في تصحيح رد ما، تحتاج سلسلة المساءلة إلى أن تكون بالوضوح ذاته: من يراجع الحالات الشاذة، ومن يملك عملية التدقيق، ومن لديه صلاحية تجاوز الدرجة.
الإنصاف عبر المرشحين. نظام تصحيح مُدرَّب دون مراعاة التيسيرات، أو التباين اللهجي في الردود الكتابية، أو أساليب حل المشكلات غير التقليدية، يمكن أن يضع المرشحين المؤهلين في موضع أضعف بهدوء دون أن يلاحظ أحد حتى تكتشفه عملية تدقيق الأثر السلبي. يحمل المصححون البشريون نسختهم الخاصة من هذه المخاطرة عبر التحيز اللاواعي، وهو بالضبط سبب تعامل SIOP مع اختبار التحيز كمتطلب تقني لأي من طريقتي التصحيح، لا مجرد خانة أخلاقية لمرة واحدة.
لا يُجادل شيء من هذا ضد استخدام الذكاء الاصطناعي. بل يُجادل لصالح التعامل مع التصحيح، بأي نوعيه، بوصفه نظاماً يحتاج إلى إشراف، لا أداة تنشرها وتنسى أمرها.
لماذا يصعب تفسير نتائج التصحيح بالذكاء الاصطناعي
يستطيع المصحح البشري في الغالب تفسير درجة ما في جملة واحدة: "حل المرشح المسألة لكنه اتبع نهجاً غير فعّال." أما الدرجة التي يُنشئها الذكاء الاصطناعي فغالباً ما يصعب تفكيكها، لا سيما حين يزن النموذج الأساسي عشرات الإشارات التي لا يراها المجند مباشرةً.
هذا يخلق مشكلة تفسير محددة: الدرجة بلا مبرر واضح يصعب الدفاع عنها إذا طعن فيها مرشح أو سأل جهة تنظيمية عن كيفية اتخاذ القرار. كما يصعب معرفة ما إذا كانت الدرجة المنخفضة تعكس ثغرة مهارية حقيقية أو غرابة في طريقة صياغة المرشح لإجابته.
الجواب العملي ليس انعدام الثقة في كل درجة يُنتجها الذكاء الاصطناعي. بل هو المطالبة بإمكانية التفسير كميزة أساسية، لا فكرة لاحقة. ينبغي أن يُظهر الملخص المفيد الذي يُنشئه الذكاء الاصطناعي المعايير المحددة التي استوفاها المرشح أو أخفق فيها، لا مجرد رقم مركّب واحد. هذا المستوى من التفصيل يُمكّن المجند من التحقق من منطق الذكاء الاصطناعي بالطريقة ذاتها التي يُدقق بها في ملاحظات مراجع بشري، ويحوّل درجة غامضة إلى شيء يمكن لمدير التوظيف الوقوف خلفه بثقة في القرار النهائي.
التصحيح بالذكاء الاصطناعي عبر الأدوار وأنواع المهارات المختلفة
التصحيح بالذكاء الاصطناعي ليس أداة واحدة مُطبَّقة بشكل موحد. يتغير مدى فاعليته بحسب ما يُختبر.
تقييمات التقنية والبرمجة هي الأكثر موثوقية للتصحيح بالذكاء الاصطناعي. حالات الاختبار إما تنجح أو تفشل، ووقت التنفيذ قابل للقياس، ومقاييس جودة الكود قابلة للتصحيح وفق معايير واضحة، وهو بالضبط البيئة المهيكلة التي قاستها دراسة التوظيف في تقنية المعلومات حين وجدت أن الذكاء الاصطناعي يُطابق متوسط الدرجات البشرية بسرعة أكبر بكثير.
اختبارات المعرفة المهيكلة، اختبارات الامتثال، واختبارات القدرة، واختبارات الحكم الظرفي ذات الإجابات الصحيحة المحددة، تُعدّ ملاءمة قوية بالقدر ذاته تقريباً، إذ تكاد تكون منطق التصحيح مطابقاً لامتحان اختيار من متعدد محكم البناء.
مهام الرد الكتابي والتواصل تقع في المنتصف. يستطيع الذكاء الاصطناعي رصد القواعد اللغوية والبنية ومدى تناول الرد للموضوع، لكن الحكم على النبرة أو القدرة الإقناعية أو حل المشكلات الإبداعي لا يزال يستفيد من نظرة ثانية بشرية.
مهام المبيعات وخدمة العملاء والأدوار التفاعلية تميل بثقل نحو البشر في الوقت الراهن. تعتمد هذه الأدوار على قراءة الإشارات العاطفية والتكيف في منتصف المحادثة، وهو ميدان يُكافح فيه معيار التصحيح لالتقاط ما يتنبأ فعلاً بالنجاح في العمل.
دليل تصميم الاختبارات الخاصة بكل دور في Talent Approved مبني على مطابقة تنسيق التقييم بالمهارة المُختبَرة، وهو الرافعة الحقيقية لتحديد مقدار الوزن الذي يمكن منحه للتصحيح بالذكاء الاصطناعي لأي دور معين.
مسار عملي لتعاون التصحيح البشري والذكاء الاصطناعي معاً
تخطّ نقاش كل شيء أو لا شيء. أجرِ تجربة على دور واحد، ادمج درجات الذكاء الاصطناعي مع الحكم البشري عبر التوليف الآلي بدلاً من اختيار أحدهما، وراجع عيّنة صغيرة قبل التوسع في أي شيء حساس. ميزات المنصة التي تدعم هذا، توليد معيار تصحيح مهيكل، ومراقبة مكافحة الغش، والملخصات التي يُنشئها الذكاء الاصطناعي، موجودة لجعل خطوة المراجعة البشرية أسرع، لا لاستبدالها. تتبع أداء ما بعد التوظيف مقارنةً بدرجات ما قبل التوظيف وعدّل معيار التصحيح حين تُخبرك البيانات بذلك، لا قبل ذلك.
— Jimmie
هل أنت مستعد لتجربة التصحيح بمساعدة الذكاء الاصطناعي؟ ابدأ من هنا
Talent Approved مبنية بالضبط للنموذج الهجين الذي توصي به هذه المقالة: الذكاء الاصطناعي يتولى العبء الأكبر في التصحيح، وأنت تحتفظ بالقرار النهائي. تحوّل Magic Create الوصف الوظيفي إلى تقييم خاص بالدور في دقائق، ومراقبة مكافحة الغش المدمجة (فحوصات الشاشة والكاميرا وإعادة تشغيل الجلسة) تحمي سلامة ما تُصحّحه، والملخصات التي يُنشئها الذكاء الاصطناعي تمنحك تحليلاً مقروءاً لكل مرشح بدلاً من رقم خام. يعمل التسعير بنموذج الدفع حسب الاستخدام بـ 5 دولارات لكل تقييم مرشح مُكتمل، دون الحاجة إلى اشتراك.
إذا كنت مستعداً لاختبار هذا بشكل صحيح، أجرِ تجربة من 30 إلى 90 يوماً: اختر دوراً واحداً، وأنشئ التقييم باستخدام Magic Create، وصحّح كل تقديم بالملخص الذي يُنشئه الذكاء الاصطناعي ومراجع بشري بالتوازي، وأجرِ فحص الأثر السلبي على النتائج، وقارن التوظيفات التجريبية ببيانات الأداء بمجرد انضمامهم إلى العمل. راجع صفحة التسعير لتحديد نطاق تجربتك قبل الالتزام بطرح شامل.
المصادر
قبل طرح التصحيح بالذكاء الاصطناعي على نطاق واسع، راجع دليل التحقق الصادر عن SIOP وإطار NIST TEVV-Athlon والدراسة التي تُقارن التصحيح بالذكاء الاصطناعي والتصحيح البشري في مجال التوظيف في تقنية المعلومات. أما بالنسبة للالتزامات القانونية المتطورة، فـملخص K&L Gates للتوجيه الفيدرالي المتحول يستحق القراءة.
- ChatGPT مقابل الخبرة البشرية في سياق التوظيف في تقنية المعلومات
- اعتبارات وتوصيات للتحقق من التقييمات القائمة على الذكاء الاصطناعي واستخدامها في اختيار الموظفين (SIOP)
- تقرير NIST ARIA 0.1 التجريبي
- صلاحية وفائدة أساليب الاختيار في علم نفس الموظفين
الأسئلة الشائعة
هل يمكن للذكاء الاصطناعي استبدال المصححين البشريين كلياً؟
لا. وجدت الأبحاث التي تُقارن التصحيح بالذكاء الاصطناعي والتصحيح البشري في مجال التوظيف في تقنية المعلومات دقة متوسطة مماثلة مع سرعة أكبر للذكاء الاصطناعي، في حين أظهر كلاهما تفاوتاً عند إعادة التصحيح. لا تزال المراجعة البشرية مهمة للمهام الغامضة والقرارات في المراحل النهائية.
هل التصحيح بالذكاء الاصطناعي قابل للدفاع عنه قانونياً في قرارات التوظيف؟
يمكن أن يكون، إذا تحققت من صحة الأداة ووثّقت العملية. توصي SIOP بالتحقق النفسي القياسي الرسمي، وعدد من الولايات تشترط الآن إخطار المرشح أو الحصول على موافقته عند استخدام الذكاء الاصطناعي في التصحيح.
كم تكلف Talent Approved؟
تفرض Talent Approved رسوماً بقيمة 5 دولارات لكل تقييم مرشح مُكتمل على أساس الدفع حسب الاستخدام، دون الحاجة إلى اشتراك.
ما الفرق بين التحيز في القياس والتحيز التنبؤي؟
التحيز في القياس يعني أن الاختبار يمنح درجات مختلفة عبر المجموعات رغم تساوي المهارة الجوهرية. التحيز التنبؤي يعني أن الدرجة تتنبأ بالأداء الوظيفي بشكل مختلف عبر المجموعات. تعامل SIOP مع هذين المفهومين كمسألتين منفصلتين وقابلتين للاختبار، لا مجرد مشكلة عدالة عامة واحدة.
أي اختبارات المهارات أأمن للتصحيح بالذكاء الاصطناعي وحده؟
الاختبارات المهيكلة والمصحَّحة بشكل موضوعي، وتحديات البرمجة، واختبارات المعرفة الموحدة، واختبارات الحكم الظرفي ذات الإجابات الصحيحة المحددة، هي الأنسب للتصحيح بالذكاء الاصطناعي وحده. الردود الكتابية المفتوحة وتقييمات الأدوار التفاعلية لا تزال تستفيد من المراجعة البشرية.