
AI بمقابلہ انسانی گریڈنگ کے لیے HR پلے بک: 30–90 دن کا پائلٹ + 4 TEVV اقدامات
AI گریڈنگ ڈھانچہ بند، کردار کے مطابق مہارت کے ٹیسٹوں کے لیے اچھی طرح کام کرتی ہے: یہ کسی انسان کی نسبت تیز اسکور کرتی ہے اور اوسط نمبروں کے قریب ہی پہنچتی ہے۔ اسے اکیلے اعلیٰ دباؤ والے یا غیر واضح فیصلوں پر نہیں چلانا چاہیے۔ SIOP اور NIST کے TEVV جانچ کے طریقہ کار کے فریم ورک ایک وجہ سے موجود ہیں، اور Talent Approved جیسے پلیٹ فارم AI اسکورنگ کو انسانی جائزے کے ساتھ جوڑنے کے لیے بنائے گئے ہیں، نہ کہ اسے مکمل طور پر ختم کرنے کے لیے۔
مختصراً:
- AI گریڈنگ ڈھانچہ بند جائزوں جیسے کوڈنگ ٹیسٹ اور معیاری علمی کوئزز کے لیے سب سے زیادہ قابلِ اعتماد ہے، جہاں واضح صحیح یا غلط جوابات موجود ہوتے ہیں۔
- ایک ہائبرڈ ماڈل، جس میں ابتدائی اسکریننگ کے لیے AI اور پیچیدہ یا غیر واضح کاموں کے لیے انسانی جائزہ شامل ہو، رفتار اور درستگی کا بہترین توازن فراہم کرتا ہے۔
- AI اور انسانی دونوں گریڈرز ایک جیسی جمع کردہ مواد کو اسکور کرنے میں عدم مستقل مزاجی دکھاتے ہیں، جو توثیق اور مسلسل نگرانی کی ضرورت کو اجاگر کرتا ہے۔
- تعصب کے خطرات میں پیمائشی تعصب اور پیش گوئی کا تعصب شامل ہیں، جنہیں مکمل جانچ، شفافیت اور جامع ضابطہ بندی کے ذریعے کم کیا جا سکتا ہے۔
- چھوٹے پائلٹ پروگرام چلانا اور جائزہ اسکوروں کا اصل ملازمتی کارکردگی سے موازنہ کرنا اس بات کو یقینی بنانے میں مدد دیتا ہے کہ AI ٹولز بھرتی میں پیش گوئی کرنے والے اور منصفانہ ہیں۔
فہرستِ مضامین
- بھرتی میں AI گریڈنگ اور انسانی گریڈنگ کیسے کام کرتی ہے
- خوبیاں اور حدود: درستگی، رفتار، مستقل مزاجی اور تعصب
- توثیق، جانچ اور گورننس جو HR ٹیموں کو چلانی چاہیے
- نفاذ کی چیک لسٹ: فیصلہ سازی کے اصول اور پیمانے
- امیدواروں کے لیے فیڈبیک کے معیار پر AI گریڈنگ کا اثر
- کاغذی ٹیسٹ سے AI اسکورنگ تک: ایک مختصر تاریخ
- AI بمقابلہ انسانی گریڈنگ سے متعلق اخلاقی تحفظات
- AI گریڈنگ کے نتائج کی تشریح کیوں مشکل ہے
- مختلف کرداروں اور مہارت کی اقسام میں AI گریڈنگ
- انسانی اور AI گریڈنگ کے مل کر کام کرنے کا عملی راستہ
- AI معاونت سے گریڈنگ کا پائلٹ چلانے کے لیے تیار ہیں؟ یہاں سے شروع کریں
- ماخذ
- اکثر پوچھے جانے والے سوالات
بھرتی میں AI گریڈنگ اور انسانی گریڈنگ کیسے کام کرتی ہے
AI گریڈنگ ٹولز امیدوار کے کام کو تربیتی لیبلز، ڈھانچہ بند معیاروں، یا سسٹم میں فیڈ کی گئی ملازمت کی تفصیل سے بنائے گئے ضابطے کے مطابق اسکور کرتے ہیں۔ کچھ AI جائزہ پلیٹ فارم ایسی خصوصیات فراہم کرتے ہیں جو ملازمت کی تفصیلات سے منٹوں میں کردار کے مطابق جائزے اور اسکورنگ کے ڈھانچے بناتے ہیں، پھر ہر امیدوار کی کارکردگی کا خلاصہ تیار کرتے ہیں تاکہ بھرتی کار ہر جمع کردہ مواد کو لائن بائی لائن پڑھے بغیر نتائج کا جائزہ لے سکیں۔ فائدہ تھرو پٹ میں ہے: اس طرح کا سسٹم اتنے وقت میں سیکڑوں کوڈ کے نمونوں یا تحریری جوابات کو گریڈ کر سکتا ہے جتنے میں ایک واحد موضوع کا ماہر چند کا جائزہ لیتا ہے۔
انسانی گریڈنگ مختلف طریقے سے کام کرتی ہے۔ ایک موضوع کا ماہر فیصلے، سیاق و سباق اور تجربے سے ضابطہ لاگو کرتا ہے، جو باریکیوں کے لیے قیمتی ہے لیکن پیمانے کے لیے مہنگا ہے۔ دو چیزیں ہر بار اسے سست کرتی ہیں: فی امیدوار لاگت اور انٹر ریٹر تغیر پذیری، یعنی دو اہل جائزہ کار ایک ہی جواب کو موڈ، تھکاوٹ، یا ضابطے کی تشریح کے اختلاف کی بنا پر مختلف طریقے سے اسکور کر سکتے ہیں۔
زیادہ تر آجر ایک طرف چننے کی بجائے ہائبرڈ ماڈل پر پہنچتے ہیں۔ عام نمونوں میں شامل ہیں:
- AI-پہلے اور انسانی جانچ کے ساتھ: AI ہر جمع کردہ مواد کو گریڈ کرتا ہے، اور بھرتی کار ایک نمونے یا کسی بھی حد پر اسکور کا جائزہ لیتا ہے۔
- پیچیدہ کاموں کے لیے انسان-پہلے: کھلے سوالات یا فیصلے پر بھاری پرامپٹ سیدھے کسی شخص کے پاس جاتے ہیں، جبکہ ڈھانچہ بند کام (کوڈنگ ٹیسٹ، ریاضی کے مسائل، ملٹی پل چوائس لاجک) AI کے پاس جاتے ہیں۔
- میکانکی ترکیب: انسانی جائزہ کاروں اور الگورتھمک اسکوروں کو ایک مشترکہ نتیجے میں ملایا جاتا ہے، یہ طریقہ پیش گوئی کی درستگی کو برقرار رکھتے ہوئے بھرتی کے مینیجروں کی قبولیت کو بہتر بناتا ہے جو عمل پر انسانی نگاہ چاہتے ہیں۔
خوبیاں اور حدود: درستگی، رفتار، مستقل مزاجی اور تعصب
IT بھرتی میں AI گریڈنگ کا انسانی ماہرین سے ہم مرتبہ جائزہ کردہ موازنہ میں دونوں کے درمیان اوسط اسکوروں میں کوئی اہم فرق نہیں پایا گیا۔ AI نے بہت تیزی سے گریڈ کیا، لیکن مطالعے میں دونوں کے لیے کچھ کم تملق انگیز بات بھی پائی گئی: دونوں میں سے کوئی بھی مکمل طور پر مستقل نہیں تھا۔ AI نے ایک ہی جمع کردہ مواد کو دوبارہ گریڈ کرنے پر مختلف اسکور دیے، اور انسانی جائزہ کاروں نے وہی انٹر ریٹر غیر قابلِ اعتماد دکھائی جو بھرتی کی تحقیق میں دہائیوں سے دستاویز کی گئی ہے۔
جہاں ہر نقطہ نظر فتح کا رجحان رکھتا ہے:
- AI خام رفتار اور بڑے امیدوار پول میں مستقل مزاجی پر جیتتا ہے جب کام ڈھانچہ بند ہو (کوڈ ٹیسٹ، معیاری مسئلہ مجموعے)۔
- انسان سیاق و سباق پر جیتتے ہیں: کسی غیر روایتی لیکن درست جواب کو پہچاننا، رہائشیں لاگو کرنا، یا ایسے امیدوار کو پکڑنا جس نے مسئلہ مختلف لیکن یکساں درست طریقے سے حل کیا۔
- دہرانے کی صلاحیت پر کوئی بھی مکمل طور پر نہیں جیتتا۔ AI اور انسانی دونوں گریڈرز ایک ہی کام کے دوسرے جائزے پر مختلف اسکور دے سکتے ہیں۔
مستقل مزاجی کی جانچ: جس مطالعے میں پایا گیا کہ AI نے انسانی اوسط اسکور سے مماثلت رکھی، اسی میں یہ بھی پایا گیا کہ AI اور انسانی دونوں گریڈنگ نے ایک جیسی جمع کردہ مواد کی بار بار تشخیص میں قابلِ پیمائش عدم مستقل مزاجی دکھائی، یہی وجہ ہے کہ کسی بھی ذریعے سے ایک بار کی گریڈنگ حتمی بھرتی کے فیصلے کی بنیاد کے لیے خطرناک ہے۔
تعصب اپنی الگ وضاحت کا مستحق ہے، کیونکہ "متعصب" کو ڈھیلے ڈھالے طریقے سے استعمال کیا جاتا ہے۔ SIOP اسے دو الگ، قابلِ جانچ تصورات میں تقسیم کرتا ہے: پیمائشی تعصب، جہاں ایک ٹیسٹ برابر بنیادی مہارت کے باوجود مختلف گروہوں کے لیے مختلف طریقے سے کام کرتا ہے، اور پیش گوئی کا تعصب، جہاں ٹیسٹ اسکور گروہوں میں ملازمتی کارکردگی کو مختلف طریقے سے پیش گوئی کرتا ہے۔ ان دونوں کو ایک مبہم مسئلے کے طور پر سمجھنا وہ طریقہ ہے جس سے آجر حقیقی خطرے سے چوک جاتے ہیں۔ ایک عام ناکامی کا طریقہ ہدف کا رسنا ہے، جہاں ایک ماڈل ایک پراکسی متغیر پر تربیت لیتا ہے جو مہارت کی بجائے کسی محفوظ خصوصیت سے منسلک ہوتا ہے۔ معذوری والے امیدواروں کے لیے رہائشوں کا فقدان ایک اور مسئلہ ہے: ADA تحفظات کے بغیر بنائی گئی AI ضابطہ بندی ایک جائز متبادل نقطہ نظر کو سزا دے سکتی ہے جسے ایک انسانی جائزہ کار فوری طور پر پہچان لیتا۔
توثیق، جانچ اور گورننس جو HR ٹیموں کو چلانی چاہیے
جانچ کے منصوبے کے بغیر AI گریڈنگ ٹول تعینات کرنا وہ طریقہ ہے جس سے آجر بھرتی کے فیصلے کے بجائے مقدمے کا دفاع کرتے ہوئے پاتے ہیں۔ NIST کا TEVV-Athlon طریقہ اس کے لیے ایک عملی ڈھانچہ فراہم کرتا ہے، جو چار مراحل پر مبنی ہے:
- اہداف متعین کریں۔ فیصلہ کریں کہ گریڈنگ ٹول کو بالکل کیا پیمائش کرنی ہے اور کردار کے لیے "اچھی کارکردگی" کیسی دکھتی ہے۔
- تعمیراتی توثیق۔ تصدیق کریں کہ ٹیسٹ واقعی وہ مہارت پیمائش کرتا ہے جس کا یہ دعویٰ کرتا ہے، نہ کہ کوئی ڈھیلا متعلقہ پراکسی۔
- صارف اور فیلڈ جانچ۔ ٹول کو حقیقی امیدوار کے جمع کردہ مواد کے خلاف چلائیں، بشمول ریڈ ٹیمنگ کی کوششیں تاکہ معلوم ہو کہ یہ کہاں ٹوٹتا یا غیر منصفانہ اسکور دیتا ہے۔
- نتائج کی ترکیب کریں۔ سب کچھ ایک دستاویزی فیصلے میں یکجا کریں کہ آیا ٹول براہ راست استعمال کے لیے تیار ہے۔
ایک آڈٹ چیک لسٹ جو لانچ سے پہلے اور اس کے بعد باقاعدہ وقفوں پر چلانے کے قابل ہے، اس میں تعمیراتی اور عملی درستگی کی جانچ، آبادیاتی گروہوں میں منفی اثرات کی جانچ، لیبل ذرائع اور ضابطہ بندی کی دستاویزسازی، نتائج اخذ کرنے سے پہلے مناسب نمونے کے حجم، اور ایک بار کے جائزے کی بجائے ایک مقررہ نگرانی کا شیڈول شامل ہونا چاہیے۔ Talent Approved کی بلٹ ان منفی اثرات کی جانچ کی رہنمائی اس طرح کی جانچ چلانے کا طریقہ بیان کرتی ہے بغیر شماریاتی پس منظر کے۔
سب سے زیادہ نظرانداز کیا جانے والا قدم فیڈبیک انضمام ہے: بھرتی سے پہلے کے اسکوروں کو اصل میں جو بھرتی کے بعد ہوتا ہے اس سے جوڑنا۔ جائزہ اسکوروں کا برقراری اور کارکردگی کے ڈیٹا سے موازنہ کرنا ایک اسکریننگ ٹیسٹ کو ایک حقیقی پیش گوئی کرنے والے آلے میں بدل دیتا ہے، بجائے اس کے کہ ایک فلٹر ہو جس کے کام کرنے کی آپ امید کرتے ہیں۔
پرو ٹپ: اپنا پہلا توثیق کا چکر اس کردار پر چلائیں جس کے لیے آپ پہلے سے کثرت سے بھرتی کرتے ہیں۔ آپ کے پاس یہ جانچنے کے لیے کافی تاریخی کارکردگی ڈیٹا ہوگا کہ آیا جائزہ اسکور نے واقعی کچھ پیش گوئی کی، اندازہ لگانے کی بجائے۔
نفاذ کی چیک لسٹ: فیصلہ سازی کے اصول اور پیمانے
ہر ٹیسٹ ایک ہی بالٹی میں نہیں آتا۔ ایک قابلِ عمل فیصلے کا اصول اس طرح دکھتا ہے:
- ڈھانچہ بند کوڈنگ ٹیسٹوں، معیاری مسئلہ مجموعوں، اور زیادہ حجم والی ابتدائی اسکریننگ کے لیے صرف AI یا AI-پہلے گریڈنگ استعمال کریں۔
- غیر واضح آزاد متن کے جوابات، پورٹ فولیو تشخیص، اور کسی بھی حتمی مرحلے کے فیصلے جو پیشکش کو متاثر کرتے ہیں، کے لیے انسانی جائزہ لازمی کریں۔
- جب بھی کردار اعلیٰ خطرے والا ہو لیکن ٹیسٹ کا فارمیٹ اب بھی اتنا ڈھانچہ بند ہو کہ AI پہلا جائزہ سنبھال سکے، ہائبرڈ اسکورنگ کو بطور ڈیفالٹ اپنائیں۔
ایک بار اصول طے ہو جائیں، تو انہیں پیٹ کی احساس کی بجائے حقیقی پیمانوں سے ٹریک کریں:
- انٹر ریٹر معاہدہ — دو ریٹر موازنوں کے لیے Cohen's kappa، یا جب زیادہ ریٹر شامل ہوں Fleiss' kappa، AI بمقابلہ انسان اور انسان بمقابلہ انسان دونوں موازنوں پر لاگو۔
- ذیلی گروہ اسکور تقسیم — پیمائشی تعصب کو جلد پکڑنے کے لیے آبادیاتی زمرے کے لحاظ سے باقاعدگی سے علیحدہ کریں۔
- پیش گوئی کی درستگی کے ارتباط — بھرتی سے پہلے کے اسکور بھرتی کے بعد کی کارکردگی کو کتنی اچھی طرح ٹریک کرتے ہیں۔
- پروسیسنگ کا وقت اور غلطی کی شرح — گریڈنگ میں کتنا وقت لگتا ہے اور آؤٹ پٹ کو کتنی بار دستی اصلاح کی ضرورت ہوتی ہے۔
آپریشنل کنٹرولز پیمانوں کی طرح ہی اہم ہیں: امیدواروں کو وہاں نوٹس دیں جہاں ریاستی قانون کی ضرورت ہو، غیر معمولی اسکوروں کے لیے ایسکلیشن کا راستہ بنائیں، تعمیل جائزے کے لیے ہر آڈٹ کی دستاویزسازی کریں، اور شکایت کا انتظار کرنے کی بجائے ایک مقررہ دوبارہ تربیت کا محرک طے کریں۔ Talent Approved کی فوری جائزہ اسکورنگ اس طرح کی شفاف، قابلِ آڈٹ ضابطہ بندی کو ذہن میں رکھ کر بنائی گئی ہے۔
امیدواروں کے لیے فیڈبیک کے معیار پر AI گریڈنگ کا اثر
تیز گریڈنگ اس بات کو بدلتی ہے جو امیدوار تجربہ کرتے ہیں، نہ صرف وہ جو بھرتی کار دیکھتے ہیں۔ ایک امیدوار جو مہارت کا ٹیسٹ مکمل کرتا ہے اور دو ہفتوں کی بجائے چند گھنٹوں میں نتیجہ پاتا ہے وہ آپ کے عمل میں منگن رہتا ہے بجائے کسی مسابقتی پیشکش کو قبول کرنے کے۔ AI سے تیار کردہ خلاصے بھرتی کاروں کو جمع کردہ مواد کے فوراً بعد تقریباً ہر امیدوار کی طاقتوں اور خامیوں کی پڑھنے کے قابل تفصیل دے سکتے ہیں، جو جائزے اور اگلے مراحل کے درمیان فاصلے کو کم کرتا ہے۔
فیڈبیک کا معیار فیڈبیک کی رفتار سے الگ سوال ہے، تاہم، اور یہ وہاں ہے جہاں AI کی ابھی تک حقیقی حدود ہیں۔ ایک تیار کردہ خلاصہ یہ نشان زد کر سکتا ہے کہ کسی امیدوار کا کوڈ کچھ ٹیسٹ کیسز میں ناکام رہا یا تحریری جواب نے ضابطے کے اہم معیاروں سے محروم رہا۔ یہ "کیوں" کو اسی ساخت کے ساتھ سمجھانے میں ابھی تک جدوجہد کرتا ہے جو ایک ماہر انسانی جائزہ کار لاتا ہے، خاص طور پر تخلیقی یا فیصلے پر بھاری کاموں کے لیے جہاں درست جواب واحد نہیں ہوتا۔
عملی حل جس پر زیادہ تر ہائبرڈ ورک فلو پہنچتے ہیں وہ پرتوں والا فیڈبیک ہے: AI فوری طور پر پہلا خلاصہ تیار کرتا ہے، اور بھرتی کار یا بھرتی کا مینیجر اسے امیدوار یا بھرتی کمیٹی تک پہنچنے سے پہلے سیاق و سباق شامل کرتا ہے۔ یہ خودکار گریڈنگ کا رفتار کا فائدہ برقرار رکھتا ہے بغیر اس تشریحی باریکی کھوئے جو ایک شخص شامل کرتا ہے۔ یہ ایک زیادہ لطیف خطرے سے بھی بچاتا ہے: امیدوار AI خلاصے کو اس سے زیادہ مستند سمجھتے ہیں جتنا یہ اصل میں ہے، محض اس لیے کہ یہ تیزی سے آیا اور صاف ستھرا دکھتا ہے۔
کاغذی ٹیسٹ سے AI اسکورنگ تک: ایک مختصر تاریخ
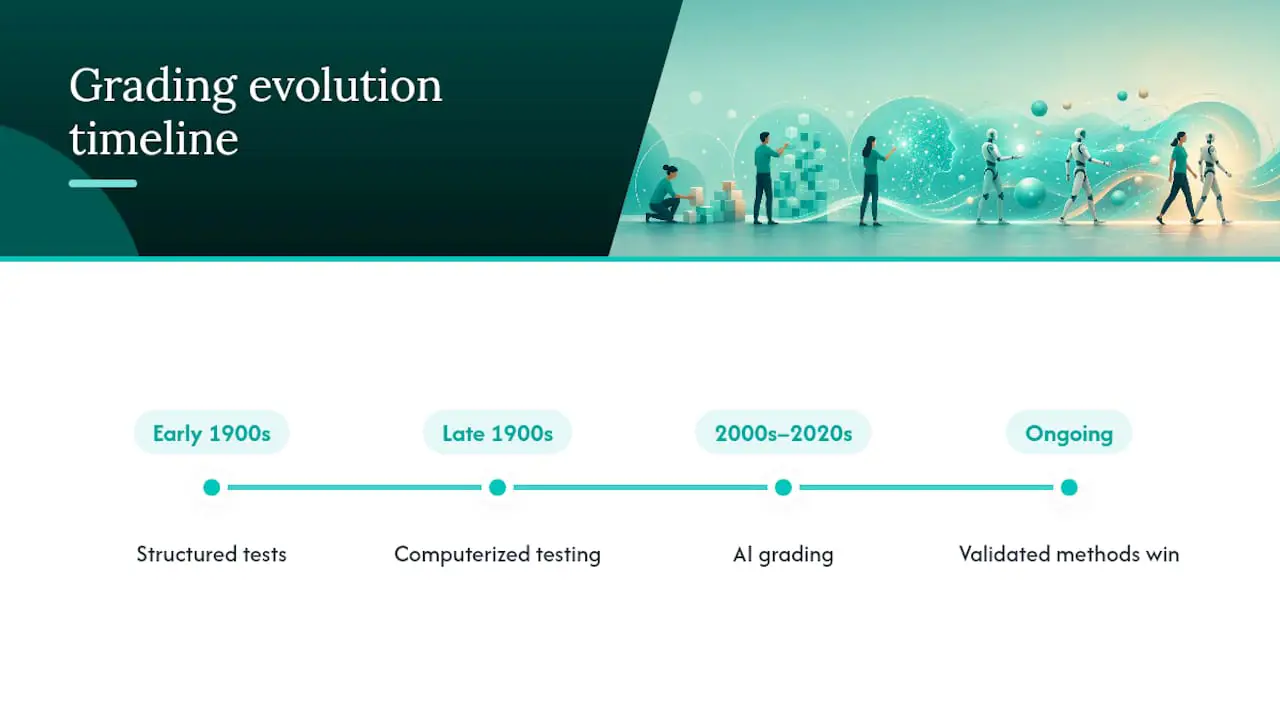
امیدواروں کو گریڈ کرنا سافٹ ویئر کے ساتھ شروع نہیں ہوا۔ ڈھانچہ بند بھرتی کے جائزے کی جڑیں 20ویں صدی کے اوائل کی پرسنل سائیکالوجی میں ہیں، جب آجروں نے پہلی بار پیٹ کی احساس اور ذاتی حوالوں پر انحصار کم کرنے کے لیے ٹیسٹوں کو معیاری بنانے کی کوشش کی۔ اس کے بعد سے دہائیوں کی تحقیق مستقل طور پر یہ ظاہر کرتی ہے کہ ڈھانچہ بند، ملازمت سے متعلقہ طریقے — خاص طور پر کام کے نمونے اور ڈھانچہ بند انٹرویوز — اصل ملازمتی کارکردگی سے سب سے مضبوط تعلق پیدا کرتے ہیں، جو غیر ڈھانچہ بند انٹرویوز یا صرف CV کی اسکریننگ سے کہیں بہتر ہیں۔
اگلی بڑی تبدیلی 20ویں صدی کے آخر میں کمپیوٹرائزڈ جانچ کے ساتھ آئی، جس نے آجروں کو ملٹی پل چوائس اور عددی جائزوں کے لیے اسکورنگ معیاری بنانے اور کچھ انٹر ریٹر عدم مستقل مزاجی کو کم کرنے کی اجازت دی۔ لیکن کھلے سوالات — لکھنے کے نمونے، کوڈ کا جائزہ، منظر نامے کے جوابات — اب بھی انہیں پڑھنے اور جانچنے کے لیے ایک انسان کی ضرورت تھی، جس نے گریڈنگ کو پیمانے پر سست اور مہنگا رکھا۔
AI گریڈنگ اسی رفتار کا اگلا قدم ہے، اس سے وقفہ نہیں۔ جو بدلا وہ غیر ڈھانچہ بند جوابات (تحریری جوابات، کوڈ، یہاں تک کہ ویڈیو) پر ایک مستقل ضابطہ اس رفتار سے لاگو کرنے کی صلاحیت ہے جو کوئی انسانی پینل مماثلت نہیں کر سکتا۔ انتخاب کے طریقوں کو ملانے سے متعلق تحقیق جو جدید AI سے دہائیوں پہلے کی ہے، اب بھی بنیادی سبق رکھتی ہے: توثیق شدہ، ملازمت سے متعلقہ ٹیسٹ غیر رسمی فیصلے سے بہتر ہیں، چاہے گریڈر انسان ہو یا ماڈل۔ AI نے یہ اصول ایجاد نہیں کیا۔ اس نے بس اسے پیمانے پر لاگو کرنا آخرکار عملی بنا دیا۔
AI بمقابلہ انسانی گریڈنگ سے متعلق اخلاقی تحفظات
AI گریڈنگ کے گرد اخلاقی سوالات واقعی اس بارے میں نہیں ہیں کہ آیا ایک مشین انصاف کو "سمجھتی" ہے۔ یہ اس بارے میں ہیں کہ آیا اسے تعینات کرنے والے انسانوں نے عمل میں کافی جوابدہی بنائی ہے۔ تین مسائل بار بار اٹھتے ہیں۔
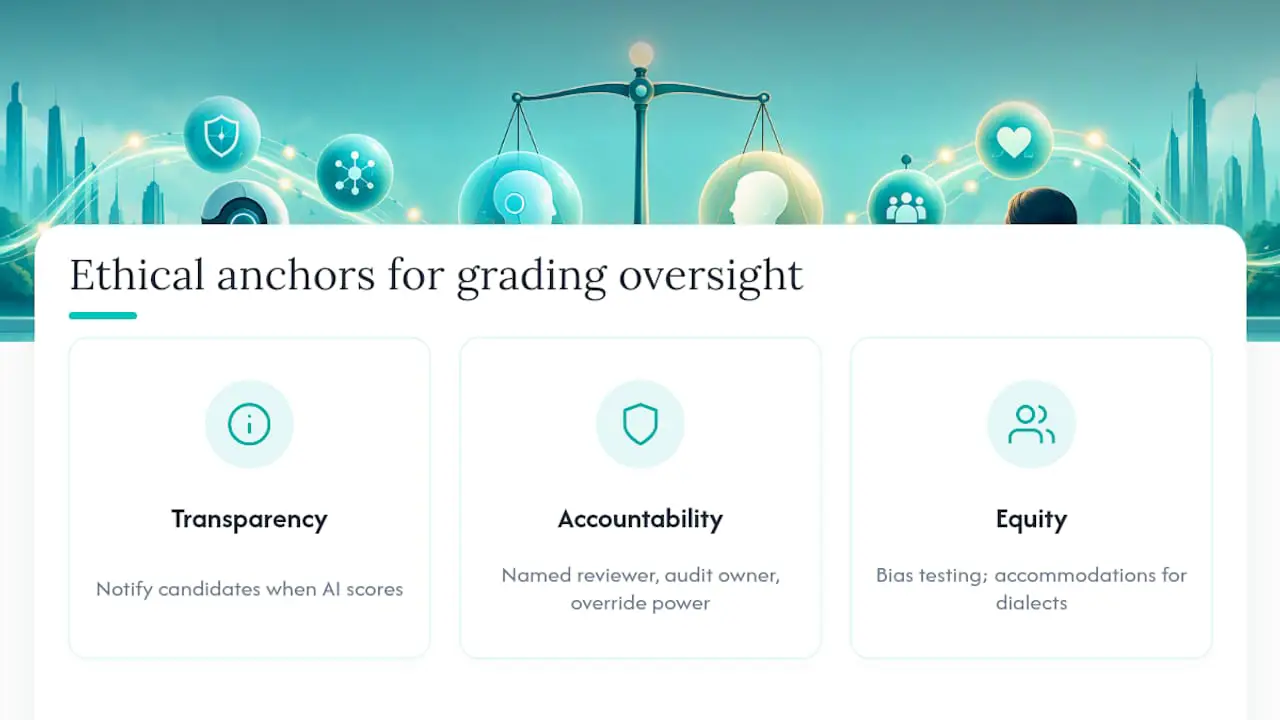
شفافیت۔ امیدواروں کو یہ جاننے کا حق ہے کہ جب AI ان کے کام کو اسکور کرنے میں شامل ہے، اور بڑھتی ہوئی تعداد میں ریاستی قوانین بالکل اسی قسم کے نوٹس کی ضرورت رکھتے ہیں۔ آجر جو اسے باریک چھاپ میں دفن کرتے ہیں وہ قانونی خطرہ پیدا کر رہے ہیں، نہ صرف اخلاقی مسئلہ۔
غلطیوں کی جوابدہی۔ جب کوئی انسانی گریڈر غلطی کرتا ہے تو ایسکلیٹ کرنے کے لیے ایک شخص ہوتا ہے۔ جب کوئی AI سسٹم کسی جواب کو غلط گریڈ کرتا ہے تو جوابدہی کا سلسلہ اتنا ہی واضح ہونا ضروری ہے: کون غیر معمولی اسکوروں کا جائزہ لیتا ہے، کون آڈٹ کا مالک ہے، اور کس کے پاس اسکور کو اوورائیڈ کرنے کا اختیار ہے۔
امیدواروں میں مساوات۔ رہائشوں، تحریری جوابات میں بولی کی تبدیلیوں، یا غیر روایتی مسئلہ حل کرنے کے نقطہ نظروں پر توجہ دیے بغیر تربیت یافتہ گریڈنگ سسٹم کسی کا دھیان جائے بغیر اہل امیدواروں کو خاموشی سے نقصان پہنچا سکتا ہے یہاں تک کہ منفی اثرات کا آڈٹ اسے پکڑ لے۔ انسانی گریڈرز اپنا اسی خطرے کا ورژن لاشعوری تعصب کے ذریعے لاتے ہیں، جو بالکل وہی وجہ ہے کہ SIOP تعصب کی جانچ کو کسی بھی گریڈنگ طریقہ کے لیے تکنیکی ضرورت کے طور پر سمجھتا ہے، نہ کہ ایک وقتی اخلاقی چیک باکس کے طور پر۔
اس میں سے کوئی بھی AI استعمال کرنے کے خلاف دلیل نہیں دیتا۔ یہ کسی بھی قسم کی گریڈنگ کو ایک ایسے سسٹم کے طور پر سمجھنے کی دلیل دیتا ہے جسے نگرانی کی ضرورت ہے، نہ کہ ایک ٹول کے طور پر جسے آپ تعینات کریں اور بھول جائیں۔
AI گریڈنگ کے نتائج کی تشریح کیوں مشکل ہے
ایک انسانی گریڈر عام طور پر ایک جملے میں اسکور بیان کر سکتا ہے: "امیدوار کا حل کام کر گیا لیکن غیر موثر نقطہ نظر استعمال کیا۔" AI سے تیار کردہ اسکور اکثر کھولنا مشکل ہوتا ہے، خاص طور پر جب بنیادی ماڈل درجنوں اشاروں کو وزن دیتا ہے جو بھرتی کار کبھی براہ راست نہیں دیکھتا۔
یہ ایک مخصوص تشریح کا مسئلہ پیدا کرتا ہے: واضح دلیل کے بغیر اسکور کا دفاع کرنا مشکل ہے اگر کوئی امیدوار اسے چیلنج کرے یا ریگولیٹر پوچھے کہ فیصلہ کیسے کیا گیا۔ یہ جاننا بھی مشکل ہے کہ آیا کم اسکور کسی حقیقی مہارت کے فرق کی عکاسی کرتا ہے یا امیدوار نے جواب کیسے لکھا اس میں کوئی خاصیت ہے۔
عملی جواب ہر AI اسکور پر بے اعتمادی نہیں ہے۔ یہ قابلِ وضاحت کو بنیادی خصوصیت کے طور پر مطالبہ کرنا ہے، نہ کہ بعد میں سوچنے کی چیز کے طور پر۔ ایک مفید AI سے تیار کردہ خلاصہ دکھانا چاہیے کہ کسی امیدوار نے کون سے مخصوص معیار پورے کیے یا چھوڑے، نہ کہ صرف ایک واحد مرکب نمبر۔ تفصیل کا یہ درجہ ایک بھرتی کار کو AI کی استدلال کو اسی طرح کراس چیک کرنے دیتا ہے جیسے وہ انسانی جائزہ کار کے نوٹوں کی سمجھ جانچتا ہے، اور یہ ایک مبہم اسکور کو کسی ایسی چیز میں بدل دیتا ہے جس کے پیچھے بھرتی کا مینیجر حتمی فیصلے میں واقعی کھڑا ہو سکتا ہے۔
مختلف کرداروں اور مہارت کی اقسام میں AI گریڈنگ
AI گریڈنگ یکساں طور پر لاگو ایک ٹول نہیں ہے۔ یہ کتنی اچھی طرح کام کرتی ہے یہ اس بات پر منحصر ہے کہ کیا جانچا جا رہا ہے۔
تکنیکی اور کوڈنگ جائزے وہ جگہ ہیں جہاں AI گریڈنگ سب سے زیادہ قابلِ اعتماد طریقے سے کام کرتی ہے۔ ٹیسٹ کیسز یا تو گزرتے ہیں یا ناکام ہوتے ہیں، عملدرآمد کا وقت قابلِ پیمائش ہے، اور کوڈ کے معیار کے پیمانوں کو واضح معیاروں کے خلاف اسکور کیا جا سکتا ہے — یہ بالکل وہی ڈھانچہ بند ماحول ہے جسے IT بھرتی مطالعے نے پیمائش کی جب اس نے AI کو بہت تیز رفتار پر انسانی اوسط اسکور سے ملتے ہوئے پایا۔
ڈھانچہ بند علمی ٹیسٹ، تعمیل کوئزز، استعداد کے ٹیسٹ، متعین درست جوابات والے حالاتی فیصلے کے ٹیسٹ تقریباً اتنے ہی مضبوط فٹ ہیں، کیونکہ اسکورنگ کی منطق اچھی طرح بنے ہوئے ملٹی پل چوائس امتحان سے بمشکل مختلف ہے۔
تحریری جواب اور ابلاغ کے کام درمیان میں بیٹھتے ہیں۔ AI گرامر، ڈھانچے اور اس بارے میں نشان زد کر سکتا ہے کہ آیا جواب نے پرامپٹ کو پورا کیا، لیکن لہجے، قائل کرنے یا تخلیقی مسئلہ حل کرنے کا فیصلہ کرنا اب بھی انسانی دوسری نظر سے فائدہ اٹھاتا ہے۔
سیلز، کسٹمر سروس اور باہمی کردار کے کام ابھی کے لیے انسانی بھاری رہتے ہیں۔ یہ کردار جذباتی اشاروں کو پڑھنے اور گفتگو کے وسط میں ڈھالنے پر منحصر ہیں، وہ علاقہ جہاں ایک ضابطہ اسے پکڑنے میں ابھی تک جدوجہد کرتا ہے جو واقعی ملازمت پر کامیابی کی پیش گوئی کرتا ہے۔
Talent Approved کی کردار کے مطابق ٹیسٹ ڈیزائن کی رہنمائی جائزے کے فارمیٹ کو جانچی جانے والی مہارت سے ملانے کے گرد بنائی گئی ہے، جو یہ فیصلہ کرنے کا اصل لیور ہے کہ کسی بھی کردار کے لیے AI اسکورنگ پر کتنا وزن ڈالنا ہے۔
انسانی اور AI گریڈنگ کے مل کر کام کرنے کا عملی راستہ
سب یا کچھ نہیں کی بحث کو چھوڑیں۔ ایک کردار پر پائلٹ چلائیں، ایک کو منتخب کرنے کی بجائے میکانکی ترکیب کے ذریعے AI اسکوروں کو انسانی فیصلے کے ساتھ ملائیں، اور کچھ بھی اعلیٰ خطرے والے تک بڑھانے سے پہلے ایک چھوٹے نمونے کا آڈٹ کریں۔ پلیٹ فارم کی خصوصیات جو اس کی حمایت کرتی ہیں — ڈھانچہ بند ضابطہ تیاری، دھوکہ دہی کی روک تھام کی نگرانی، AI سے تیار کردہ خلاصے — انسانی جائزے کے قدم کو تیز تر بنانے کے لیے موجود ہیں، اسے بدلنے کے لیے نہیں۔ بھرتی سے پہلے کے اسکوروں کے خلاف بھرتی کے بعد کی کارکردگی کو ٹریک کریں اور جب ڈیٹا آپ کو بتائے تب ضابطے کو ایڈجسٹ کریں، اس سے پہلے نہیں۔
— Jimmie
AI معاونت سے گریڈنگ کا پائلٹ چلانے کے لیے تیار ہیں؟ یہاں سے شروع کریں
Talent Approved بالکل اسی ہائبرڈ ماڈل کے لیے بنایا گیا ہے جس کی یہ مضمون سفارش کرتا ہے: AI اسکورنگ پر بھاری کام کرتا ہے، اور آپ حتمی فیصلہ اپنے پاس رکھتے ہیں۔ Magic Create منٹوں میں ملازمت کی تفصیل کو کردار کے مطابق جائزے میں بدل دیتا ہے، بلٹ ان دھوکہ دہی روک تھام نگرانی (اسکرین اور ویب کیم چیکس، سیشن ریپلیز) جو آپ اسکور کر رہے ہیں اس کی سالمیت کی حفاظت کرتی ہے، اور AI سے تیار کردہ خلاصے آپ کو خام نمبر کی بجائے فی امیدوار پڑھنے کے قابل تفصیل دیتے ہیں۔ قیمتیں فی مکمل امیدوار جائزہ $5 کی ادائیگی جیسے جیسے جائیں ماڈل پر چلتی ہیں، بغیر سبسکرپشن کی ضرورت کے۔
اگر آپ اسے صحیح طریقے سے جانچنے کے لیے تیار ہیں تو 30 سے 90 دن کا پائلٹ چلائیں: ایک کردار منتخب کریں، Magic Create کے ساتھ جائزہ تیار کریں، ہر جمع کردہ مواد کو AI خلاصے اور انسانی جائزہ کار دونوں کے ساتھ متوازی طور پر اسکور کریں، نتائج میں منفی اثرات کی جانچ چلائیں، اور پائلٹ بھرتیوں کا کارکردگی ڈیٹا سے موازنہ کریں جب وہ ملازمت پر آ جائیں۔ مکمل رول آؤٹ کرنے سے پہلے اپنا پائلٹ دائرہ کار طے کرنے کے لیے قیمتوں کا صفحہ چیک کریں۔
ماخذ
پیمانے پر AI گریڈنگ شروع کرنے سے پہلے SIOP کی توثیق کی رہنمائی، NIST کا TEVV-Athlon فریم ورک، اور AI اور انسانی گریڈنگ کا موازنہ کرنے والا IT بھرتی مطالعہ دیکھیں۔ بدلتی قانونی ذمہ داریوں کے لیے، K&L Gates کا وفاقی رہنمائی کی تبدیلی کا خلاصہ پڑھنے کے قابل ہے۔
- IT بھرتی کے تناظر میں ChatGPT بمقابلہ انسانی مہارت
- ملازم انتخاب کے لیے AI پر مبنی جائزوں کی توثیق اور استعمال کے لیے تحفظات اور سفارشات (SIOP)
- NIST ARIA 0.1 پائلٹ رپورٹ
- پرسنل سائیکالوجی میں انتخاب کے طریقوں کی درستگی اور افادیت
اکثر پوچھے جانے والے سوالات
کیا AI انسانی گریڈرز کو مکمل طور پر بدل سکتا ہے؟
نہیں۔ IT بھرتی میں AI اور انسانی گریڈنگ کا موازنہ کرنے والی تحقیق میں اوسط درستگی میں ملتا جلتا لیکن AI کی رفتار تیز پائی گئی، جبکہ دونوں نے دہرائی جانے والی اسکورنگ میں عدم مستقل مزاجی دکھائی۔ انسانی جائزہ اب بھی غیر واضح کاموں اور حتمی مرحلے کے فیصلوں کے لیے اہمیت رکھتا ہے۔
کیا AI گریڈنگ بھرتی کے فیصلوں کے لیے قانونی طور پر قابلِ دفاع ہے؟
ہو سکتی ہے، اگر آپ ٹول کی توثیق کریں اور عمل کی دستاویزسازی کریں۔ SIOP باضابطہ نفسیاتی پیمائش کی توثیق کی سفارش کرتا ہے، اور کئی ریاستیں اب امیدوار نوٹس یا رضامندی کی ضرورت رکھتی ہیں جب اسکورنگ میں AI استعمال کیا جائے۔
Talent Approved کی لاگت کتنی ہے؟
Talent Approved ادائیگی جیسے جیسے جائیں بنیاد پر فی مکمل امیدوار جائزہ $5 چارج کرتا ہے، بغیر سبسکرپشن کی ضرورت کے۔
پیمائشی تعصب اور پیش گوئی کے تعصب میں کیا فرق ہے؟
پیمائشی تعصب کا مطلب ہے کہ ایک ٹیسٹ برابر بنیادی مہارت کے باوجود گروہوں میں مختلف طریقے سے اسکور کرتا ہے۔ پیش گوئی کے تعصب کا مطلب ہے کہ اسکور گروہ کے لحاظ سے ملازمتی کارکردگی کو مختلف طریقے سے پیش گوئی کرتا ہے۔ SIOP ان دونوں کو الگ، قابلِ جانچ مسائل کے طور پر سمجھتا ہے، نہ کہ ایک عمومی انصاف کا مسئلہ۔
کون سے مہارت کے ٹیسٹ صرف AI کے ساتھ گریڈ کرنے کے لیے سب سے محفوظ ہیں؟
ڈھانچہ بند، معروضی طور پر اسکور کیے گئے ٹیسٹ — کوڈنگ چیلنجز، معیاری علمی کوئزز، اور متعین درست جوابات والے حالاتی فیصلے کے ٹیسٹ — صرف AI گریڈنگ کے لیے سب سے محفوظ فٹ ہیں۔ کھلے تحریری جوابات اور باہمی کردار کے جائزے اب بھی انسانی جائزے سے فائدہ اٹھاتے ہیں۔