
HR-playbook til AI vs. menneskelig bedømmelse: 30–90 dages pilot + 4 TEVV-trin
AI-bedømmelse fungerer godt til strukturerede, rollespecifikke færdighedstests: det giver karakterer hurtigere end en person og lander tæt på de samme gennemsnitlige resultater. Det bør ikke køre alene ved afgørelser med høj risiko eller tvetydige beslutninger. Rammer fra SIOP og NISTs TEVV-testmetode eksisterer af en grund, og platforme som Talent Approved er bygget op omkring at kombinere AI-bedømmelse med menneskelig gennemgang – ikke at erstatte den fuldstændigt.
TL;DR:
- AI-bedømmelse er mest pålidelig til strukturerede vurderinger som kodningstest og standardiserede vidensquizzer, hvor der eksisterer klare rigtige eller forkerte svar.
- En hybridmodel med AI i indledende screening og menneskelig gennemgang til nuancerede eller tvetydige opgaver tilbyder den bedste balance mellem hastighed og nøjagtighed.
- Både AI- og menneskelige bedømmere viser uoverensstemmelser ved bedømmelse af identiske besvarelser, hvilket understreger behovet for validering og løbende overvågning.
- Biasrisici omfatter målingsbias og prædiktiv bias, som kan afhjælpes gennem grundig testning, gennemsigtighed og inkluderende rubrikdesign.
- At køre små pilotprogrammer og sammenligne vurderingsresultater med faktisk jobpræstation hjælper med at sikre, at AI-værktøjer er prædiktive og retfærdige i ansættelsesprocessen.
Indholdsfortegnelse
- Sådan fungerer AI-bedømmelse og menneskelig bedømmelse i ansættelsesprocessen
- Styrker og begrænsninger: Nøjagtighed, hastighed, konsistens og bias
- Validering, testning og styring, som HR-teams skal gennemføre
- Implementeringstjekliste: Beslutningsregler og målinger
- AI-bedømmelsens indvirkning på feedbackkvaliteten for kandidater
- Fra papiртests til AI-bedømmelse: En kort historik
- Etiske overvejelser specifikt for AI kontra menneskelig bedømmelse
- Hvorfor AI-bedømmelsesresultater er sværere at fortolke
- AI-bedømmelse på tværs af forskellige roller og færdighedstyper
- En pragmatisk vej til at menneskelig og AI-bedømmelse arbejder sammen
- Klar til at pilotafprøve AI-assisteret bedømmelse? Start her
- Kilder
- FAQ
Sådan fungerer AI-bedømmelse og menneskelig bedømmelse i ansættelsesprocessen
AI-bedømmelsesværktøjer scorer kandidaternes arbejde op imod en rubrik bygget på træningsetiketter, strukturerede kriterier eller en jobbeskrivelse, der er indtastet i systemet. Nogle AI-vurderingsplatforme tilbyder funktioner, der bygger rollespecifikke vurderinger og scoringsstrukturer ud fra jobbeskrivelser på få minutter og derefter genererer resuméer af hver kandidats præstation, så rekrutterere kan gennemgå resultater uden at læse hver besvarelse linje for linje. Fordelen er gennemstrømning: et sådant system kan bedømme hundredvis af kodeeksempler eller skriftlige svar i den tid, en enkelt fagekspert gennemgår en håndfuld.
Menneskelig bedømmelse fungerer anderledes. En fagekspert anvender en rubrik ved hjælp af vurderingsevne, kontekst og erfaring, hvilket er værdifuldt for nuancer, men dyrt at skalere. To ting bremser det hver gang: omkostninger pr. kandidat og inter-bedømmervariabilitet, hvilket betyder, at to kvalificerede bedømmere kan give det samme svar forskellige karakterer afhængigt af humør, træthed eller fortolkning af rubrikken.
De fleste arbejdsgivere ender med en hybridmodel frem for at vælge én side. Almindelige mønstre inkluderer:
- AI-først med menneskelige stikprøvekontroller: AI bedømmer alle besvarelser, og en rekrutterer gennemgår en stikprøve eller eventuelle grænsetilfælde.
- Menneske-først til komplekse opgaver: åbne eller skønsbaserede opgaver går direkte til en person, mens strukturerede opgaver (kodningstest, matematikopgaver, flervalgslogik) går til AI.
- Mekanisk syntese: menneskelige bedømmeres og algoritmiske scores blandes til ét kombineret output – en metode, der er vist at bevare prædiktiv nøjagtighed og samtidig forbedre opbakningen fra ansættelsesledere, der ønsker en menneskelig kontrol af processen.
Styrker og begrænsninger: Nøjagtighed, hastighed, konsistens og bias
En fagfællebedømt sammenligning af AI-bedømmelse og menneskelige eksperter inden for IT-rekruttering fandt ingen signifikant forskel i gennemsnitlige scores mellem de to. AI bedømte langt hurtigere, men undersøgelsen fandt også noget mindre flatterende for begge parter: ingen var fuldt ud konsistente. AI producerede varierende scores, når den blev bedt om at genbedømme den samme besvarelse, og menneskelige bedømmere viste den samme inter-bedømmerpålidelighed, der har været dokumenteret i ansættelsesforskning i årtier.
Hvor hver tilgang typisk vinder:
- AI vinder på ren hastighed og konsistens på tværs af store kandidatpuljer, når opgaven er struktureret (kodetest, standardiserede opgavesæt).
- Mennesker vinder på kontekst: at genkende et utraditionelt men gyldigt svar, anvende tilpasninger eller opdage en kandidat, der løste problemet på en anderledes men lige så korrekt måde.
- Ingen vinder entydigt på gentagelighed. Både AI og menneskelige bedømmere kan producere forskellige scores for det samme arbejde ved en anden gennemgang.
Konsistenstjek: den samme undersøgelse, der fandt, at AI matchede menneskelige gennemsnitsscore, fandt også, at både AI- og menneskelig bedømmelse viste målbar inkonsistens ved gentagen evaluering af identiske besvarelser – hvilket er grunden til, at en enkelt bedømmelsesgennemgang fra begge kilder er et risikabelt grundlag for en endelig ansættelsesbeslutning.
Bias fortjener sin egen gennemgang, fordi "biased" bruges løst. SIOP adskiller det i to distinkte, testbare begreber: målingsbias, hvor en test præsterer forskelligt for forskellige grupper på trods af lige underliggende færdigheder, og prædiktiv bias, hvor en testscore forudsiger jobpræstation forskelligt på tværs af grupper. At behandle disse som ét uklart problem er, hvordan arbejdsgivere overser reel risiko. En almindelig fejlform er mållækage, hvor en model trænes på en proxyvariabel, der korrelerer med en beskyttet egenskab frem for selve færdigheden. Manglende tilpasninger for kandidater med handicap er en anden: en AI-rubrik opbygget uden ADA-hensyn kan straffe en legitim alternativ tilgang, som en menneskelig bedømmer ville genkende øjeblikkeligt.
Validering, testning og styring, som HR-teams skal gennemføre
At implementere et AI-bedømmelsesværktøj uden en testplan er, hvordan arbejdsgivere ender med at forsvare en retssag i stedet for en ansættelsesbeslutning. NISTs TEVV-Athlon-tilgang giver en praktisk struktur herfor, bygget op omkring fire faser:
- Definer mål. Beslut præcist, hvad bedømmelsesværktøjet skal måle, og hvordan "god præstation" ser ud for rollen.
- Konstruktionsvalidering. Bekræft, at testen faktisk måler den færdighed, den hævder at måle, og ikke en løst relateret proxy.
- Bruger- og felttest. Kør værktøjet mod rigtige kandidatbesvarelser, herunder red-teaming-forsøg for at finde, hvor det bryder sammen eller bedømmer uretfærdigt.
- Syntetiser resultater. Kombiner alt til en dokumenteret vurdering af, om værktøjet er klar til live-brug.
En revisionstjekliste, der er værd at køre inden lancering og med jævne mellemrum efterfølgende, bør omfatte konstruktions- og praktisk valideringskontrol, test for negativ indvirkning på tværs af demografiske grupper, dokumentation af etikettkilder og rubrikdesign, tilstrækkelige stikprøvestørrelser inden konklusioner drages, og en fast overvågningsplan frem for en engangsvurdering. Talent Approveds indbyggede vejledning til test for negativ indvirkning gennemgår, hvordan man udfører denne slags kontrol uden en statistikbaggrund.
Det mest oversete trin er feedbackintegration: at forbinde scores fra før ansættelsen med det, der faktisk sker efter ansættelsen. At sammenligne vurderingsscores med fastholdelse og præstationsdata forvandler en screeningtest til et genuint prædiktivt instrument frem for et filter, man håber virker.
Pro Tip: Kør din første valideringscyklus på en rolle, du allerede ansætter til ofte. Du vil have nok historiske præstationsdata til at kontrollere, om vurderingsscoren faktisk forudsagde noget, i stedet for at gætte.
Implementeringstjekliste: Beslutningsregler og målinger
Ikke enhver test hører hjemme i den samme kategori. En brugbar beslutningsregel ser sådan ud:
- Brug kun AI eller AI-først bedømmelse til strukturerede kodningstest, standardiserede opgavesæt og indledende screening ved høj volumen.
- Kræv menneskelig gennemgang for tvetydige fritekstbesvarelser, porteføljeevaluering og enhver afgørelse i den endelige fase, der påvirker et tilbud.
- Anvend som standard hybrid scoring, når rollen er højrisikobetonet, men testformatet stadig er struktureret nok til, at AI kan håndtere en første gennemgang.
Når reglerne er fastsat, skal de spores med rigtige målinger frem for mavefornemmelse:
- Inter-bedømmerenighed — Cohens kappa til sammenligninger med to bedømmere, eller Fleiss' kappa når flere bedømmere er involveret, anvendt på både AI-versus-menneske og menneske-versus-menneske-sammenligninger.
- Scoredistributioner for undergrupper — regelmæssigt opdelt efter demografisk kategori for tidligt at opdage målingsbias.
- Prædiktive validitetskorrelationer — hvor godt scores fra før ansættelsen faktisk sporer præstation efter ansættelsen.
- Behandlingstid og fejlrate — hvor lang tid bedømmelsen tager, og hvor ofte output kræver manuel korrektion.
Operationelle kontroller er lige så vigtige som selve målingerne: giv kandidater besked, hvor delstatslovgivningen kræver det, byg en eskaleringsvej til afvigende scores, dokumentér hver revision til compliancegennemgang, og sæt en fast genudlæringsudløser frem for at vente på, at en klage tvinger sagen. Talent Approveds øjeblikkelige vurderingsscoring er bygget med denne slags gennemsigtige, revisionssikre rubrik for øje.
AI-bedømmelsens indvirkning på feedbackkvaliteten for kandidater
Hurtigere bedømmelse ændrer, hvad kandidater oplever – ikke kun hvad rekrutterere ser. En kandidat, der afslutter en færdighedstest og får et resultat inden for timer i stedet for to uger, forbliver engageret i din proces frem for at acceptere et konkurrerende tilbud. AI-genererede resuméer kan give rekrutterere en læsbar opdeling af styrker og mangler pr. kandidat næsten umiddelbart efter indsendelse, hvilket forkorter kløften mellem vurdering og næste skridt.
Feedbackkvalitet er et separat spørgsmål fra feedbackhastighed, og det er her AI stadig har reelle begrænsninger. Et genereret resumé kan markere, at en kandidats kode ikke bestod visse testcases, eller at et skriftligt svar manglede nøglekriterier fra rubrikken. Det kæmper med at forklare "hvorfor" med den samme tekstur, som en dygtig menneskelig bedømmer bringer, især for kreative eller skønsbaserede opgaver, hvor det rigtige svar ikke er entydigt.
Den praktiske løsning, som de fleste hybridworkflows lander på, er lagdelt feedback: AI genererer resuméet fra første gennemgang øjeblikkeligt, og en rekrutterer eller ansættelsesleder tilføjer kontekst, inden det når en kandidat eller ansættelseskomité. Dette bevarer hastighedsfordelen ved automatiseret bedømmelse uden at miste den fortolkningsmæssige nuance, en person tilføjer. Det beskytter også mod en mere subtil risiko: at kandidater stoler på et AI-resumé som mere autoritativt, end det faktisk er, blot fordi det ankom hurtigt og ser pænt ud.
Fra papiртests til AI-bedømmelse: En kort historik
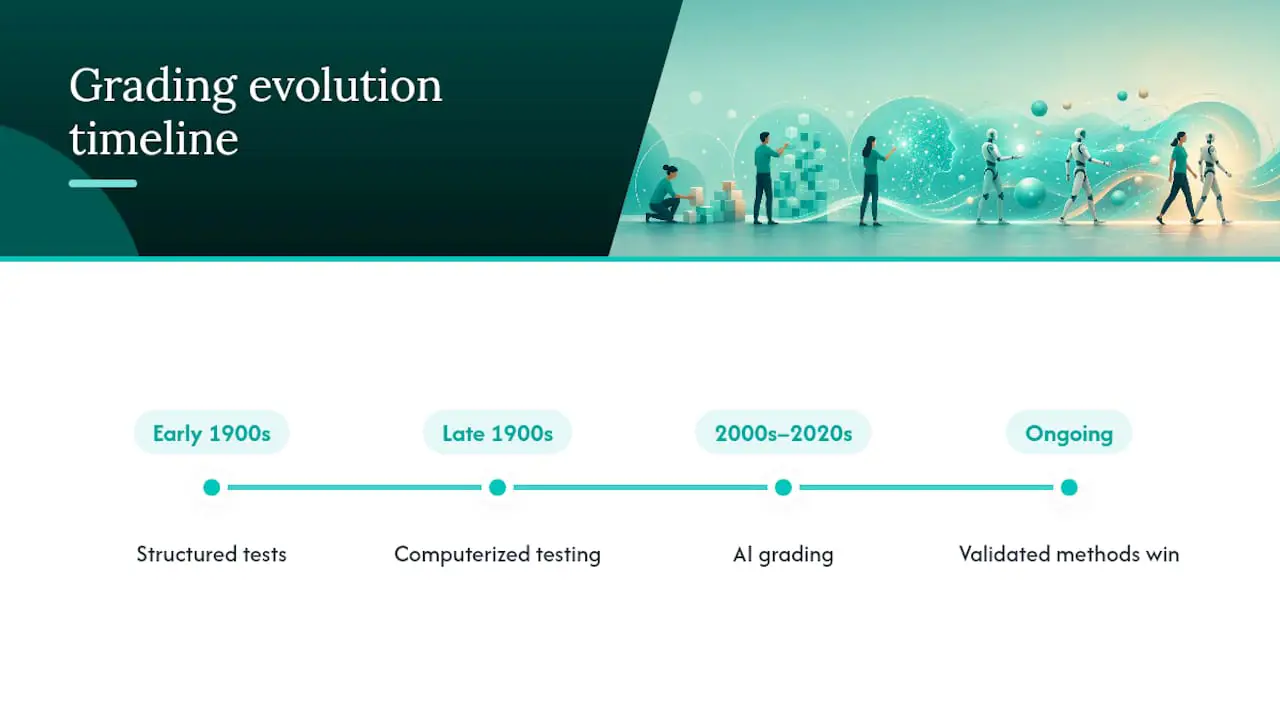
Bedømmelse af kandidater startede ikke med software. Struktureret ansættelsesvurdering går tilbage til begyndelsen af det 20. århundrede inden for personalepsykologi, da arbejdsgivere første gang forsøgte at standardisere tests for at reducere afhængigheden af mavefornemmelse og personlige anbefalinger. Årtiers forskning siden da viser konsekvent, at strukturerede, jobrelevante metoder – arbejdsprøver og strukturerede interviews især – producerer den stærkeste sammenhæng med faktisk jobpræstation og langt overgår ustrukturerede interviews eller CV-screening alene.
Det næste store skift kom med computerbaseret testning i slutningen af det 20. århundrede, som lod arbejdsgivere standardisere scoring og reducere noget inter-bedømmervariabilitet for flervalgs- og numeriske vurderinger. Men åbne opgaver – skriveprøver, kodegennemgang, scenariebesvarelser – krævede stadig et menneske til at læse og vurdere dem, hvilket holdt bedømmelsen langsom og dyr i stor skala.
AI-bedømmelse er det næste skridt i den samme bane – ikke et brud med den. Det, der ændrede sig, er evnen til at anvende en konsistent rubrik på ustrukturerede besvarelser (skriftlige svar, kode, endda video) med en hastighed, som intet menneskeligt panel kan matche. Forskningen i kombination af udvælgelsesmetoder, der går forud for moderne AI med årtier, holder stadig den underliggende lære: validerede, jobrelevante tests slår uformel vurdering, uanset om bedømmeren er en person eller en model. AI opfandt ikke det princip. Den gjorde blot det endelig praktisk at anvende det i stor skala.
Etiske overvejelser specifikt for AI kontra menneskelig bedømmelse
De etiske spørgsmål omkring AI-bedømmelse handler ikke rigtig om, hvorvidt en maskine "forstår" retfærdighed. De handler om, hvorvidt de mennesker, der implementerer den, har bygget tilstrækkelig ansvarlighed ind i processen. Tre problemer dukker op gentagne gange.
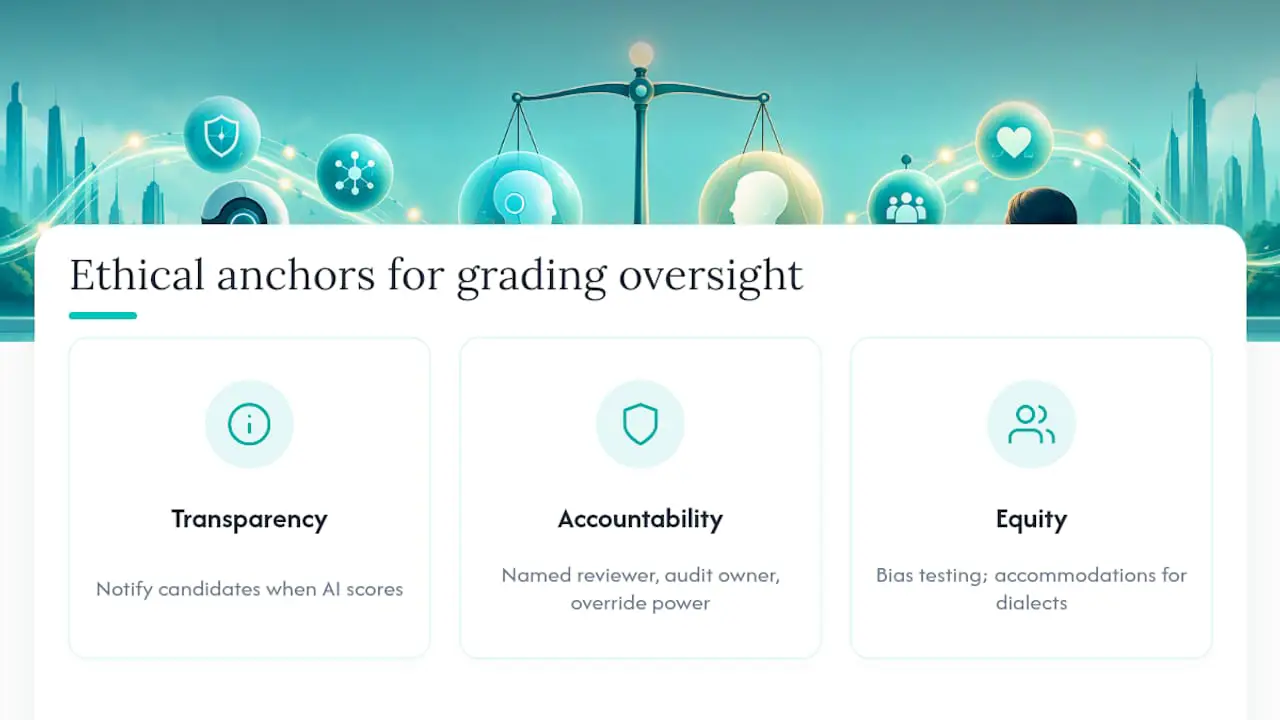
Gennemsigtighed. Kandidater fortjener at vide, hvornår AI er involveret i bedømmelsen af deres arbejde, og et voksende antal delstatslove kræver præcis den slags besked. Arbejdsgivere, der begrave dette i det fine print, skaber juridisk eksponering – ikke bare et etisk problem.
Ansvarlighed for fejl. Når en menneskelig bedømmer begår en fejl, er der en person at eskalere til. Når et AI-system bedømmer en besvarelse forkert, skal ansvarlighedskæden være lige så klar: hvem gennemgår afvigere, hvem ejer revisionen, og hvem har autoritet til at tilsidesætte en score.
Lighed på tværs af kandidater. Et bedømmelsessystem trænet uden opmærksomhed på tilpasninger, dialektvariationer i skriftlige besvarelser eller utraditionelle problemløsningstilgange kan stille kvalificerede kandidater stille og roligt ringere uden at nogen lægger mærke til det, før en audit for negativ indvirkning opdager det. Menneskelige bedømmere bærer deres egen version af denne risiko gennem ubevidst bias, hvilket er præcis grunden til, at SIOP behandler bias-testning som et teknisk krav for begge bedømmelsesmetoder – ikke en engangs etisk afkrydsningsboks.
Intet af dette argumenterer imod at bruge AI. Det argumenterer for at behandle bedømmelse – af begge slags – som et system, der kræver tilsyn, ikke et værktøj, man implementerer og glemmer.
Hvorfor AI-bedømmelsesresultater er sværere at fortolke
En menneskelig bedømmer kan normalt forklare en score i en sætning: "kandidatens løsning virkede, men brugte en ineffektiv tilgang." En AI-genereret score er ofte sværere at pakke ud, især når den underliggende model vejer snesevis af signaler, som en rekrutterer aldrig ser direkte.
Dette skaber et specifikt fortolkningsproblem: en score uden en klar begrundelse er svær at forsvare, hvis en kandidat anfægter den, eller en regulator spørger om, hvordan en beslutning blev truffet. Det er også sværere at vide, om en lav score afspejler et reelt færdighedsgab eller en særhed i måden, kandidaten formulerede et svar.
Det praktiske svar er ikke at mistro enhver AI-score. Det er at kræve forklarbarhed som en grundlæggende funktion – ikke en eftertanke. Et nyttigt AI-genereret resumé bør vise, hvilke specifikke kriterier en kandidat opfyldte eller ikke opfyldte, ikke bare et enkelt samlet tal. Det detaljeringsniveau lader en rekrutterer krydstjekke AI'ens ræsonnement på samme måde, som de ville sanity-checke en menneskelig bedømmers noter, og det forvandler en uigennemsigtig score til noget, en ansættelsesleder faktisk kan stå bag i en endelig beslutning.
AI-bedømmelse på tværs af forskellige roller og færdighedstyper
AI-bedømmelse er ikke ét værktøj anvendt ensartet. Hvor godt det virker, afhænger af, hvad der testes.
Tekniske og kodningsvurderinger er der, hvor AI-bedømmelse præsterer mest pålideligt. Testcases enten består eller fejler, udførelsestid er målbar, og kodekvalitetsmålinger kan scores op imod klare kriterier – præcis det strukturerede miljø, IT-rekrutteringsundersøgelsen målte, da den fandt, at AI matchede menneskelige gennemsnitsscore ved langt højere hastighed.
Strukturerede videnstests, compliance-quizzer, egnetheds-tests, situationsbedømmelsestests med definerede korrekte svar, passer næsten lige så godt, da scoringslogikken næppe adskiller sig fra en velbygget flervalgseksamen.
Skriftlige besvarelses- og kommunikationsopgaver befinder sig i midten. AI kan markere grammatik, struktur og hvorvidt en besvarelse adresserede opgaven, men at bedømme tone, overbevisningskraft eller kreativ problemløsning drager stadig fordel af et menneskes andet blik.
Salgs-, kundeservice- og interpersonelle rolleopgaver læner sig i høj grad mod mennesker for nu. Disse roller afhænger af at aflæse følelsesmæssige signaler og tilpasse sig midt i en samtale – et territorium, hvor en rubrik kæmper med at fange, hvad der faktisk forudsiger succes i jobbet.
Talent Approveds vejledning til rollespecifikt testdesign er bygget op omkring at matche vurderingsformatet til den færdighed, der testes – hvilket er den reelle løftestang for at beslutte, hvor meget vægt man skal lægge på AI-scoring for en given rolle.
En pragmatisk vej til at menneskelig og AI-bedømmelse arbejder sammen
Spring alt-eller-intet-debatten over. Kør en pilot på én rolle, bland AI-scores med menneskelig vurdering gennem mekanisk syntese frem for at vælge én, og revidér en lille stikprøve inden du skalerer til noget højrisikobetonet. Platformfunktioner, der understøtter dette – struktureret rubrikgenerering, anti-snyd-overvågning, AI-genererede resuméer – eksisterer for at gøre det menneskelige gennemgangstrin hurtigere, ikke for at erstatte det. Spor præstation efter ansættelsen op imod scores fra før ansættelsen, og juster rubrikken, når dataene fortæller dig det – ikke før.
— Jimmie
Klar til at pilotafprøve AI-assisteret bedømmelse? Start her
Talent Approved er bygget til præcis den hybridmodel, denne artikel anbefaler: AI tager det tunge løft ved scoring, og du beholder den endelige beslutning. Magic Create forvandler en jobbeskrivelse til en rollespecifik vurdering på få minutter, indbygget anti-snyd-overvågning (skærm- og webkameratjek, sessionsoptagelser) beskytter integriteten af det, du bedømmer, og AI-genererede resuméer giver dig en læsbar opdeling pr. kandidat i stedet for et råt tal. Prissætning kører på en betal-som-du-går-model til $5 pr. gennemført kandidatvurdering, uden abonnement krævet.
Hvis du er klar til at teste dette ordentligt, kør en 30 til 90 dages pilot: vælg én rolle, generer vurderingen med Magic Create, score alle besvarelser med både AI-resuméet og en menneskelig bedømmer parallelt, kør en kontrol for negativ indvirkning på tværs af resultaterne, og sammenlign pilotansættelser med præstationsdata, når de er i jobbet. Tjek prissætningssiden for at afgrænse din pilot, inden du forpligter dig til en fuld udrulning.
Kilder
Inden du udrullner AI-bedømmelse i stor skala, gennemgå SIOPs valideringsvejledning, NISTs TEVV-Athlon-ramme og IT-rekrutteringsundersøgelsen, der sammenligner AI- og menneskelig bedømmelse. For løbende juridiske forpligtelser er K&L Gates' oversigt over skiftende føderal vejledning værd at læse.
- ChatGPT vs. menneskelig ekspertise i forbindelse med IT-rekruttering
- Overvejelser og anbefalinger til validering og brug af AI-baserede vurderinger til medarbejderudvælgelse (SIOP)
- NIST ARIA 0.1 pilotrapport
- Gyldighed og nytte af udvælgelsesmetoder inden for personalepsykologi
FAQ
Kan AI erstatte menneskelige bedømmere fuldstændigt?
Nej. Forskning, der sammenligner AI- og menneskelig bedømmelse i IT-rekruttering, fandt lignende gennemsnitlig nøjagtighed, men hurtigere AI-hastighed, mens begge viste inkonsistens ved gentagen scoring. Menneskelig gennemgang er stadig vigtig for tvetydige opgaver og beslutninger i den endelige fase.
Er AI-bedømmelse juridisk forsvarlig ved ansættelsesbeslutninger?
Det kan det være, hvis du validerer værktøjet og dokumenterer processen. SIOP anbefaler formel psykometrisk validering, og flere delstater kræver nu, at kandidater gives besked eller samtykke, når AI bruges i scoring.
Hvad koster Talent Approved?
Talent Approved opkræver $5 pr. gennemført kandidatvurdering på betal-som-du-går-basis, uden abonnement krævet.
Hvad er forskellen mellem målingsbias og prædiktiv bias?
Målingsbias betyder, at en test scorer forskelligt på tværs af grupper på trods af lige underliggende færdigheder. Prædiktiv bias betyder, at scoren forudsiger jobpræstation forskelligt efter gruppe. SIOP behandler disse som separate, testbare problemer – ikke ét generelt retfærdighedsproblem.
Hvilke færdighedstests er sikrest at bedømme med AI alene?
Strukturerede, objektivt scorede tests – kodningsudfordringer, standardiserede vidensquizzer og situationsbedømmelsestests med definerede korrekte svar – passer bedst til AI-only-bedømmelse. Åbne skriftlige besvarelser og interpersonelle rollevurderinger drager stadig fordel af menneskelig gennemgang.