
AI बनाम मानव ग्रेडिंग के लिए HR प्लेबुक: 30–90 दिन का पायलट और 4 TEVV चरण
AI ग्रेडिंग संरचित, भूमिका-विशिष्ट कौशल परीक्षणों के लिए अच्छी तरह काम करती है: यह किसी व्यक्ति की तुलना में तेज़ी से स्कोर करती है और औसत अंकों के करीब पहुँचती है। इसे उच्च-दांव वाले या अस्पष्ट निर्णयों पर अकेले नहीं चलाना चाहिए। SIOP और NIST के TEVV परीक्षण दृष्टिकोण से ढाँचे एक कारण से मौजूद हैं, और Talent Approved जैसे प्लेटफ़ॉर्म AI स्कोरिंग को मानव समीक्षा के साथ जोड़ने पर आधारित हैं, न कि इसे पूरी तरह बदलने पर।
संक्षेप में:
- AI ग्रेडिंग संरचित मूल्यांकनों जैसे कोडिंग परीक्षणों और मानकीकृत ज्ञान प्रश्नोत्तरी के लिए सबसे विश्वसनीय है, जहाँ स्पष्ट सही या गलत उत्तर मौजूद होते हैं।
- प्रारंभिक स्क्रीनिंग में AI और सूक्ष्म या अस्पष्ट कार्यों के लिए मानव समीक्षा वाला एक हाइब्रिड मॉडल गति और सटीकता का सर्वोत्तम संतुलन प्रदान करता है।
- AI और मानव दोनों ग्रेडर समान सबमिशन को स्कोर करने में असंगति दिखाते हैं, जो सत्यापन और निरंतर निगरानी की आवश्यकता पर जोर देता है।
- पूर्वाग्रह जोखिमों में माप पूर्वाग्रह और पूर्वानुमानात्मक पूर्वाग्रह शामिल हैं, जिन्हें गहन परीक्षण, पारदर्शिता और समावेशी रूब्रिक डिज़ाइन के माध्यम से कम किया जा सकता है।
- छोटे पायलट कार्यक्रम चलाना और मूल्यांकन स्कोर की तुलना वास्तविक नौकरी प्रदर्शन से करना यह सुनिश्चित करने में मदद करता है कि AI उपकरण भर्ती में पूर्वानुमानात्मक और निष्पक्ष हैं।
विषय-सूची
- भर्ती में AI ग्रेडिंग और मानव ग्रेडिंग कैसे काम करती है
- ताकत और सीमाएँ: सटीकता, गति, संगति और पूर्वाग्रह
- सत्यापन, परीक्षण और शासन जो HR टीमों को चलाना चाहिए
- कार्यान्वयन चेकलिस्ट: निर्णय नियम और मेट्रिक्स
- उम्मीदवारों के लिए फ़ीडबैक गुणवत्ता पर AI ग्रेडिंग का प्रभाव
- पेपर परीक्षणों से AI स्कोरिंग तक: एक संक्षिप्त इतिहास
- AI बनाम मानव ग्रेडिंग से संबंधित नैतिक विचार
- AI ग्रेडिंग परिणामों की व्याख्या करना कठिन क्यों है
- विभिन्न भूमिकाओं और कौशल प्रकारों में AI ग्रेडिंग
- मानव और AI ग्रेडिंग के एक साथ काम करने का एक व्यावहारिक मार्ग
- AI-सहायता प्राप्त ग्रेडिंग पायलट करने के लिए तैयार हैं? यहाँ से शुरू करें
- स्रोत
- सामान्य प्रश्न
भर्ती में AI ग्रेडिंग और मानव ग्रेडिंग कैसे काम करती है
AI ग्रेडिंग उपकरण उम्मीदवार के काम को प्रशिक्षण लेबल, संरचित मानदंड, या सिस्टम में फीड की गई नौकरी के विवरण से बने रूब्रिक के विरुद्ध स्कोर करते हैं। कुछ AI मूल्यांकन प्लेटफ़ॉर्म ऐसी सुविधाएँ प्रदान करते हैं जो मिनटों में नौकरी के विवरण से भूमिका-विशिष्ट मूल्यांकन और स्कोरिंग संरचनाएँ बनाती हैं, फिर प्रत्येक उम्मीदवार के प्रदर्शन का सारांश तैयार करती हैं ताकि भर्तीकर्ता प्रत्येक सबमिशन को लाइन दर लाइन पढ़े बिना परिणामों की समीक्षा कर सकें। लाभ थ्रूपुट है: इस तरह की एक प्रणाली उतने समय में सैकड़ों कोड नमूने या लिखित प्रतिक्रियाओं को ग्रेड कर सकती है जितने में एक अकेला विषय-विशेषज्ञ कुछ ही की समीक्षा करता है।
मानव ग्रेडिंग अलग तरह से काम करती है। एक विषय-विशेषज्ञ निर्णय, संदर्भ और अनुभव का उपयोग करके एक रूब्रिक लागू करता है, जो सूक्ष्मता के लिए मूल्यवान है लेकिन पैमाने पर महंगा है। दो चीजें इसे हर बार धीमा करती हैं: प्रति उम्मीदवार लागत और इंटर-रेटर परिवर्तनशीलता, यानी दो योग्य समीक्षक मूड, थकान, या रूब्रिक की व्याख्या के आधार पर एक ही उत्तर को अलग-अलग तरह से स्कोर कर सकते हैं।
अधिकांश नियोक्ता एक तरफ चुनने के बजाय हाइब्रिड मॉडल पर आते हैं। सामान्य पैटर्न में शामिल हैं:
- मानव स्पॉट-चेक के साथ AI-पहले: AI हर सबमिशन को ग्रेड करता है, और एक भर्तीकर्ता एक नमूने या किसी सीमारेखा वाले स्कोर की समीक्षा करता है।
- जटिल कार्यों के लिए पहले मानव: खुले-अंत वाले या निर्णय-भारी संकेत सीधे किसी व्यक्ति के पास जाते हैं, जबकि संरचित कार्य (कोडिंग परीक्षण, गणित की समस्याएँ, बहुविकल्पीय तर्क) AI के पास जाते हैं।
- मैकेनिकल संश्लेषण: मानव मूल्यांकनकर्ताओं और एल्गोरिदमिक स्कोरों को एक संयुक्त आउटपुट में मिलाया जाता है, एक ऐसी विधि जो पूर्वानुमानात्मक सटीकता को बनाए रखते हुए उन भर्ती प्रबंधकों की स्वीकृति में सुधार करने के लिए दिखाई गई है जो प्रक्रिया पर मानव जाँच चाहते हैं।
ताकत और सीमाएँ: सटीकता, गति, संगति और पूर्वाग्रह
IT भर्ती में मानव विशेषज्ञों के विरुद्ध AI ग्रेडिंग की एक सहकर्मी-समीक्षित तुलना में दोनों के बीच औसत स्कोर में कोई महत्वपूर्ण अंतर नहीं पाया गया। AI ने बहुत तेज़ी से ग्रेड किया, लेकिन अध्ययन में दोनों पक्षों के लिए कुछ कम चापलूसी भरा भी मिला: न तो पूरी तरह से सुसंगत था। AI ने उसी सबमिशन को फिर से ग्रेड करने पर अलग-अलग स्कोर दिए, और मानव समीक्षकों ने भी वही इंटर-रेटर अविश्वसनीयता दिखाई जो दशकों से भर्ती अनुसंधान में प्रलेखित है।
जहाँ प्रत्येक दृष्टिकोण जीतता है:
- AI कच्ची गति और बड़े उम्मीदवार पूलों में संगति में जीतता है जब कार्य संरचित होता है (कोड परीक्षण, मानकीकृत समस्या सेट)।
- मानव संदर्भ में जीतते हैं: एक अपरंपरागत लेकिन वैध उत्तर को पहचानना, आवास लागू करना, या किसी ऐसे उम्मीदवार को पकड़ना जिसने समस्या को एक अलग लेकिन समान रूप से सही तरीके से हल किया।
- दोहराव क्षमता में कोई भी पूरी तरह नहीं जीतता। AI और मानव दोनों ग्रेडर दूसरे पास पर एक ही काम के लिए अलग-अलग स्कोर दे सकते हैं।
संगति जाँच: उसी अध्ययन में जिसने पाया कि AI ने मानव औसत स्कोर से मिलान किया, यह भी पाया कि AI और मानव दोनों ग्रेडिंग ने समान सबमिशन के दोहराए गए मूल्यांकन पर मापने योग्य असंगति दिखाई, यही कारण है कि किसी भी स्रोत से एकल ग्रेडिंग पास अंतिम भर्ती निर्णय के लिए एक जोखिम भरा आधार है।
पूर्वाग्रह का अपना विवरण होना चाहिए, क्योंकि "पक्षपाती" का उपयोग ढीले तरीके से किया जाता है। SIOP इसे दो अलग, परीक्षण योग्य अवधारणाओं में विभाजित करता है: माप पूर्वाग्रह, जहाँ एक परीक्षण समान अंतर्निहित कौशल के बावजूद विभिन्न समूहों के लिए अलग-अलग प्रदर्शन करता है, और पूर्वानुमानात्मक पूर्वाग्रह, जहाँ एक परीक्षण स्कोर विभिन्न समूहों में नौकरी के प्रदर्शन की अलग-अलग भविष्यवाणी करता है। इन्हें एक अस्पष्ट समस्या के रूप में मानना ऐसा है जिससे नियोक्ता वास्तविक जोखिम चूक जाते हैं। एक सामान्य विफलता मोड लक्ष्य रिसाव है, जहाँ एक मॉडल एक प्रॉक्सी चर पर प्रशिक्षित होता है जो कौशल के बजाय एक संरक्षित विशेषता के साथ सहसंबद्ध होता है। विकलांग उम्मीदवारों के लिए आवासों की अनुपस्थिति एक और है: ADA विचारों के बिना बनाया गया एक AI रूब्रिक एक वैध वैकल्पिक दृष्टिकोण को दंडित कर सकता है जिसे एक मानव समीक्षक तुरंत पहचान लेता।
सत्यापन, परीक्षण और शासन जो HR टीमों को चलाना चाहिए
बिना परीक्षण योजना के AI ग्रेडिंग टूल तैनात करना ऐसा है जिससे नियोक्ता भर्ती निर्णय के बजाय मुकदमे का बचाव करते हैं। NIST का TEVV-Athlon दृष्टिकोण इसके लिए एक व्यावहारिक संरचना देता है, जो चार चरणों के आसपास बनी है:
- लक्ष्य परिभाषित करें। तय करें कि ग्रेडिंग टूल को वास्तव में क्या मापने की आवश्यकता है और भूमिका के लिए "अच्छा प्रदर्शन" कैसा दिखता है।
- निर्माण सत्यापन। पुष्टि करें कि परीक्षण वास्तव में उस कौशल को मापता है जिसका वह दावा करता है, न कि एक ढीले संबंधित प्रॉक्सी को।
- उपयोगकर्ता और क्षेत्र परीक्षण। वास्तविक उम्मीदवार सबमिशन के विरुद्ध टूल चलाएं, जिसमें रेड-टीमिंग प्रयास शामिल हैं जहाँ यह टूटता है या अनुचित तरीके से स्कोर करता है।
- परिणामों को संश्लेषित करें। सब कुछ एक प्रलेखित निर्णय में मिलाएं कि क्या टूल लाइव उपयोग के लिए तैयार है।
लॉन्च से पहले और बाद में एक आवर्ती आधार पर चलाने के लायक एक ऑडिट चेकलिस्ट में निर्माण और व्यावहारिक वैधता जाँच, जनसांख्यिकीय समूहों में प्रतिकूल प्रभाव परीक्षण, लेबल स्रोतों और रूब्रिक डिज़ाइन का प्रलेखन, निष्कर्ष निकालने से पहले पर्याप्त नमूना आकार, और एकमुश्त समीक्षा के बजाय एक निश्चित निगरानी अनुसूची शामिल होनी चाहिए। Talent Approved का अंतर्निहित प्रतिकूल प्रभाव परीक्षण मार्गदर्शन बिना सांख्यिकी पृष्ठभूमि के इस प्रकार की जाँच कैसे चलाएं, इसके बारे में बताता है।
सबसे अनदेखा किया गया कदम फ़ीडबैक एकीकरण है: प्री-हायर स्कोर को वास्तव में होने वाली घटनाओं से जोड़ना। मूल्यांकन स्कोर की तुलना प्रतिधारण और प्रदर्शन डेटा के विरुद्ध करना एक स्क्रीनिंग परीक्षण को एक वास्तविक रूप से पूर्वानुमानात्मक उपकरण में बदल देता है, बजाय एक फ़िल्टर के जिसके बारे में आप उम्मीद करते हैं कि यह काम कर रहा है।
प्रो टिप: अपना पहला सत्यापन चक्र उस भूमिका पर चलाएं जिसके लिए आप पहले से अक्सर भर्ती करते हैं। आपके पास यह जाँचने के लिए पर्याप्त ऐतिहासिक प्रदर्शन डेटा होगा कि क्या मूल्यांकन स्कोर ने वास्तव में कुछ भविष्यवाणी की, बजाय अनुमान लगाने के।
कार्यान्वयन चेकलिस्ट: निर्णय नियम और मेट्रिक्स
हर परीक्षण एक ही बाल्टी में नहीं आता। एक कार्यशील निर्णय नियम इस तरह दिखता है:
- संरचित कोडिंग परीक्षणों, मानकीकृत समस्या सेटों और उच्च-मात्रा प्रारंभिक स्क्रीनिंग के लिए केवल-AI या AI-पहले ग्रेडिंग का उपयोग करें।
- अस्पष्ट मुक्त-पाठ प्रतिक्रियाओं, पोर्टफोलियो मूल्यांकन और किसी भी अंतिम-चरण के निर्णय के लिए मानव समीक्षा की आवश्यकता है जो एक प्रस्ताव को प्रभावित करता है।
- जब भी भूमिका उच्च-दांव वाली हो लेकिन परीक्षण प्रारूप अभी भी AI के लिए पहला पास संभालने के लिए पर्याप्त संरचित हो, हाइब्रिड स्कोरिंग पर डिफ़ॉल्ट करें।
एक बार नियम निर्धारित हो जाने के बाद, उन्हें अनुमान के बजाय वास्तविक मेट्रिक्स से ट्रैक करें:
- इंटर-रेटर समझौता — दो-रेटर तुलनाओं के लिए Cohen's kappa, या जब अधिक रेटर शामिल हों तो Fleiss' kappa, AI-बनाम-मानव और मानव-बनाम-मानव तुलनाओं दोनों पर लागू।
- उपसमूह स्कोर वितरण — माप पूर्वाग्रह को जल्दी पकड़ने के लिए नियमित रूप से जनसांख्यिकीय श्रेणी द्वारा विभाजित।
- पूर्वानुमानात्मक वैधता सहसंबंध — प्री-हायर स्कोर वास्तव में पोस्ट-हायर प्रदर्शन को कितनी अच्छी तरह ट्रैक करते हैं।
- प्रसंस्करण समय और त्रुटि दर — ग्रेडिंग में कितना समय लगता है और आउटपुट को कितनी बार मैन्युअल सुधार की आवश्यकता होती है।
परिचालन नियंत्रण मेट्रिक्स जितने ही महत्वपूर्ण हैं: उम्मीदवारों को वहाँ नोटिस दें जहाँ राज्य कानून इसकी आवश्यकता करता है, आउटलायर स्कोर के लिए एक एस्केलेशन पथ बनाएं, अनुपालन समीक्षा के लिए हर ऑडिट का दस्तावेज़ीकरण करें, और किसी शिकायत के मुद्दे को मजबूर करने की प्रतीक्षा करने के बजाय एक निश्चित पुनः प्रशिक्षण ट्रिगर सेट करें। Talent Approved की तत्काल मूल्यांकन स्कोरिंग इस प्रकार के पारदर्शी, ऑडिट योग्य रूब्रिक को ध्यान में रखकर बनाई गई है।
उम्मीदवारों के लिए फ़ीडबैक गुणवत्ता पर AI ग्रेडिंग का प्रभाव
तेज़ ग्रेडिंग उम्मीदवारों के अनुभव को बदलती है, न केवल वह जो भर्तीकर्ता देखते हैं। एक उम्मीदवार जो एक कौशल परीक्षण पूरा करता है और दो सप्ताह के बजाय घंटों में परिणाम प्राप्त करता है, वह प्रतिस्पर्धी प्रस्ताव स्वीकार करने के बजाय आपकी प्रक्रिया में व्यस्त रहता है। AI-जनरेटेड सारांश सबमिशन के लगभग तुरंत बाद भर्तीकर्ताओं को प्रति उम्मीदवार ताकत और कमजोरियों का पठनीय विवरण दे सकते हैं, जो मूल्यांकन और अगले चरणों के बीच की खाई को कम करता है।
फ़ीडबैक गुणवत्ता फ़ीडबैक गति से एक अलग प्रश्न है, हालांकि, और यह वहाँ है जहाँ AI की अभी भी वास्तविक सीमाएं हैं। एक जनरेटेड सारांश यह संकेत दे सकता है कि उम्मीदवार का कोड कुछ परीक्षण मामलों में विफल हुआ या एक लिखित प्रतिक्रिया रूब्रिक से प्रमुख मानदंडों से चूक गई। यह "क्यों" को उसी बनावट के साथ समझाने के लिए संघर्ष करता है जो एक कुशल मानव समीक्षक लाता है, विशेष रूप से रचनात्मक या निर्णय-भारी कार्यों के लिए जहाँ सही उत्तर एकवचन नहीं है।
अधिकांश हाइब्रिड वर्कफ़्लो जो व्यावहारिक समाधान पर आते हैं वह स्तरित फ़ीडबैक है: AI तुरंत पहले पास का सारांश तैयार करता है, और एक भर्तीकर्ता या भर्ती प्रबंधक उम्मीदवार या भर्ती समिति तक पहुँचने से पहले संदर्भ जोड़ता है। यह स्वचालित ग्रेडिंग के गति लाभ को बनाए रखता है बिना उस व्याख्यात्मक सूक्ष्मता को खोए जो एक व्यक्ति जोड़ता है। यह एक सूक्ष्म जोखिम से भी बचाता है: उम्मीदवार AI सारांश को वास्तव में जितना अधिकृत है उससे अधिक मान लेते हैं, केवल इसलिए कि यह तेज़ी से आया और व्यवस्थित दिखता है।
पेपर परीक्षणों से AI स्कोरिंग तक: एक संक्षिप्त इतिहास
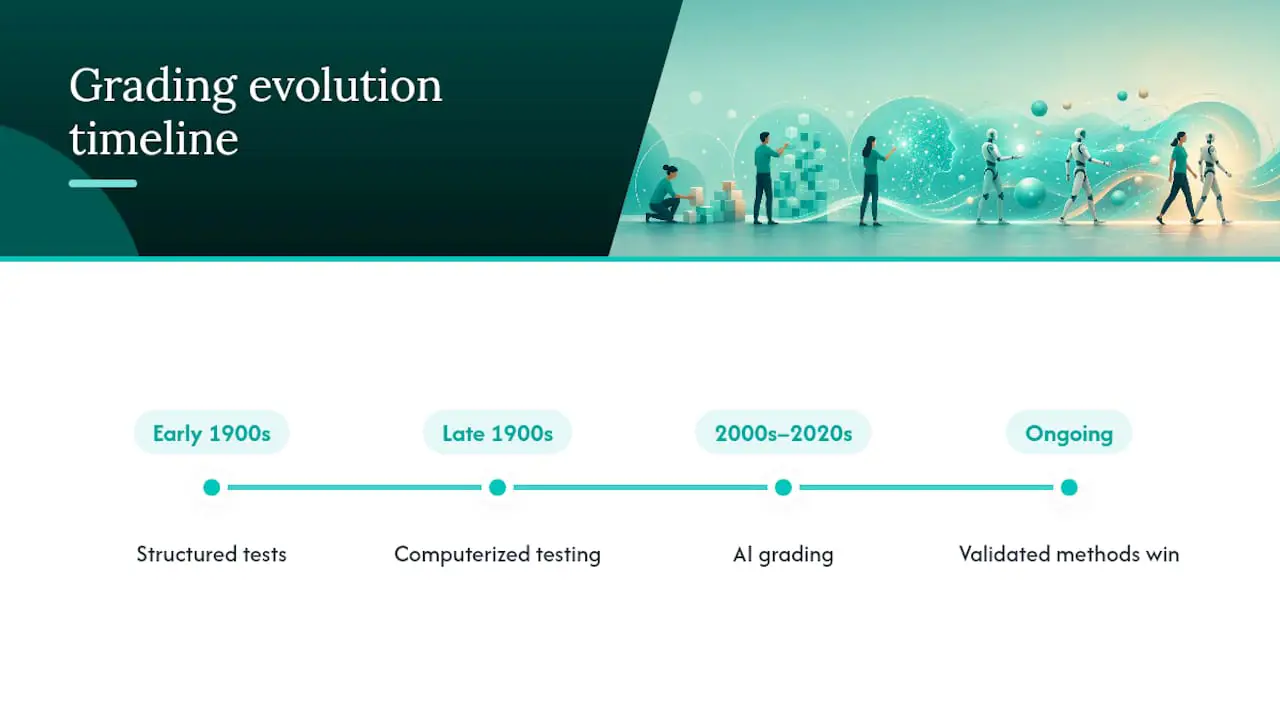
उम्मीदवारों को ग्रेड करना सॉफ़्टवेयर से शुरू नहीं हुआ। संरचित भर्ती मूल्यांकन 20वीं सदी की शुरुआत के कार्मिक मनोविज्ञान में वापस जाता है, जब नियोक्ताओं ने पहली बार आंत की प्रवृत्ति और व्यक्तिगत रेफरल पर निर्भरता को कम करने के लिए परीक्षणों को मानकीकृत करने की कोशिश की। तब से दशकों के शोध ने लगातार यह दिखाया है कि संरचित, नौकरी-प्रासंगिक तरीके, विशेष रूप से कार्य नमूने और संरचित साक्षात्कार, वास्तविक नौकरी प्रदर्शन के साथ सबसे मजबूत संबंध उत्पन्न करते हैं, जो असंरचित साक्षात्कार या अकेले रेज़्यूमे स्क्रीनिंग से बहुत बेहतर है।
अगला बड़ा बदलाव 20वीं सदी के अंत में कम्प्यूटरीकृत परीक्षण के साथ आया, जिसने नियोक्ताओं को स्कोरिंग को मानकीकृत करने और बहुविकल्पीय और संख्यात्मक मूल्यांकनों के लिए कुछ इंटर-रेटर असंगति को कम करने दिया। लेकिन खुले-अंत वाले कार्य, लेखन नमूने, कोड समीक्षा, परिदृश्य प्रतिक्रियाएं, अभी भी उन्हें पढ़ने और जाँचने के लिए एक मानव की आवश्यकता थी, जिसने पैमाने पर ग्रेडिंग को धीमा और महंगा बनाए रखा।
AI ग्रेडिंग उसी प्रक्षेपवक्र में अगला कदम है, इससे अलगाव नहीं। जो बदला वह है असंरचित प्रतिक्रियाओं (लिखित उत्तर, कोड, यहाँ तक कि वीडियो) पर एक सुसंगत रूब्रिक को उस गति से लागू करने की क्षमता जिसे कोई मानव पैनल मेल नहीं कर सकता। चयन विधियों के संयोजन पर शोध जो आधुनिक AI से दशकों पहले का है, अभी भी अंतर्निहित सबक रखता है: मान्य, नौकरी-प्रासंगिक परीक्षण अनौपचारिक निर्णय को मात देते हैं, चाहे ग्रेडर एक व्यक्ति हो या एक मॉडल। AI ने वह सिद्धांत नहीं बनाया। इसने बस इसे पैमाने पर लागू करना अंततः व्यावहारिक बना दिया।
AI बनाम मानव ग्रेडिंग से संबंधित नैतिक विचार
AI ग्रेडिंग के आसपास के नैतिक प्रश्न वास्तव में इस बारे में नहीं हैं कि क्या एक मशीन निष्पक्षता को "समझती" है। वे इस बारे में हैं कि क्या इसे तैनात करने वाले मनुष्यों ने प्रक्रिया में पर्याप्त जवाबदेही बनाई। तीन मुद्दे बार-बार आते हैं।
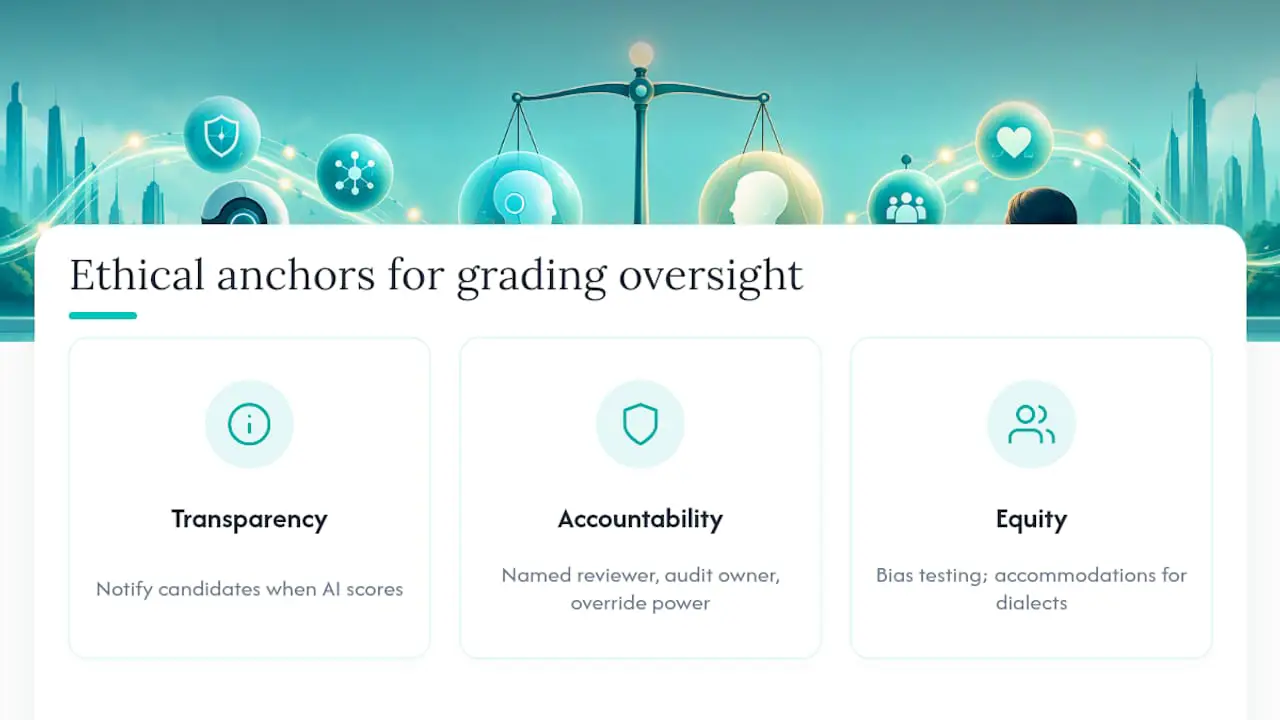
पारदर्शिता। उम्मीदवारों को यह जानने का अधिकार है कि उनके काम को स्कोर करने में AI कब शामिल है, और बढ़ती संख्या में राज्य कानून ठीक उसी प्रकार की सूचना की आवश्यकता करते हैं। जो नियोक्ता इसे बारीक प्रिंट में दबाते हैं, वे केवल नैतिकता की समस्या नहीं, बल्कि कानूनी जोखिम भी पैदा कर रहे हैं।
त्रुटियों के लिए जवाबदेही। जब एक मानव ग्रेडर गलती करता है, तो एस्केलेट करने के लिए एक व्यक्ति होता है। जब एक AI प्रणाली किसी प्रतिक्रिया को गलत ग्रेड करती है, तो जवाबदेही श्रृंखला उतनी ही स्पष्ट होनी चाहिए: कौन आउटलायर की समीक्षा करता है, कौन ऑडिट का मालिक है, और किसके पास स्कोर को ओवरराइड करने का अधिकार है।
उम्मीदवारों के बीच समानता। एक ग्रेडिंग प्रणाली जो आवासों, लिखित प्रतिक्रियाओं में बोली विविधता, या गैर-पारंपरिक समस्या-समाधान दृष्टिकोणों पर ध्यान दिए बिना प्रशिक्षित होती है, चुपचाप योग्य उम्मीदवारों को नुकसान पहुँचा सकती है जब तक कोई प्रतिकूल प्रभाव ऑडिट इसे नहीं पकड़ता। मानव ग्रेडर इस जोखिम का अपना संस्करण अचेतन पूर्वाग्रह के माध्यम से वहन करते हैं, जो ठीक वही कारण है जिसके लिए SIOP किसी भी ग्रेडिंग विधि के लिए पूर्वाग्रह परीक्षण को एक तकनीकी आवश्यकता के रूप में मानता है, न कि एकमुश्त नैतिक चेकबॉक्स के रूप में।
इनमें से कोई भी AI का उपयोग करने के विरुद्ध तर्क नहीं देता। यह किसी भी प्रकार की ग्रेडिंग को एक ऐसी प्रणाली के रूप में मानने के लिए तर्क देता है जिसे निगरानी की आवश्यकता है, न कि एक उपकरण जिसे आप तैनात करते हैं और भूल जाते हैं।
AI ग्रेडिंग परिणामों की व्याख्या करना कठिन क्यों है
एक मानव ग्रेडर आमतौर पर एक वाक्य में एक स्कोर समझा सकता है: "उम्मीदवार का समाधान काम करता था लेकिन एक अकुशल दृष्टिकोण का उपयोग करता था।" एक AI-जनरेटेड स्कोर को अक्सर समझना कठिन होता है, विशेष रूप से जब अंतर्निहित मॉडल दर्जनों संकेतों को वजन देता है जो एक भर्तीकर्ता सीधे कभी नहीं देखता।
यह एक विशिष्ट व्याख्या समस्या बनाता है: एक स्पष्ट तर्क के बिना एक स्कोर का बचाव करना मुश्किल है अगर एक उम्मीदवार इसे चुनौती देता है या एक नियामक पूछता है कि निर्णय कैसे किया गया। यह भी जानना कठिन है कि क्या एक कम स्कोर एक वास्तविक कौशल अंतर को दर्शाता है या उम्मीदवार ने उत्तर को कैसे तैयार किया इसमें एक विचित्रता।
व्यावहारिक उत्तर हर AI स्कोर पर अविश्वास करना नहीं है। यह एक आधारभूत सुविधा के रूप में स्पष्टता की मांग करना है, न कि एक बाद का विचार। एक उपयोगी AI-जनरेटेड सारांश को यह दिखाना चाहिए कि एक उम्मीदवार ने कौन से विशिष्ट मानदंड पूरे किए या चूक गए, न कि केवल एक एकल समग्र संख्या। विवरण का वह स्तर एक भर्तीकर्ता को AI के तर्क को उसी तरह क्रॉस-चेक करने देता है जैसे वे एक मानव समीक्षक के नोट्स को स्वच्छता-जाँच करते, और यह एक अपारदर्शी स्कोर को ऐसी चीज़ में बदल देता है जिसके पीछे एक भर्ती प्रबंधक वास्तव में अंतिम निर्णय में खड़ा हो सकता है।
विभिन्न भूमिकाओं और कौशल प्रकारों में AI ग्रेडिंग
AI ग्रेडिंग एक समान रूप से लागू एक उपकरण नहीं है। यह कितनी अच्छी तरह काम करता है यह इस बात पर निर्भर करता है कि क्या परीक्षण किया जा रहा है।
तकनीकी और कोडिंग मूल्यांकन वे हैं जहाँ AI ग्रेडिंग सबसे विश्वसनीय रूप से प्रदर्शन करती है। परीक्षण मामले या तो पास होते हैं या विफल होते हैं, निष्पादन समय मापने योग्य है, और कोड गुणवत्ता मेट्रिक्स स्पष्ट मानदंडों के विरुद्ध स्कोर किए जा सकते हैं, जो ठीक वह संरचित वातावरण है जिसे IT भर्ती अध्ययन ने तब मापा जब उसने AI को बहुत तेज़ गति से मानव औसत स्कोर से मिलाते पाया।
संरचित ज्ञान परीक्षण, अनुपालन प्रश्नोत्तरी, योग्यता परीक्षण, परिभाषित सही उत्तरों वाले परिस्थितिजन्य निर्णय परीक्षण, लगभग उतने ही मजबूत फिट हैं, क्योंकि स्कोरिंग तर्क एक अच्छी तरह से बने बहुविकल्पीय परीक्षा से मुश्किल से अलग होता है।
लिखित प्रतिक्रिया और संचार कार्य बीच में बैठते हैं। AI व्याकरण, संरचना और क्या एक प्रतिक्रिया ने संकेत को संबोधित किया, इसे चिह्नित कर सकता है, लेकिन टोन, प्रेरकता, या रचनात्मक समस्या-समाधान का निर्णय करना अभी भी एक मानव दूसरी नज़र से लाभान्वित होता है।
बिक्री, ग्राहक सेवा और पारस्परिक भूमिका कार्य अभी के लिए मानव-भारी हैं। ये भूमिकाएं भावनात्मक संकेतों को पढ़ने और बातचीत के बीच में अनुकूलन पर निर्भर करती हैं, ऐसा क्षेत्र जहाँ एक रूब्रिक यह कैप्चर करने के लिए संघर्ष करता है कि वास्तव में नौकरी पर सफलता की भविष्यवाणी क्या करती है।
Talent Approved का भूमिका-विशिष्ट परीक्षण डिज़ाइन मार्गदर्शन मूल्यांकन प्रारूप को परीक्षण किए जा रहे कौशल से मिलाने के आसपास बनाया गया है, जो किसी भी दी गई भूमिका के लिए AI स्कोरिंग पर कितना वजन डालना है, यह तय करने का वास्तविक उत्तोलक है।
मानव और AI ग्रेडिंग के एक साथ काम करने का एक व्यावहारिक मार्ग
सब-या-कुछ नहीं की बहस को छोड़ दें। एक भूमिका पर एक पायलट चलाएं, एक को चुनने के बजाय मैकेनिकल संश्लेषण के माध्यम से AI स्कोर को मानव निर्णय के साथ मिलाएं, और किसी भी उच्च-दांव वाली चीज़ पर स्केल करने से पहले एक छोटे नमूने का ऑडिट करें। प्लेटफ़ॉर्म सुविधाएँ जो इसका समर्थन करती हैं, संरचित रूब्रिक जनरेशन, एंटी-चीट मॉनिटरिंग, AI-जनरेटेड सारांश, मानव समीक्षा चरण को तेज़ करने के लिए मौजूद हैं, इसे बदलने के लिए नहीं। प्री-हायर स्कोर के विरुद्ध पोस्ट-हायर प्रदर्शन ट्रैक करें और जब डेटा आपको बताए तब रूब्रिक को समायोजित करें, उससे पहले नहीं।
— Jimmie
AI-सहायता प्राप्त ग्रेडिंग पायलट करने के लिए तैयार हैं? यहाँ से शुरू करें
Talent Approved ठीक उस हाइब्रिड मॉडल के लिए बनाया गया है जिसकी इस लेख में अनुशंसा की गई है: AI स्कोरिंग पर भारी काम करता है, और आप अंतिम निर्णय अपने पास रखते हैं। Magic Create एक नौकरी विवरण को मिनटों में एक भूमिका-विशिष्ट मूल्यांकन में बदल देता है, अंतर्निहित एंटी-चीट मॉनिटरिंग (स्क्रीन और वेबकैम जाँच, सेशन रिप्ले) आप जो स्कोर कर रहे हैं उसकी अखंडता की रक्षा करती है, और AI-जनरेटेड सारांश आपको एक कच्ची संख्या के बजाय प्रति उम्मीदवार पठनीय विवरण देते हैं। मूल्य निर्धारण $5 प्रति पूर्ण उम्मीदवार मूल्यांकन पर पे-एज़-यू-गो मॉडल पर चलता है, बिना सदस्यता की आवश्यकता के।
यदि आप इसे ठीक से परीक्षण करने के लिए तैयार हैं, तो 30 से 90 दिन का पायलट चलाएं: एक भूमिका चुनें, Magic Create के साथ मूल्यांकन उत्पन्न करें, समानांतर में AI सारांश और एक मानव समीक्षक दोनों के साथ हर सबमिशन को स्कोर करें, परिणामों में प्रतिकूल प्रभाव जाँच चलाएं, और पायलट नियुक्तियों की तुलना प्रदर्शन डेटा से करें एक बार जब वे नौकरी पर हों। पूर्ण रोलआउट के लिए प्रतिबद्ध होने से पहले अपने पायलट का दायरा तय करने के लिए मूल्य निर्धारण पृष्ठ देखें।
स्रोत
पैमाने पर AI ग्रेडिंग शुरू करने से पहले, SIOP के सत्यापन मार्गदर्शन, NIST के TEVV-Athlon ढाँचे, और AI और मानव ग्रेडिंग की तुलना करने वाले IT भर्ती अध्ययन की समीक्षा करें। विकसित होती कानूनी बाध्यताओं के लिए, K&L Gates का बदलते संघीय मार्गदर्शन का सारांश पढ़ने योग्य है।
- IT भर्ती के संदर्भ में ChatGPT बनाम मानव विशेषज्ञता
- कर्मचारी चयन के लिए AI-आधारित मूल्यांकनों के सत्यापन और उपयोग के लिए विचार और सिफारिशें (SIOP)
- NIST ARIA 0.1 पायलट रिपोर्ट
- कार्मिक मनोविज्ञान में चयन विधियों की वैधता और उपयोगिता
सामान्य प्रश्न
क्या AI मानव ग्रेडरों को पूरी तरह से बदल सकता है?
नहीं। IT भर्ती में AI और मानव ग्रेडिंग की तुलना करने वाले शोध में समान औसत सटीकता लेकिन तेज़ AI गति पाई गई, जबकि दोनों ने दोहराए गए स्कोरिंग में असंगति दिखाई। अस्पष्ट कार्यों और अंतिम-चरण के निर्णयों के लिए मानव समीक्षा अभी भी महत्वपूर्ण है।
क्या भर्ती निर्णयों के लिए AI ग्रेडिंग कानूनी रूप से बचाव योग्य है?
यह हो सकती है, यदि आप टूल को मान्य करते हैं और प्रक्रिया का दस्तावेज़ीकरण करते हैं। SIOP औपचारिक मनोमितीय सत्यापन की सिफारिश करता है, और कई राज्यों को अब स्कोरिंग में AI का उपयोग होने पर उम्मीदवार की सूचना या सहमति की आवश्यकता होती है।
Talent Approved की लागत कितनी है?
Talent Approved बिना सदस्यता की आवश्यकता के पे-एज़-यू-गो आधार पर प्रति पूर्ण उम्मीदवार मूल्यांकन $5 चार्ज करता है।
माप पूर्वाग्रह और पूर्वानुमानात्मक पूर्वाग्रह के बीच क्या अंतर है?
माप पूर्वाग्रह का अर्थ है कि एक परीक्षण समान अंतर्निहित कौशल के बावजूद विभिन्न समूहों में अलग-अलग स्कोर करता है। पूर्वानुमानात्मक पूर्वाग्रह का अर्थ है कि स्कोर समूह द्वारा नौकरी के प्रदर्शन की अलग-अलग भविष्यवाणी करता है। SIOP इन्हें अलग, परीक्षण योग्य मुद्दों के रूप में मानता है, न कि एक सामान्य निष्पक्षता समस्या के रूप में।
केवल AI के साथ ग्रेड करने के लिए कौन से कौशल परीक्षण सबसे सुरक्षित हैं?
संरचित, वस्तुनिष्ठ रूप से स्कोर किए गए परीक्षण, कोडिंग चुनौतियाँ, मानकीकृत ज्ञान प्रश्नोत्तरी, और परिभाषित सही उत्तरों वाले परिस्थितिजन्य निर्णय परीक्षण, केवल-AI ग्रेडिंग के लिए सबसे सुरक्षित फिट हैं। खुले-अंत वाली लिखित प्रतिक्रियाएं और पारस्परिक भूमिका मूल्यांकन अभी भी मानव समीक्षा से लाभान्वित होते हैं।