
HR-handbok för AI vs mänsklig bedömning: 30–90 dagars pilot och 4 TEVV-steg
AI-bedömning fungerar bra för strukturerade, rollspecifika kompetenstester: det sätter betyg snabbare än en person och landar nära samma genomsnittspoäng. Det bör inte köras ensamt vid högriskbeslut eller tvetydiga situationer. Ramverk från SIOP och NISTs TEVV-testmetod finns av en anledning, och plattformar som Talent Approved är byggda kring att para ihop AI-bedömning med mänsklig granskning – inte att ersätta den helt.
TL;DR:
- AI-bedömning är mest tillförlitlig för strukturerade tester som kodningsprov och standardiserade kunskapsquizzar, där tydliga rätt eller fel svar finns.
- En hybridmodell med AI vid initial screening och mänsklig granskning för nyanserade eller tvetydiga uppgifter erbjuder den bästa balansen mellan hastighet och noggrannhet.
- Både AI och mänskliga bedömare uppvisar inkonsekvenser när de sätter betyg på identiska inlämningar, vilket understryker behovet av validering och löpande övervakning.
- Risker för partiskhet inkluderar mätpartiskhet och prediktiv partiskhet, vilket kan mildras genom noggrann testning, transparens och inkluderande rubrikdesign.
- Att köra små pilotprogram och jämföra bedömningspoäng med faktisk arbetsprestation hjälper till att säkerställa att AI-verktyg är prediktiva och rättvisa vid rekrytering.
Innehållsförteckning
- Hur AI-bedömning och mänsklig bedömning fungerar vid rekrytering
- Styrkor och begränsningar: noggrannhet, hastighet, konsekvens och partiskhet
- Validering, testning och styrning som HR-team måste genomföra
- Checklista för implementering: beslutsregler och mätvärden
- AI-bedömningens påverkan på feedbackkvaliteten för kandidater
- Från pappersprov till AI-bedömning: en kort historik
- Etiska överväganden specifika för AI- kontra mänsklig bedömning
- Varför AI-bedömningsresultat är svårare att tolka
- AI-bedömning inom olika roller och kompetenstyper
- En pragmatisk väg till att mänsklig och AI-baserad bedömning fungerar tillsammans
- Redo att testa AI-assisterad bedömning? Börja här
- Källor
- FAQ
Hur AI-bedömning och mänsklig bedömning fungerar vid rekrytering
AI-bedömningsverktyg poängsätter kandidaters arbete mot en rubrik byggd på träningsetiketter, strukturerade kriterier eller en arbetsbeskrivning som matats in i systemet. Vissa AI-bedömningsplattformar erbjuder funktioner som bygger rollspecifika bedömningar och poängsättningsstrukturer utifrån arbetsbeskrivningar på några minuter, och sedan genererar sammanfattningar av varje kandidats prestation så att rekryterare kan granska resultaten utan att läsa varje inlämning rad för rad. Fördelen är genomströmning: ett sådant system kan bedöma hundratals kodexempel eller skriftliga svar på den tid en enda ämnesexpert hinner granska ett fåtal.
Mänsklig bedömning fungerar annorlunda. En ämnesexpert tillämpar en rubrik med hjälp av omdöme, sammanhang och erfarenhet, vilket är värdefullt för nyansering men dyrt att skala upp. Två saker bromsar det varje gång: kostnad per kandidat och variabilitet mellan bedömare – det vill säga att två kvalificerade granskare kan sätta olika betyg på samma svar beroende på humör, trötthet eller tolkning av rubriken.
De flesta arbetsgivare landar i en hybridmodell snarare än att välja en sida. Vanliga mönster inkluderar:
- AI-först med mänskliga stickprov: AI bedömer varje inlämning, och en rekryterare granskar ett urval eller eventuella gränsfall.
- Människa-först för komplexa uppgifter: öppna eller omdömeskrävande uppgifter går direkt till en person, medan strukturerade uppgifter (kodningsprov, matematikuppgifter, flervalsfrågor i logik) går till AI.
- Mekanisk syntes: mänskliga bedömares och algoritmiska poäng blandas till ett kombinerat resultat – en metod som visat sig bevara prediktiv noggrannhet och samtidigt öka acceptansen hos rekryteringschefer som vill ha en mänsklig kontroll i processen.
Styrkor och begränsningar: noggrannhet, hastighet, konsekvens och partiskhet
En expertgranskad jämförelse av AI-bedömning mot mänskliga experter inom IT-rekrytering fann ingen signifikant skillnad i genomsnittspoäng mellan de två. AI bedömde betydligt snabbare, men studien avslöjade också något mindre smickrande för båda sidor: ingen var helt konsekvent. AI producerade varierande poäng när den ombads att betygsätta samma inlämning på nytt, och mänskliga granskare uppvisade samma otillförlitlighet mellan bedömare som dokumenterats i rekryteringsforskning i decennier.
Var respektive metod tenderar att vinna:
- AI vinner på ren hastighet och konsekvens över stora kandidatpooler när uppgiften är strukturerad (kodningsprov, standardiserade uppgiftsset).
- Människor vinner på sammanhang: att känna igen ett okonventionellt men giltigt svar, tillämpa anpassningar eller fånga upp en kandidat som löste problemet på ett annorlunda men lika korrekt sätt.
- Ingen vinner helt och hållet på repeterbarhet. Både AI och mänskliga bedömare kan producera olika poäng för samma arbete vid en andra genomgång.
Konsekvenskontroll: samma studie som fann att AI matchade mänskliga genomsnittspoäng fann också att både AI- och mänsklig bedömning uppvisade mätbar inkonsekvens vid upprepad utvärdering av identiska inlämningar – vilket är anledningen till att en enda bedömningsomgång från endera källan är ett riskabelt underlag för ett slutgiltigt rekryteringsbeslut.
Partiskhet förtjänar en egen genomgång, eftersom "partisk" används löst. SIOP delar upp det i två distinkta, testbara begrepp: mätpartiskhet, där ett test presterar olika för olika grupper trots lika underliggande kompetens, och prediktiv partiskhet, där ett testresultat förutsäger arbetsprestation olika beroende på grupp. Att behandla dessa som ett vagt problem är hur arbetsgivare missar verkliga risker. Ett vanligt misslyckande är målläckage, där en modell tränas på en proxyvariabel som korrelerar med ett skyddat kännetecken snarare än kompetensen i sig. Bristande anpassningar för kandidater med funktionsnedsättningar är ett annat: en AI-rubrik byggd utan hänsyn till tillgänglighetskrav kan straffa ett legitimt alternativt tillvägagångssätt som en mänsklig granskare skulle känna igen omedelbart.
Validering, testning och styrning som HR-team måste genomföra
Att driftsätta ett AI-bedömningsverktyg utan en testplan är hur arbetsgivare hamnar i en rättegång i stället för ett rekryteringsbeslut. NISTs TEVV-Athlon-metod ger en praktisk struktur för detta, byggd kring fyra steg:
- Definiera mål. Bestäm exakt vad bedömningsverktyget behöver mäta och hur "god prestation" ser ut för rollen.
- Konstruktvalidering. Bekräfta att testet faktiskt mäter den kompetens det påstår sig mäta och inte en löst relaterad proxyvariabel.
- Användar- och fälttestning. Kör verktyget mot verkliga kandidatinlämningar, inklusive red-teaming-försök för att hitta var det brister eller bedömer orättvist.
- Syntetisera resultaten. Sammanfatta allt i ett dokumenterat omdöme om huruvida verktyget är redo för skarp användning.
En granskningschecklista som är värd att köra inför lansering och på återkommande basis efteråt bör inkludera konstrukt- och praktisk validitetskontroll, kontroll av negativ påverkan över demografiska grupper, dokumentation av etikettkällor och rubrikdesign, tillräckliga urvalsstorlekar innan slutsatser dras samt ett fast övervakningsschema snarare än en engångsgranskning. Talent Approved:s inbyggda vägledning för test av negativ påverkan går igenom hur man genomför den här typen av kontroll utan statistikbakgrund.
Det mest förbisedda steget är feedbackintegration: att koppla samman poäng före anställning med vad som faktiskt händer efter anställningen. Att jämföra bedömningspoäng mot data om kvarhållning och prestation förvandlar ett urvalstest till ett genuint prediktivt instrument, snarare än ett filter man hoppas fungerar.
Proffstips: Kör din första valideringscykel på en roll du redan rekryterar till ofta. Du har tillräckligt med historisk prestationsdata för att kontrollera om bedömningspoängen faktiskt förutsåg något, i stället för att gissa.
Checklista för implementering: beslutsregler och mätvärden
Inte alla tester hör hemma i samma hink. En fungerande beslutsregel ser ut så här:
- Använd enbart AI eller AI-först för strukturerade kodningsprov, standardiserade uppgiftsset och storskalig initial screening.
- Kräv mänsklig granskning för tvetydiga fritext-svar, portföljutvärdering och alla slutskedesbeslut som påverkar ett erbjudande.
- Använd som standard hybridbedömning när rollen är högrisk men testformatet ändå är tillräckligt strukturerat för att AI ska kunna hantera en första genomgång.
När reglerna är satta, följ upp dem med verkliga mätvärden i stället för magkänsla:
- Samstämmighet mellan bedömare – Cohens kappa för jämförelser med två bedömare, eller Fleiss kappa när fler bedömare är inblandade, tillämpat på både AI-kontra-människa och människa-kontra-människa-jämförelser.
- Poängfördelningar per undergrupp – regelbundet uppdelade per demografisk kategori för att fånga mätpartiskhet tidigt.
- Prediktiva validitetskorrelationer – hur väl poäng före anställning faktiskt spårar prestation efter anställning.
- Behandlingstid och felfrekvens – hur lång tid bedömningen tar och hur ofta utdata behöver manuell korrigering.
Operativa kontroller är lika viktiga som mätvärdena i sig: ge kandidater information där delstatslag kräver det, bygg en eskaleringsväg för avvikande poäng, dokumentera varje granskning för efterlevnadsöversyn och sätt en fast omträningströskel snarare än att vänta på ett klagomål som tvingar fram åtgärden. Talent Approved:s direktbedömningspoängsättning är byggd med denna typ av transparent, granskningsbar rubrik i åtanke.
AI-bedömningens påverkan på feedbackkvaliteten för kandidater
Snabbare bedömning förändrar vad kandidater upplever, inte bara vad rekryterare ser. En kandidat som genomför ett kompetenstest och får ett resultat inom timmar i stället för två veckor förblir engagerad i din process i stället för att tacka ja till ett konkurrerande erbjudande. AI-genererade sammanfattningar kan ge rekryterare en läsbar genomgång av styrkor och brister per kandidat nästan omedelbart efter inlämning, vilket förkortar gapet mellan bedömning och nästa steg.
Feedbackkvalitet är en separat fråga från feedbackhastighet, och det är där AI fortfarande har verkliga begränsningar. En genererad sammanfattning kan flagga att en kandidats kod inte klarade vissa testfall eller att ett skriftligt svar missade nyckelkriterier från rubriken. Den kämpar med att förklara "varför" med samma textur som en skicklig mänsklig granskare tillför, särskilt för kreativa eller omdömeskrävande uppgifter där rätt svar inte är entydigt.
Den praktiska lösning som de flesta hybridarbetsflöden landar på är skiktad feedback: AI genererar förstahandssammanfattningen omedelbart, och en rekryterare eller rekryteringschef lägger till sammanhang innan den når en kandidat eller ett rekryteringsutskott. Detta bevarar hastighetsfördelarna med automatiserad bedömning utan att förlora den tolkande nyansering en person tillför. Det skyddar också mot en subtilare risk: att kandidater litar på en AI-sammanfattning som mer auktoritativ än den faktiskt är, helt enkelt för att den kom snabbt och ser prydlig ut.
Från pappersprov till AI-bedömning: en kort historik
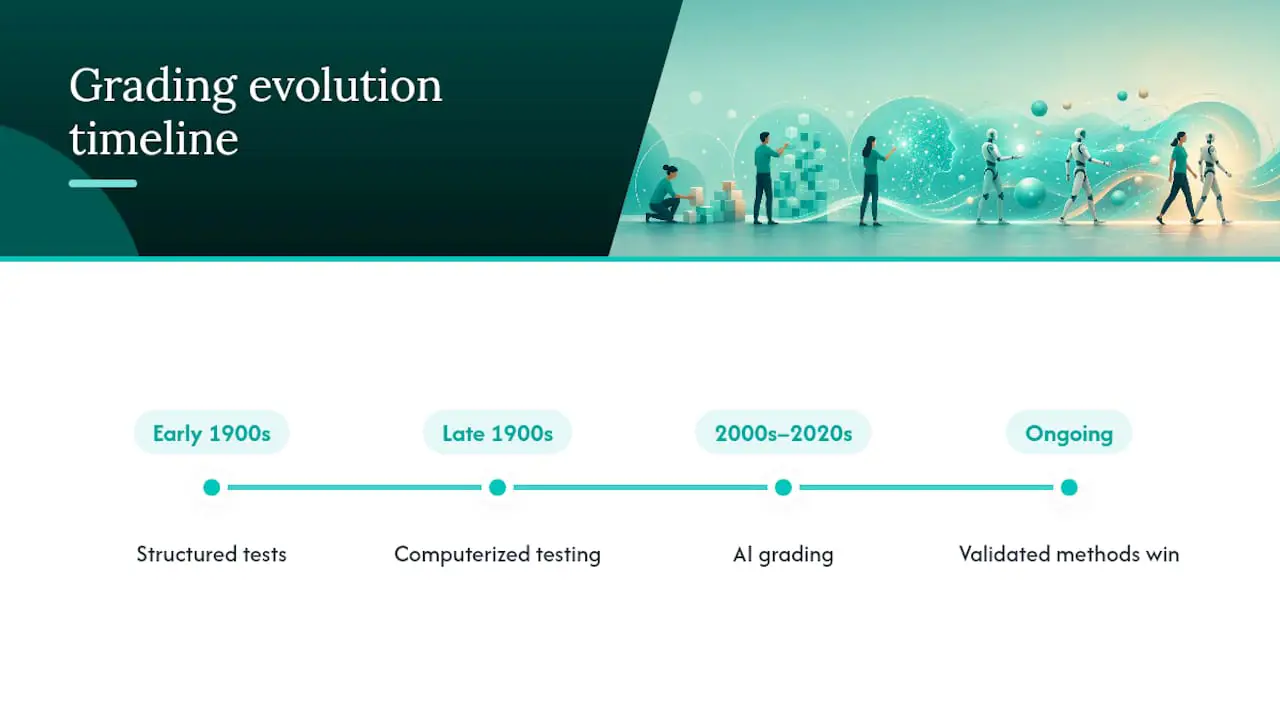
Att bedöma kandidater började inte med programvara. Strukturerad rekryteringsbedömning spårar tillbaka till tidig 1900-tals personalpsykologi, när arbetsgivare för första gången försökte standardisera tester för att minska beroendet av magkänsla och personliga rekommendationer. Decennier av forskning sedan dess visar konsekvent att strukturerade, jobbspecifika metoder – arbetsprovsuppgifter och strukturerade intervjuer framför allt – ger den starkaste kopplingen till faktisk arbetsprestation, långt bättre än ostrukturerade intervjuer eller CV-granskning ensamt.
Nästa stora skifte kom med datorbaserade tester i slutet av 1900-talet, vilket lät arbetsgivare standardisera poängsättningen och minska viss inkonsekvens mellan bedömare för flervals- och numeriska bedömningar. Men öppna uppgifter – skrivprov, kodgranskning, scenariosvar – krävde fortfarande en människa för att läsa och bedöma dem, vilket höll bedömningen långsam och dyr i stor skala.
AI-bedömning är nästa steg i samma bana, inte ett brott mot den. Det som förändrats är förmågan att tillämpa en konsekvent rubrik på ostrukturerade svar (skriftliga svar, kod, till och med video) i en hastighet som ingen mänsklig panel kan matcha. Forskningen om att kombinera urvalsmetoder som föregår modern AI med decennier håller fortfarande den underliggande lärdomen: validerade, jobbspecifika tester slår informellt omdöme, oavsett om bedömaren är en person eller en modell. AI uppfann inte den principen. Den gjorde det bara äntligen praktiskt att tillämpa den i stor skala.
Etiska överväganden specifika för AI- kontra mänsklig bedömning
De etiska frågorna kring AI-bedömning handlar egentligen inte om huruvida en maskin "förstår" rättvisa. De handlar om huruvida de människor som driftsätter den byggde in tillräcklig ansvarsskyldighet i processen. Tre frågor dyker upp upprepade gånger.
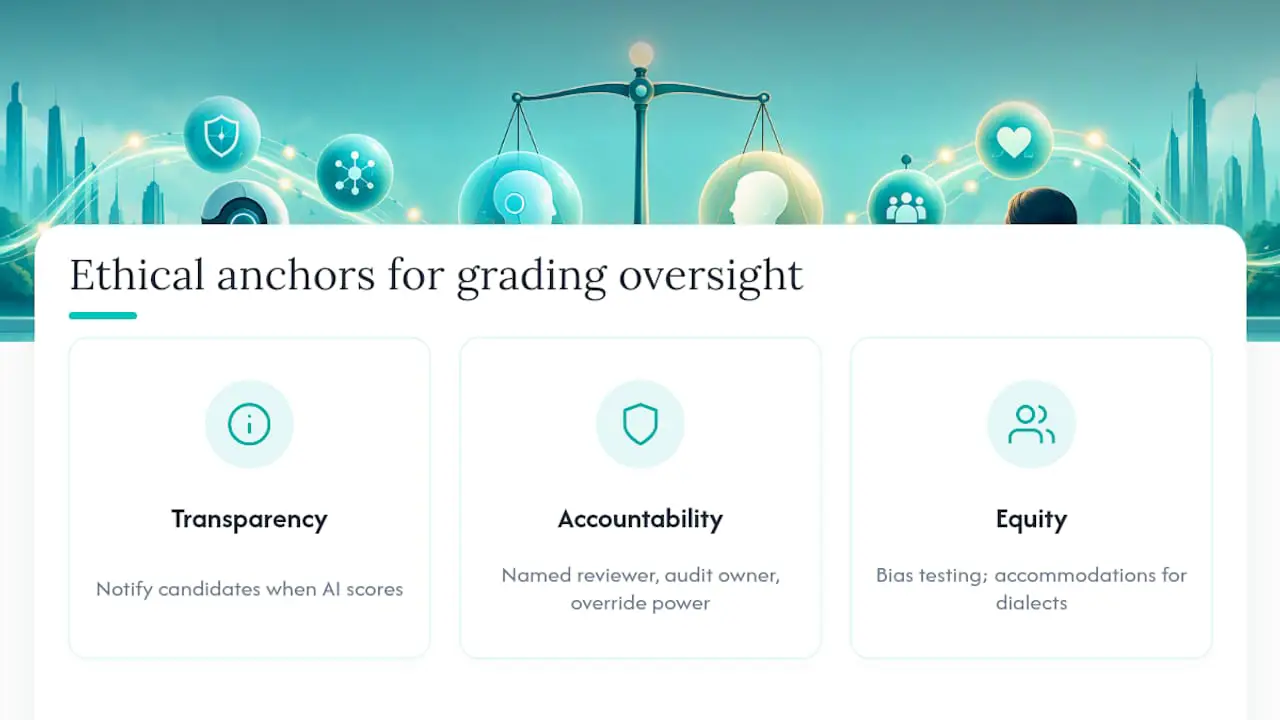
Transparens. Kandidater förtjänar att veta när AI är inblandad i bedömningen av deras arbete, och ett växande antal delstatslagar kräver exakt den typen av information. Arbetsgivare som gömmer detta i småtryckt skapar juridisk exponering, inte bara ett etikproblem.
Ansvarsskyldighet för fel. När en mänsklig bedömare gör ett misstag finns det en person att eskalera till. När ett AI-system bedömer fel måste ansvarskedjan vara lika tydlig: vem granskar avvikelser, vem äger granskningen och vem har befogenhet att åsidosätta en poäng.
Rättvisa för alla kandidater. Ett bedömningssystem tränat utan hänsyn till anpassningar, dialektvariationer i skriftliga svar eller icke-traditionella problemlösningsmetoder kan tyst missgynna kvalificerade kandidater utan att någon märker det förrän en granskning av negativ påverkan fångar upp det. Mänskliga bedömare bär sin egen version av denna risk genom omedveten partiskhet, vilket är precis varför SIOP behandlar partiskhetstest som ett tekniskt krav för båda bedömningsmetoderna, inte som en engångs etisk kryssruta.
Inget av detta argumenterar mot att använda AI. Det argumenterar för att behandla bedömning – av endera typen – som ett system som behöver tillsyn, inte ett verktyg man driftsätter och glömmer.
Varför AI-bedömningsresultat är svårare att tolka
En mänsklig bedömare kan vanligtvis förklara ett betyg i en mening: "kandidatens lösning fungerade men använde ett ineffektivt tillvägagångssätt." En AI-genererad poäng är ofta svårare att packa upp, särskilt när den underliggande modellen väger dussintals signaler som en rekryterare aldrig ser direkt.
Detta skapar ett specifikt tolkningsproblem: en poäng utan en tydlig motivering är svår att försvara om en kandidat ifrågasätter den eller en tillsynsmyndighet frågar hur ett beslut fattades. Det är också svårare att veta om en låg poäng återspeglar en verklig kompetenslucka eller ett särdrag i hur kandidaten formulerade ett svar.
Det praktiska svaret är inte att misstro varje AI-poäng. Det är att kräva förklarbarhet som en grundläggande funktion, inte ett eftertanke. En användbar AI-genererad sammanfattning bör visa vilka specifika kriterier en kandidat uppfyllde eller missade, inte bara ett enda sammansatt tal. Den detaljeringsnivån låter en rekryterare dubbelkolla AI:ns resonemang på samma sätt som man rimlighetskontrollerar en mänsklig granskares anteckningar – och förvandlar en ogenomskinlig poäng till något en rekryteringschef faktiskt kan stå bakom i ett slutgiltigt beslut.
AI-bedömning inom olika roller och kompetenstyper
AI-bedömning är inte ett verktyg som tillämpas enhetligt. Hur väl det fungerar varierar beroende på vad som testas.
Tekniska bedömningar och kodningsprov är där AI-bedömning presterar mest tillförlitligt. Testfall antingen passerar eller misslyckas, körningstid är mätbar och kodkvalitetsmått kan poängsättas mot tydliga kriterier – vilket är precis den strukturerade miljö som IT-rekryteringsstudien mätte när den fann att AI matchade mänskliga genomsnittspoäng vid mycket högre hastighet.
Strukturerade kunskapsprov – efterlevnadsquizzar, anlagstest, situationsbaserade omdömestester med definierade korrekta svar – är nästan lika stark en passform, eftersom poängsättningslogiken knappt skiljer sig från ett välkonstruerat flervalsprov.
Skriftliga svar och kommunikationsuppgifter befinner sig i mitten. AI kan flagga grammatik, struktur och huruvida ett svar adresserade uppmaningen, men att bedöma ton, övertygande kraft eller kreativ problemlösning gynnas fortfarande av en mänsklig andra blick.
Sälj-, kundtjänst- och interpersonella rolluppgifter lutar tungt mot människor för tillfället. Dessa roller är beroende av att läsa känslomässiga signaler och anpassa sig mitt i en konversation – ett territorium där en rubrik kämpar med att fånga vad som faktiskt förutsäger framgång i jobbet.
Talent Approved:s vägledning för rollspecifik testdesign är byggd kring att matcha bedömningsformatet med den kompetens som testas – vilket är den verkliga spaken för att avgöra hur mycket vikt man ska lägga på AI-bedömning för en given roll.
En pragmatisk väg till att mänsklig och AI-baserad bedömning fungerar tillsammans
Hoppa över allt-eller-inget-debatten. Kör ett pilotprojekt på en roll, blanda AI-poäng med mänskligt omdöme genom mekanisk syntes i stället för att välja ett alternativ, och granska ett litet urval innan du skalar upp till något med hög insats. Plattformsfunktioner som stödjer detta – strukturerad rubrikgenerering, fusksäkerhetsövervakning, AI-genererade sammanfattningar – finns till för att göra det mänskliga granskningssteget snabbare, inte för att ersätta det. Spåra prestation efter anställning mot poäng före anställning och justera rubriken när datan säger att du ska göra det, inte dessförinnan.
— Jimmie
Redo att testa AI-assisterad bedömning? Börja här
Talent Approved är byggt för precis den hybridmodell som den här artikeln rekommenderar: AI gör det tunga lyftet vid poängsättning och du behåller det slutliga avgörandet. Magic Create förvandlar en arbetsbeskrivning till en rollspecifik bedömning på några minuter, inbyggd fusksäkerhetsövervakning (skärm- och webbkamerakontroller, sessionsuppspelningar) skyddar integriteten hos det du bedömer, och AI-genererade sammanfattningar ger dig en läsbar genomgång per kandidat i stället för ett råtal. Prissättningen bygger på en betala-per-användning-modell till 5 dollar per genomförd kandidatbedömning, utan krav på prenumeration.
Om du är redo att testa detta ordentligt, kör ett 30 till 90 dagars pilotprojekt: välj en roll, generera bedömningen med Magic Create, poängsätt varje inlämning med både AI-sammanfattningen och en mänsklig granskare parallellt, kör en kontroll av negativ påverkan på resultaten och jämför pilotanställningar mot prestationsdata när de väl är i tjänst. Kolla prissidan för att planera ditt pilotprojekt innan du förbinder dig till en fullständig utrullning.
Källor
Innan du rullar ut AI-bedömning i stor skala, granska SIOPs valideringsvägledning, NISTs TEVV-Athlon-ramverk och IT-rekryteringsstudien som jämför AI- och mänsklig bedömning. För utvecklande juridiska skyldigheter är K&L Gates sammanfattning av förändrad federal vägledning värd att läsa.
- ChatGPT vs mänsklig expertis i samband med IT-rekrytering
- Överväganden och rekommendationer för validering och användning av AI-baserade bedömningar för personalurval (SIOP)
- NIST ARIA 0.1 pilotrapport
- Validiteten och nyttan av urvalsmetoder inom personalpsykologi
FAQ
Kan AI ersätta mänskliga bedömare helt och hållet?
Nej. Forskning som jämför AI- och mänsklig bedömning inom IT-rekrytering fann liknande genomsnittlig noggrannhet men högre AI-hastighet, medan båda uppvisade inkonsekvens vid upprepad poängsättning. Mänsklig granskning spelar fortfarande roll för tvetydiga uppgifter och slutskedesbeslut.
Är AI-bedömning juridiskt försvarbar för rekryteringsbeslut?
Det kan den vara, om du validerar verktyget och dokumenterar processen. SIOP rekommenderar formell psykometrisk validering, och flera delstater kräver nu att kandidater informeras eller ger samtycke när AI används vid poängsättning.
Hur mycket kostar Talent Approved?
Talent Approved tar ut 5 dollar per genomförd kandidatbedömning på betala-per-användning-basis, utan krav på prenumeration.
Vad är skillnaden mellan mätpartiskhet och prediktiv partiskhet?
Mätpartiskhet innebär att ett test poängsätter olika mellan grupper trots lika underliggande kompetens. Prediktiv partiskhet innebär att poängen förutsäger arbetsprestation olika per grupp. SIOP behandlar dessa som separata, testbara frågor, inte som ett allmänt rättviseproblem.
Vilka kompetenstester är säkrast att bedöma med AI ensamt?
Strukturerade, objektivt poängsatta tester – kodningsutmaningar, standardiserade kunskapsquizzar och situationsbaserade omdömestester med definierade korrekta svar – är den säkraste passformen för enbart AI-bedömning. Öppna skriftliga svar och interpersonella rollbedömningar gynnas fortfarande av mänsklig granskning.