
HR-opas tekoälyn ja ihmisen arviointiin: 30–90 päivän pilotti ja 4 TEVV-vaihetta
Tekoälypohjainen arviointi toimii hyvin rakenteellisissa, roolikohtaisissa taitotesteissä: se pisteyttää nopeammin kuin ihminen ja päätyy lähelle samoja keskiarvopisteitä. Sitä ei kuitenkaan pidä käyttää yksinään korkean panoksen tai tulkinnanvaraisten päätösten tekemiseen. SIOP:n ja NIST:n TEVV-testauskehykset ovat olemassa hyvästä syystä, ja Talent Approvedin kaltaiset alustat on rakennettu yhdistämään tekoälypisteitys ihmisen suorittamaan tarkistukseen – ei korvaamaan sitä kokonaan.
TL;DR:
- Tekoälypisteitys on luotettavinta rakenteellisissa arvioinneissa, kuten koodaustesteissä ja standardoiduissa tietoviseissä, joissa on selkeät oikeat tai väärät vastaukset.
- Hybridimalli, jossa tekoäly hoitaa alkuseulonnan ja ihminen tarkistaa vivahteikkaat tai tulkinnanvaraiset tehtävät, tarjoaa parhaan tasapainon nopeuden ja tarkkuuden välillä.
- Sekä tekoäly- että ihmisarvioijat osoittavat epäjohdonmukaisuuksia pisteyttäessään identtisiä suorituksia, mikä korostaa validoinnin ja jatkuvan seurannan tarvetta.
- Vinoumien riskeihin kuuluvat mittausvinoutuma ja ennustavuusvinoutuma, joita voidaan lieventää perusteellisella testauksella, läpinäkyvyydellä ja osallistavalla arviointikriteeristön suunnittelulla.
- Pienten pilottiohjelmien toteuttaminen ja arviointipisteiden vertaaminen todelliseen työssä suoriutumiseen auttaa varmistamaan, että tekoälytyökalut ovat ennustavia ja oikeudenmukaisia rekrytoinnissa.
Sisällysluettelo
- Miten tekoäly- ja ihmisarviointi toimivat rekrytoinnissa
- Vahvuudet ja rajoitukset: tarkkuus, nopeus, johdonmukaisuus ja vinoumat
- Validointi, testaus ja hallinto, jotka HR-tiimien on toteutettava
- Käyttöönoton tarkistuslista: päätössäännöt ja mittarit
- Tekoälypisteityksen vaikutus ehdokkaille annettavan palautteen laatuun
- Paperitesteistä tekoälypisteytykseen: lyhyt historia
- Tekoäly- ja ihmisarviointiin liittyvät eettiset näkökohdat
- Miksi tekoälypisteityksen tuloksia on vaikeampi tulkita
- Tekoälypisteitys eri rooleissa ja osaamistyypeissä
- Käytännöllinen tie ihmis- ja tekoälypisteityksen yhteistyöhön
- Valmis pilotoimaan tekoälyavusteista pisteytystä? Aloita tästä
- Lähteet
- UKK
Miten tekoäly- ja ihmisarviointi toimivat rekrytoinnissa
Tekoälypohjaiset arviointityökalut pisteyttävät ehdokkaiden suorituksia arviointikriteeristöä vasten, joka on rakennettu koulutusmerkintöjen, jäsenneltyjen kriteerien tai järjestelmään syötetyn toimenkuvauksen pohjalta. Jotkin tekoälyarviointialustat tarjoavat ominaisuuksia, joiden avulla voidaan rakentaa roolikohtaisia arviointeja ja pisteytysjärjestelmiä toimenkuvauksista muutamassa minuutissa, minkä jälkeen ne tuottavat yhteenvedot kunkin ehdokkaan suorituksesta niin, että rekrytoijat voivat tarkastella tuloksia lukematta jokaista suoritusta rivi riviltä. Etuna on läpäisyteho: tällainen järjestelmä voi pisteyttää satoja koodinäytteitä tai kirjallisia vastauksia siinä ajassa, kun yksittäinen aiheen asiantuntija tarkastelee kourallisen suorituksia.
Ihmisarviointi toimii toisin. Aiheen asiantuntija soveltaa arviointikriteeristöä käyttäen harkintaa, kontekstia ja kokemusta, mikä on arvokasta vivahteikkuuden kannalta, mutta kallista skaalata. Kaksi asiaa hidastaa sitä aina: kustannus ehdokasta kohti ja arvioijien välinen vaihtelevuus – kaksi pätevää arvioijaa voi pisteyttää saman vastauksen eri tavoin mielialasta, väsymyksestä tai kriteeristön tulkinnasta riippuen.
Useimmat työnantajat päätyvät hybridimalliin valitsematta puolta. Yleisiä malleja ovat:
- Tekoäly ensin, ihmisen pistokoetyyppiset tarkistukset: tekoäly pisteyttää jokaisen suorituksen, ja rekrytoija tarkastelee otosta tai rajatapauksia.
- Ihminen ensin monimutkaisissa tehtävissä: avoimet tai harkintaa vaativat tehtävät ohjataan suoraan ihmiselle, kun taas jäsennellyt tehtävät (koodaustestit, matematiikan tehtävät, monivalintalogiikka) menevät tekoälylle.
- Mekaaninen synteesi: ihmisarvioijien ja algoritmisten pisteiden yhdistäminen yhdeksi yhteiseksi tulokseksi – menetelmä, jonka on osoitettu säilyttävän ennustavan tarkkuuden samalla kun se parantaa rekrytointipäälliköiden hyväksyntää, kun prosessissa halutaan ihmisen tarkistus.
Vahvuudet ja rajoitukset: tarkkuus, nopeus, johdonmukaisuus ja vinoumat
Vertaisarvioitu vertailu tekoälyarvioinnin ja ihmisasiantuntijoiden välillä IT-rekrytoinnissa ei löytänyt merkittävää eroa keskiarvopisteissä kummankaan välillä. Tekoäly pisteyttää huomattavasti nopeammin, mutta tutkimus paljasti myös jotain vähemmän mairittelevaa molemmille osapuolille: kumpikaan ei ollut täysin johdonmukainen. Tekoäly tuotti vaihtelevia pisteitä pyydettäessä pisteyttämään sama suoritus uudelleen, ja ihmisarvioijat osoittivat samaa arvioijien välistä epäluotettavuutta, joka on dokumentoitu rekrytointitutkimuksessa vuosikymmenten ajan.
Missä kukin lähestymistapa yleensä voittaa:
- Tekoäly voittaa raakassa nopeudessa ja johdonmukaisuudessa suurissa ehdokasryhmissä, kun tehtävä on jäsennelty (koodaustestit, standardoidut tehtäväpaketit).
- Ihmiset voittavat kontekstin osalta: epätavanomaisen mutta pätevän vastauksen tunnistaminen, mukautusten soveltaminen tai sellaisen ehdokkaan havaitseminen, joka ratkaisi ongelman eri mutta yhtä oikealla tavalla.
- Kumpikaan ei voita selkeästi toistettavuuden osalta. Sekä tekoäly- että ihmisarvioijat voivat tuottaa erilaisia pisteitä samasta työstä toisella arviointikerralla.
Johdonmukaisuustarkistus: sama tutkimus, joka havaitsi tekoälyn vastaavan ihmisen keskiarvopisteitä, havaitsi myös, että sekä tekoäly- että ihmisarviointi osoittivat mitattavaa epäjohdonmukaisuutta identtisten suoritusten toistuvassa arvioinnissa – minkä vuoksi yksittäinen arviointikierros kummaltakaan taholta on riskialtis perusta lopulliselle rekrytointipäätökselle.
Vinoumat ansaitsevat oman erittelyn, koska "vinoutunut" -termiä käytetään löyhästi. SIOP erottaa sen kahteen erilliseen, testattavaan käsitteeseen: mittausvinoutuma, jossa testi toimii eri tavoin eri ryhmissä yhtäläisestä pohjataidosta huolimatta, ja ennustavan vinoutuman, jossa testin tulos ennustaa työssä suoriutumista eri tavoin eri ryhmien välillä. Näiden käsitteleminen yhtenä epämääräisenä ongelmana on tapa, jolla työnantajat jäävät todelliselta riskiltä sokeaksi. Yleinen epäonnistumistapa on kohdevuoto, jossa malli harjaantuu proxymuuttujaan, joka korreloi suojatun ominaisuuden kanssa eikä itse taidon kanssa. Vammaisten ehdokkaiden mukautusten puuttuminen on toinen: ilman ADA-näkökohtia rakennettu tekoälykriteeristö voi rangaista laillisesta vaihtoehtoisesta lähestymistavasta, jonka ihmisarvioija tunnistaisi välittömästi.
Validointi, testaus ja hallinto, jotka HR-tiimien on toteutettava
Tekoälypisteytyspohjaisen arviointityökalun käyttöönotto ilman testaussuunnitelmaa on tapa, jolla työnantajat päätyvät puolustamaan oikeusjuttua rekrytointipäätöksen sijaan. NIST:n TEVV-Athlon-lähestymistapa tarjoaa tälle käytännöllisen rakenteen, joka on rakennettu neljän vaiheen ympärille:
- Määrittele tavoitteet. Päätä tarkalleen, mitä arviointityökalun on mitattava ja miltä "hyvä suoritustaso" näyttää roolissa.
- Rakennevalidointi. Vahvista, että testi todella mittaa väittämäänsä taitoa eikä löyhästi liittyvää proxymuuttujaa.
- Käyttäjä- ja kenttätestaus. Aja työkalu oikeita ehdokassuorituksia vasten, mukaan lukien red team -yritykset löytää kohdat, joissa se hajoaa tai pisteyttää epäreilusti.
- Syntetisoi tulokset. Yhdistä kaikki dokumentoituun arvioon siitä, onko työkalu valmis live-käyttöön.
Tarkistuslista, joka kannattaa suorittaa ennen lanseerausta ja sen jälkeen säännöllisesti, tulisi sisältää rakenne- ja käytännön validointitarkistukset, haitallisten vaikutusten testaus demografisten ryhmien välillä, merkintälähteiden ja kriteeristön suunnittelun dokumentointi, riittävät otoskoot ennen johtopäätösten tekemistä sekä kiinteä seurantaaikataulu eikä kertaluonteinen tarkistus. Talent Approvedin sisäänrakennettu haitallisten vaikutusten testauksen ohjeistus opastaa tällaisen tarkistuksen tekemiseen ilman tilastoalan taustaa.
Eniten laiminlyöty vaihe on palautteen integrointi: ennakkoon kerättyjen pisteiden yhdistäminen siihen, mitä todella tapahtuu rekrytoinnin jälkeen. Arviointipisteiden vertaaminen pysyvyys- ja suoritustietoihin muuttaa seulontatestistä aidosti ennustavan välineen eikä suodattimen, jonka toivot toimivan.
Asiantuntijavinkki: Suorita ensimmäinen validointisyklisi roolissa, johon jo rekrytoit usein. Sinulla on tarpeeksi historiallisia suoritustietoja tarkistaaksesi, ennustiko arviointipiste todella jotain, sen sijaan että arvailisit.
Käyttöönoton tarkistuslista: päätössäännöt ja mittarit
Kaikki testit eivät kuulu samaan lokeroon. Toimiva päätössääntö näyttää tältä:
- Käytä pelkkää tekoälyä tai tekoälyä ensin jäsenneltyihin koodaustesteihin, standardoituihin tehtäväpaketteihin ja suurivolyymiseen alkuseulontaan.
- Vaadi ihmisen tarkistus tulkinnanvaraisiin vapaamuotoisiin vastauksiin, portfolioarviointiin ja kaikkiin loppuvaiheen päätöksiin, jotka vaikuttavat työtarjoukseen.
- Käytä oletuksena hybridipisteitystä aina, kun rooli on korkean panoksen mutta testimuoto on silti riittävän jäsennelty tekoälyn ensimmäistä kierrosta varten.
Kun säännöt on asetettu, seuraa niitä todellisilla mittareilla eikä mutu-tuntumalla:
- Arvioijien välinen yksimielisyys — Cohenin kappa kahden arvioijan vertailuissa tai Fleissin kappa useamman arvioijan tapauksessa, sovellettuna sekä tekoälyn ja ihmisen että ihmisen ja ihmisen vertailuihin.
- Alaryhmien pistejakaumat — säännöllisesti eriteltynä demografisen kategorian mukaan mittausvinoutuman havaitsemiseksi varhain.
- Ennustavuuden korrelaatiot — kuinka hyvin ennakkopisteet todella seuraavat rekrytoinnin jälkeistä suoritusta.
- Käsittelyaika ja virheprosentti — kuinka kauan pisteitys kestää ja kuinka usein tulokset tarvitsevat manuaalista korjausta.
Operatiiviset kontrollit ovat yhtä tärkeitä kuin itse mittarit: ilmoita ehdokkaille, kun osavaltion laki sitä vaatii, rakenna eskalointipolku poikkeaville pisteille, dokumentoi jokainen tarkastus vaatimustenmukaisuuden arviointia varten ja aseta kiinteä uudelleenkoulutuksen laukaisija sen sijaan, että odottaisit valitusta pakottamaan toimia. Talent Approvedin pikapisteytys on rakennettu tällaisen läpinäkyvän, tarkastettavan kriteeristön pohjalta.
Tekoälypisteityksen vaikutus ehdokkaille annettavan palautteen laatuun
Nopeampi arviointi muuttaa ehdokkaiden kokemusta, ei pelkästään sitä, mitä rekrytoijat näkevät. Ehdokas, joka suorittaa taitotestin ja saa tuloksen tunneissa kahden viikon sijaan, pysyy sitoutuneena prosessiisi sen sijaan, että hyväksyisi kilpailevan tarjouksen. Tekoälyn tuottamat yhteenvedot voivat antaa rekrytoijille luettavan erittelyn kunkin ehdokkaan vahvuuksista ja puutteista lähes välittömästi suorituksen jälkeen, mikä lyhentää arviointivaiheen ja seuraavien askelten välistä kuilua.
Palautteen laatu on kuitenkin eri kysymys kuin palautteen nopeus, ja juuri siinä tekoälyllä on edelleen todellisia rajoituksia. Tuotettu yhteenveto voi merkitä, että ehdokkaan koodi epäonnistui tietyissä testitapauksissa tai että kirjallinen vastaus jätti huomiotta kriteeristön avainkohtia. Sen sijaan on vaikea selittää "miksi" samalla tekstuurilla, jonka taitava ihmisarvioija tuo, erityisesti luovissa tai harkintaa vaativissa tehtävissä, joissa oikea vastaus ei ole yksiselitteinen.
Käytännön ratkaisu, johon useimmat hybridityönkulut päätyvät, on kerrostettu palaute: tekoäly tuottaa ensimmäisen kierroksen yhteenvedon välittömästi, ja rekrytoija tai rekrytointipäällikkö lisää kontekstin ennen kuin se tavoittaa ehdokkaan tai rekrytointikomitean. Tämä säilyttää automatisoidun pisteityksen nopeusedun menettämättä tulkinnallista vivahteikkuutta, jonka ihminen lisää. Se myös suojaa hienovaraisemmalta riskiltä: ehdokkaat, jotka luottavat tekoälyn yhteenvetoon auktoritatiivisempana kuin se todella on, yksinkertaisesti siksi, että se saapui nopeasti ja näyttää siistiltä.
Paperitesteistä tekoälypisteytykseen: lyhyt historia
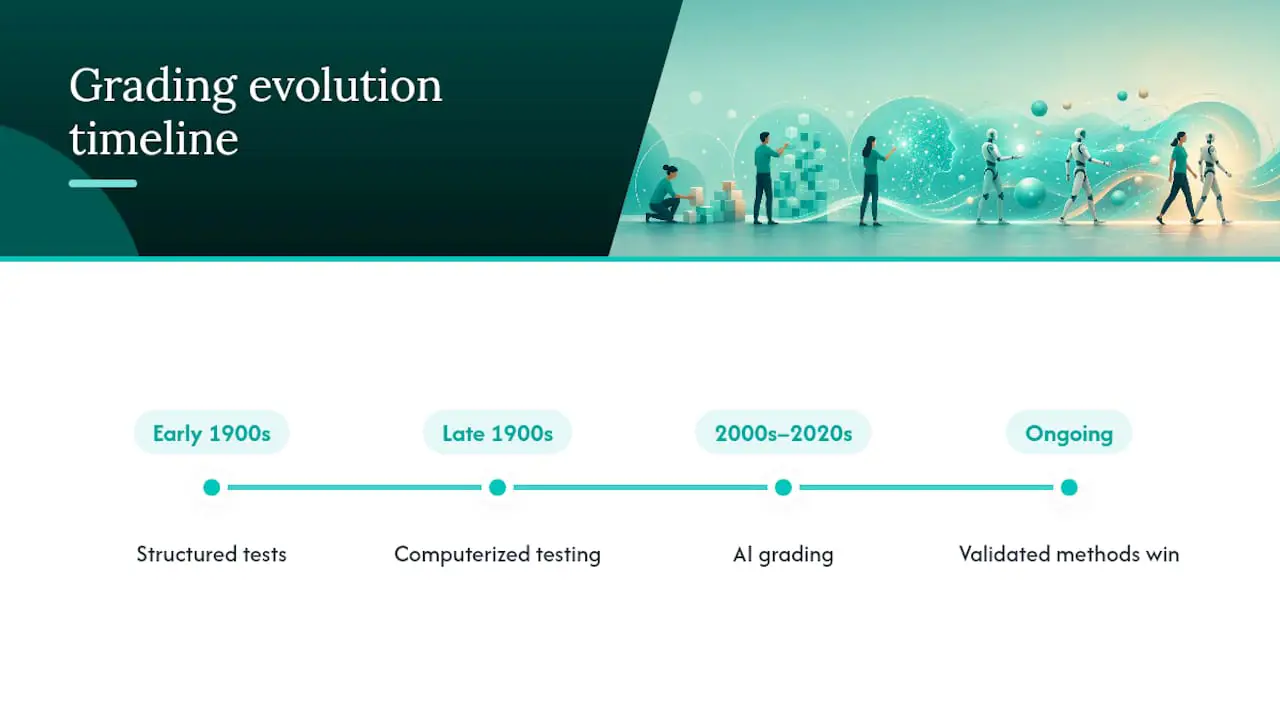
Ehdokkaiden arviointi ei alkanut ohjelmistoilla. Jäsennelty rekrytointiarviointi juontaa juurensa 1900-luvun alkupuolen henkilöstöpsykologiaan, jolloin työnantajat yrittivät ensimmäistä kertaa standardoida testejä vähentääkseen riippuvuutta mutu-tuntumasta ja henkilökohtaisista suosituksista. Vuosikymmenten tutkimus osoittaa johdonmukaisesti, että jäsennellyt, työnkuvaan liittyvät menetelmät – erityisesti työnäytteet ja jäsennellyt haastattelut – tuottavat vahvimman yhteyden todelliseen työssä suoriutumiseen, selvästi paremmin kuin jäsentämättömät haastattelut tai pelkkä ansioluettelon seulonta.
Seuraava suuri muutos tuli tietokoneistetun testauksen myötä 1900-luvun lopulla, mikä antoi työnantajille mahdollisuuden standardoida pisteitys ja vähentää arvioijien välistä epäjohdonmukaisuutta monivalinta- ja numeerisissa arvioinneissa. Avoimet tehtävät – kirjoitusnäytteet, koodiarvioinnit, skenaariovasteukset – tarvitsivat kuitenkin edelleen ihmisen lukemaan ja arvioimaan ne, mikä piti pisteityksen hitaana ja kalliina skaalata.
Tekoälypisteitys on seuraava askel samalla kehityspolulla – ei poikkeama siitä. Se, mikä muuttui, on kyky soveltaa johdonmukaista kriteeristöä jäsentämättömiin vastauksiin (kirjalliset vastaukset, koodi, jopa video) nopeudella, jota mikään ihmispaneeli ei voi saavuttaa. Tutkimus valintamenetelmien yhdistämisestä, joka on vuosikymmenia vanhempaa kuin nykyaikainen tekoäly, pitää edelleen perimmäisen opetuksen: validoidut, työnkuvaan liittyvät testit voittavat epävirallisen arvioinnin, oli arvioijana sitten ihminen tai malli. Tekoäly ei keksinyt tätä periaatetta. Se teki sen soveltamisesta käytännössä mahdollista laajassa mittakaavassa.
Tekoäly- ja ihmisarviointiin liittyvät eettiset näkökohdat
Tekoälypisteityksen eettiset kysymykset eivät todellakaan koske sitä, "ymmärtääkö" kone oikeudenmukaisuuden. Ne koskevat sitä, rakensiko sen käyttöönottaneet ihmiset prosessiin riittävästi vastuullisuutta. Kolme asiaa nousee esiin toistuvasti.
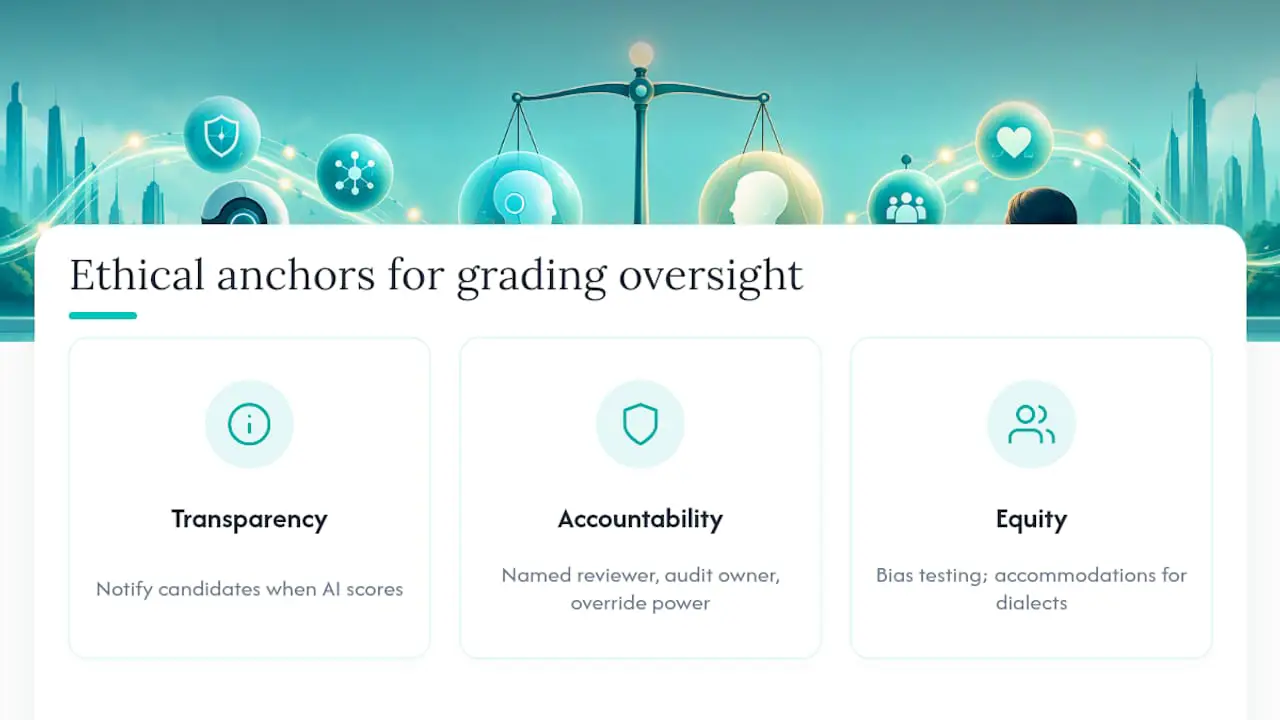
Läpinäkyvyys. Ehdokkailla on oikeus tietää, kun tekoäly on mukana heidän työnsä pisteytyksessä, ja kasvava joukko osavaltiolakeja vaatii juuri tällaista ilmoitusta. Työnantajat, jotka piilottavat tämän pieneen painettuun tekstiin, luovat oikeudellista altistumista, ei vain eettistä ongelmaa.
Vastuullisuus virheistä. Kun ihmisarvioija tekee virheen, on henkilö, jolle voi eskalata. Kun tekoälyjärjestelmä pisteyttää väärin, vastuuketjun on oltava yhtä selvä: kuka tarkistaa poikkeamat, kuka omistaa tarkastuksen ja kenellä on valtuudet ohittaa pisteet.
Tasapuolisuus ehdokkaiden välillä. Pisteytysjärjestelmä, joka on koulutettu ilman huomiota mukautuksiin, kirjallisten vastausten murrehavaintoihin tai epäperinteisiin ongelmanratkaisutapoihin, voi hiljaa asettaa pätevät ehdokkaat epäedulliseen asemaan ilman, että kukaan huomaa sitä ennen kuin haitallisten vaikutusten tarkastus sen havaitsee. Ihmisarvioijilla on oma versionsa tästä riskistä tiedostamattoman vinoutuman kautta, mikä on juuri syy siihen, miksi SIOP käsittelee vinoutumatestausta teknisenä vaatimuksena kummallekin pisteytysmenetelmälle – ei kertaluonteisena eettisenä ruksiruututehtävänä.
Mikään tästä ei argumentoi tekoälyn käyttöä vastaan. Se argumentoi sen puolesta, että pisteytystä – tyypistä riippumatta – kohdellaan järjestelmänä, joka tarvitsee valvontaa, ei työkaluna, jonka voi ottaa käyttöön ja unohtaa.
Miksi tekoälypisteityksen tuloksia on vaikeampi tulkita
Ihmisarvioija voi yleensä selittää pisteen yhdellä lauseella: "ehdokkaan ratkaisu toimi, mutta käytti tehotonta lähestymistapaa." Tekoälyn tuottamaa pistettä on usein vaikeampi purkaa, erityisesti kun taustalla oleva malli painottaa kymmeniä signaaleja, joita rekrytoija ei näe suoraan.
Tämä luo erityisen tulkintaongelman: pistettä ilman selkeää perustetta on vaikea puolustaa, jos ehdokas kyseenalaistaa sen tai sääntelyviranomainen kysyy, miten päätös tehtiin. On myös vaikeampi tietää, heijastaako matala pisteet todellista osaamisvajetta vai ehdokkaan vastaustavan erikoisuutta.
Käytännöllinen vastaus ei ole epäillä jokaista tekoälypistettä. Se on vaatia selitettävyyttä perusominaisuutena, ei jälkiajatuksena. Hyödyllisen tekoälyn tuottaman yhteenvedon tulisi näyttää, mitkä erityiset kriteerit ehdokas täytti tai jätti täyttämättä – ei pelkästään yhtä yhdistelmälukua. Tämä yksityiskohtaisuus antaa rekrytoijalle mahdollisuuden ristiintarkistaa tekoälyn päättelytapa samalla tavoin kuin hän tarkistaisi ihmisarvioijan muistiinpanot, ja se muuttaa läpinäkymättömän pisteen joksikin, minkä taakse rekrytointipäällikkö voi todella asettua lopullisessa päätöksessä.
Tekoälypisteitys eri rooleissa ja osaamistyypeissä
Tekoälypisteitys ei ole yksi työkalu, jota sovelletaan tasaisesti kaikkialla. Se, kuinka hyvin se toimii, vaihtelee sen mukaan, mitä testataan.
Tekniset arvioinnit ja koodaustestit ovat se alue, jossa tekoälypisteitys toimii luotettavimmin. Testitapaukset joko läpäisevät tai epäonnistuvat, suoritusaika on mitattavissa ja koodilaatumetriikat voidaan pisteyttää selkeiden kriteerien mukaan – juuri se jäsennelty ympäristö, jonka IT-rekrytoinnin tutkimus mittasi havaitessaan tekoälyn vastaavan ihmisen keskiarvopisteitä huomattavasti nopeammin.
Jäsennellyt tietotestit – vaatimustenmukaisuustietovissit, kyvykkyystestit, tilanteenmukaiset arviointitestit, joilla on määritellyt oikeat vastaukset – ovat lähes yhtä hyvä sopivuus, koska pisteityslogiikka eroaa tuskin lainkaan hyvin rakennetusta monivalintakokeesta.
Kirjalliset vastaukset ja viestintätehtävät asettuvat keskivälille. Tekoäly voi merkitä kieliopin, rakenteen ja sen, käsittelikö vastaus kehotuksen, mutta sävyn, vakuuttavuuden tai luovan ongelmanratkaisun arvioiminen hyötyy edelleen ihmisen toisesta katseesta.
Myynti-, asiakaspalvelu- ja vuorovaikutusroolien tehtävät nojaavat toistaiseksi vahvasti ihmiseen. Nämä roolit riippuvat tunnevihjeiden lukemisesta ja kesken keskustelun tapahtuvasta sopeutumisesta – alue, jolla kriteeristö kamppailee kaapata sen, mikä todella ennustaa menestystä työssä.
Talent Approvedin roolikohtaisen testauksen suunnitteluohjeistus on rakennettu arviointimuodon sovittamisen ympärille testattavaan taitoon, mikä on todellinen vipuvarsi päättäessä, kuinka paljon painoa tekoälypisteitykselle asetetaan missä tahansa roolissa.
Käytännöllinen tie ihmis- ja tekoälypisteityksen yhteistyöhön
Ohita kaikki tai ei mitään -väittely. Suorita pilotti yhdelle roolille, yhdistä tekoälypisteet ihmisen arviointiin mekaanisen synteesin kautta valitsematta puolta, ja tarkasta pieni otos ennen skaalaamista mihinkään korkean panoksen tilanteeseen. Alustan ominaisuudet, jotka tukevat tätä – jäsennelty kriteeristön luominen, huijaamisen esto, tekoälyn tuottamat yhteenvedot – ovat olemassa ihmisen tarkistusvaiheen nopeuttamiseksi, eivät sen korvaamiseksi. Seuraa rekrytoinnin jälkeistä suoritusta suhteessa ennakkopisteisiin ja muokkaa kriteeristöä, kun data niin kertoo – ei ennen sitä.
— Jimmie
Valmis pilotoimaan tekoälyavusteista pisteytystä? Aloita tästä
Talent Approved on rakennettu juuri tämän artikkelin suosittelemalle hybridimallille: tekoäly tekee raskaan pisteitystyön ja sinä pidät lopullisen päätösvallan. Magic Create muuttaa toimenkuvauksen roolikohtaiseksi arvioinniksi minuuteissa, sisäänrakennettu huijaamisen esto (näyttö- ja web-kameratarkistukset, istuntojen toistot) suojaa pisteitettävän materiaalin eheyttä, ja tekoälyn tuottamat yhteenvedot antavat sinulle luettavan erittelyn ehdokaskohtaisesti pelkän raakaluvun sijaan. Hinnoittelu perustuu maksa käytön mukaan -malliin 5 dollaria per suoritettu ehdokasarviointi, ilman tilausta.
Jos olet valmis testaamaan tätä asianmukaisesti, suorita 30–90 päivän pilotti: valitse yksi rooli, luo arviointi Magic Creatella, pisteytä jokainen suoritus sekä tekoälyn yhteenvedon että ihmisarvioijan avulla rinnakkain, suorita haitallisten vaikutusten tarkistus tuloksille ja vertaa pilottipalkkauksia suoritustietoihin, kun he ovat töissä. Tarkista hinnoittelusivulta pilotin laajuus ennen kuin sitoudut täyteen käyttöönottoon.
Lähteet
Ennen tekoälypisteityksen laajamittaista käyttöönottoa tutustu SIOP:n validointiohjeistukseen, NIST:n TEVV-Athlon-kehykseen ja IT-rekrytointitutkimukseen, joka vertailee tekoäly- ja ihmisarviointia. Kehittyvien oikeudellisten velvoitteiden osalta K&L Gatesin yhteenveto muuttuvasta liittovaltion ohjeistuksesta kannattaa lukea.
- ChatGPT vs. ihmisasiantuntemus IT-rekrytoinnin kontekstissa
- Näkökohtia ja suosituksia tekoälypohjaisten arviointien validoinnista ja käytöstä henkilöstövalinnassa (SIOP)
- NIST ARIA 0.1 -pilottiraportti
- Valintamenetelmien validiteetti ja hyödyllisyys henkilöstöpsykologiassa
UKK
Voiko tekoäly korvata ihmisarvioijat kokonaan?
Ei. IT-rekrytoinnissa tekoäly- ja ihmisarviointia vertaileva tutkimus löysi samankaltaisen keskimääräisen tarkkuuden mutta nopeamman tekoälyn, samalla kun molemmat osoittivat epäjohdonmukaisuutta toistuvassa pisteytyksessä. Ihmisen tarkistus on edelleen tärkeää tulkinnanvaraisissa tehtävissä ja loppuvaiheen päätöksissä.
Onko tekoälypisteitys oikeudellisesti puolustettavissa rekrytointipäätöksissä?
Se voi olla, jos validoit työkalun ja dokumentoit prosessin. SIOP suosittelee virallista psykometrista validointia, ja useat osavaltiot vaativat nyt ehdokkaalle ilmoittamista tai suostumusta, kun tekoälyä käytetään pisteytyksessä.
Paljonko Talent Approved maksaa?
Talent Approved veloittaa 5 dollaria per suoritettu ehdokasarviointi maksa käytön mukaan -periaatteella, ilman tilausta.
Mikä on ero mittausvinoutuman ja ennustavan vinoutuman välillä?
Mittausvinoutuma tarkoittaa, että testi pisteyttää eri tavoin eri ryhmissä yhtäläisestä pohjataidosta huolimatta. Ennustava vinoutuma tarkoittaa, että pisteet ennustavat työssä suoriutumista eri tavoin ryhmästä riippuen. SIOP käsittelee näitä erillisinä, testattavina kysymyksinä – ei yhtenä yleisenä oikeudenmukaisuusongelmana.
Mitkä taitotestit on turvallisinta pisteyttää pelkästään tekoälyllä?
Jäsennellyt, objektiivisesti pisteytettävät testit – koodaushaasteet, standardoidut tietovissit ja tilanteenmukaiset arviointitestit, joilla on määritellyt oikeat vastaukset – sopivat parhaiten pelkkään tekoälypisteytykseen. Avoimet kirjalliset vastaukset ja vuorovaikutusroolien arvioinnit hyötyvät edelleen ihmisen tarkistuksesta.
Suositellut
- Rakenna arviointipisteytyskriteeristöjä, joita opettajat voivat pilotoida ja skaalata tekoälyllä
- Yhdysvaltain HR-käsikirja haitallisten vaikutusten testaukseen: suorita, lue, korjaa
- Talent Approved 5 dollarin pilotti: ehdokkaiden vertailupisteet HR:lle
- Tekoälyn rooli massaehdokasseulonnassa: 2026-opas