
Guía de RRHH para Calificación con IA vs Humanos: Piloto de 30–90 Días + 4 Pasos TEVV
La calificación por IA funciona bien en pruebas de habilidades estructuradas y específicas para cada puesto: puntúa más rápido que una persona y obtiene promedios muy similares. No debería actuar de forma autónoma en decisiones de alto riesgo o ambiguas. Los marcos de SIOP y el enfoque de pruebas TEVV de NIST existen por una razón, y plataformas como Talent Approved están diseñadas para combinar la puntuación de IA con la revisión humana, no para reemplazarla por completo.
Resumen rápido:
- La calificación por IA es más fiable en evaluaciones estructuradas como pruebas de programación y cuestionarios de conocimiento estandarizados, donde existen respuestas claramente correctas o incorrectas.
- Un modelo híbrido con IA en la selección inicial y revisión humana para tareas complejas o ambiguas ofrece el mejor equilibrio entre velocidad y precisión.
- Tanto los evaluadores de IA como los humanos muestran inconsistencias al puntuar envíos idénticos, lo que subraya la necesidad de validación y seguimiento continuo.
- Los riesgos de sesgo incluyen el sesgo de medición y el sesgo predictivo, que pueden mitigarse mediante pruebas exhaustivas, transparencia y un diseño de rúbricas inclusivo.
- Ejecutar programas piloto reducidos y comparar las puntuaciones de las evaluaciones con el desempeño real en el puesto ayuda a garantizar que las herramientas de IA sean predictivas y justas en los procesos de selección.
Tabla de Contenidos
- Cómo funcionan la calificación por IA y la calificación humana en los procesos de selección
- Fortalezas y limitaciones: precisión, velocidad, consistencia y sesgo
- Validación, pruebas y gobernanza que los equipos de RR. HH. deben llevar a cabo
- Lista de verificación de implementación: reglas de decisión y métricas
- Impacto de la calificación por IA en la calidad de la retroalimentación para los candidatos
- De las pruebas en papel a la puntuación por IA: una breve historia
- Consideraciones éticas específicas sobre la calificación por IA frente a la calificación humana
- Por qué los resultados de la calificación por IA son más difíciles de interpretar
- La calificación por IA en diferentes roles y tipos de habilidades
- Un camino pragmático para que la calificación humana y la de IA trabajen juntas
- ¿Listo para probar la calificación asistida por IA? Empieza aquí
- Fuentes
- Preguntas frecuentes
Cómo funcionan la calificación por IA y la calificación humana en los procesos de selección
Las herramientas de calificación por IA puntúan el trabajo de los candidatos según una rúbrica construida a partir de etiquetas de entrenamiento, criterios estructurados o una descripción del puesto introducida en el sistema. Algunas plataformas de evaluación con IA ofrecen funciones que permiten crear evaluaciones y estructuras de puntuación específicas para cada puesto a partir de descripciones de empleo en cuestión de minutos, y luego generan resúmenes del rendimiento de cada candidato para que los reclutadores puedan revisar los resultados sin leer cada envío línea por línea. La ventaja es la capacidad de procesamiento: un sistema así puede calificar cientos de muestras de código o respuestas escritas en el tiempo que un único experto en la materia tarda en revisar un puñado.
La calificación humana funciona de manera diferente. Un experto en la materia aplica una rúbrica utilizando juicio, contexto y experiencia, lo que resulta valioso para captar matices, pero es costoso de escalar. Dos factores la ralentizan cada vez: el coste por candidato y la variabilidad entre evaluadores, es decir, que dos revisores cualificados pueden puntuar la misma respuesta de forma diferente según su estado de ánimo, el cansancio o la interpretación de la rúbrica.
La mayoría de los empleadores optan por un modelo híbrido en lugar de decantarse por un único enfoque. Los patrones más comunes incluyen:
- IA primero con verificaciones humanas: la IA califica cada envío y un reclutador revisa una muestra o cualquier puntuación en el límite.
- Humano primero para tareas complejas: las preguntas abiertas o que requieren mucho juicio van directamente a una persona, mientras que las tareas estructuradas (pruebas de programación, problemas matemáticos, lógica de opción múltiple) las gestiona la IA.
- Síntesis mecánica: las valoraciones de los evaluadores humanos y las puntuaciones algorítmicas se combinan en un único resultado, un método que se ha demostrado que preserva la precisión predictiva y mejora la aceptación por parte de los responsables de contratación que desean una supervisión humana del proceso.
Fortalezas y limitaciones: precisión, velocidad, consistencia y sesgo
Una comparación revisada por pares entre la calificación por IA y expertos humanos en el ámbito de la selección de personal de TI no encontró diferencias significativas en las puntuaciones medias entre ambos. La IA calificó mucho más rápido, pero el estudio también reveló algo menos favorecedor para ambos: ninguno fue completamente consistente. La IA produjo puntuaciones variables al volver a calificar el mismo envío, y los revisores humanos mostraron la misma falta de fiabilidad entre evaluadores que se ha documentado en la investigación sobre selección de personal durante décadas.
Dónde tiende a ganar cada enfoque:
- La IA gana en velocidad bruta y consistencia en grandes grupos de candidatos cuando la tarea es estructurada (pruebas de código, conjuntos de problemas estandarizados).
- Los humanos ganan en contexto: reconocer una respuesta poco convencional pero válida, aplicar adaptaciones o detectar que un candidato resolvió el problema de una manera diferente pero igualmente correcta.
- Ninguno gana de forma clara en repetibilidad. Tanto los evaluadores de IA como los humanos pueden producir puntuaciones diferentes para el mismo trabajo en una segunda revisión.
Verificación de consistencia: el mismo estudio que encontró que la IA igualaba las puntuaciones medias humanas también halló que tanto la calificación por IA como la humana mostraban inconsistencias medibles al evaluar repetidamente envíos idénticos, razón por la cual una única ronda de calificación de cualquiera de las dos fuentes es una base arriesgada para una decisión final de contratación.
El sesgo merece su propio análisis, porque «sesgado» se usa de forma imprecisa. SIOP lo separa en dos conceptos distintos y verificables: el sesgo de medición, donde una prueba funciona de manera diferente para distintos grupos a pesar de una habilidad subyacente igual, y el sesgo predictivo, donde la puntuación de una prueba predice el desempeño laboral de forma diferente entre grupos. Tratar estos como un único problema vago es cómo los empleadores pasan por alto riesgos reales. Un modo de fallo habitual es la fuga de objetivo, donde un modelo se entrena con una variable proxy que correlaciona con una característica protegida en lugar de la habilidad en sí misma. La falta de adaptaciones para candidatos con discapacidades es otro ejemplo: una rúbrica de IA creada sin tener en cuenta la ADA puede penalizar un enfoque alternativo legítimo que un revisor humano reconocería de inmediato.
Validación, pruebas y gobernanza que los equipos de RR. HH. deben llevar a cabo
Implementar una herramienta de calificación por IA sin un plan de pruebas es la manera en que los empleadores acaban defendiendo una demanda en lugar de una decisión de contratación. El enfoque TEVV-Athlon de NIST ofrece una estructura práctica para esto, construida en torno a cuatro etapas:
- Definir objetivos. Decidir exactamente qué debe medir la herramienta de calificación y cómo se ve un «buen rendimiento» para el puesto.
- Validación de construcción. Confirmar que la prueba mide realmente la habilidad que dice medir y no un proxy relacionado de forma vaga.
- Pruebas de usuario y de campo. Ejecutar la herramienta con envíos reales de candidatos, incluidos intentos de red-teaming para encontrar dónde falla o puntúa de forma injusta.
- Síntesis de resultados. Combinar todo en un juicio documentado sobre si la herramienta está lista para su uso en vivo.
Una lista de verificación de auditoría que vale la pena ejecutar antes del lanzamiento y de forma periódica después debería incluir verificaciones de validez de construcción y práctica, pruebas de impacto adverso entre grupos demográficos, documentación de las fuentes de etiquetas y el diseño de la rúbrica, tamaños de muestra adecuados antes de extraer conclusiones y un calendario de seguimiento fijo en lugar de una revisión puntual. La guía de pruebas de impacto adverso integrada en Talent Approved explica cómo llevar a cabo este tipo de verificación sin necesidad de conocimientos estadísticos.
El paso más ignorado es la integración de la retroalimentación: conectar las puntuaciones previas a la contratación con lo que ocurre realmente después de la misma. Comparar las puntuaciones de las evaluaciones con los datos de retención y rendimiento convierte una prueba de selección en un instrumento genuinamente predictivo, en lugar de un filtro del que simplemente se espera que funcione.
Consejo profesional: Ejecuta tu primer ciclo de validación en un puesto para el que ya contratas con frecuencia. Tendrás suficientes datos de rendimiento histórico para verificar si la puntuación de la evaluación realmente predijo algo, en lugar de suponerlo.
Lista de verificación de implementación: reglas de decisión y métricas
No toda prueba pertenece al mismo grupo. Una regla de decisión funcional tiene este aspecto:
- Usa la calificación solo por IA o con IA primero para pruebas de programación estructuradas, conjuntos de problemas estandarizados y selección inicial de alto volumen.
- Exige revisión humana para respuestas de texto libre ambiguas, evaluación de portafolios y cualquier decisión en fase final que afecte a una oferta.
- Opta por defecto por la puntuación híbrida siempre que el puesto sea de alto riesgo pero el formato de la prueba sea lo suficientemente estructurado para que la IA gestione una primera revisión.
Una vez establecidas las reglas, fíjate en ellas con métricas reales en lugar de intuición:
- Acuerdo entre evaluadores: kappa de Cohen para comparaciones entre dos evaluadores, o kappa de Fleiss cuando intervienen más evaluadores, aplicado tanto a comparaciones IA-versus-humano como humano-versus-humano.
- Distribuciones de puntuaciones por subgrupos: desglosadas regularmente por categoría demográfica para detectar el sesgo de medición de forma temprana.
- Correlaciones de validez predictiva: en qué medida las puntuaciones previas a la contratación reflejan realmente el rendimiento posterior a la misma.
- Tiempo de procesamiento y tasa de errores: cuánto tiempo tarda la calificación y con qué frecuencia los resultados requieren corrección manual.
Los controles operativos importan tanto como las métricas en sí mismas: notifica a los candidatos donde la ley estatal lo exija, crea una vía de escalada para puntuaciones atípicas, documenta cada auditoría para revisión de cumplimiento y establece un disparador de reentrenamiento fijo en lugar de esperar a que una queja fuerce el asunto. La puntuación de evaluación instantánea de Talent Approved está diseñada con este tipo de rúbrica transparente y auditable en mente.
Impacto de la calificación por IA en la calidad de la retroalimentación para los candidatos
La calificación más rápida cambia la experiencia de los candidatos, no solo lo que ven los reclutadores. Un candidato que termina una prueba de habilidades y recibe un resultado en horas en lugar de dos semanas permanece comprometido con tu proceso en lugar de aceptar una oferta de la competencia. Los resúmenes generados por IA pueden ofrecer a los reclutadores un desglose legible de las fortalezas y debilidades de cada candidato casi de inmediato después del envío, lo que acorta el intervalo entre la evaluación y los siguientes pasos.
La calidad de la retroalimentación es una cuestión diferente a la velocidad de la retroalimentación, sin embargo, y es donde la IA todavía tiene limitaciones reales. Un resumen generado puede señalar que el código de un candidato no superó ciertos casos de prueba o que una respuesta escrita omitió criterios clave de la rúbrica. Pero le cuesta explicar el «por qué» con la misma profundidad que aporta un revisor humano cualificado, especialmente en tareas creativas o que requieren juicio donde la respuesta correcta no es única.
La solución práctica en la que aterrizan la mayoría de los flujos de trabajo híbridos es la retroalimentación por capas: la IA genera el resumen de primera pasada de inmediato, y un reclutador o responsable de contratación añade contexto antes de que llegue al candidato o al comité de contratación. Esto mantiene la ventaja de velocidad de la calificación automatizada sin perder el matiz interpretativo que aporta una persona. También protege contra un riesgo más sutil: que los candidatos confíen en un resumen de IA como más autoritario de lo que realmente es, simplemente porque llegó rápido y tiene una apariencia ordenada.
De las pruebas en papel a la puntuación por IA: una breve historia
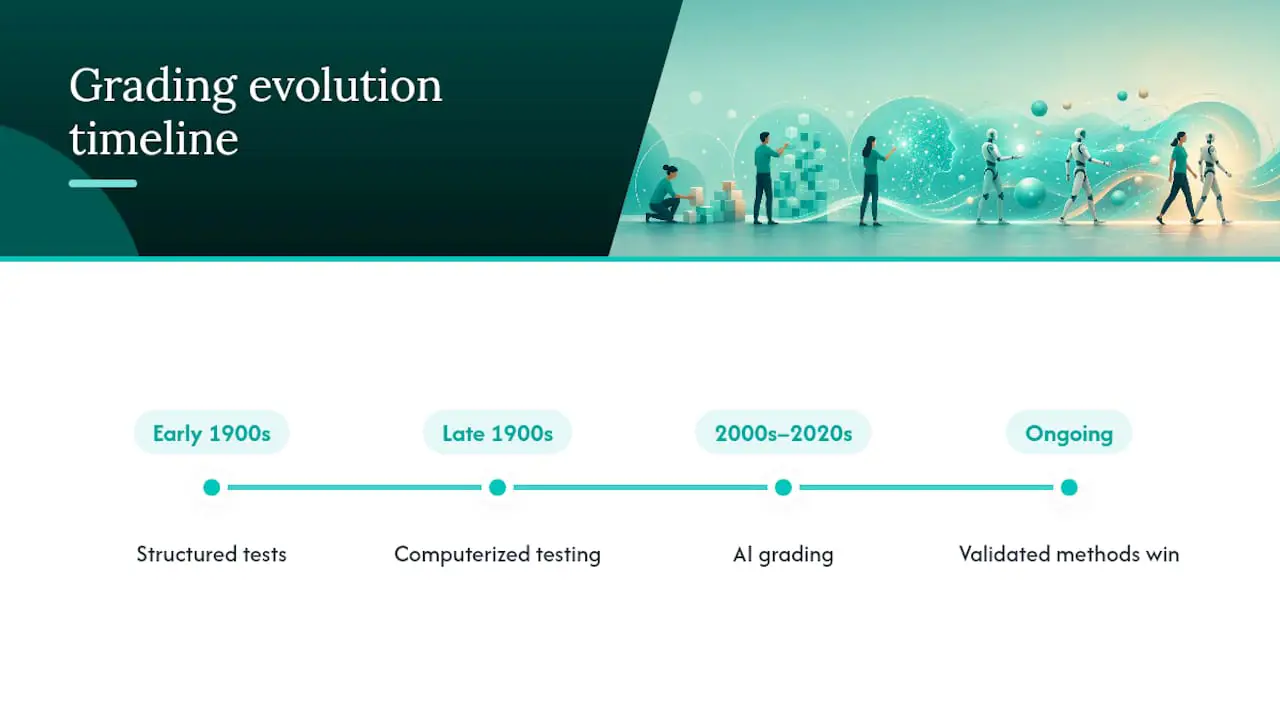
La calificación de candidatos no comenzó con el software. La evaluación estructurada en los procesos de selección se remonta a la psicología del personal de principios del siglo XX, cuando los empleadores comenzaron a estandarizar las pruebas para reducir la dependencia del instinto y las referencias personales. Décadas de investigación desde entonces demuestran de forma consistente que los métodos estructurados y relevantes para el puesto, especialmente las muestras de trabajo y las entrevistas estructuradas, producen el vínculo más sólido con el desempeño laboral real, superando con creces las entrevistas no estructuradas o la selección de currículum por sí sola.
El siguiente gran cambio llegó con las pruebas informatizadas a finales del siglo XX, que permitieron a los empleadores estandarizar la puntuación y reducir parte de la inconsistencia entre evaluadores en las evaluaciones de opción múltiple y numéricas. Pero las tareas abiertas (muestras de escritura, revisión de código, respuestas a escenarios) seguían necesitando que una persona las leyera y juzgara, lo que mantuvo la calificación lenta y costosa a escala.
La calificación por IA es el siguiente paso en esa misma trayectoria, no una ruptura con ella. Lo que cambió es la capacidad de aplicar una rúbrica consistente a respuestas no estructuradas (respuestas escritas, código, incluso vídeo) a una velocidad que ningún panel humano puede igualar. La investigación sobre la combinación de métodos de selección que precede a la IA moderna en décadas todavía mantiene la lección subyacente: las pruebas validadas y relevantes para el puesto superan al juicio informal, ya sea el evaluador una persona o un modelo. La IA no inventó ese principio. Simplemente hizo que su aplicación a escala fuera finalmente práctica.
Consideraciones éticas específicas sobre la calificación por IA frente a la calificación humana
Las cuestiones éticas en torno a la calificación por IA no se refieren realmente a si una máquina «entiende» la equidad. Se refieren a si los humanos que la implementan incorporaron suficiente responsabilidad en el proceso. Tres problemas surgen repetidamente.
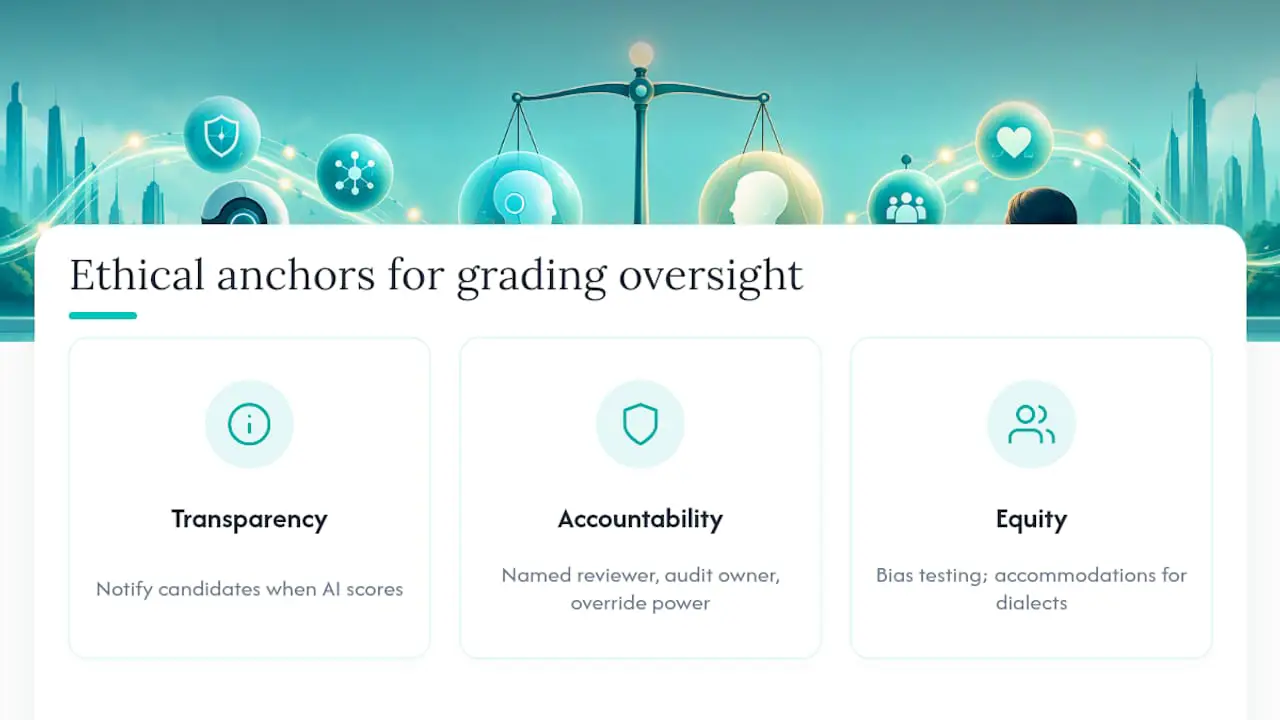
Transparencia. Los candidatos merecen saber cuándo la IA interviene en la puntuación de su trabajo, y un número creciente de leyes estatales exige exactamente ese tipo de aviso. Los empleadores que entierran esto en la letra pequeña están creando exposición legal, no solo un problema ético.
Responsabilidad por errores. Cuando un evaluador humano comete un error, hay una persona a quien escalar el asunto. Cuando un sistema de IA califica incorrectamente una respuesta, la cadena de responsabilidad debe ser igualmente clara: quién revisa los casos atípicos, quién es propietario de la auditoría y quién tiene autoridad para anular una puntuación.
Equidad entre candidatos. Un sistema de calificación entrenado sin atención a las adaptaciones, la variación dialectal en las respuestas escritas o los enfoques no convencionales de resolución de problemas puede perjudicar silenciosamente a candidatos cualificados sin que nadie lo note hasta que una auditoría de impacto adverso lo detecte. Los evaluadores humanos llevan su propia versión de este riesgo a través del sesgo inconsciente, que es exactamente por qué SIOP trata las pruebas de sesgo como un requisito técnico para cualquiera de los métodos de calificación, no como una casilla ética puntual.
Nada de esto argumenta en contra del uso de la IA. Argumenta a favor de tratar la calificación, de cualquier tipo, como un sistema que necesita supervisión, no como una herramienta que se implementa y se olvida.
Por qué los resultados de la calificación por IA son más difíciles de interpretar
Un evaluador humano generalmente puede explicar una puntuación en una frase: «la solución del candidato funcionó, pero empleó un enfoque ineficiente». Una puntuación generada por IA es a menudo más difícil de descomponer, especialmente cuando el modelo subyacente pondera docenas de señales que el reclutador nunca ve directamente.
Esto crea un problema de interpretación específico: una puntuación sin una justificación clara es difícil de defender si un candidato la impugna o un regulador pregunta cómo se tomó una decisión. También es más difícil saber si una puntuación baja refleja una brecha de habilidad genuina o una peculiaridad en la forma en que el candidato redactó una respuesta.
La respuesta práctica no es desconfiar de cada puntuación de IA. Es exigir la explicabilidad como característica básica, no como un añadido posterior. Un resumen útil generado por IA debe mostrar qué criterios específicos cumplió o no cumplió un candidato, no solo un único número compuesto. Ese nivel de detalle permite a un reclutador verificar el razonamiento de la IA del mismo modo que comprobaría las notas de un revisor humano, y convierte una puntuación opaca en algo que un responsable de contratación puede respaldar de verdad en una decisión final.
La calificación por IA en diferentes roles y tipos de habilidades
La calificación por IA no es una única herramienta aplicada de forma uniforme. Su eficacia varía según lo que se esté evaluando.
Las evaluaciones técnicas y de programación son donde la calificación por IA funciona de manera más fiable. Los casos de prueba pasan o fallan, el tiempo de ejecución es medible y las métricas de calidad del código pueden puntuarse con criterios claros, que es exactamente el entorno estructurado que el estudio de selección de personal de TI midió cuando encontró que la IA igualaba las puntuaciones medias humanas a una velocidad mucho mayor.
Las pruebas de conocimiento estructurado, cuestionarios de cumplimiento, pruebas de aptitud y pruebas de juicio situacional con respuestas correctas definidas, se adaptan casi igual de bien, ya que la lógica de puntuación apenas difiere de un examen de opción múltiple bien construido.
Las tareas de respuesta escrita y comunicación se sitúan en el medio. La IA puede señalar la gramática, la estructura y si una respuesta abordó el tema propuesto, pero juzgar el tono, la persuasión o la resolución creativa de problemas sigue beneficiándose de una segunda revisión humana.
Las tareas de ventas, atención al cliente y roles interpersonales requieren actualmente un mayor peso humano. Estos roles dependen de leer señales emocionales y adaptarse durante la conversación, un territorio donde una rúbrica tiene dificultades para capturar lo que realmente predice el éxito en el puesto.
La guía de diseño de pruebas específicas por rol de Talent Approved está construida en torno a adaptar el formato de evaluación a la habilidad que se evalúa, que es el verdadero factor decisivo para determinar cuánto peso dar a la calificación por IA para cualquier puesto determinado.
Un camino pragmático para que la calificación humana y la de IA trabajen juntas
Olvida el debate de todo o nada. Ejecuta un piloto en un solo puesto, combina las puntuaciones de IA con el juicio humano mediante síntesis mecánica en lugar de elegir uno, y audita una pequeña muestra antes de escalar a algo de alto riesgo. Las funciones de la plataforma que apoyan esto (generación de rúbricas estructuradas, monitoreo antitrampas, resúmenes generados por IA) existen para agilizar el paso de revisión humana, no para reemplazarlo. Registra el rendimiento posterior a la contratación frente a las puntuaciones previas a la misma y ajusta la rúbrica cuando los datos te lo indiquen, no antes.
— Jimmie
¿Listo para probar la calificación asistida por IA? Empieza aquí
Talent Approved está diseñado exactamente para el modelo híbrido que recomienda este artículo: la IA hace el trabajo pesado de puntuación y tú conservas la decisión final. Magic Create convierte una descripción de puesto en una evaluación específica para el rol en cuestión de minutos, el monitoreo antitrampas integrado (verificaciones de pantalla y cámara web, repeticiones de sesión) protege la integridad de lo que estás puntuando, y los resúmenes generados por IA te ofrecen un desglose legible por candidato en lugar de un número sin contexto. El precio funciona con un modelo de pago por uso a $5 por evaluación de candidato completada, sin necesidad de suscripción.
Si estás listo para probarlo correctamente, ejecuta un piloto de 30 a 90 días: elige un puesto, genera la evaluación con Magic Create, puntúa cada envío tanto con el resumen de IA como con un revisor humano en paralelo, realiza una verificación de impacto adverso en los resultados y compara las contrataciones del piloto con los datos de rendimiento una vez que estén incorporados. Consulta la página de precios para dimensionar tu piloto antes de comprometerte con un despliegue completo.
Fuentes
Antes de implementar la calificación por IA a escala, revisa la guía de validación de SIOP, el marco TEVV-Athlon de NIST y el estudio de selección de personal de TI que compara la calificación por IA y la humana. Para las obligaciones legales en evolución, el resumen de K&L Gates sobre los cambios en la orientación federal merece una lectura.
- ChatGPT frente a la experiencia humana en el contexto de la selección de personal de TI
- Consideraciones y recomendaciones para la validación y uso de evaluaciones basadas en IA para la selección de empleados (SIOP)
- Informe piloto NIST ARIA 0.1
- La validez y utilidad de los métodos de selección en psicología del personal
Preguntas frecuentes
¿Puede la IA reemplazar completamente a los evaluadores humanos?
No. La investigación que compara la calificación por IA y la humana en la selección de personal de TI encontró una precisión media similar pero una mayor velocidad de la IA, mientras que ambas mostraron inconsistencias en la puntuación repetida. La revisión humana sigue siendo importante para las tareas ambiguas y las decisiones en fase final.
¿Es la calificación por IA legalmente defendible para las decisiones de contratación?
Puede serlo, si validas la herramienta y documentas el proceso. SIOP recomienda la validación psicométrica formal, y varios estados exigen ahora la notificación o el consentimiento del candidato cuando se utiliza IA en la puntuación.
¿Cuánto cuesta Talent Approved?
Talent Approved cobra $5 por evaluación de candidato completada bajo un modelo de pago por uso, sin necesidad de suscripción.
¿Cuál es la diferencia entre el sesgo de medición y el sesgo predictivo?
El sesgo de medición significa que una prueba puntúa de manera diferente entre grupos a pesar de una habilidad subyacente igual. El sesgo predictivo significa que la puntuación predice el desempeño laboral de forma diferente según el grupo. SIOP los trata como problemas separados y verificables, no como un único problema general de equidad.
¿Qué pruebas de habilidades son más seguras para calificar solo con IA?
Las pruebas estructuradas y puntuadas de forma objetiva (retos de programación, cuestionarios de conocimiento estandarizados y pruebas de juicio situacional con respuestas correctas definidas) son las más adecuadas para la calificación exclusiva por IA. Las respuestas escritas abiertas y las evaluaciones de roles interpersonales siguen beneficiándose de la revisión humana.
Recomendado
- Crea rúbricas de puntuación para evaluaciones que los educadores puedan probar y escalar con IA
- Guía de RR. HH. para EE. UU. sobre pruebas de impacto adverso: ejecutar, leer y corregir
- Piloto de $5 de Talent Approved: puntuaciones de referencia de candidatos para RR. HH.
- El papel de la IA en la selección masiva de candidatos: guía 2026