
AI বনাম মানব গ্রেডিং-এর জন্য HR প্লেবুক: ৩০–৯০ দিনের পাইলট + ৪টি TEVV ধাপ
AI গ্রেডিং কাঠামোগত, ভূমিকা-নির্দিষ্ট দক্ষতা পরীক্ষার জন্য ভালোভাবে কাজ করে: এটি একজন ব্যক্তির চেয়ে দ্রুত স্কোর করে এবং গড় নম্বরের কাছাকাছি থাকে। উচ্চ-ঝুঁকিপূর্ণ বা অস্পষ্ট সিদ্ধান্তের ক্ষেত্রে এটি একা চলা উচিত নয়। SIOP এবং NIST-এর TEVV পরীক্ষার পদ্ধতির কাঠামো একটি কারণে বিদ্যমান, এবং Talent Approved-এর মতো প্ল্যাটফর্মগুলো AI স্কোরিংকে মানবিক পর্যালোচনার সাথে যুক্ত করার ভিত্তিতে তৈরি, সম্পূর্ণরূপে প্রতিস্থাপন করার জন্য নয়।
সংক্ষেপে:
- AI গ্রেডিং কাঠামোগত মূল্যায়নের জন্য সবচেয়ে নির্ভরযোগ্য, যেমন কোডিং পরীক্ষা এবং মানসম্পন্ন জ্ঞান কুইজ, যেখানে স্পষ্ট সঠিক বা ভুল উত্তর বিদ্যমান।
- প্রাথমিক স্ক্রিনিংয়ে AI এবং সূক্ষ্ম বা অস্পষ্ট কাজের জন্য মানবিক পর্যালোচনার সমন্বয়ে একটি হাইব্রিড মডেল গতি ও নির্ভুলতার সর্বোত্তম ভারসাম্য প্রদান করে।
- AI এবং মানব উভয় গ্রেডারই অভিন্ন জমাগুলো স্কোর করার সময় অসামঞ্জস্য দেখায়, যা যাচাইকরণ এবং চলমান পর্যবেক্ষণের প্রয়োজনীয়তা জোর দেয়।
- পক্ষপাতের ঝুঁকির মধ্যে রয়েছে পরিমাপ পক্ষপাত এবং ভবিষ্যদ্বাণীমূলক পক্ষপাত, যা পুঙ্খানুপুঙ্খ পরীক্ষা, স্বচ্ছতা এবং অন্তর্ভুক্তিমূলক রুব্রিক ডিজাইনের মাধ্যমে হ্রাস করা যায়।
- ছোট পাইলট প্রোগ্রাম চালানো এবং মূল্যায়ন স্কোরকে প্রকৃত চাকরির কর্মক্ষমতার সাথে তুলনা করা নিশ্চিত করতে সাহায্য করে যে AI টুলগুলো নিয়োগে ভবিষ্যদ্বাণীযোগ্য এবং ন্যায্য।
বিষয়বস্তু সূচী
- নিয়োগে AI গ্রেডিং এবং মানব গ্রেডিং কীভাবে কাজ করে
- শক্তি ও সীমাবদ্ধতা: নির্ভুলতা, গতি, সামঞ্জস্য এবং পক্ষপাত
- HR দলগুলোকে অবশ্যই যে যাচাইকরণ, পরীক্ষা ও শাসন পরিচালনা করতে হবে
- বাস্তবায়ন চেকলিস্ট: সিদ্ধান্তের নিয়ম এবং মেট্রিক্স
- প্রার্থীদের জন্য ফিডব্যাকের মানের উপর AI গ্রেডিংয়ের প্রভাব
- কাগজের পরীক্ষা থেকে AI স্কোরিং: একটি সংক্ষিপ্ত ইতিহাস
- AI বনাম মানব গ্রেডিং সম্পর্কিত নৈতিক বিবেচনা
- কেন AI গ্রেডিংয়ের ফলাফল ব্যাখ্যা করা কঠিন
- বিভিন্ন ভূমিকা ও দক্ষতার ধরন জুড়ে AI গ্রেডিং
- মানব ও AI গ্রেডিং একসাথে কাজ করার একটি বাস্তবসম্মত পথ
- AI-সহায়তা গ্রেডিং পাইলট করতে প্রস্তুত? এখান থেকে শুরু করুন
- সূত্র
- সাধারণ জিজ্ঞাসা
নিয়োগে AI গ্রেডিং এবং মানব গ্রেডিং কীভাবে কাজ করে
AI গ্রেডিং টুলগুলো প্রশিক্ষণ লেবেল, কাঠামোগত মানদণ্ড, অথবা সিস্টেমে ফিড করা চাকরির বিবরণ থেকে তৈরি একটি রুব্রিকের বিপরীতে প্রার্থীদের কাজ স্কোর করে। কিছু AI মূল্যায়ন প্ল্যাটফর্ম এমন বৈশিষ্ট্য প্রদান করে যা মিনিটের মধ্যে চাকরির বিবরণ থেকে ভূমিকা-নির্দিষ্ট মূল্যায়ন এবং স্কোরিং কাঠামো তৈরি করে, তারপর প্রতিটি প্রার্থীর কর্মক্ষমতার সারসংক্ষেপ তৈরি করে যাতে নিয়োগকর্তারা প্রতিটি জমা লাইন বাই লাইন না পড়েও ফলাফল পর্যালোচনা করতে পারেন। সুবিধা হলো থ্রুপুট: এই ধরনের একটি সিস্টেম একজন বিষয়-বিশেষজ্ঞ মাত্র কয়েকটি পর্যালোচনা করার সময়ে শত শত কোড নমুনা বা লিখিত প্রতিক্রিয়া গ্রেড করতে পারে।
মানব গ্রেডিং ভিন্নভাবে কাজ করে। একজন বিষয়-বিশেষজ্ঞ বিচার, প্রেক্ষাপট এবং অভিজ্ঞতা ব্যবহার করে একটি রুব্রিক প্রয়োগ করেন, যা সূক্ষ্মতার জন্য মূল্যবান কিন্তু স্কেল করতে ব্যয়বহুল। প্রতিবার দুটি জিনিস এটিকে ধীর করে দেয়: প্রতি প্রার্থী খরচ এবং আন্তঃ-মূল্যায়নকারী পরিবর্তনশীলতা, অর্থাৎ দুজন যোগ্য পর্যালোচক মেজাজ, ক্লান্তি, বা রুব্রিকের ব্যাখ্যার উপর নির্ভর করে একই উত্তর ভিন্নভাবে স্কোর করতে পারেন।
বেশিরভাগ নিয়োগকর্তা একটি পক্ষ বেছে নেওয়ার পরিবর্তে হাইব্রিড মডেলে পৌঁছান। সাধারণ ধরনগুলো হলো:
- AI-প্রথম এবং মানবিক স্পট-চেক সহ: AI প্রতিটি জমা গ্রেড করে, এবং একজন নিয়োগকর্তা একটি নমুনা বা যেকোনো সীমারেখার স্কোর পর্যালোচনা করেন।
- জটিল কাজের জন্য মানব-প্রথম: মুক্ত-শেষ বা বিচার-ভারী প্রম্পটগুলো সরাসরি একজন ব্যক্তির কাছে যায়, যখন কাঠামোগত কাজগুলো (কোডিং পরীক্ষা, গণিতের সমস্যা, বহুনির্বাচনী যুক্তি) AI-এর কাছে যায়।
- যান্ত্রিক সংশ্লেষণ: মানব মূল্যায়নকারী এবং অ্যালগরিদমিক স্কোরগুলো একটি সম্মিলিত আউটপুটে মিশ্রিত করা হয়, একটি পদ্ধতি যা ভবিষ্যদ্বাণীমূলক নির্ভুলতা বজায় রাখার পাশাপাশি নিয়োগ ব্যবস্থাপকদের কাছ থেকে গ্রহণযোগ্যতা উন্নত করে যারা প্রক্রিয়ায় একটি মানবিক পরীক্ষা চান।
শক্তি ও সীমাবদ্ধতা: নির্ভুলতা, গতি, সামঞ্জস্য এবং পক্ষপাত
IT নিয়োগে মানব বিশেষজ্ঞদের বিপরীতে AI গ্রেডিংয়ের একটি পিয়ার-রিভিউড তুলনায় দুটির মধ্যে গড় স্কোরে কোনো উল্লেখযোগ্য পার্থক্য পাওয়া যায়নি। AI অনেক দ্রুত গ্রেড করেছে, কিন্তু সমীক্ষায় উভয় পক্ষের জন্য কম আকর্ষণীয় কিছু পাওয়া গেছে: কেউই সম্পূর্ণ সামঞ্জস্যপূর্ণ ছিল না। AI একই জমা পুনরায় গ্রেড করতে বলা হলে ভিন্ন স্কোর তৈরি করেছে, এবং মানব পর্যালোচকরাও দশকের পর দশক ধরে নিয়োগ গবেষণায় নথিভুক্ত একই আন্তঃ-মূল্যায়নকারী অবিশ্বস্ততা দেখিয়েছে।
প্রতিটি পদ্ধতি যেখানে জয়ী হতে থাকে:
- AI কাজটি কাঠামোগত হলে (কোড পরীক্ষা, মানসম্পন্ন সমস্যার সেট) বড় প্রার্থী পুলে কাঁচা গতি এবং সামঞ্জস্যে জয়ী হয়।
- মানুষ প্রেক্ষাপটে জয়ী হয়: একটি অপ্রচলিত কিন্তু বৈধ উত্তর চেনা, আবাসন প্রয়োগ করা, বা এমন একজন প্রার্থীকে ধরা যিনি সমস্যাটি ভিন্ন কিন্তু সমানভাবে সঠিক উপায়ে সমাধান করেছেন।
- পুনরাবৃত্তিযোগ্যতায় কেউই সম্পূর্ণরূপে জয়ী নয়। AI এবং মানব উভয় গ্রেডারই দ্বিতীয় পাসে একই কাজের জন্য ভিন্ন স্কোর তৈরি করতে পারে।
সামঞ্জস্য পরীক্ষা: একই সমীক্ষা যেটি AI-কে মানব গড় স্কোরের সাথে মিলিয়েছে সেটি খুঁজে পেয়েছে যে AI এবং মানব উভয় গ্রেডিংই অভিন্ন জমার বারবার মূল্যায়নে পরিমাপযোগ্য অসামঞ্জস্য দেখিয়েছে, যে কারণে যেকোনো উৎস থেকে একটি একক গ্রেডিং পাস একটি চূড়ান্ত নিয়োগ সিদ্ধান্তের ঝুঁকিপূর্ণ ভিত্তি।
পক্ষপাত তার নিজস্ব বিশ্লেষণের দাবি রাখে, কারণ "পক্ষপাতমূলক" শব্দটি ঢিলেঢালাভাবে ব্যবহার করা হয়। SIOP এটিকে দুটি স্বতন্ত্র, পরীক্ষাযোগ্য ধারণায় বিভক্ত করে: পরিমাপ পক্ষপাত, যেখানে একটি পরীক্ষা সমান অন্তর্নিহিত দক্ষতা সত্ত্বেও বিভিন্ন গোষ্ঠীর জন্য ভিন্নভাবে কার্যকর হয়, এবং ভবিষ্যদ্বাণীমূলক পক্ষপাত, যেখানে একটি পরীক্ষার স্কোর বিভিন্ন গোষ্ঠীর মধ্যে ভিন্নভাবে চাকরির কর্মক্ষমতা পূর্বাভাস দেয়। এগুলোকে একটি অস্পষ্ট সমস্যা হিসেবে বিবেচনা করা হলো নিয়োগকর্তারা কীভাবে প্রকৃত ঝুঁকি মিস করেন। একটি সাধারণ ব্যর্থতার ধরন হলো টার্গেট লিকেজ, যেখানে একটি মডেল একটি প্রক্সি ভেরিয়েবলে প্রশিক্ষণ নেয় যা দক্ষতার পরিবর্তে একটি সংরক্ষিত বৈশিষ্ট্যের সাথে সম্পর্কযুক্ত। প্রতিবন্ধী প্রার্থীদের জন্য আবাসন বাদ দেওয়া আরেকটি: ADA বিবেচনা ছাড়া তৈরি একটি AI রুব্রিক একটি বৈধ বিকল্প পদ্ধতিকে শাস্তি দিতে পারে যা একজন মানব পর্যালোচক তাৎক্ষণিকভাবে চিনবেন।
HR দলগুলোকে অবশ্যই যে যাচাইকরণ, পরীক্ষা ও শাসন পরিচালনা করতে হবে
পরীক্ষার পরিকল্পনা ছাড়া একটি AI গ্রেডিং টুল স্থাপন করা হলো নিয়োগকর্তারা কীভাবে একটি নিয়োগ সিদ্ধান্তের পরিবর্তে মামলা রক্ষায় শেষ পর্যন্ত পড়ে যান। NIST-এর TEVV-Athlon পদ্ধতি এর জন্য একটি ব্যবহারিক কাঠামো প্রদান করে, চারটি পর্যায়ের ভিত্তিতে তৈরি:
- লক্ষ্য নির্ধারণ করুন। গ্রেডিং টুলকে ঠিক কী পরিমাপ করতে হবে এবং ভূমিকার জন্য "ভালো কর্মক্ষমতা" কেমন দেখায় তা স্থির করুন।
- গঠনমূলক যাচাইকরণ। নিশ্চিত করুন যে পরীক্ষাটি আসলে যে দক্ষতা দাবি করে তা পরিমাপ করছে, কোনো ঢিলেঢালাভাবে সম্পর্কিত প্রক্সি নয়।
- ব্যবহারকারী এবং ক্ষেত্র পরীক্ষা। প্রকৃত প্রার্থীদের জমার বিরুদ্ধে টুলটি চালান, যেখানে এটি ভেঙে পড়ে বা অন্যায্যভাবে স্কোর করে তা খুঁজে বের করতে রেড-টিমিং প্রচেষ্টা সহ।
- ফলাফল সংশ্লেষণ করুন। টুলটি লাইভ ব্যবহারের জন্য প্রস্তুত কিনা তার একটি নথিভুক্ত বিচারে সবকিছু একত্রিত করুন।
লঞ্চের আগে এবং পরবর্তীতে পুনরাবৃত্তিমূলক ক্যাডেন্সে চালানোর যোগ্য একটি অডিট চেকলিস্টে গঠনমূলক এবং ব্যবহারিক বৈধতা পরীক্ষা, জনতাত্ত্বিক গোষ্ঠী জুড়ে প্রতিকূল প্রভাব পরীক্ষা, লেবেল উৎস এবং রুব্রিক ডিজাইনের ডকুমেন্টেশন, সিদ্ধান্তে আঁকার আগে পর্যাপ্ত নমুনা আকার, এবং একটি একক পর্যালোচনার পরিবর্তে একটি নির্দিষ্ট পর্যবেক্ষণ সময়সূচি অন্তর্ভুক্ত থাকা উচিত। Talent Approved-এর অন্তর্নির্মিত প্রতিকূল প্রভাব পরীক্ষার নির্দেশিকা পরিসংখ্যান পটভূমি ছাড়াই এই ধরনের পরীক্ষা চালানোর পদ্ধতি ব্যাখ্যা করে।
সবচেয়ে উপেক্ষিত পদক্ষেপ হলো ফিডব্যাক একীভূতকরণ: নিয়োগ-পূর্ব স্কোরগুলোকে নিয়োগের পরে আসলে কী ঘটে তার সাথে সংযুক্ত করা। একটি স্ক্রিনিং পরীক্ষাকে সত্যিকারের ভবিষ্যদ্বাণীমূলক যন্ত্রে পরিণত করতে, আপনি আশা করছেন এমন একটি ফিল্টারের পরিবর্তে, মূল্যায়ন স্কোরকে ধারণ এবং কর্মক্ষমতা ডেটার বিরুদ্ধে তুলনা করা।
প্রো টিপ: আপনি যে ভূমিকার জন্য ঘন ঘন নিয়োগ করেন সেই ভূমিকায় আপনার প্রথম যাচাইকরণ চক্র চালান। মূল্যায়ন স্কোর আসলে কিছু পূর্বাভাস দিয়েছিল কিনা তা পরীক্ষা করার জন্য আপনার কাছে যথেষ্ট ঐতিহাসিক কর্মক্ষমতা ডেটা থাকবে, অনুমান করার পরিবর্তে।
বাস্তবায়ন চেকলিস্ট: সিদ্ধান্তের নিয়ম এবং মেট্রিক্স
প্রতিটি পরীক্ষা একই বালতিতে রাখা উচিত নয়। একটি কার্যকর সিদ্ধান্তের নিয়ম এরকম দেখায়:
- কাঠামোগত কোডিং পরীক্ষা, মানসম্পন্ন সমস্যার সেট এবং উচ্চ-পরিমাণের প্রাথমিক স্ক্রিনিংয়ের জন্য শুধুমাত্র AI বা AI-প্রথম গ্রেডিং ব্যবহার করুন।
- অস্পষ্ট মুক্ত-পাঠ্য প্রতিক্রিয়া, পোর্টফোলিও মূল্যায়ন, এবং যেকোনো চূড়ান্ত-পর্যায়ের সিদ্ধান্ত যা একটি অফারকে প্রভাবিত করে তার জন্য মানবিক পর্যালোচনা প্রয়োজন।
- যখনই ভূমিকা উচ্চ-ঝুঁকিপূর্ণ কিন্তু পরীক্ষার ফরম্যাট AI-কে প্রথম পাস পরিচালনার জন্য যথেষ্ট কাঠামোগত তখন হাইব্রিড স্কোরিং-কে ডিফল্ট করুন।
নিয়মগুলো সেট হয়ে গেলে, অন্ত্রের অনুভূতির পরিবর্তে প্রকৃত মেট্রিক্স দিয়ে ট্র্যাক করুন:
- আন্তঃ-মূল্যায়নকারী চুক্তি — দুই-মূল্যায়নকারী তুলনার জন্য কোহেনের কাপ্পা, বা যখন আরও মূল্যায়নকারী জড়িত তখন ফ্লেইসের কাপ্পা, AI-বনাম-মানব এবং মানব-বনাম-মানব উভয় তুলনায় প্রয়োগ করা।
- উপগোষ্ঠী স্কোর বিতরণ — পরিমাপ পক্ষপাত তাড়াতাড়ি ধরতে নিয়মিতভাবে জনতাত্ত্বিক বিভাগ অনুসারে বিভক্ত।
- ভবিষ্যদ্বাণীমূলক বৈধতা সম্পর্ক — নিয়োগ-পূর্ব স্কোর আসলে নিয়োগ-পরবর্তী কর্মক্ষমতা কতটা ভালোভাবে ট্র্যাক করে।
- প্রক্রিয়াকরণ সময় এবং ত্রুটির হার — গ্রেডিং কতক্ষণ লাগে এবং আউটপুটগুলো কতবার ম্যানুয়াল সংশোধন প্রয়োজন।
অপারেশনাল নিয়ন্ত্রণগুলো মেট্রিক্সের মতোই গুরুত্বপূর্ণ: রাজ্য আইন যেখানে প্রয়োজন সেখানে প্রার্থীদের নোটিশ দিন, আউটলায়ার স্কোরের জন্য একটি এস্কেলেশন পথ তৈরি করুন, সম্মতি পর্যালোচনার জন্য প্রতিটি অডিট নথিভুক্ত করুন, এবং কোনো অভিযোগ সমস্যাটিকে জোর করার অপেক্ষা করার পরিবর্তে একটি নির্দিষ্ট পুনঃপ্রশিক্ষণ ট্রিগার সেট করুন। Talent Approved-এর তাৎক্ষণিক মূল্যায়ন স্কোরিং এই ধরনের স্বচ্ছ, অডিটযোগ্য রুব্রিককে মাথায় রেখে তৈরি।
প্রার্থীদের জন্য ফিডব্যাকের মানের উপর AI গ্রেডিংয়ের প্রভাব
দ্রুততর গ্রেডিং প্রার্থীরা কী অনুভব করেন তা পরিবর্তন করে, শুধু নিয়োগকর্তারা কী দেখেন তা নয়। একজন প্রার্থী যিনি একটি দক্ষতা পরীক্ষা শেষ করেন এবং দুই সপ্তাহের পরিবর্তে কয়েক ঘণ্টার মধ্যে একটি ফলাফল পান তিনি একটি প্রতিযোগিতামূলক অফার গ্রহণ করার পরিবর্তে আপনার প্রক্রিয়ায় নিযুক্ত থাকেন। AI-জেনারেটেড সারসংক্ষেপগুলো নিয়োগকর্তাদের প্রতিটি প্রার্থীর শক্তি ও দুর্বলতার একটি পঠনযোগ্য বিশ্লেষণ জমা দেওয়ার প্রায় তাৎক্ষণিকভাবে দিতে পারে, যা মূল্যায়ন এবং পরবর্তী পদক্ষেপের মধ্যে ব্যবধান কমায়।
ফিডব্যাকের গুণমান ফিডব্যাকের গতি থেকে আলাদা প্রশ্ন, তবে, এবং এখানেই AI-এর এখনও প্রকৃত সীমাবদ্ধতা রয়েছে। একটি জেনারেটেড সারসংক্ষেপ চিহ্নিত করতে পারে যে একজন প্রার্থীর কোড নির্দিষ্ট পরীক্ষার ক্ষেত্রে ব্যর্থ হয়েছে বা একটি লিখিত প্রতিক্রিয়া রুব্রিক থেকে মূল মানদণ্ড বাদ দিয়েছে। একজন দক্ষ মানব পর্যালোচক যে গঠন নিয়ে আসেন সেই একই গঠন দিয়ে "কেন" ব্যাখ্যা করতে এটি সংগ্রাম করে, বিশেষত সৃজনশীল বা বিচার-ভারী কাজের জন্য যেখানে সঠিক উত্তর একক নয়।
বেশিরভাগ হাইব্রিড ওয়ার্কফ্লো যে ব্যবহারিক সমাধানে পৌঁছায় তা হলো স্তরিত ফিডব্যাক: AI তাৎক্ষণিকভাবে প্রথম-পাস সারসংক্ষেপ তৈরি করে, এবং একজন নিয়োগকর্তা বা নিয়োগ ব্যবস্থাপক একজন প্রার্থী বা নিয়োগ কমিটিতে পৌঁছানোর আগে প্রেক্ষাপট যোগ করেন। এটি একজন ব্যক্তি যে ব্যাখ্যামূলক সূক্ষ্মতা যোগ করেন তা না হারিয়ে স্বয়ংক্রিয় গ্রেডিংয়ের গতির সুবিধা বজায় রাখে। এটি একটি সূক্ষ্ম ঝুঁকির বিরুদ্ধেও সুরক্ষা দেয়: প্রার্থীরা একটি AI সারসংক্ষেপকে আসলে যা তার চেয়ে বেশি কর্তৃত্বপূর্ণ হিসেবে বিশ্বাস করছেন, শুধুমাত্র কারণ এটি দ্রুত এসেছে এবং সুন্দরভাবে দেখাচ্ছে।
কাগজের পরীক্ষা থেকে AI স্কোরিং: একটি সংক্ষিপ্ত ইতিহাস
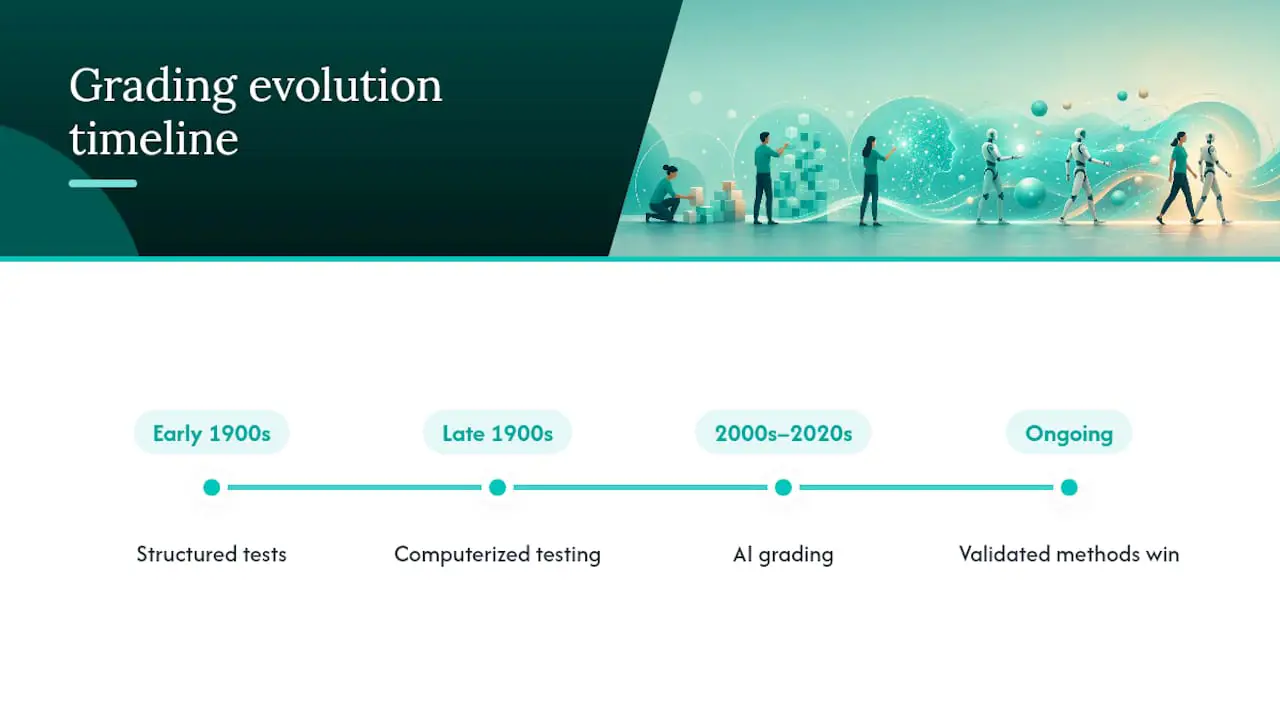
সফটওয়্যার দিয়ে প্রার্থী গ্রেড করা শুরু হয়নি। কাঠামোগত নিয়োগ মূল্যায়নের ইতিহাস ২০তম শতাব্দীর প্রথম দিকের কার্মিক মনোবিজ্ঞানে ফিরে যায়, যখন নিয়োগকর্তারা প্রথমবার অন্ত্রের প্রবৃত্তি এবং ব্যক্তিগত রেফারেলের উপর নির্ভরতা কমাতে পরীক্ষা মানসম্পন্ন করার চেষ্টা করেছিলেন। তখন থেকে দশকের পর দশক ধরে গবেষণা ধারাবাহিকভাবে দেখায় যে কাঠামোগত, চাকরি-প্রাসঙ্গিক পদ্ধতি, বিশেষত কাজের নমুনা এবং কাঠামোগত সাক্ষাৎকার, প্রকৃত চাকরির কর্মক্ষমতার সাথে সবচেয়ে শক্তিশালী সংযোগ তৈরি করে, অকাঠামোগত সাক্ষাৎকার বা একা রেজুমে স্ক্রিনিংকে অনেকটা ছাড়িয়ে যায়।
পরবর্তী বড় পরিবর্তন এসেছিল ২০তম শতাব্দীর শেষের দিকে কম্পিউটারাইজড পরীক্ষার সাথে, যা নিয়োগকর্তাদের স্কোরিং মানসম্পন্ন করতে এবং বহুনির্বাচনী এবং সংখ্যাগত মূল্যায়নের জন্য কিছু আন্তঃ-মূল্যায়নকারী অসামঞ্জস্য কমাতে দিয়েছিল। কিন্তু মুক্ত-শেষ কাজ, লেখার নমুনা, কোড পর্যালোচনা, পরিস্থিতিগত প্রতিক্রিয়া, এখনও পড়তে এবং বিচার করতে একজন মানুষের প্রয়োজন ছিল, যা স্কেলে গ্রেডিংকে ধীর এবং ব্যয়বহুল রাখে।
AI গ্রেডিং সেই একই গতিপথে পরবর্তী পদক্ষেপ, এটি থেকে বিরতি নয়। যা পরিবর্তন হয়েছে তা হলো কোনো মানব প্যানেল মেলাতে পারে না এমন গতিতে অকাঠামোগত প্রতিক্রিয়াগুলোতে (লিখিত উত্তর, কোড, এমনকি ভিডিও) একটি সামঞ্জস্যপূর্ণ রুব্রিক প্রয়োগ করার ক্ষমতা। আধুনিক AI-এর দশক আগের নির্বাচন পদ্ধতি একত্রিত করার গবেষণা এখনও অন্তর্নিহিত শিক্ষা ধারণ করে: যাচাইকৃত, চাকরি-প্রাসঙ্গিক পরীক্ষাগুলো অনানুষ্ঠানিক বিচারকে হারায়, গ্রেডার একজন ব্যক্তি হোক বা একটি মডেল। AI সেই নীতি আবিষ্কার করেনি। এটি কেবল স্কেলে প্রয়োগ করাকে অবশেষে বাস্তবসম্মত করেছে।
AI বনাম মানব গ্রেডিং সম্পর্কিত নৈতিক বিবেচনা
AI গ্রেডিং নিয়ে নৈতিক প্রশ্নগুলো সত্যিই একটি মেশিন ন্যায্যতা "বোঝে" কিনা তা নিয়ে নয়। এগুলো এটি স্থাপনকারী মানুষরা প্রক্রিয়ায় যথেষ্ট জবাবদিহিতা তৈরি করেছেন কিনা তা নিয়ে। তিনটি সমস্যা বারবার উঠে আসে।
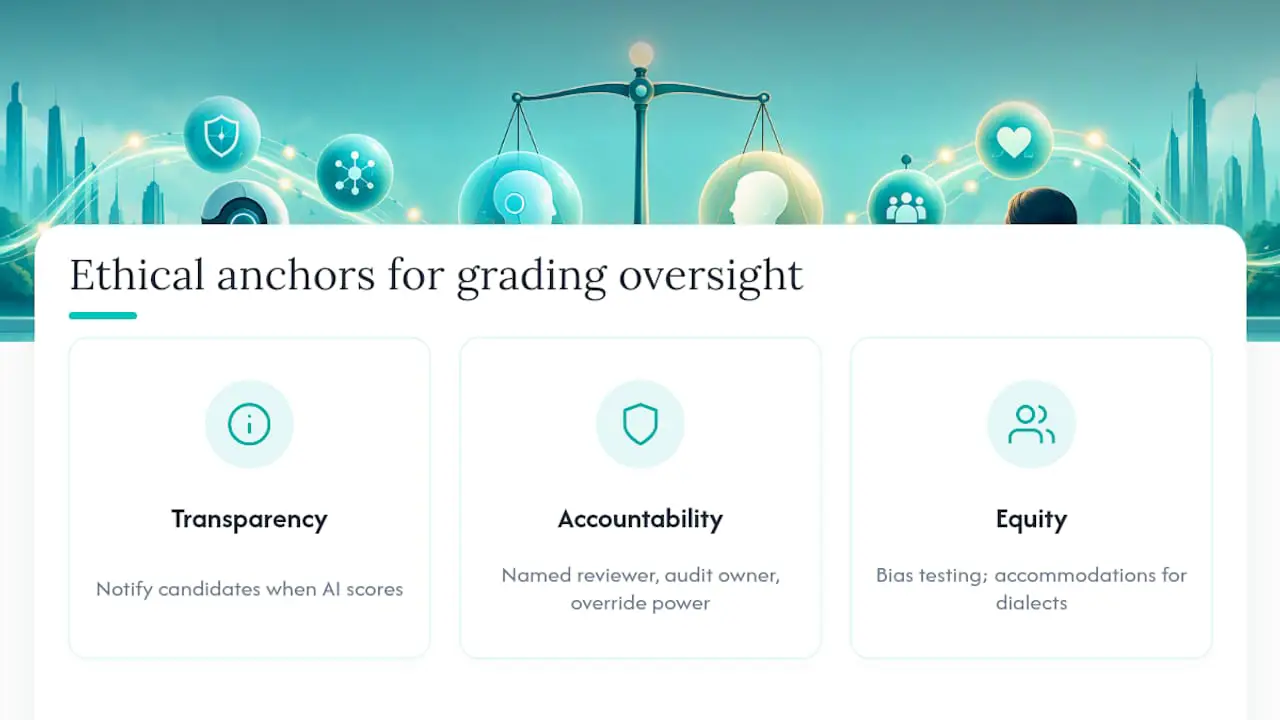
স্বচ্ছতা। প্রার্থীরা জানার অধিকার রাখেন যখন AI তাদের কাজ স্কোর করতে জড়িত, এবং ক্রমবর্ধমান সংখ্যক রাজ্য আইন ঠিক সেই ধরনের নোটিশ প্রয়োজন। যে নিয়োগকর্তারা এটিকে সূক্ষ্ম মুদ্রণে লুকিয়ে রাখেন তারা শুধু একটি নৈতিকতার সমস্যা নয়, আইনি এক্সপোজার তৈরি করছেন।
ত্রুটির জন্য জবাবদিহিতা। যখন একজন মানব গ্রেডার ভুল করেন, সেখানে একটি এস্কেলেশনের জন্য একজন ব্যক্তি আছেন। যখন একটি AI সিস্টেম একটি প্রতিক্রিয়া ভুল গ্রেড করে, জবাবদিহিতার শৃঙ্খলটি ঠিক ততটাই স্পষ্ট হওয়া দরকার: কে আউটলায়ারগুলো পর্যালোচনা করেন, কে অডিটের মালিক, এবং একটি স্কোর ওভাররাইড করার কর্তৃত্ব কার আছে।
প্রার্থীদের মধ্যে সমতা। আবাসন, লিখিত প্রতিক্রিয়ায় উপভাষার বৈচিত্র্য, বা অ-ঐতিহ্যগত সমস্যা-সমাধান পদ্ধতিতে মনোযোগ ছাড়াই প্রশিক্ষিত একটি গ্রেডিং সিস্টেম কারও না জানা পর্যন্ত নিঃশব্দে যোগ্য প্রার্থীদের অসুবিধায় ফেলতে পারে যতক্ষণ না একটি প্রতিকূল প্রভাব অডিট এটি ধরে। মানব গ্রেডাররা অচেতন পক্ষপাতের মাধ্যমে এই ঝুঁকির নিজস্ব সংস্করণ বহন করেন, যা ঠিক কারণে SIOP পক্ষপাত পরীক্ষাকে যেকোনো গ্রেডিং পদ্ধতির জন্য একটি প্রযুক্তিগত প্রয়োজনীয়তা হিসেবে বিবেচনা করে, একটি একক নৈতিক চেকবক্স হিসেবে নয়।
এর কোনোটিই AI ব্যবহারের বিরুদ্ধে যুক্তি দেয় না। এটি যুক্তি দেয় গ্রেডিংকে, যেকোনো ধরনের, একটি সিস্টেম হিসেবে বিবেচনা করার জন্য যার তত্ত্বাবধান প্রয়োজন, এমন একটি টুল নয় যা আপনি স্থাপন করে ভুলে যান।
কেন AI গ্রেডিংয়ের ফলাফল ব্যাখ্যা করা কঠিন
একজন মানব গ্রেডার সাধারণত একটি বাক্যে একটি স্কোর ব্যাখ্যা করতে পারেন: "প্রার্থীর সমাধান কাজ করেছিল কিন্তু একটি অদক্ষ পদ্ধতি ব্যবহার করেছিল।" একটি AI-জেনারেটেড স্কোর প্রায়ই খোলাসা করা কঠিন, বিশেষত যখন অন্তর্নিহিত মডেলটি ডজন ডজন সংকেত ওজন করে যা একজন নিয়োগকর্তা সরাসরি কখনও দেখেন না।
এটি একটি নির্দিষ্ট ব্যাখ্যার সমস্যা তৈরি করে: একটি স্পষ্ট যুক্তি ছাড়া একটি স্কোর রক্ষা করা কঠিন যদি একজন প্রার্থী এটি চ্যালেঞ্জ করেন বা একজন নিয়ন্ত্রক জিজ্ঞেস করেন কীভাবে একটি সিদ্ধান্ত নেওয়া হয়েছিল। একটি কম স্কোর একটি প্রকৃত দক্ষতার ব্যবধান প্রতিফলিত করে কিনা বা প্রার্থী কীভাবে একটি উত্তর তৈরি করেছিলেন তার একটি অদ্ভুততা জানাও কঠিন।
ব্যবহারিক উত্তর হলো প্রতিটি AI স্কোরকে অবিশ্বাস করা নয়। এটি হলো একটি বেসলাইন বৈশিষ্ট্য হিসেবে ব্যাখ্যাযোগ্যতা দাবি করা, একটি পরবর্তী চিন্তা নয়। একটি কার্যকর AI-জেনারেটেড সারসংক্ষেপ দেখাতে হবে একজন প্রার্থী কোন নির্দিষ্ট মানদণ্ড পূরণ করেছেন বা বাদ দিয়েছেন, শুধু একটি একক যৌগিক সংখ্যা নয়। সেই স্তরের বিবরণ একজন নিয়োগকর্তাকে AI-এর যুক্তি ক্রস-চেক করতে দেয় একইভাবে তারা একজন মানব পর্যালোচকের নোটগুলো স্যানিটি-চেক করবেন, এবং এটি একটি অস্পষ্ট স্কোরকে এমন কিছুতে পরিণত করে যা একজন নিয়োগ ব্যবস্থাপক আসলে একটি চূড়ান্ত সিদ্ধান্তে সমর্থন করতে পারেন।
বিভিন্ন ভূমিকা ও দক্ষতার ধরন জুড়ে AI গ্রেডিং
AI গ্রেডিং সমানভাবে প্রয়োগ করা একটি টুল নয়। এটি কতটা ভালো কাজ করে তা পরিবর্তিত হয় কী পরীক্ষা করা হচ্ছে তার উপর নির্ভর করে।
প্রযুক্তিগত এবং কোডিং মূল্যায়ন হলো সেখানে যেখানে AI গ্রেডিং সবচেয়ে নির্ভরযোগ্যভাবে কার্যকর হয়। পরীক্ষার ক্ষেত্রগুলো হয় পাস হয় বা ব্যর্থ হয়, কার্যকরী সময় পরিমাপযোগ্য, এবং কোডের গুণমান মেট্রিক্স স্পষ্ট মানদণ্ডের বিপরীতে স্কোর করা যায় — এটি ঠিক সেই কাঠামোগত পরিবেশ যা IT নিয়োগ সমীক্ষা পরিমাপ করেছিল যখন এটি দেখেছিল AI অনেক দ্রুত গতিতে মানব গড় স্কোরের সাথে মিলছে।
কাঠামোগত জ্ঞান পরীক্ষা, সম্মতি কুইজ, যোগ্যতা পরীক্ষা, নির্ধারিত সঠিক উত্তর সহ পরিস্থিতিগত বিচার পরীক্ষা, প্রায় ততটাই শক্তিশালী ফিট, কারণ স্কোরিং যুক্তি একটি সুনির্মিত বহুনির্বাচনী পরীক্ষা থেকে প্রায় আলাদা নয়।
লিখিত প্রতিক্রিয়া এবং যোগাযোগের কাজ মাঝখানে অবস্থিত। AI ব্যাকরণ, কাঠামো এবং একটি প্রতিক্রিয়া প্রম্পটটি সম্বোধন করেছে কিনা তা চিহ্নিত করতে পারে, কিন্তু স্বর, প্ররোচনা, বা সৃজনশীল সমস্যা-সমাধান বিচার করা এখনও মানবিক দ্বিতীয় দৃষ্টির সুবিধা পায়।
বিক্রয়, গ্রাহক সেবা এবং আন্তঃব্যক্তিক ভূমিকার কাজ এখনের জন্য মানব-ভারী। এই ভূমিকাগুলো আবেগীয় সংকেত পড়া এবং কথোপকথনের মাঝে মিড-কনভার্সেশনে অভিযোজনের উপর নির্ভর করে, এমন এলাকা যেখানে একটি রুব্রিক চাকরিতে আসলে কী সাফল্য পূর্বাভাস দেয় তা ধরতে সংগ্রাম করে।
Talent Approved-এর ভূমিকা-নির্দিষ্ট পরীক্ষা ডিজাইন নির্দেশিকা পরীক্ষার ফরম্যাটকে পরীক্ষিত দক্ষতার সাথে মেলানোর ভিত্তিতে তৈরি, যা যেকোনো প্রদত্ত ভূমিকার জন্য AI স্কোরিংয়ে কতটা ওজন রাখতে হবে তা নির্ধারণের প্রকৃত লিভার।
মানব ও AI গ্রেডিং একসাথে কাজ করার একটি বাস্তবসম্মত পথ
সব-অথবা-কিছুই-না বিতর্ক এড়িয়ে চলুন। একটি ভূমিকায় একটি পাইলট চালান, একটি বেছে নেওয়ার পরিবর্তে যান্ত্রিক সংশ্লেষণের মাধ্যমে AI স্কোরগুলোকে মানবিক বিচারের সাথে মিশ্রিত করুন, এবং যেকোনো উচ্চ-ঝুঁকিপূর্ণ বিষয়ে স্কেল করার আগে একটি ছোট নমুনা অডিট করুন। প্ল্যাটফর্ম বৈশিষ্ট্যগুলো যা এটিকে সমর্থন করে — কাঠামোগত রুব্রিক জেনারেশন, অ্যান্টি-চিট মনিটরিং, AI-জেনারেটেড সারসংক্ষেপ — মানবিক পর্যালোচনার পদক্ষেপটিকে দ্রুততর করার জন্য বিদ্যমান, এটি প্রতিস্থাপন করার জন্য নয়। নিয়োগ-পরবর্তী কর্মক্ষমতা ট্র্যাক করুন নিয়োগ-পূর্ব স্কোরের বিপরীতে এবং ডেটা আপনাকে বললে রুব্রিক সামঞ্জস্য করুন, তার আগে নয়।
— Jimmie
AI-সহায়তা গ্রেডিং পাইলট করতে প্রস্তুত? এখান থেকে শুরু করুন
Talent Approved ঠিক এই নিবন্ধে সুপারিশকৃত হাইব্রিড মডেলের জন্য তৈরি: AI স্কোরিংয়ে ভারী কাজ করে, এবং আপনি চূড়ান্ত সিদ্ধান্ত নেন। Magic Create মিনিটের মধ্যে একটি চাকরির বিবরণকে একটি ভূমিকা-নির্দিষ্ট মূল্যায়নে পরিণত করে, অন্তর্নির্মিত অ্যান্টি-চিট মনিটরিং (স্ক্রিন এবং ওয়েবক্যাম চেক, সেশন রিপ্লে) আপনি যা স্কোর করছেন তার অখণ্ডতা রক্ষা করে, এবং AI-জেনারেটেড সারসংক্ষেপ একটি কাঁচা সংখ্যার পরিবর্তে প্রতি প্রার্থীর পঠনযোগ্য বিশ্লেষণ দেয়। মূল্য নির্ধারণ প্রতি সম্পূর্ণ প্রার্থী মূল্যায়নে $5 একটি পে-অ্যাজ-ইউ-গো মডেলে চলে, কোনো সদস্যপদ প্রয়োজন ছাড়াই।
আপনি যদি এটি সঠিকভাবে পরীক্ষা করতে প্রস্তুত থাকেন, তাহলে ৩০ থেকে ৯০ দিনের একটি পাইলট চালান: একটি ভূমিকা বেছে নিন, Magic Create দিয়ে মূল্যায়ন তৈরি করুন, AI সারসংক্ষেপ এবং একটি মানব পর্যালোচক উভয় সমান্তরালভাবে প্রতিটি জমা স্কোর করুন, ফলাফল জুড়ে একটি প্রতিকূল প্রভাব পরীক্ষা চালান, এবং পাইলট নিয়োগকারীরা চাকরিতে থাকলে তাদের কর্মক্ষমতা ডেটার বিপরীতে তুলনা করুন। একটি পূর্ণ রোলআউটে প্রতিশ্রুতি দেওয়ার আগে আপনার পাইলটের সুযোগ নির্ধারণ করতে মূল্য নির্ধারণ পৃষ্ঠা দেখুন।
সূত্র
স্কেলে AI গ্রেডিং চালু করার আগে, SIOP-এর যাচাইকরণ নির্দেশিকা, NIST-এর TEVV-Athlon কাঠামো, এবং AI ও মানব গ্রেডিং তুলনা করা IT নিয়োগ সমীক্ষা পর্যালোচনা করুন। পরিবর্তনশীল আইনি বাধ্যবাধকতার জন্য, K&L Gates-এর পরিবর্তনশীল ফেডারেল নির্দেশিকার সারসংক্ষেপ পড়ার যোগ্য।
- IT নিয়োগের প্রেক্ষাপটে ChatGPT বনাম মানব দক্ষতা
- কর্মচারী নির্বাচনের জন্য AI-ভিত্তিক মূল্যায়নের যাচাইকরণ ও ব্যবহারে বিবেচনা ও সুপারিশ (SIOP)
- NIST ARIA 0.1 পাইলট রিপোর্ট
- কার্মিক মনোবিজ্ঞানে নির্বাচন পদ্ধতির বৈধতা ও উপযোগিতা
সাধারণ জিজ্ঞাসা
AI কি সম্পূর্ণরূপে মানব গ্রেডারদের প্রতিস্থাপন করতে পারে?
না। IT নিয়োগে AI এবং মানব গ্রেডিং তুলনা করা গবেষণা একই গড় নির্ভুলতা পেয়েছে কিন্তু দ্রুততর AI গতি, যখন উভয়ই পুনরায় স্কোর করার সময় অসামঞ্জস্য দেখিয়েছে। অস্পষ্ট কাজ এবং চূড়ান্ত-পর্যায়ের সিদ্ধান্তের জন্য মানবিক পর্যালোচনা এখনও গুরুত্বপূর্ণ।
নিয়োগ সিদ্ধান্তের জন্য AI গ্রেডিং কি আইনগতভাবে রক্ষাযোগ্য?
হতে পারে, যদি আপনি টুলটি যাচাই করেন এবং প্রক্রিয়াটি নথিভুক্ত করেন। SIOP আনুষ্ঠানিক সাইকোমেট্রিক যাচাইকরণের সুপারিশ করে, এবং বেশ কয়েকটি রাজ্য এখন স্কোরিংয়ে AI ব্যবহার করা হলে প্রার্থীর নোটিশ বা সম্মতি প্রয়োজন।
Talent Approved-এর খরচ কত?
Talent Approved পে-অ্যাজ-ইউ-গো ভিত্তিতে প্রতি সম্পূর্ণ প্রার্থী মূল্যায়নে $5 চার্জ করে, কোনো সদস্যপদ প্রয়োজন ছাড়াই।
পরিমাপ পক্ষপাত এবং ভবিষ্যদ্বাণীমূলক পক্ষপাতের মধ্যে পার্থক্য কী?
পরিমাপ পক্ষপাত মানে একটি পরীক্ষা সমান অন্তর্নিহিত দক্ষতা সত্ত্বেও গোষ্ঠীগুলোর মধ্যে ভিন্নভাবে স্কোর করে। ভবিষ্যদ্বাণীমূলক পক্ষপাত মানে স্কোর গোষ্ঠী অনুযায়ী ভিন্নভাবে চাকরির কর্মক্ষমতা পূর্বাভাস দেয়। SIOP এগুলোকে পৃথক, পরীক্ষাযোগ্য সমস্যা হিসেবে বিবেচনা করে, একটি সাধারণ ন্যায্যতার সমস্যা নয়।
কোন দক্ষতা পরীক্ষাগুলো শুধুমাত্র AI দিয়ে গ্রেড করা সবচেয়ে নিরাপদ?
কাঠামোগত, বস্তুনিষ্ঠভাবে স্কোর করা পরীক্ষা — কোডিং চ্যালেঞ্জ, মানসম্পন্ন জ্ঞান কুইজ, এবং নির্ধারিত সঠিক উত্তর সহ পরিস্থিতিগত বিচার পরীক্ষা — শুধুমাত্র AI গ্রেডিংয়ের জন্য সবচেয়ে নিরাপদ ফিট। মুক্ত-শেষ লিখিত প্রতিক্রিয়া এবং আন্তঃব্যক্তিক ভূমিকা মূল্যায়ন এখনও মানবিক পর্যালোচনার সুবিধা পায়।