
HR-Playbook für KI- vs. menschliches Grading: 30–90-Tage-Pilot + 4 TEVV-Schritte
KI-Bewertung funktioniert gut bei strukturierten, rollenspezifischen Kompetenztests: Sie bewertet schneller als ein Mensch und erzielt ähnliche Durchschnittswerte. Sie sollte jedoch nicht allein bei weitreichenden oder mehrdeutigen Entscheidungen eingesetzt werden. Rahmenwerke von SIOP und NISTsund NISTsund der TEVV-Testansatz von NIST existieren aus gutem Grund, und Plattformen wie Talent Approved sind darauf ausgelegt, KI-Bewertung mit menschlicher Überprüfung zu kombinieren – nicht, um sie vollständig zu ersetzen.
Kurzfassung:
- KI-Bewertung ist am zuverlässigsten bei strukturierten Assessments wie Coding-Tests und standardisierten Wissensquizzes, bei denen es klare richtige oder falsche Antworten gibt.
- Ein hybrides Modell – mit KI bei der ersten Sichtung und menschlicher Überprüfung bei nuancierten oder mehrdeutigen Aufgaben – bietet die beste Balance aus Geschwindigkeit und Genauigkeit.
- Sowohl KI- als auch menschliche Bewerter zeigen Inkonsistenzen bei der Bewertung identischer Einreichungen, was die Notwendigkeit von Validierung und laufender Überwachung unterstreicht.
- Zu den Bias-Risiken gehören Messbias und Vorhersagebias, die durch gründliche Tests, Transparenz und ein inklusives Rubrik-Design gemindert werden können.
- Das Durchführen kleiner Pilotprogramme und der Vergleich von Assessment-Ergebnissen mit tatsächlicher Arbeitsleistung hilft sicherzustellen, dass KI-Tools im Einstellungsprozess vorhersagekräftig und fair sind.
Inhaltsverzeichnis
- Wie KI-Bewertung und menschliche Bewertung im Recruiting funktionieren
- Stärken und Grenzen: Genauigkeit, Geschwindigkeit, Konsistenz und Bias
- Validierung, Tests und Governance, die HR-Teams durchführen müssen
- Implementierungs-Checkliste: Entscheidungsregeln und Kennzahlen
- Auswirkungen der KI-Bewertung auf die Feedback-Qualität für Kandidaten
- Von Papiertests zur KI-Bewertung: Eine kurze Geschichte
- Ethische Überlegungen speziell zur KI- vs. menschlichen Bewertung
- Warum KI-Bewertungsergebnisse schwerer zu interpretieren sind
- KI-Bewertung bei verschiedenen Rollen und Kompetenztypen
- Ein pragmatischer Weg zur Zusammenarbeit von menschlicher und KI-Bewertung
- Bereit, KI-gestützte Bewertung zu pilotieren? Hier beginnen
- Quellen
- FAQ
Wie KI-Bewertung und menschliche Bewertung im Recruiting funktionieren
KI-Bewertungstools beurteilen die Arbeit von Kandidaten anhand einer Rubrik, die aus Trainingslabels, strukturierten Kriterien oder einer dem System übergebenen Stellenbeschreibung aufgebaut wird. Einige KI-Assessment-Plattformen bieten Funktionen, mit denen sich rollenspezifische Assessments und Bewertungsstrukturen aus Stellenbeschreibungen in wenigen Minuten erstellen lassen und anschließend Zusammenfassungen der Leistung jedes Kandidaten generiert werden, sodass Recruiter die Ergebnisse prüfen können, ohne jede Einreichung Zeile für Zeile zu lesen. Der Vorteil liegt im Durchsatz: Ein solches System kann Hunderte von Code-Beispielen oder schriftlichen Antworten in der Zeit bewerten, in der ein einzelner Fachexperte eine Handvoll durchsieht.
Menschliche Bewertung funktioniert anders. Ein Fachexperte wendet eine Rubrik unter Einsatz von Urteilsvermögen, Kontext und Erfahrung an – was für Nuancen wertvoll, aber kostspielig zu skalieren ist. Zwei Dinge verlangsamen den Prozess jedes Mal: die Kosten pro Kandidat und die Inter-Rater-Variabilität, d. h. zwei qualifizierte Bewerter können dieselbe Antwort je nach Stimmung, Erschöpfung oder Interpretation der Rubrik unterschiedlich bewerten.
Die meisten Arbeitgeber entscheiden sich für ein hybrides Modell, anstatt eine Seite zu wählen. Gängige Muster sind:
- KI zuerst mit menschlichen Stichproben: Die KI bewertet jede Einreichung, und ein Recruiter überprüft eine Stichprobe oder Grenzwertpunkte.
- Mensch zuerst bei komplexen Aufgaben: Offene oder stark urteilsbasierte Aufgaben gehen direkt an eine Person, während strukturierte Aufgaben (Coding-Tests, Matheaufgaben, Multiple-Choice-Logik) an die KI gehen.
- Mechanische Synthese: Menschliche Bewertungen und algorithmische Punkte werden zu einem kombinierten Ergebnis zusammengeführt – eine Methode, die nachweislich die Vorhersagegenauigkeit erhält und gleichzeitig die Akzeptanz bei Hiring Managern verbessert, die eine menschliche Überprüfung des Prozesses wünschen.
Stärken und Grenzen: Genauigkeit, Geschwindigkeit, Konsistenz und Bias
Ein peer-reviewed Vergleich von KI-Bewertung und menschlichen Experten im IT-Recruiting ergab keinen signifikanten Unterschied in den Durchschnittswerten zwischen beiden. Die KI beurteilte wesentlich schneller, aber die Studie fand auch etwas weniger Schmeichelhaftes für beide Seiten: Keine war vollständig konsistent. Die KI produzierte unterschiedliche Bewertungen, wenn sie gebeten wurde, dieselbe Einreichung erneut zu bewerten, und menschliche Bewerter zeigten dieselbe Inter-Rater-Unzuverlässigkeit, die seit Jahrzehnten in der Einstellungsforschung dokumentiert ist.
Wo jeder Ansatz tendenziell die Nase vorn hat:
- Die KI gewinnt bei roher Geschwindigkeit und Konsistenz über große Kandidatenpools hinweg, wenn die Aufgabe strukturiert ist (Code-Tests, standardisierte Aufgabensets).
- Menschen gewinnen beim Kontext: eine unkonventionelle, aber gültige Antwort erkennen, Anpassungen vornehmen oder einen Kandidaten bemerken, der das Problem auf eine andere, aber gleichermaßen korrekte Weise gelöst hat.
- Keiner gewinnt klar bei der Wiederholbarkeit. Sowohl KI- als auch menschliche Bewerter können dieselbe Arbeit beim zweiten Durchgang unterschiedlich bewerten.
Konsistenzprüfung: Dieselbe Studie, die feststellte, dass die KI menschliche Durchschnittsbewertungen erreichte, stellte auch fest, dass sowohl KI- als auch menschliche Bewertungen bei wiederholter Auswertung identischer Einreichungen messbare Inkonsistenz zeigten – weshalb ein einzelner Bewertungsdurchlauf aus einer der beiden Quellen eine riskante Grundlage für eine endgültige Einstellungsentscheidung ist.
Bias verdient eine eigene Betrachtung, da „voreingenommen" oft unscharf verwendet wird. SIOP trennt es in zwei unterschiedliche, testbare Konzepte: Messbias, bei dem ein Test für verschiedene Gruppen trotz gleicher zugrunde liegender Fähigkeiten unterschiedlich abschneidet, und Vorhersagebias, bei dem ein Testergebnis die Arbeitsleistung gruppenübergreifend unterschiedlich vorhersagt. Diese als ein vages Problem zu behandeln ist der Weg, wie Arbeitgeber echte Risiken übersehen. Ein häufiges Versagensmuster ist Target Leakage, bei dem ein Modell auf eine Proxy-Variable trainiert wird, die mit einem geschützten Merkmal korreliert, anstatt mit der Fähigkeit selbst. Fehlende Anpassungen für Kandidaten mit Behinderungen sind ein weiteres Beispiel: Eine KI-Rubrik, die ohne Berücksichtigung der ADA-Anforderungen erstellt wurde, kann einen legitimen alternativen Ansatz bestrafen, den ein menschlicher Bewerter sofort erkennen würde.
Validierung, Tests und Governance, die HR-Teams durchführen müssen
Ein KI-Bewertungstool ohne Testplan einzusetzen ist der Weg, auf dem Arbeitgeber eine Klage statt einer Einstellungsentscheidung verteidigen müssen. NISTNISTs TEVV-Athlon-Ansatz bietet dafür eine praktische Struktur, die auf vier Phasen aufbaut:
- Ziele definieren. Genau festlegen, was das Bewertungstool messen soll und wie „gute Leistung" für die Rolle aussieht.
- Konstruktvalidierung. Bestätigen, dass der Test tatsächlich die behauptete Fähigkeit misst und nicht ein lose verwandtes Proxymerkmal.
- Nutzer- und Feldtests. Das Tool an echten Kandidateneinreichungen testen, einschließlich Red-Teaming-Versuchen, um Schwachstellen oder unfaire Bewertungen zu finden.
- Ergebnisse synthetisieren. Alles zu einem dokumentierten Urteil zusammenfassen, ob das Tool für den Live-Einsatz bereit ist.
Eine Audit-Checkliste, die es wert ist, vor dem Launch und danach in wiederkehrendem Rhythmus durchzuführen, sollte Konstrukt- und praktische Validitätsprüfungen, Tests auf adverse impact über demografische Gruppen hinweg, Dokumentation der Label-Quellen und des Rubrik-Designs, ausreichende Stichprobengrößen vor dem Ziehen von Schlussfolgerungen sowie einen festen Überwachungsplan statt einer einmaligen Überprüfung umfassen. Die integrierte Adverse-Impact-Testing-Anleitung von Talent Approved führt durch diese Art von Prüfung, ohne dass ein Statistik-Hintergrund erforderlich ist.
Der am häufigsten übersehene Schritt ist die Feedback-Integration: das Verbinden von Pre-Hire-Ergebnissen mit dem, was nach der Einstellung tatsächlich passiert. Der Vergleich von Assessment-Ergebnissen mit Bindungs- und Leistungsdaten verwandelt einen Screening-Test in ein wirklich vorhersagekräftiges Instrument – anstatt einen Filter zu verwenden, von dem man hofft, dass er funktioniert.
Profi-Tipp: Führen Sie Ihren ersten Validierungszyklus für eine Rolle durch, für die Sie bereits häufig einstellen. Sie werden über genügend historische Leistungsdaten verfügen, um zu prüfen, ob der Assessment-Score tatsächlich etwas vorhergesagt hat – anstatt zu raten.
Implementierungs-Checkliste: Entscheidungsregeln und Kennzahlen
Nicht jeder Test gehört in denselben Topf. Eine praktikable Entscheidungsregel sieht so aus:
- Verwenden Sie ausschließlich KI oder KI zuerst für die Bewertung bei strukturierten Coding-Tests, standardisierten Aufgabensets und der ersten Sichtung bei hohem Bewerbungsvolumen.
- Fordern Sie eine menschliche Überprüfung für mehrdeutige Freitextantworten, Portfolio-Bewertungen und alle Entscheidungen in der Endphase, die ein Angebot betreffen.
- Setzen Sie standardmäßig auf hybride Bewertung, wenn die Rolle zwar hohe Relevanz hat, das Testformat aber noch strukturiert genug ist, damit die KI einen ersten Durchgang bewältigen kann.
Sobald die Regeln festgelegt sind, verfolgen Sie diese mit echten Kennzahlen statt mit Bauchgefühl:
- Inter-Rater-Übereinstimmung — Cohens Kappa für Zwei-Bewerter-Vergleiche oder Fleiss' Kappa bei mehreren Bewertern, angewendet auf KI-gegen-Mensch- und Mensch-gegen-Mensch-Vergleiche.
- Teilgruppenscoreverteilungen — regelmäßig nach demografischen Kategorien aufgeschlüsselt, um Messbias frühzeitig zu erkennen.
- Prädiktive Validitätskorrelationen — wie gut Pre-Hire-Ergebnisse tatsächlich die Post-Hire-Leistung widerspiegeln.
- Verarbeitungszeit und Fehlerquote — wie lange die Bewertung dauert und wie oft Ergebnisse manuell korrigiert werden müssen.
Operative Kontrollmechanismen sind ebenso wichtig wie die Kennzahlen selbst: Informieren Sie Kandidaten, wo es das Landesrecht verlangt, schaffen Sie einen Eskalationspfad für Ausreißer-Bewertungen, dokumentieren Sie jedes Audit für die Compliance-Überprüfung und legen Sie einen festen Retraining-Auslöser fest, anstatt auf eine Beschwerde zu warten, die das Thema erzwingt. Die Sofort-Assessment-Bewertung von Talent Approved ist mit genau dieser Art von transparenter, prüfbarer Rubrik konzipiert.
Auswirkungen der KI-Bewertung auf die Feedback-Qualität für Kandidaten
Schnellere Bewertung verändert das Erlebnis der Kandidaten, nicht nur das, was Recruiter sehen. Ein Kandidat, der einen Kompetenztest abschließt und das Ergebnis in Stunden statt in zwei Wochen erhält, bleibt in Ihrem Prozess engagiert, anstatt ein konkurrierendes Angebot anzunehmen. KI-generierte Zusammenfassungen können Recruitern eine lesbare Übersicht über Stärken und Schwächen pro Kandidat nahezu unmittelbar nach der Einreichung liefern, was die Zeitspanne zwischen Assessment und nächsten Schritten verkürzt.
Die Qualität des Feedbacks ist jedoch eine andere Frage als die Geschwindigkeit des Feedbacks, und hier hat die KI noch echte Grenzen. Eine generierte Zusammenfassung kann darauf hinweisen, dass der Code eines Kandidaten bestimmte Testfälle nicht bestanden hat oder dass eine schriftliche Antwort wichtige Kriterien der Rubrik verfehlt hat. Es fällt ihr schwer, das „Warum" mit der gleichen Tiefe zu erklären, die ein erfahrener menschlicher Bewerter mitbringt – insbesondere bei kreativen oder stark urteilsbasierten Aufgaben, bei denen die richtige Antwort nicht eindeutig ist.
Die praktische Lösung, auf die die meisten hybriden Workflows kommen, ist gestuftes Feedback: Die KI generiert sofort die erste Zusammenfassung, und ein Recruiter oder Hiring Manager fügt Kontext hinzu, bevor sie einen Kandidaten oder ein Einstellungskomitee erreicht. Dies bewahrt den Geschwindigkeitsvorteil automatisierter Bewertung, ohne die interpretative Nuance zu verlieren, die eine Person einbringt. Es schützt auch vor einem subtileren Risiko: dass Kandidaten einer KI-Zusammenfassung mehr Autorität beimessen, als sie tatsächlich hat – einfach weil sie schnell ankam und ordentlich aussieht.
Von Papiertests zur KI-Bewertung: Eine kurze Geschichte
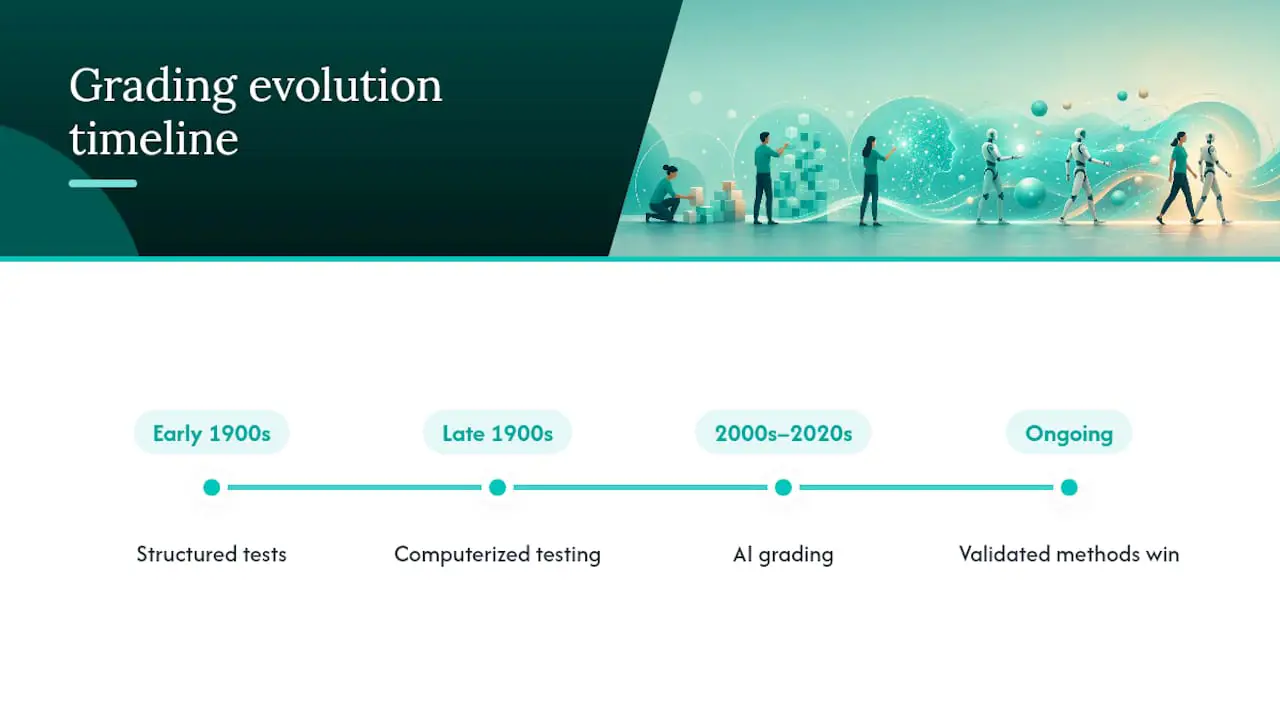
Die Bewertung von Kandidaten begann nicht mit Software. Strukturierte Einstellungs-Assessments gehen auf die Personalpsychologie des frühen 20. Jahrhunderts zurück, als Arbeitgeber erstmals versuchten, Tests zu standardisieren, um die Abhängigkeit von Bauchgefühl und persönlichen Empfehlungen zu verringern. Jahrzehntelange Forschung seither zeigt konsistent, dass strukturierte, jobrelevante Methoden – vor allem Arbeitsproben und strukturierte Interviews – die stärkste Verbindung zur tatsächlichen Arbeitsleistung aufweisen und unstrukturierte Interviews oder alleiniges Lebenslauf-Screening bei weitem übertreffen.
Der nächste große Wandel kam mit computergestütztem Testen im späten 20. Jahrhundert, das es Arbeitgebern ermöglichte, die Bewertung zu standardisieren und einige Inter-Rater-Inkonsistenzen bei Multiple-Choice- und numerischen Assessments zu reduzieren. Offene Aufgaben – Schreibproben, Code-Reviews, Szenarioantworten – mussten jedoch weiterhin von einem Menschen gelesen und beurteilt werden, was die Bewertung in großem Maßstab langsam und teuer hielt.
KI-Bewertung ist der nächste Schritt in derselben Entwicklung – kein Bruch mit ihr. Was sich verändert hat, ist die Fähigkeit, eine konsistente Rubrik auf unstrukturierte Antworten (schriftliche Antworten, Code, sogar Video) mit einer Geschwindigkeit anzuwenden, mit der kein menschliches Gremium mithalten kann. Die Forschung zur Kombination von Auswahlmethoden, die der modernen KI um Jahrzehnte vorausgeht, hält die grundlegende Lektion aufrecht: Validierte, jobrelevante Tests schlagen informelles Urteilsvermögen – egal ob der Bewerter ein Mensch oder ein Modell ist. Die KI hat dieses Prinzip nicht erfunden. Sie hat es nur endlich praktisch gemacht, es in großem Maßstab anzuwenden.
Ethische Überlegungen speziell zur KI- vs. menschlichen Bewertung
Die ethischen Fragen rund um KI-Bewertung drehen sich nicht wirklich darum, ob eine Maschine Fairness „versteht". Es geht darum, ob die Menschen, die sie einsetzen, genug Verantwortlichkeit in den Prozess eingebaut haben. Drei Themen tauchen immer wieder auf.
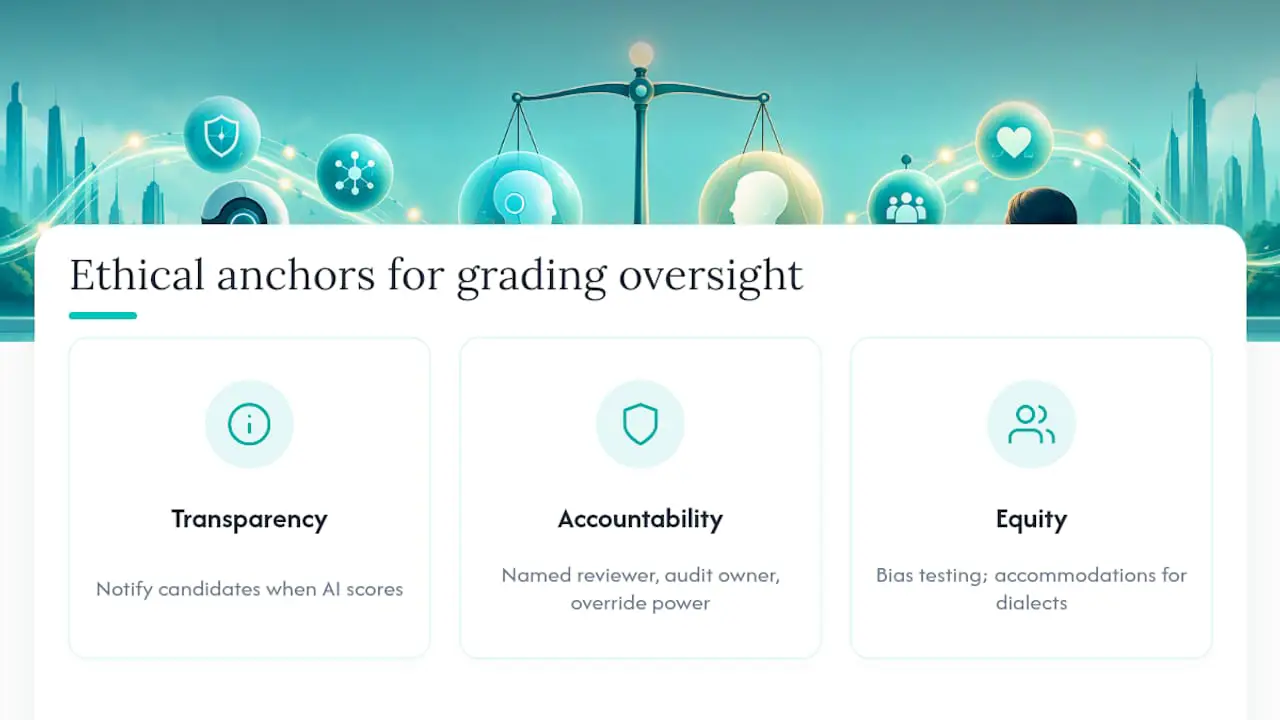
Transparenz. Kandidaten haben das Recht zu wissen, wenn KI an der Bewertung ihrer Arbeit beteiligt ist, und eine wachsende Zahl von Landesgesetzen verlangt genau diese Art von Hinweis. Arbeitgeber, die dies im Kleingedruckten vergraben, schaffen rechtliche Risiken – nicht nur ein Ethikproblem.
Verantwortlichkeit für Fehler. Wenn ein menschlicher Bewerter einen Fehler macht, gibt es eine Person, an die man sich wenden kann. Wenn ein KI-System eine Antwort falsch bewertet, muss die Verantwortungskette ebenso klar sein: Wer überprüft Ausreißer, wer ist für das Audit verantwortlich, und wer hat die Befugnis, eine Bewertung zu überschreiben.
Gerechtigkeit gegenüber allen Kandidaten. Ein Bewertungssystem, das ohne Berücksichtigung von Anpassungen, dialektaler Variation in schriftlichen Antworten oder unkonventionellen Problemlösungsansätzen trainiert wurde, kann qualifizierte Kandidaten still benachteiligen, ohne dass es jemandem auffällt, bis ein Adverse-Impact-Audit es aufdeckt. Menschliche Bewerter tragen ihre eigene Version dieses Risikos durch unbewusste Vorurteile – weshalb SIOP Bias-Tests als technische Anforderung für beide Bewertungsmethoden betrachtet, nicht als einmaligen ethischen Haken.
All das spricht nicht gegen den Einsatz von KI. Es spricht dafür, Bewertung – gleich welcher Art – als ein System zu behandeln, das Aufsicht benötigt, nicht als ein Werkzeug, das man einsetzt und vergisst.
Warum KI-Bewertungsergebnisse schwerer zu interpretieren sind
Ein menschlicher Bewerter kann eine Bewertung in der Regel in einem Satz erklären: „Die Lösung des Kandidaten funktionierte, verwendete aber einen ineffizienten Ansatz." Eine KI-generierte Bewertung ist oft schwerer zu entschlüsseln, insbesondere wenn das zugrundeliegende Modell Dutzende von Signalen gewichtet, die ein Recruiter nie direkt sieht.
Dies schafft ein spezifisches Interpretationsproblem: Eine Bewertung ohne klare Begründung ist schwer zu verteidigen, wenn ein Kandidat sie anficht oder eine Behörde fragt, wie eine Entscheidung getroffen wurde. Es ist auch schwerer zu beurteilen, ob eine niedrige Bewertung eine echte Kompetenzlücke widerspiegelt oder eine Eigenheit darin, wie der Kandidat eine Antwort formuliert hat.
Die praktische Antwort ist nicht, jeder KI-Bewertung zu misstrauen. Es geht darum, Erklärbarkeit als grundlegendes Merkmal zu fordern – nicht als Nachgedanken. Eine nützliche KI-generierte Zusammenfassung sollte zeigen, welche spezifischen Kriterien ein Kandidat erfüllt oder verfehlt hat – nicht nur eine einzelne Gesamtzahl. Dieses Maß an Detail ermöglicht es einem Recruiter, die Argumentation der KI zu überprüfen, genauso wie er die Notizen eines menschlichen Bewerters einer Plausibilitätsprüfung unterziehen würde – und verwandelt eine undurchsichtige Bewertung in etwas, hinter dem ein Hiring Manager in einer endgültigen Entscheidung wirklich stehen kann.
KI-Bewertung bei verschiedenen Rollen und Kompetenztypen
KI-Bewertung ist kein einheitlich anwendbares Werkzeug. Wie gut sie funktioniert, hängt davon ab, was getestet wird.
Technische Assessments und Coding-Tests sind der Bereich, in dem KI-Bewertung am zuverlässigsten abschneidet. Testfälle bestehen entweder oder nicht, die Ausführungszeit ist messbar, und Code-Qualitätsmetriken können anhand klarer Kriterien bewertet werden – genau die strukturierte Umgebung, die die IT-Recruiting-Studie maß, als sie feststellte, dass die KI menschliche Durchschnittsbewertungen bei wesentlich höherer Geschwindigkeit erreichte.
Strukturierte Wissenstests – Compliance-Quizze, Eignungstests, Situational-Judgment-Tests mit definierten richtigen Antworten – sind nahezu ebenso gut geeignet, da sich die Bewertungslogik kaum von einem gut aufgebauten Multiple-Choice-Test unterscheidet.
Schriftliche Antworten und Kommunikationsaufgaben liegen im Mittelfeld. Die KI kann Grammatik, Struktur und ob eine Antwort die Aufgabenstellung adressiert hat, kennzeichnen – aber Ton, Überzeugungskraft oder kreatives Problemlösen zu beurteilen, profitiert noch immer von einem zweiten menschlichen Blick.
Aufgaben für Vertrieb, Kundenservice und zwischenmenschliche Rollen sind derzeit noch stark auf Menschen ausgerichtet. Diese Rollen hängen vom Lesen emotionaler Signale und der Anpassung mitten im Gespräch ab – ein Bereich, in dem eine Rubrik Schwierigkeiten hat, das zu erfassen, was tatsächlich den Erfolg im Job vorhersagt.
Die rollenspezifische Testdesign-Anleitung von Talent Approved ist darauf ausgelegt, das Assessment-Format auf die zu testende Fähigkeit abzustimmen – der entscheidende Hebel, um zu bestimmen, wie viel Gewicht der KI-Bewertung für eine bestimmte Rolle beigemessen werden sollte.
Ein pragmatischer Weg zur Zusammenarbeit von menschlicher und KI-Bewertung
Überspringen Sie die Alles-oder-Nichts-Debatte. Führen Sie einen Pilot für eine Rolle durch, kombinieren Sie KI-Bewertungen mit menschlichem Urteil durch mechanische Synthese, anstatt sich für eine Seite zu entscheiden, und überprüfen Sie eine kleine Stichprobe, bevor Sie auf etwas Weitreichendes skalieren. Plattformfunktionen, die dies unterstützen – strukturierte Rubrik-Generierung, Anti-Betrug-Monitoring, KI-generierte Zusammenfassungen – existieren, um den menschlichen Überprüfungsschritt zu beschleunigen, nicht um ihn zu ersetzen. Verfolgen Sie die Post-Hire-Leistung im Vergleich zu den Pre-Hire-Ergebnissen und passen Sie die Rubrik an, wenn die Daten es Ihnen sagen – nicht vorher.
— Jimmie
Bereit, KI-gestützte Bewertung zu pilotieren? Hier beginnen
Talent Approved ist genau für das hybride Modell konzipiert, das dieser Artikel empfiehlt: Die KI übernimmt die Hauptarbeit bei der Bewertung, und Sie behalten das letzte Wort. Magic Create verwandelt eine Stellenbeschreibung in wenigen Minuten in ein rollenspezifisches Assessment, das integrierte Anti-Betrug-Monitoring (Bildschirm- und Webcam-Prüfungen, Session-Replays) schützt die Integrität dessen, was Sie bewerten, und KI-generierte Zusammenfassungen liefern Ihnen eine lesbare Übersicht pro Kandidat statt einer rohen Zahl. Das Preismodell basiert auf einem Pay-as-you-go-Prinzip bei 5 $ pro abgeschlossenem Kandidaten-Assessment, ohne erforderliches Abonnement.
Wenn Sie bereit sind, dies ordnungsgemäß zu testen, führen Sie einen 30- bis 90-tägigen Pilot durch: Wählen Sie eine Rolle, generieren Sie das Assessment mit Magic Create, bewerten Sie jede Einreichung parallel sowohl mit der KI-Zusammenfassung als auch mit einem menschlichen Bewerter, führen Sie einen Adverse-Impact-Check über die Ergebnisse durch, und vergleichen Sie die Pilot-Einstellungen mit Leistungsdaten, sobald sie im Job sind. Schauen Sie sich die Preisseite an, um Ihren Pilot zu planen, bevor Sie sich zu einem vollständigen Rollout verpflichten.
Quellen
Bevor Sie KI-Bewertung in großem Maßstab einführen, lesen Sie SIOPs Validierungsleitfaden, NISTsNISTs TEVV-Athlon-Framework und die IT-Recruiting-Studie zum Vergleich von KI- und menschlicher Bewertung. Für sich entwickelnde rechtliche Verpflichtungen ist K&L Gates' Zusammenfassung der sich wandelnden Bundesrichtlinien lesenswert.
- ChatGPT vs. menschliches Fachwissen im Kontext des IT-Recruitings
- Überlegungen und Empfehlungen zur Validierung und Nutzung KI-basierter Assessments für die Mitarbeiterauswahl (SIOP)
- NIST ARIA 0.1 Pilotbericht
- Die Validität und Nützlichkeit von Auswahlmethoden in der Personalpsychologie
FAQ
Kann KI menschliche Bewerter vollständig ersetzen?
Nein. Forschungen, die KI- und menschliche Bewertung im IT-Recruiting verglichen, stellten ähnliche durchschnittliche Genauigkeit, aber höhere KI-Geschwindigkeit fest, während beide bei wiederholter Bewertung Inkonsistenz zeigten. Menschliche Überprüfung ist weiterhin wichtig für mehrdeutige Aufgaben und Entscheidungen in der Endphase.
Ist KI-Bewertung für Einstellungsentscheidungen rechtlich vertretbar?
Das kann sie sein, wenn Sie das Tool validieren und den Prozess dokumentieren. SIOP empfiehlt eine formale psychometrische Validierung, und mehrere US-Bundesstaaten verlangen inzwischen eine Benachrichtigung oder Zustimmung der Kandidaten, wenn KI bei der Bewertung eingesetzt wird.
Wie viel kostet Talent Approved?
Talent Approved berechnet 5 $ pro abgeschlossenem Kandidaten-Assessment auf Pay-as-you-go-Basis, ohne erforderliches Abonnement.
Was ist der Unterschied zwischen Messbias und Vorhersagebias?
Messbias bedeutet, dass ein Test Gruppen trotz gleicher zugrunde liegender Fähigkeiten unterschiedlich bewertet. Vorhersagebias bedeutet, dass der Score die Arbeitsleistung je nach Gruppe unterschiedlich vorhersagt. SIOP behandelt diese als separate, testbare Probleme – nicht als ein allgemeines Fairnessproblem.
Welche Kompetenztests sind am sichersten, allein mit KI zu bewerten?
Strukturierte, objektiv bewertete Tests – Coding-Challenges, standardisierte Wissensquizze und Situational-Judgment-Tests mit definierten richtigen Antworten – sind am besten für die alleinige KI-Bewertung geeignet. Offene schriftliche Antworten und Assessments für zwischenmenschliche Rollen profitieren weiterhin von menschlicher Überprüfung.