
Manual de RH para Avaliação por IA vs Humana: Piloto de 30–90 Dias + 4 Etapas TEVV
A avaliação por IA funciona bem para testes de habilidades estruturados e específicos para funções: pontua mais rapidamente do que uma pessoa e chega perto das mesmas médias. Não deve funcionar sozinha em decisões de alto impacto ou ambíguas. As estruturas do SIOP e a abordagem de testes TEVV do NIST existem por um motivo, e plataformas como a Talent Approved são construídas em torno da combinação de pontuação por IA com revisão humana, não para substituí-la completamente.
Resumo:
- A avaliação por IA é mais confiável para avaliações estruturadas, como testes de programação e questionários de conhecimento padronizados, onde existem respostas claramente certas ou erradas.
- Um modelo híbrido com IA na triagem inicial e revisão humana para tarefas mais complexas ou ambíguas oferece o melhor equilíbrio entre velocidade e precisão.
- Tanto a IA quanto os avaliadores humanos apresentam inconsistências ao pontuar envios idênticos, o que enfatiza a necessidade de validação e monitoramento contínuo.
- Os riscos de viés incluem viés de mensuração e viés preditivo, que podem ser mitigados por meio de testes rigorosos, transparência e design de rubricas inclusivas.
- Executar programas-piloto pequenos e comparar as pontuações das avaliações com o desempenho real no trabalho ajuda a garantir que as ferramentas de IA sejam preditivas e justas no processo seletivo.
Índice
- Como a Avaliação por IA e a Avaliação Humana Funcionam no Processo Seletivo
- Pontos Fortes e Limitações: Precisão, Velocidade, Consistência e Viés
- Validação, Testes e Governança que as Equipes de RH Devem Executar
- Lista de Verificação de Implementação: Regras de Decisão e Métricas
- Impacto da Avaliação por IA na Qualidade do Feedback para Candidatos
- De Testes em Papel à Pontuação por IA: Uma Breve História
- Considerações Éticas Específicas sobre IA versus Avaliação Humana
- Por Que os Resultados da Avaliação por IA São Mais Difíceis de Interpretar
- Avaliação por IA em Diferentes Funções e Tipos de Habilidades
- Um Caminho Pragmático para a Avaliação Humana e por IA Trabalharem Juntas
- Pronto para Testar a Avaliação Assistida por IA? Comece Aqui
- Fontes
- Perguntas Frequentes
Como a Avaliação por IA e a Avaliação Humana Funcionam no Processo Seletivo
As ferramentas de avaliação por IA pontuam o trabalho dos candidatos com base em uma rubrica construída a partir de rótulos de treinamento, critérios estruturados ou uma descrição de cargo inserida no sistema. Algumas plataformas de avaliação por IA oferecem recursos que criam avaliações e estruturas de pontuação específicas para funções a partir de descrições de cargos em minutos, e depois geram resumos do desempenho de cada candidato para que os recrutadores possam revisar os resultados sem precisar ler cada envio linha por linha. A vantagem é o volume processado: um sistema como este pode avaliar centenas de amostras de código ou respostas escritas no tempo em que um único especialista no assunto revisaria alguns poucos.
A avaliação humana funciona de forma diferente. Um especialista no assunto aplica uma rubrica usando julgamento, contexto e experiência, o que é valioso para captar nuances, mas caro para escalar. Dois fatores a tornam mais lenta em todas as situações: o custo por candidato e a variabilidade entre avaliadores, ou seja, dois revisores qualificados podem pontuar a mesma resposta de forma diferente dependendo do humor, da fadiga ou da interpretação da rubrica.
A maioria dos empregadores opta por um modelo híbrido em vez de escolher apenas um lado. Os padrões mais comuns incluem:
- IA em primeiro lugar com verificações humanas pontuais: a IA avalia todos os envios, e um recrutador revisa uma amostra ou qualquer pontuação limítrofe.
- Humano em primeiro lugar para tarefas complexas: perguntas abertas ou que exigem julgamento vão diretamente para uma pessoa, enquanto tarefas estruturadas (testes de programação, problemas matemáticos, lógica de múltipla escolha) vão para a IA.
- Síntese mecânica: as avaliações de avaliadores humanos e as pontuações algorítmicas são combinadas em um único resultado, um método que demonstrou preservar a precisão preditiva ao mesmo tempo que melhora a adesão dos gestores de contratação que desejam uma verificação humana do processo.
Pontos Fortes e Limitações: Precisão, Velocidade, Consistência e Viés
Uma comparação revisada por pares entre a avaliação por IA e especialistas humanos no recrutamento de TI não encontrou diferença significativa nas pontuações médias entre os dois. A IA avaliou muito mais rápido, mas o estudo também encontrou algo menos lisonjeiro para ambos os lados: nenhum era totalmente consistente. A IA produziu pontuações variadas quando solicitada a reavaliar o mesmo envio, e os revisores humanos demonstraram a mesma inconsistência entre avaliadores que tem sido documentada na pesquisa sobre contratação há décadas.
Onde cada abordagem tende a se destacar:
- A IA vence em velocidade bruta e consistência em grandes grupos de candidatos quando a tarefa é estruturada (testes de código, conjuntos de problemas padronizados).
- Os humanos vencem no contexto: reconhecer uma resposta não convencional, mas válida, aplicar adaptações ou perceber um candidato que resolveu o problema de uma maneira diferente, porém igualmente correta.
- Nenhum vence de forma absoluta em repetibilidade. Tanto os avaliadores por IA quanto os humanos podem produzir pontuações diferentes para o mesmo trabalho em uma segunda análise.
Verificação de consistência: o mesmo estudo que constatou que a IA igualou as pontuações médias humanas também verificou que tanto a avaliação por IA quanto a humana apresentaram inconsistência mensurável na reavaliação de envios idênticos, razão pela qual uma única rodada de avaliação de qualquer uma das fontes é uma base arriscada para uma decisão final de contratação.
O viés merece uma análise própria, porque "tendencioso" é usado de forma imprecisa. O SIOP o separa em dois conceitos distintos e testáveis: viés de mensuração, em que um teste tem desempenho diferente para grupos distintos apesar de habilidades subjacentes iguais, e viés preditivo, em que uma pontuação de teste prediz o desempenho no trabalho de forma diferente entre grupos. Tratar esses dois conceitos como um único problema vago é a forma como os empregadores perdem riscos reais. Um modo de falha comum é o vazamento de alvo, em que um modelo treina em uma variável substituta que se correlaciona com uma característica protegida em vez da própria habilidade. A ausência de adaptações para candidatos com deficiências é outro exemplo: uma rubrica de IA criada sem considerar as normas de acessibilidade pode penalizar uma abordagem alternativa legítima que um avaliador humano reconheceria imediatamente.
Validação, Testes e Governança que as Equipes de RH Devem Executar
Implantar uma ferramenta de avaliação por IA sem um plano de testes é a forma como os empregadores acabam tendo que defender uma ação judicial em vez de uma decisão de contratação. A abordagem TEVV-Athlon do NIST oferece uma estrutura prática para isso, construída em torno de quatro etapas:
- Definir objetivos. Decida exatamente o que a ferramenta de avaliação precisa medir e como é o "bom desempenho" para a função.
- Validação de construto. Confirme que o teste realmente mede a habilidade que afirma medir, e não um substituto vagamente relacionado.
- Testes de usuário e em campo. Execute a ferramenta com envios reais de candidatos, incluindo tentativas de red-teaming para encontrar onde ela falha ou pontua de forma injusta.
- Sintetizar os resultados. Combine tudo em um julgamento documentado sobre se a ferramenta está pronta para uso em produção.
Uma lista de verificação de auditoria que vale a pena executar antes do lançamento e de forma recorrente depois deve incluir verificações de validade de construto e prática, testes de impacto adverso entre grupos demográficos, documentação de fontes de rótulos e design de rubricas, tamanhos de amostra adequados antes de tirar conclusões e um cronograma de monitoramento fixo em vez de uma revisão única. A orientação sobre testes de impacto adverso integrada da Talent Approved explica como executar esse tipo de verificação sem precisar de formação em estatística.
A etapa mais negligenciada é a integração de feedback: conectar as pontuações pré-contratação ao que realmente acontece após a contratação. Comparar as pontuações das avaliações com os dados de retenção e desempenho transforma um teste de triagem em um instrumento genuinamente preditivo, em vez de um filtro que você espera que esteja funcionando.
Dica Profissional: Execute o seu primeiro ciclo de validação em uma função para a qual você já contrata com frequência. Você terá dados históricos de desempenho suficientes para verificar se a pontuação da avaliação realmente previu algo, em vez de adivinhar.
Lista de Verificação de Implementação: Regras de Decisão e Métricas
Nem todo teste pertence ao mesmo grupo. Uma regra de decisão funcional tem a seguinte aparência:
- Use avaliação somente por IA ou com IA em primeiro lugar para testes de programação estruturados, conjuntos de problemas padronizados e triagem inicial de alto volume.
- Exija revisão humana para respostas de texto livre ambíguas, avaliação de portfólio e qualquer decisão de estágio final que afete uma proposta de emprego.
- Adote por padrão a pontuação híbrida sempre que a função for de alto impacto, mas o formato do teste ainda for estruturado o suficiente para que a IA realize uma primeira análise.
Uma vez definidas as regras, rastreie-as com métricas reais em vez de intuição:
- Concordância entre avaliadores — kappa de Cohen para comparações com dois avaliadores, ou kappa de Fleiss quando há mais avaliadores envolvidos, aplicado tanto nas comparações IA versus humano quanto humano versus humano.
- Distribuições de pontuação por subgrupo — regularmente discriminadas por categoria demográfica para identificar viés de mensuração precocemente.
- Correlações de validade preditiva — quão bem as pontuações pré-contratação rastreiam de fato o desempenho pós-contratação.
- Tempo de processamento e taxa de erros — quanto tempo leva a avaliação e com que frequência os resultados precisam de correção manual.
Os controles operacionais são tão importantes quanto as próprias métricas: notifique os candidatos onde a lei estadual exige, crie um caminho de escalada para pontuações discrepantes, documente todas as auditorias para revisão de conformidade e defina um gatilho fixo de retreinamento em vez de esperar que uma reclamação force a questão. A pontuação de avaliação instantânea da Talent Approved é construída com esse tipo de rubrica transparente e auditável em mente.
Impacto da Avaliação por IA na Qualidade do Feedback para Candidatos
A avaliação mais rápida muda o que os candidatos experienciam, não apenas o que os recrutadores veem. Um candidato que termina um teste de habilidades e recebe um resultado em horas em vez de duas semanas permanece engajado com o seu processo em vez de aceitar uma oferta concorrente. Os resumos gerados por IA podem fornecer aos recrutadores uma análise legível dos pontos fortes e lacunas de cada candidato quase imediatamente após o envio, o que encurta o intervalo entre a avaliação e os próximos passos.
A qualidade do feedback é uma questão separada da velocidade do feedback, porém, e é aí que a IA ainda tem limitações reais. Um resumo gerado pode sinalizar que o código de um candidato falhou em determinados casos de teste ou que uma resposta escrita perdeu critérios-chave da rubrica. Mas ela tem dificuldade em explicar o "porquê" com a mesma profundidade que um revisor humano habilidoso traz, especialmente para tarefas criativas ou que exigem julgamento, onde a resposta certa não é única.
A solução prática com que a maioria dos fluxos de trabalho híbridos chega é o feedback em camadas: a IA gera o resumo da primeira análise imediatamente, e um recrutador ou gestor de contratação adiciona contexto antes que ele chegue a um candidato ou comitê de contratação. Isso mantém a vantagem de velocidade da avaliação automatizada sem perder a nuance interpretativa que uma pessoa acrescenta. Também protege contra um risco mais sutil: candidatos que confiam em um resumo de IA como mais autoritativo do que realmente é, simplesmente porque chegou rapidamente e parece organizado.
De Testes em Papel à Pontuação por IA: Uma Breve História
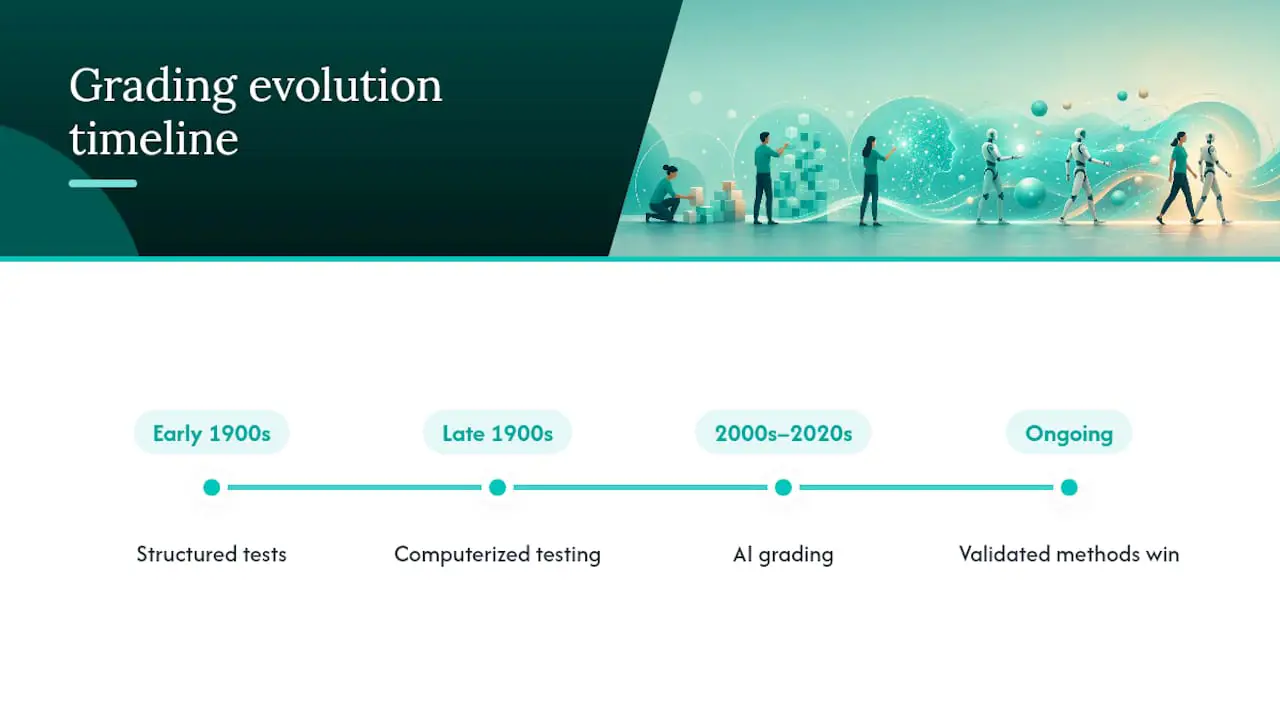
Avaliar candidatos não começou com software. A avaliação estruturada no processo seletivo remonta à psicologia de pessoal do início do século XX, quando os empregadores tentaram pela primeira vez padronizar os testes para reduzir a dependência de intuição e indicações pessoais. Décadas de pesquisa desde então mostram consistentemente que métodos estruturados e relevantes para o trabalho — especialmente amostras de trabalho e entrevistas estruturadas — produzem o vínculo mais forte com o desempenho real no trabalho, superando em muito as entrevistas não estruturadas ou a triagem de currículos isoladamente.
A próxima grande mudança veio com os testes computadorizados no final do século XX, o que permitiu aos empregadores padronizar a pontuação e reduzir alguma inconsistência entre avaliadores para avaliações de múltipla escolha e numéricas. Mas tarefas abertas — amostras de escrita, revisão de código, respostas a cenários — ainda precisavam de um humano para lê-las e julgá-las, o que mantinha a avaliação lenta e cara em escala.
A avaliação por IA é o próximo passo nessa mesma trajetória, não uma ruptura com ela. O que mudou é a capacidade de aplicar uma rubrica consistente a respostas não estruturadas (respostas escritas, código, até mesmo vídeo) em uma velocidade que nenhum painel humano consegue igualar. A pesquisa sobre combinação de métodos de seleção que antecede a IA moderna por décadas ainda mantém a lição subjacente: testes validados e relevantes para o trabalho superam o julgamento informal, seja o avaliador uma pessoa ou um modelo. A IA não inventou esse princípio. Ela apenas tornou a sua aplicação em escala finalmente prática.
Considerações Éticas Específicas sobre IA versus Avaliação Humana
As questões éticas em torno da avaliação por IA não são realmente sobre se uma máquina "entende" a justiça. São sobre se os humanos que a implantam incorporaram responsabilidade suficiente no processo. Três questões surgem repetidamente.
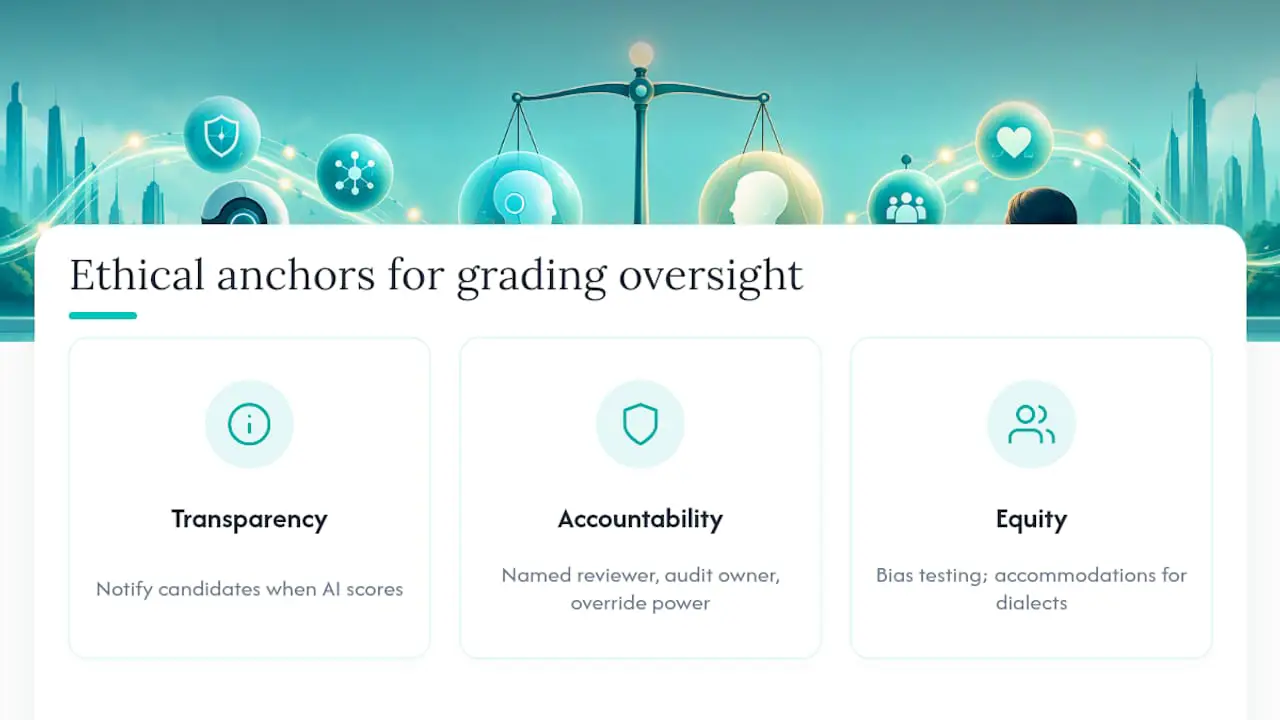
Transparência. Os candidatos merecem saber quando a IA está envolvida na avaliação do seu trabalho, e um número crescente de leis estaduais exige exatamente esse tipo de notificação. Os empregadores que enterram isso nas letras miúdas estão criando exposição legal, não apenas um problema ético.
Responsabilização por erros. Quando um avaliador humano comete um erro, há uma pessoa para quem escalar o problema. Quando um sistema de IA avalia mal uma resposta, a cadeia de responsabilização precisa ser igualmente clara: quem revisa os valores discrepantes, quem é responsável pela auditoria e quem tem autoridade para substituir uma pontuação.
Equidade entre candidatos. Um sistema de avaliação treinado sem atenção às adaptações, variações dialetais em respostas escritas ou abordagens não tradicionais de resolução de problemas pode prejudicar silenciosamente candidatos qualificados sem que ninguém perceba até que uma auditoria de impacto adverso identifique o problema. Os avaliadores humanos carregam sua própria versão desse risco por meio de viés inconsciente, o que é exatamente a razão pela qual o SIOP trata o teste de viés como um requisito técnico para qualquer método de avaliação, não uma verificação ética pontual.
Nada disso é um argumento contra o uso de IA. É um argumento para tratar a avaliação — de qualquer tipo — como um sistema que precisa de supervisão, não como uma ferramenta que você implanta e esquece.
Por Que os Resultados da Avaliação por IA São Mais Difíceis de Interpretar
Um avaliador humano geralmente consegue explicar uma pontuação em uma frase: "a solução do candidato funcionou, mas usou uma abordagem ineficiente." Uma pontuação gerada por IA é muitas vezes mais difícil de descompactar, especialmente quando o modelo subjacente pondera dezenas de sinais que um recrutador nunca vê diretamente.
Isso cria um problema de interpretação específico: uma pontuação sem uma justificativa clara é difícil de defender se um candidato a questionar ou se um regulador perguntar como uma decisão foi tomada. Também é mais difícil saber se uma pontuação baixa reflete uma lacuna de habilidade genuína ou uma peculiaridade na forma como o candidato formulou uma resposta.
A resposta prática não é desconfiar de cada pontuação de IA. É exigir explicabilidade como um recurso básico, não como um recurso secundário. Um resumo útil gerado por IA deve mostrar quais critérios específicos um candidato atendeu ou não, não apenas um único número composto. Esse nível de detalhe permite que um recrutador faça uma verificação cruzada do raciocínio da IA da mesma forma que faria uma verificação de sanidade nas notas de um revisor humano, e transforma uma pontuação opaca em algo que um gestor de contratação pode realmente defender em uma decisão final.
Avaliação por IA em Diferentes Funções e Tipos de Habilidades
A avaliação por IA não é uma ferramenta única aplicada uniformemente. O quão bem ela funciona varia dependendo do que está sendo testado.
Avaliações técnicas e de programação são onde a avaliação por IA tem o desempenho mais confiável. Os casos de teste passam ou falham, o tempo de execução é mensurável e as métricas de qualidade do código podem ser pontuadas com base em critérios claros — que é exatamente o ambiente estruturado que o estudo de recrutamento de TI mediu quando constatou que a IA igualou as pontuações médias humanas em velocidade muito maior.
Testes de conhecimento estruturados, questionários de conformidade, testes de aptidão, testes de julgamento situacional com respostas corretas definidas, são quase tão adequados, uma vez que a lógica de pontuação dificilmente difere de um exame de múltipla escolha bem elaborado.
Tarefas de resposta escrita e comunicação ficam no meio. A IA pode sinalizar gramática, estrutura e se uma resposta abordou o tema proposto, mas julgar tom, poder de persuasão ou resolução criativa de problemas ainda se beneficia de uma segunda análise humana.
Tarefas de vendas, atendimento ao cliente e funções interpessoais dependem mais do humano por enquanto. Essas funções dependem de ler pistas emocionais e se adaptar durante uma conversa, um território onde uma rubrica tem dificuldade em capturar o que realmente prevê o sucesso no trabalho.
A orientação de design de testes específicos para funções da Talent Approved é construída em torno da correspondência do formato da avaliação com a habilidade sendo testada, que é a alavanca real para decidir quanto peso colocar na pontuação por IA para qualquer função específica.
Um Caminho Pragmático para a Avaliação Humana e por IA Trabalharem Juntas
Pule o debate de tudo ou nada. Execute um piloto em uma função, combine pontuações de IA com julgamento humano por meio de síntese mecânica em vez de escolher uma delas, e audite uma pequena amostra antes de escalar para qualquer coisa de alto impacto. Os recursos da plataforma que dão suporte a isso — geração de rubricas estruturadas, monitoramento antifraude, resumos gerados por IA — existem para tornar a etapa de revisão humana mais rápida, não para substituí-la. Rastreie o desempenho pós-contratação em relação às pontuações pré-contratação e ajuste a rubrica quando os dados indicarem, não antes.
— Jimmie
Pronto para Testar a Avaliação Assistida por IA? Comece Aqui
A Talent Approved é construída exatamente para o modelo híbrido que este artigo recomenda: a IA faz o trabalho pesado na pontuação, e você mantém a decisão final. O Magic Create transforma uma descrição de cargo em uma avaliação específica para a função em minutos, o monitoramento antifraude integrado (verificações de tela e webcam, repetições de sessão) protege a integridade do que você está avaliando, e os resumos gerados por IA fornecem uma análise legível por candidato em vez de um número bruto. O preço funciona em um modelo de pagamento conforme o uso a $5 por avaliação de candidato concluída, sem necessidade de assinatura.
Se você estiver pronto para testar isso adequadamente, execute um piloto de 30 a 90 dias: escolha uma função, gere a avaliação com o Magic Create, pontue cada envio com o resumo de IA e um revisor humano em paralelo, execute uma verificação de impacto adverso nos resultados e compare as contratações do piloto com os dados de desempenho assim que estiverem no trabalho. Verifique a página de preços para dimensionar seu piloto antes de se comprometer com uma implantação completa.
Fontes
Antes de implementar a avaliação por IA em escala, revise as orientações de validação do SIOP, o framework TEVV-Athlon do NIST e o estudo de recrutamento de TI que compara a avaliação por IA e humana. Para obrigações legais em evolução, o resumo da K&L Gates sobre as mudanças nas orientações federais vale a leitura.
- ChatGPT versus especialização humana no contexto do recrutamento de TI
- Considerações e Recomendações para a Validação e Uso de Avaliações Baseadas em IA para Seleção de Funcionários (SIOP)
- Relatório piloto NIST ARIA 0.1
- A validade e utilidade dos métodos de seleção em psicologia de pessoal
Perguntas Frequentes
A IA Pode Substituir Completamente os Avaliadores Humanos?
Não. A pesquisa que compara a avaliação por IA e humana no recrutamento de TI encontrou precisão média semelhante, mas velocidade maior da IA, enquanto ambas apresentaram inconsistência na pontuação repetida. A revisão humana ainda importa para tarefas ambíguas e decisões de estágio final.
A Avaliação por IA É Juridicamente Defensável para Decisões de Contratação?
Pode ser, se você validar a ferramenta e documentar o processo. O SIOP recomenda validação psicométrica formal, e vários estados agora exigem notificação ou consentimento do candidato quando a IA é usada na pontuação.
Quanto Custa a Talent Approved?
A Talent Approved cobra $5 por avaliação de candidato concluída em um modelo de pagamento conforme o uso, sem necessidade de assinatura.
Qual é a Diferença Entre Viés de Mensuração e Viés Preditivo?
Viés de mensuração significa que um teste pontua de forma diferente entre grupos apesar de habilidades subjacentes iguais. Viés preditivo significa que a pontuação prevê o desempenho no trabalho de forma diferente por grupo. O SIOP trata esses como questões separadas e testáveis, não como um problema geral de justiça.
Quais Testes de Habilidades São os Mais Seguros para Avaliar Somente com IA?
Testes estruturados com pontuação objetiva — desafios de programação, questionários de conhecimento padronizados e testes de julgamento situacional com respostas corretas definidas — são os mais adequados para avaliação somente por IA. Respostas escritas abertas e avaliações de funções interpessoais ainda se beneficiam da revisão humana.
Recomendado
- Construa Rubricas de Pontuação de Avaliação que Educadores Podem Testar e Escalar com IA
- Guia de RH dos EUA para Testes de Impacto Adverso: Execute, Leia, Corrija
- Piloto de $5 da Talent Approved: Pontuações de Benchmarking de Candidatos para RH
- O Papel da IA na Triagem de Candidatos em Massa: Guia 2026