
Réduire le bruit : 9 étapes pour les évaluateurs sur la validité et la fiabilité des tests
La validité demande si un score signifie ce que vous voulez qu'il signifie. La fidélité demande si ce score réapparaîtrait si vous mesuriez la même personne demain. Les deux sont liées mais non interchangeables : la fidélité est nécessaire mais non suffisante pour la validité, car un test peut produire des scores admirablement cohérents qui mesurent quelque chose d'entièrement erroné. Ce qui suit décompose les types de preuves, les statistiques utilisées pour estimer chacune d'elles, ainsi que les étapes pratiques pour construire une évaluation qui résiste à l'examen des deux.
En résumé :
- Une fidélité élevée est avant tout essentielle, car des scores incohérents ne peuvent pas soutenir une évaluation valide, en particulier lorsqu'on mesure des traits qui devraient rester stables dans le temps.
- La validité dépend de la capacité des scores du test à prédire avec précision le résultat visé ; le contenu, la structure interne, les relations aux variables, les processus de réponse et les conséquences constituent les principales sources de preuves.
- Rassembler de solides preuves de validité exige de définir un objectif clair, de construire un plan de contenu, de mener un pilote auprès d'échantillons représentatifs et d'analyser les relations entre construits et critères.
- La plupart des problèmes d'évaluation proviennent d'un bruit de mesure faible, qui peut être corrigé par une conception ciblée des items et une administration standardisée, et non par une simple révision du contenu.
- L'utilisation de la génération d'items spécifiques au rôle et d'outils anti-triche intégrés simplifie la validation en fournissant des preuves continues sans travail manuel excessif, en particulier pour les évaluations basées sur le rôle.
Table des matières
- Comprendre la validité d'un test : ce que cela signifie réellement
- Comprendre la fidélité d'un test : la cohérence avant la précision
- Fidélité test-retest, cohérence interne et fidélité inter-juges expliquées
- Fidèle mais erroné, ou valide mais bruité : la confusion dissipée
- Un plan étape par étape pour rassembler des preuves de validité et de fidélité
- Une liste de contrôle pratique pour des évaluations plus solides
- Comment les plateformes d'évaluation documentent la validité en pratique
- Ce que la recherche vous dit réellement de prioriser
- Construire des évaluations validées sans la piste de preuves manuelle
- Sources
- FAQ
Comprendre la validité d'un test : ce que cela signifie réellement
La validité n'est pas une propriété qu'un test porte comme une étiquette de certification. C'est un argument, construit à partir de preuves, quant à savoir si les interprétations des scores soutiennent un usage intentionnel spécifique. Une évaluation en programmation peut être très valide pour prédire les performances en débogage sur le terrain et totalement invalide pour prédire le potentiel de leadership, même s'il s'agit exactement du même test. Le score n'a pas changé. Ce que vous affirmez à propos du score, si.
C'est là que naissent beaucoup de confusions. Les gens demandent « ce test est-il valide ? » comme si la validité était binaire, mais les Standards for Educational and Psychological Testing la conçoivent comme un argument de validité unifié, construit à partir de cinq sources de preuves plutôt qu'une liste de contrôle de « types » séparés. Ces cinq sources sont :
- Les preuves de contenu — les items du test représentent-ils réellement le domaine ou la compétence en question ?
- Les preuves de structure interne — les items regroupés statistiquement correspondent-ils aux construits qu'ils sont censés mesurer ?
- Les relations avec d'autres variables — le score se corrèle-t-il avec des mesures externes de la manière que la théorie prédit (ce qui couvre ce que les anciens manuels appelaient la validité convergente, discriminante et de critère) ?
- Les preuves des processus de réponse — les candidats mobilisent-ils réellement la compétence que vous avez l'intention de mesurer, ou jouent-ils avec le format ?
- Les preuves de conséquences — l'utilisation du test produit-elle des résultats équitables et intentionnels, ou des préjudices non intentionnels pour des groupes spécifiques ?
L'objectif détermine les preuves dont vous avez le plus besoin. Un test de programmation avant embauche s'appuie fortement sur les preuves de contenu et de critère. Un inventaire de personnalité utilisé pour le placement en équipe s'appuie sur les preuves de structure interne et de relations. La validité repose en définitive sur la capacité du test à prédire le résultat qu'il prétend prédire, et non sur le fait que les items semblent soignés.
Comprendre la fidélité d'un test : la cohérence avant la précision
La fidélité mesure si un test produit le même résultat dans les mêmes conditions, de manière répétée. Elle n'a rien à voir avec l'exactitude du résultat. Une balance de cuisine qui affiche 400 grammes à chaque fois que vous y posez un poids d'une livre est parfaitement fidèle et constamment fausse de près de 50 grammes.
La fidélité est la cohérence et la reproductibilité d'une mesure, indiquant à quel point les résultats sont fiables lors d'essais répétés, tandis que la validité est la question distincte de l'exactitude et du sens. Chaque mesure contient une certaine quantité d'erreur — un bruit aléatoire dû à la fatigue, la distraction, une formulation ambiguë ou un correcteur incohérent — qui éloigne un score observé du « vrai » score d'une personne. La fidélité est en réalité une estimation de la quantité de ce bruit.
- Une faible fidélité signifie que les scores varient de manière imprévisible entre les tentatives, les sessions ou les évaluateurs.
- Une fidélité élevée signifie que les scores restent stables lorsque rien de significatif n'a changé chez la personne.
- La fidélité fixe un plafond à la validité : une mesure très bruitée ne peut pas se corréler fortement avec quoi que ce soit, y compris le résultat qu'elle est censée prédire.
Ce dernier point mérite d'être souligné, car c'est le lien mécanique entre les deux concepts. Une faible fidélité dans l'une ou l'autre des mesures plafonne la corrélation observable maximale entre elles, un effet appelé atténuation. Trois formes courantes de fidélité — test-retest, cohérence interne et accord inter-juges — capturent chacune une source différente de ce bruit.
Fidélité test-retest, cohérence interne et fidélité inter-juges expliquées
La fidélité test-retest mesure la stabilité dans le temps. Vous administrez le même test aux mêmes personnes deux fois, généralement à deux à quatre semaines d'intervalle, et vous corrèlez les deux ensembles de scores. Elle convient aux traits stables, comme l'aptitude cognitive générale ou les dimensions de la personnalité, mais est mal adaptée aux construits censés évoluer rapidement, comme l'humeur ou le stress à court terme.
La cohérence interne mesure si les items d'un même test concordent entre eux, généralement via l'alpha de Cronbach. C'est la vérification de fidélité la plus rapide à effectuer car elle ne nécessite qu'une seule passation, ce qui explique pourquoi elle est surexploitée. L'alpha est sensible au nombre d'items d'un test, de sorte qu'un test long peut produire un alpha gonflé même lorsque les items individuels sont médiocres. Les coefficients oméga gèrent mieux cela pour les tests dont la qualité des items est inégale, bien que l'alpha reste la norme du secteur.
La fidélité inter-juges est importante lorsqu'un être humain évalue quelque chose de subjectif : un échantillon de rédaction, un entretien structuré, une tâche sur vidéo. Le kappa de Cohen ou un coefficient de corrélation intraclasse (ICC) quantifie l'accord entre les évaluateurs, en corrigeant l'accord attendu par le seul hasard.
Conseil pro : Une corrélation test-retest à un niveau raisonnablement élevé (souvent proche de +0,80 ou plus) est généralement considérée comme un repère pratique pour les traits stables. Tout résultat significativement inférieur sur un trait qui ne devrait pas varier d'une semaine à l'autre signale un problème de conception qui mérite d'être examiné avant de construire le moindre argument de validité par-dessus.
Le contexte détermine quelle forme est la plus importante. Un test de compétences noté automatiquement nécessite une forte cohérence interne mais aucune vérification inter-juges. Un entretien structuré nécessite un accord inter-juges au-dessus de presque tout le reste.
Fidèle mais erroné, ou valide mais bruité : la confusion dissipée
La façon la plus claire de voir la différence entre la validité et la fidélité d'un test est à travers deux modes de défaillance qui ne se ressemblent pas mais ruinent tous les deux une évaluation.
- Fidèle mais invalide : un thermomètre biaisé qui affiche toujours deux degrés de trop. Il est parfaitement cohérent, ce qui le rend fidèle, mais chaque lecture est fausse, ce qui le rend invalide.
- Valide mais peu fidèle : un test de compétences avec seulement trois items couvrant une large compétence. En moyenne, sur de nombreux candidats, il pourrait se corréler raisonnablement avec les performances professionnelles, mais le score d'une personne en particulier varie trop entre les tentatives pour être fiable individuellement.
Ces exemples répondent aux deux questions que les gens recherchent le plus. Lequel vient en premier ? La fidélité, fonctionnellement, parce que vous ne pouvez pas construire un argument de validité défendable sur des scores incohérents. Un test peut-il être fidèle sans être valide ? Oui, facilement, et cela arrive constamment avec des tests qui sont cohérents en interne mais mesurent simplement le mauvais construit pour l'usage prévu.
Si votre fidélité est solide mais que les preuves de validité sont minces, la solution réside généralement dans le contenu : faites appel à des experts en la matière et vérifiez si les items représentent réellement le poste ou le trait. Si la fidélité elle-même est faible, aucune quantité de preuves de validité ne sauvera le test. Vous devez d'abord corriger le bruit de mesure — généralement en ajoutant des items bien ciblés ou en resserrant les règles de notation — avant même que la question de validité ne soit répondable.
Un plan étape par étape pour rassembler des preuves de validité et de fidélité
Construire un argument de validité défendable est une séquence, pas une étude unique. Voici l'ordre qui produit des preuves derrière lesquelles vous pouvez réellement vous tenir.
- Définissez l'usage prévu en une phrase. « Cette évaluation prédit les performances des 90 premiers jours pour un rôle de support client » est suffisamment précis pour guider toutes les décisions qui suivent.
- Construisez un plan de contenu. Listez les compétences ou domaines de connaissances requis par l'usage prévu, pondérés par importance, avant d'écrire un seul item.
- Effectuez un examen du contenu par des experts. Demandez à deux ou trois experts en la matière d'évaluer indépendamment si chaque item correspond au plan et de signaler tout ce qui est hors sujet.
- Pilotez le test sur un échantillon représentatif. Même 40 à 80 réponses révèlent des problèmes au niveau des items : formulation confuse, effets plafond, items que personne ne rate.
- Effectuez une analyse de la structure interne. Utilisez une analyse factorielle exploratoire ou confirmatoire pour vérifier si les items se regroupent comme votre plan le prédit, et calculez l'alpha ou l'oméga de Cronbach pour chaque sous-échelle.
- Vérifiez les relations convergentes et discriminantes. Corrélez les scores avec une mesure établie du même construit et avec une mesure non liée pour confirmer que le test mesure ce qu'il prétend mesurer.
- Collectez des données de critère lorsque c'est possible. Suivez les résultats réels — évaluations des performances professionnelles, taux de promotion, taux d'erreur — et corrélez-les avec les scores d'origine.
- Rapportez la taille de l'échantillon, le contexte et les intervalles de confiance. Un coefficient de fidélité basé sur 30 personnes dans un bureau signifie quelque chose de différent d'un basé sur 2 000 personnes dans cinq pays.
- Documentez l'ensemble de l'argument. Notez quelles preuves ont été rassemblées, pourquoi, et comment elles soutiennent l'usage prévu spécifique défini à l'étape une.
Conseil pro : Sautez l'étape une et tout ce qui suit devient plus difficile à défendre par la suite. Les réviseurs, les auditeurs et même votre propre équipe continueront à demander « valide pour quoi ? » si l'usage prévu n'a jamais été consigné par écrit dès le départ.
Les équipes qui construisent des tests de sélection spécifiques au poste passent souvent directement au pilotage en sautant l'étape du plan de contenu, ce qui est exactement l'inverse de ce qu'il faut faire. Le plan de contenu est ce qui rend chaque étape ultérieure interprétable.
Une liste de contrôle pratique pour des évaluations plus solides
La plupart des problèmes de validité et de fidélité sont liés à une poignée de choix de conception corrigeables. Avant de lancer ou de réviser une évaluation, vérifiez les points suivants :
- Chaque item doit correspondre à une ligne spécifique de votre plan de contenu ; supprimez tout ce qui ne justifie pas sa place.
- Un plus grand nombre d'items bien ciblés l'emporte généralement sur un nombre moindre d'items larges, car des items supplémentaires réduisent le bruit de mesure et améliorent la cohérence interne.
- Standardisez les conditions d'administration — délais, instructions, environnement — afin que la variation des scores reflète la personne et non le contexte.
- Formez les évaluateurs sur un barème commun et vérifiez l'accord inter-juges avant de vous fier au jugement d'un seul correcteur.
- Pilotez avant le déploiement complet, et traitez la première version comme un brouillon qui nécessitera une révision.
- Collectez des données de critère ou convergentes chaque fois que vous le pouvez, même de manière informelle, et consignez-les avec le reste de vos preuves.
Conseil pro : Les employeurs qui construisent des tests de compétences prêts pour l'audit constatent souvent que le gain de fidélité le plus important vient de la standardisation de la notation, et non de l'ajout de questions. Un barème vague annulera chaque fois l'avantage d'une banque d'items bien construite.
Faire correspondre les items à une fiche de poste réelle plutôt qu'à une étiquette de compétence générique renforce également considérablement les preuves de contenu, car les étiquettes génériques invitent des items génériques à faible pertinence.
Comment les plateformes d'évaluation documentent la validité en pratique
Collecter ces preuves manuellement — des feuilles de calcul de statistiques d'items, des notes séparées des évaluateurs, un dossier de données pilotes — c'est exactement la raison pour laquelle la plupart des équipes s'arrêtent à une révision du contenu et s'en contentent. Une plateforme construite autour de tests structurés et spécifiques au rôle peut compresser ce cycle au lieu de supprimer la rigueur.
Générer des items directement à partir d'une fiche de poste ou d'une liste de compétences vous donne un plan de contenu dès le premier brouillon, plutôt que d'en reconstruire un une fois les items déjà existants. La diffusion aléatoire des items et la surveillance anti-triche — y compris les vérifications d'écran et de webcam — renforcent les preuves des processus de réponse et des conséquences en réduisant la probabilité qu'un score reflète de la triche plutôt qu'une compétence. Les statistiques d'items exportables, les replays de sessions et les résumés de performance transforment ce qui était autrefois un dossier de validation épars en quelque chose qui ressemble davantage à un dossier évolutif.
L'approche de la plateforme traite chaque évaluation complétée comme un point de données dans un argument de validité continu, et non comme une simple décision d'embauche, ce qui distingue un programme de test défendable d'un programme basé sur l'intuition.
Ce que la recherche vous dit réellement de prioriser
Le plus grand écart entre les conseils conventionnels et ce que les preuves soutiennent concerne le séquençage. La plupart des recommandations traitent la validité et la fidélité comme des listes de contrôle parallèles à parcourir une seule fois. Elles ne sont pas parallèles. La fidélité est le socle ; la validité est ce que vous construisez par-dessus, et aucune révision de contenu par des experts ne peut sauver un test dont les scores varient d'une session à l'autre.
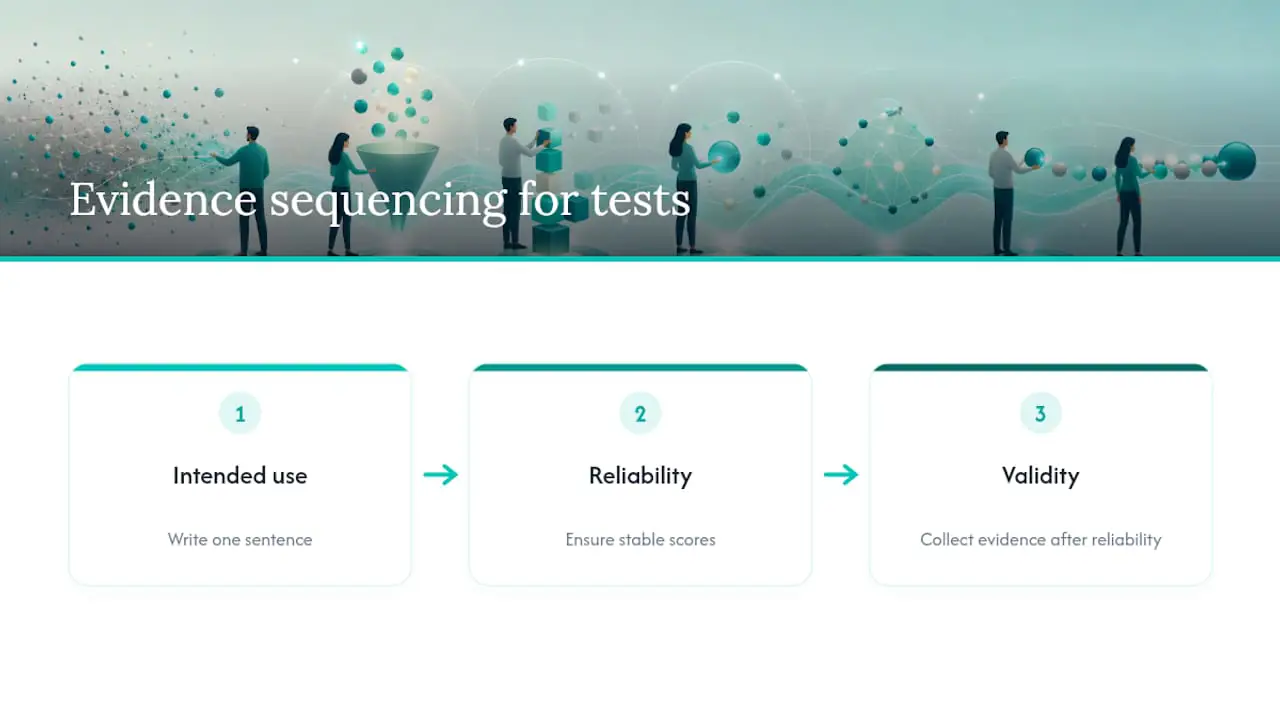
Le deuxième écart est plus inconfortable : les équipes adorent les preuves de contenu parce qu'elles sont bon marché et rapides — trois experts, un après-midi, c'est fait. Les preuves de critère — vérifier réellement si les scores prédisent le résultat que vous affirmez qu'ils prédisent — sont pratiquement ignorées partout en dehors de la recherche académique, parce qu'elles exigent de la patience et des données de résultats que la plupart des équipes de recrutement ne se donnent jamais la peine de collecter.
Si vous ne retenez qu'une seule chose, retenez ceci : notez votre usage prévu en une seule phrase avant d'écrire un seul item. Tout le reste — le plan, les statistiques, la formation des évaluateurs — ne fonctionne que si cette phrase est précise. Un usage prévu vague produit des preuves vagues, quelle que soit la sophistication de l'analyse factorielle.
— Jimmie
Construire des évaluations validées sans la piste de preuves manuelle
Documenter un argument de validité manuellement — suivre les statistiques des items dans une feuille de calcul, les notes des évaluateurs dans une autre, les données pilotes ailleurs — c'est exactement le type de travail qui se retrouve silencieusement négligé sous la pression des délais. Un outil génère des items spécifiques au rôle directement à partir d'une fiche de poste, vous offrant un plan de contenu avant même d'avoir rédigé une seule question, tandis que la surveillance anti-triche intégrée et les replays de sessions ajoutent les preuves des processus de réponse que la plupart des équipes ne collectent jamais.
Il n'y a pas d'abonnement à contracter. Vous payez par candidat complété, de sorte que le coût s'adapte au recrutement que vous effectuez réellement, et non à une licence forfaitaire. Si vous évaluez des compétences pour un rôle spécifique et souhaitez que les preuves de fidélité et de validité soient intégrées dans le processus plutôt qu'assemblées après coup, découvrez la plateforme et voyez comment une fiche de poste se transforme en une évaluation testable et défendable en quelques minutes.
Sources
Les manuels classiques enseignent encore la validité de contenu, de construit et de critère comme s'il s'agissait de trois cases séparées à cocher. La psychométrie moderne les traite comme des facettes d'un seul argument, et certains experts s'opposent explicitement à leur isolement parce qu'un test peut sembler correct sur une facette et échouer gravement sur une autre. Voici comment les preuves se décomposent réellement selon le moment et la façon dont vous les collectez :
- Fidélité vs validité dans la recherche
- Introduction à la validité dans les tests éducatifs et psychologiques
- La validité pour les évaluations
- Fidélité et validité de la mesure (LibreTexts)
Distinguer le jugement d'experts préalable aux données des vérifications statistiques postérieures aux données est important car les équipes s'arrêtent souvent à la première étape. Une révision du contenu par trois experts en la matière semble approfondie, mais elle ne dit rien sur la capacité du test à prédire quoi que ce soit de réel.
FAQ
Qu'est-ce qui vient en premier, la validité ou la fidélité ?
La fidélité vient fonctionnellement en premier. Vous ne pouvez pas construire un argument de validité convaincant sur des scores qui ne sont pas cohérents, même si la fidélité seule ne prouve jamais qu'un test est valide.
Un test peut-il être fidèle sans être valide ?
Oui. Un test peut produire des scores très cohérents qui mesurent néanmoins entièrement le mauvais construit — l'exemple classique étant une balance qui affiche toujours le même poids incorrect.
Quelle est la principale différence entre la fidélité et la validité ?
La fidélité demande si une mesure est cohérente ; la validité demande si cette mesure capture réellement ce qu'elle prétend mesurer pour un usage prévu spécifique.
Quels sont des exemples de validité et de fidélité ?
Un thermomètre biaisé qui affiche toujours deux degrés de trop est fidèle mais invalide ; un test de trois items qui prédit les performances professionnelles en moyenne mais qui varie fortement pour les individus est valide mais peu fidèle.
Comment mesure-t-on la fidélité d'un test ?
Les trois méthodes les plus courantes sont les corrélations test-retest, les mesures de cohérence interne comme l'alpha de Cronbach, et les statistiques d'accord inter-juges comme le kappa ou l'ICC, choisies selon que le test est répété, noté par items ou noté par des évaluateurs humains.
Recommandé
- Équipes RH : rendez les tests de compétences prêts pour l'audit, 5 $ par évaluation
- Créer des barèmes de notation d'évaluation que les enseignants peuvent piloter et mettre à l'échelle avec l'IA
- Équipes de recrutement : 5 étapes vers des analyses d'évaluation axées sur la mesure
- Comment les fiches de poste guident les évaluations qui prédisent réellement…