
Fixa mätbrus: 9 steg för bedömare om testvaliditet och reliabilitet
Validitet frågar om ett resultat betyder det du avser att det ska betyda. Reliabilitet frågar om det resultatet skulle dyka upp igen om du mätte samma person imorgon. De två begreppen är relaterade men inte utbytbara: reliabilitet är nödvändigt men inte tillräckligt för validitet, eftersom ett test kan producera underbart konsekventa resultat som mäter helt fel sak. Nedan redogörs för typerna av evidens, de statistiska metoder som används för att uppskatta varje typ, samt de praktiska steg som krävs för att bygga en bedömning som håller under båda kraven.
TL;DR:
- Hög reliabilitet är avgörande i första hand, eftersom inkonsekventa resultat inte kan ligga till grund för en giltig bedömning, särskilt när man mäter egenskaper som bör förbli stabila över tid.
- Validitet beror på om testresultaten korrekt förutsäger det avsedda utfallet, där innehåll, intern struktur, relationer till variabler, responsprocesser och konsekvenser utgör centrala evidenskällor.
- Att samla in stark valideringsbevisning kräver att man definierar ett tydligt syfte, skapar en innehållsplan, pilottestprövar med representativa urval och analyserar konstrukt- och kriterierelationer.
- De flesta bedömningsproblem beror på svagt mätbrus, vilket kan avhjälpas med riktad uppgiftsdesign och standardiserad administration – inte enbart innehållsgranskning.
- Att använda rollspecifik uppgiftsgenerering och inbyggda fuskförebyggande verktyg effektiviserar valideringen och ger löpande evidens utan alltför manuellt arbete, särskilt vid rollbaserade bedömningar.
Innehållsförteckning
- Att förstå testvaliditet: vad det faktiskt innebär
- Att förstå testreliabilitet: konsekvens framför noggrannhet
- Test-retest, intern konsistens och interbedömarreliabilitet förklarade
- Reliabelt men felaktigt, eller giltigt men brusigt: förvirringen klargjord
- En steg-för-steg-plan för att samla in validitets- och reliabilitetsevidens
- En praktisk checklista för starkare bedömningar
- Hur bedömningsplattformar dokumenterar validitet i praktiken
- Vad forskningen faktiskt säger att du bör prioritera
- Bygg validerade bedömningar utan det manuella evidensspåret
- Källor
- Vanliga frågor
Att förstå testvaliditet: vad det faktiskt innebär
Validitet är inte en egenskap som ett test bär med sig som ett certifieringsmärke. Det är ett argument, byggt på evidens, om huruvida resultatstolkningar stöder ett specifikt avsett användningsområde. En kodningsbedömning kan vara mycket valid för att förutsäga felsökningsprestanda på jobbet och helt ogiltig för att förutsäga ledarskapsförmåga – även om det är exakt samma test. Resultatet förändrades inte. Det påstående du gör om resultatet förändrades.
Det är här mycket av förvirringen uppstår. Människor frågar "är detta test giltigt?" som om validitet vore binärt, men Standards for Educational and Psychological Testing beskriver det som ett enhetligt valideringsargument, byggt på fem evidenskällor snarare än en checklista med separata "typer". De fem källorna är:
- Innehållsevidens — representerar testuppgifterna faktiskt det aktuella området eller den aktuella färdigheten?
- Intern strukturevidens — stämmer uppgifter som grupperats statistiskt överens med de konstrukt de är avsedda att mäta?
- Relationer till andra variabler — korrelerar resultatet med externa mått på det sätt som teorin förutsäger (detta täcker vad äldre läroböcker kallade konvergent, diskriminant och kriterievaliditet)?
- Responsprocessevidens — engagerar testdeltagarna faktiskt den färdighet du avser att mäta, eller utnyttjar de formatet?
- Konsekvensevidens — producerar användningen av testet rättvisa, avsedda utfall, eller oavsiktlig skada för specifika grupper?
Syftet avgör vilken evidens du behöver mest. Ett kodningstest för anställning lutar tungt mot innehålls- och kriteriebevisning. Ett personlighetsinventarium som används för teamplacering lutar mot intern struktur och relationsbevisning. Validiteten vilar i slutändan på om testet förutsäger det utfall det påstår sig förutsäga – inte på om uppgifterna ser välpolerade ut.
Att förstå testreliabilitet: konsekvens framför noggrannhet
Reliabilitet mäter om ett test producerar samma resultat under samma förhållanden, upprepade gånger. Det har ingenting att göra med om resultatet är korrekt. En köksvåg som visar 400 gram varje gång du lägger ett 450-gramslod på den är fullständigt reliabel och konsekvent fel med 50 gram.
Reliabilitet är konsekvensen och reproducerbarheten hos en mätning, vilket indikerar hur tillförlitliga resultaten är över upprepade försök, medan validitet är den separata frågan om noggrannhet och mening. Varje mätning innehåller en viss mängd fel – slumpmässigt brus från trötthet, distraktion, tvetydig formulering eller en inkonsekvent bedömare – som skjuter ett observerat resultat bort från en persons "sanna" resultat. Reliabilitet är i grunden en uppskattning av hur mycket av det bruset som existerar.
- Låg reliabilitet innebär att resultat studsar runt oförutsägbart mellan försök, sessioner eller bedömare.
- Hög reliabilitet innebär att resultat förblir stabila när ingenting meningsfullt om personen har förändrats.
- Reliabilitet sätter ett tak för validiteten: ett mycket brusigt mått kan inte korrelera starkt med något, inklusive det utfall det ska förutsäga.
Den sista punkten förtjänar att betonas, eftersom den är den mekaniska länken mellan de två begreppen. Låg reliabilitet i endera mått begränsar den maximalt observerbara korrelationen mellan dem – en effekt kallad attenuation. Tre vanliga former av reliabilitet – test-retest, intern konsistens och interbedömaröverenskommelse – fångar var och en en annan källa till detta brus.
Test-retest, intern konsistens och interbedömarreliabilitet förklarade
Test-retest-reliabilitet mäter stabilitet över tid. Du administrerar samma test till samma personer två gånger, vanligtvis med två till fyra veckors mellanrum, och korrelerar de två uppsättningarna av resultat. Det passar stabila egenskaper, som allmän kognitiv förmåga eller personlighetsdimensioner – dåligt lämpade konstrukt som är avsedda att förändras snabbt, som humör eller kortvarig stress.
Intern konsistens mäter om uppgifterna i ett enda test stämmer överens med varandra, vanligtvis via Cronbachs alfa. Det är den snabbaste reliabilitetskontrollen att genomföra eftersom den bara kräver en enda administration, vilket är anledningen till att den är överanvänd. Alfa är känsligt för antalet uppgifter i ett test, så ett långt test kan producera ett uppblåst alfa även när enskilda uppgifter är mediokra. Omegakoefficienter hanterar detta bättre för test med ojämn uppgiftskvalitet, även om alfa förblir branschstandard.
Interbedömarreliabilitet spelar roll när en människa bedömer något subjektivt – ett skriftligt prov, en strukturerad intervju, en videobaserad uppgift. Cohens kappa eller en intraklasskorrelationskoefficient (ICC) kvantifierar överensstämmelse mellan bedömare och korrigerar för den överensstämmelse man kan förvänta sig av ren slump.
Proffstips: En test-retest-korrelation på en rimligt hög nivå (ofta nära +0,80 eller högre) behandlas vanligtvis som ett praktiskt riktmärke för stabila egenskaper. Något som är meningsfullt lägre än så för en egenskap som inte borde förändras vecka till vecka signalerar ett designproblem som är värt att undersöka innan du bygger något valideringsargument ovanpå det.
Sammanhanget avgör vilken form som spelar störst roll. Ett färdighetstest som poängsätts automatiskt behöver stark intern konsistens men ingen interbedömarkontroll alls. En strukturerad intervju behöver interbedömaröverenskommelse framför nästan allt annat.
Reliabelt men felaktigt, eller giltigt men brusigt: förvirringen klargjord
Det tydligaste sättet att se skillnaden mellan testvaliditet och reliabilitet är genom två typer av misslyckanden som ser helt olika ut men som båda förstör en bedömning.
- Reliabelt men ogiltigt: en partisk termometer som läser två grader för högt varje enda gång. Den är fullständigt konsekvent, vilket gör den reliabel, men varje avläsning är fel, vilket gör den ogiltig.
- Giltigt men opålitligt: ett färdighetstest med bara tre uppgifter som täcker en bred kompetens. I genomsnitt bland många testdeltagare kan det korrelera rimligt med arbetsprestation, men en enskild persons resultat studsar runt för mycket mellan försök för att vara individuellt tillförlitligt.
Dessa exempel svarar på de två frågor som folk söker mest. Vad kommer först? Reliabilitet, funktionellt sett, eftersom du inte kan bygga ett försvarbart valideringsargument ovanpå inkonsekventa resultat. Kan ett test vara reliabelt utan att vara giltigt? Ja, lätt, och det händer hela tiden med test som är internt konsekventa men helt enkelt mäter fel konstrukt för det avsedda användningsområdet.
Om din reliabilitet är stark men valideringsevidensen är tunn, är åtgärden vanligtvis innehållsrelaterad: ta in ämnesexperter och kontrollera om uppgifterna faktiskt representerar jobbet eller egenskapen. Om reliabiliteten i sig är svag, kommer ingen mängd valideringsevidens att rädda testet. Du måste åtgärda mätbruset först – vanligtvis genom att lägga till välriktade uppgifter eller skärpa poängsättningsreglerna – innan valideringsfrågan ens kan besvaras.
En steg-för-steg-plan för att samla in validitets- och reliabilitetsevidens
Att bygga ett försvarbart valideringsargument är en sekvens, inte en enstaka studie. Här är den ordning som producerar evidens du faktiskt kan stå bakom.
- Definiera det avsedda användningsområdet i en mening. "Den här bedömningen förutsäger prestation under de första 90 dagarna för en kundtjänstroll" är specifikt nog för att vägleda varje beslut efter det.
- Bygg en innehållsplan. Lista de färdigheter eller kunskapsområden som det avsedda användningsområdet kräver, viktade efter betydelse, innan du skriver en enda uppgift.
- Genomför en expertgranskning av innehållet. Låt två eller tre ämnesexperter oberoende av varandra bedöma om varje uppgift stämmer överens med planen och markera allt som avviker.
- Pilottesta testet på ett representativt urval. Även 40 till 80 svar avslöjar problem på uppgiftsnivå – förvirrande formuleringar, takeffekter, uppgifter som ingen svarar fel på.
- Kör intern strukturanalys. Använd explorativ eller konfirmatorisk faktoranalys för att kontrollera om uppgifterna klustrar sig på det sätt din plan förutsäger, och beräkna Cronbachs alfa eller omega för varje delskal.
- Kontrollera konvergenta och diskriminanta relationer. Korrelera resultaten mot ett etablerat mått på samma konstrukt och mot ett orelaterat mått för att bekräfta att testet mäter vad det påstår sig mäta.
- Samla in kriteriedata när det är möjligt. Spåra faktiska utfall – arbetsprestatingsbetyg, befordringshastigheter, felfrekvenser – och korrelera dem mot de ursprungliga resultaten.
- Rapportera urvalsstorlek, kontext och konfidensintervall. En reliabilitetskoefficient från 30 personer på ett kontor betyder något annat än en baserad på 2 000 personer i fem länder.
- Dokumentera hela argumentet. Skriv ned vilken evidens som samlades in, varför, och hur den stöder det specifika avsedda användningsområde som definierades i steg ett.
Proffstips: Hoppa över steg ett och allt efterföljande blir svårare att försvara senare. Granskare, revisorer och till och med ditt eget team kommer hela tiden att fråga "giltigt för vad?" om det avsedda användningsområdet aldrig skrevs ned från början.
Team som bygger jobbspecifika screeningtester hoppar ofta direkt till pilottestning och hoppar över plansteget, vilket är precis bakvänt. Planen är det som gör varje senare steg tolkningsbart.
En praktisk checklista för starkare bedömningar
De flesta validitets- och reliabilitetsproblem kan spåras tillbaka till ett fåtal åtgärdbara designval. Innan du lanserar eller reviderar en bedömning, kontrollera dessa:
- Varje uppgift bör kopplas tillbaka till en specifik rad i din innehållsplan; ta bort allt som inte förtjänar sin plats.
- Fler välriktade uppgifter är i allmänhet bättre än färre breda, eftersom ytterligare uppgifter minskar mätbrus och höjer intern konsistens.
- Standardisera administrationsbetingelserna – tidsgränser, instruktioner, miljö – så att variation i resultat speglar personen, inte situationen.
- Utbilda bedömare i ett gemensamt bedömningskriterium och kontrollera interbedömaröverenskommelsen innan du litar på en enskild bedömares omdöme.
- Pilottesta innan fullskalig lansering och behandla den första versionen som ett utkast som behöver revideras.
- Samla in kriteriedata eller konvergent data när du kan, även informellt, och logga det tillsammans med resten av din evidens.
Proffstips: Arbetsgivare som bygger revisionsklara färdighetstester märker ofta att den största reliabilitetsvinsten kommer från standardiserad poängsättning, inte från att lägga till frågor. En vag bedömningsrubrik underminerar nyttan av en välbyggd uppgiftsbank varje gång.
Att koppla uppgifter tillbaka till en faktisk jobbeskrivning snarare än en generisk färdighetsetikett stärker också innehållsevidensen avsevärt, eftersom generiska etiketter inbjuder till generiska, lågvärdiga uppgifter.
Hur bedömningsplattformar dokumenterar validitet i praktiken
Att samla in denna evidens manuellt – kalkylblad med uppgiftsstatistik, separata bedömaranteckningar, en mapp med pilotdata – är precis anledningen till att de flesta team stannar vid en innehållsgranskning och kallar det klart. En plattform byggd kring strukturerad, rollspecifik testning kan komprimera den cykeln istället för att eliminera noggrannheten.
Att generera uppgifter direkt från en jobbeskrivning eller färdighetslista ger dig en innehållsplan redan från det första utkastet, snarare än att konstruera en i efterhand när uppgifterna redan existerar. Slumpmässig uppgiftsleverans och fuskförebyggande övervakning – inklusive skärm- och webbkamerakontroller – stärker responsprocess- och konsekvensevidensen genom att minska chansen att ett resultat speglar fusk snarare än färdighet. Exporterbar uppgiftsstatistik, sessionsreplayar och prestationssammanfattningar förvandlar vad som tidigare var en utspridd valideringsmapp till något som liknar ett löpande register.
Plattformens tillvägagångssätt behandlar varje slutförd bedömning som en datapunkt i ett pågående valideringsargument, inte bara ett anställningsbeslut, vilket är det som skiljer ett försvarbart testprogram från ett som bygger på magkänsla.
Vad forskningen faktiskt säger att du bör prioritera
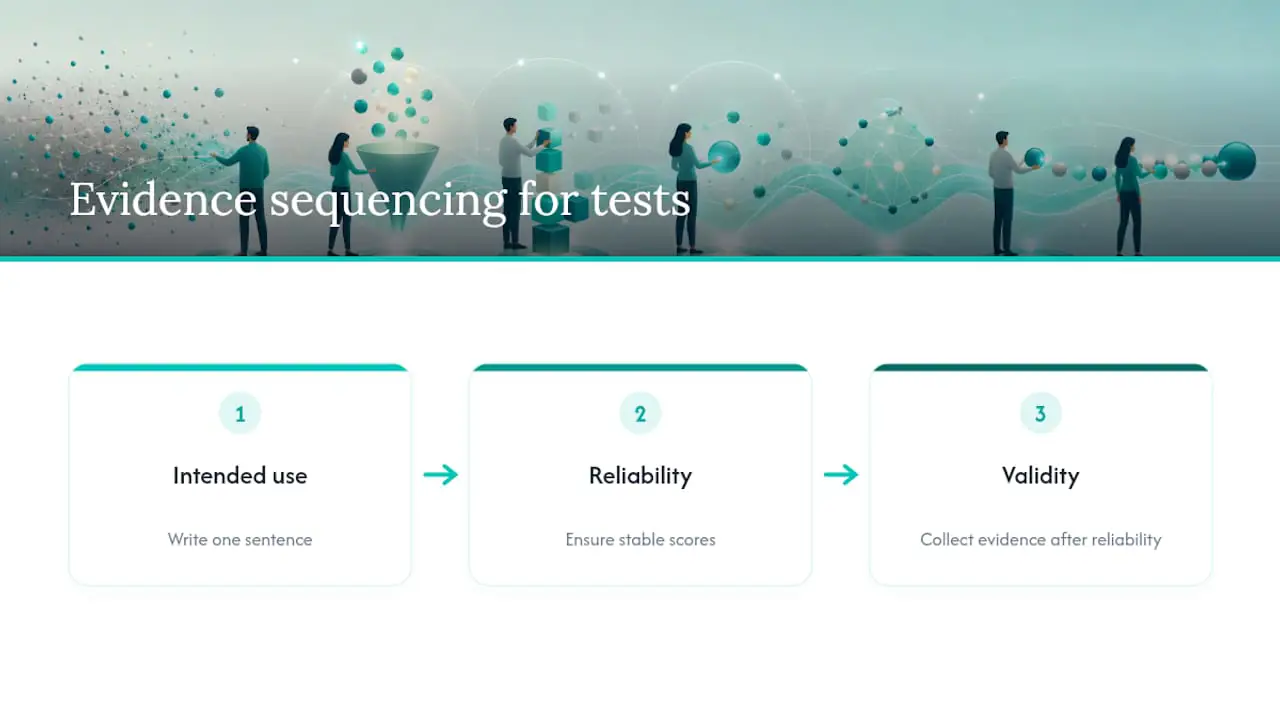
Det största gapet mellan konventionella råd och vad evidensen stöder är sekvensering. De flesta riktlinjer behandlar validitet och reliabilitet som parallella checklistor att gå igenom en gång. De är inte parallella. Reliabilitet är grunden; validitet är vad du bygger ovanpå den, och ingen mängd expertgranskning av innehåll räddar ett test vars resultat studsar runt från en session till nästa.
Det andra gapet är mer obehagligt: team älskar innehållsevidens eftersom den är billig och snabb – tre experter, en eftermiddag, klart. Kriteriebevisning – att faktiskt kontrollera om resultaten förutsäger det utfall du påstår att de förutsäger – hoppas nästan överallt utanför akademisk forskning, eftersom det kräver tålamod och utfallsdata som de flesta rekryteringsteam aldrig bryr sig om att samla in.
Om du tar med dig en sak härifrån, ta med dig detta: skriv ned ditt avsedda användningsområde i en enda mening innan du skriver en enda uppgift. Allt annat – planen, statistiken, bedömarutbildningen – fungerar bara om den meningen är precis. Vagt avsett användningsområde producerar vag evidens, oavsett hur sofistikerad faktoranalysen ser ut.
— Jimmie
Bygg validerade bedömningar utan det manuella evidensspåret
Att dokumentera ett valideringsargument manuellt – spåra uppgiftsstatistik i ett kalkylblad, bedömaranteckningar i ett annat, pilotdata någon annanstans – är precis den typ av arbete som tyst hoppas över under tidspress. Ett verktyg genererar rollspecifika uppgifter direkt från en jobbeskrivning och ger dig en innehållsplan innan du har skrivit en enda fråga, medan inbyggd fuskförebyggande övervakning och sessionsreplayar lägger till den responsprocessevidens som de flesta team aldrig samlar in alls.
Det finns ingen prenumeration att binda sig till. Du betalar per slutförd kandidat, så kostnaden skalas med den rekrytering du faktiskt gör – inte en fast licensavgift. Om du utvärderar färdigheter för en specifik roll och vill att reliabilitets- och valideringsevidensen ska vara inbyggd i processen snarare än att sammanställas i efterhand, kolla in plattformen och se hur en jobbeskrivning omvandlas till en testbar, försvarbar bedömning på några minuter.
Källor
Klassiska läroböcker lär fortfarande ut innehålls-, konstrukt- och kriterievaliditet som om de vore tre separata rutor att bocka av. Modern psykometri behandlar dem som facetter av ett argument, och vissa experter argumenterar uttryckligen mot att isolera dem eftersom ett test kan se bra ut på en facett och misslyckas rejält på en annan. Här är hur evidensen faktiskt bryter ned sig utifrån när och hur du samlar in den:
- Reliabilitet vs validitet i forskning
- En introduktion till validitet inom utbildnings- och psykologisk testning
- Validitet för bedömningar
- Reliabilitet och validitet vid mätning (LibreTexts)
Att skilja på expertbedömning före data och statistiska kontroller efter data spelar roll eftersom team ofta stannar vid steg ett. En innehållsgranskning från tre ämnesexperter känns grundlig, men den säger ingenting om huruvida testet faktiskt förutsäger något verkligt.
Vanliga frågor
Vad kommer först, validitet eller reliabilitet?
Reliabilitet kommer funktionellt sett först. Du kan inte bygga ett övertygande valideringsargument på resultat som inte är konsekventa, även om reliabilitet ensamt aldrig bevisar att ett test är giltigt.
Kan ett test ha reliabilitet utan validitet?
Ja. Ett test kan producera mycket konsekventa resultat som ändå mäter helt fel konstrukt – det klassiska exemplet är en våg som visar samma felaktiga vikt varje gång.
Vad är den viktigaste skillnaden mellan reliabilitet och validitet?
Reliabilitet frågar om en mätning är konsekvent; validitet frågar om den mätningen faktiskt fångar det den påstår sig mäta för ett specifikt avsett användningsområde.
Vilka är några exempel på validitet och reliabilitet?
En partisk termometer som alltid läser två grader för högt är reliabel men ogiltig; ett test med tre uppgifter som i genomsnitt förutsäger arbetsprestation men varierar kraftigt för enskilda individer är giltigt men opålitligt.
Hur mäter man testreliabilitet?
De tre vanligaste metoderna är test-retest-korrelationer, mått på intern konsistens som Cronbachs alfa, och statistik för interbedömaröverenskommelse som kappa eller ICC – valda utifrån om testet upprepas, poängsätts per uppgift eller poängsätts av mänskliga bedömare.