
Elimina el Ruido: 9 Pasos para Evaluadores sobre Validez y Fiabilidad de Pruebas
La validez pregunta si una puntuación significa lo que se pretende que signifique. La fiabilidad pregunta si esa puntuación volvería a aparecer si se midiera a la misma persona mañana. Las dos están relacionadas pero no son intercambiables: la fiabilidad es necesaria pero no suficiente para la validez, porque una prueba puede producir puntuaciones maravillosamente consistentes que midan algo completamente equivocado. Lo que sigue desglosa los tipos de evidencia, las estadísticas utilizadas para estimar cada una y los pasos prácticos para construir una evaluación que resista ambas.
Resumen:
- Una alta fiabilidad es esencial en primer lugar, ya que las puntuaciones inconsistentes no pueden sostener una evaluación válida, especialmente al medir rasgos que deberían permanecer estables en el tiempo.
- La validez depende de si las puntuaciones de la prueba predicen con precisión el resultado previsto, siendo el contenido, la estructura interna, las relaciones con otras variables, los procesos de respuesta y las consecuencias las fuentes clave de evidencia.
- Recopilar evidencia de validez sólida requiere definir un propósito claro, construir un esquema de contenido, realizar pruebas piloto con muestras representativas y analizar las relaciones de constructo y criterio.
- La mayoría de los problemas en las evaluaciones provienen de un ruido de medición débil, que puede remediarse mediante un diseño específico de ítems y una administración estandarizada, no solo mediante la revisión del contenido.
- Utilizar la generación de ítems específicos para cada puesto y herramientas integradas contra el fraude agiliza la validación, proporcionando evidencia continua sin un trabajo manual excesivo, especialmente para evaluaciones basadas en roles.
Tabla de Contenidos
- Comprender la Validez de una Prueba: Lo Que Realmente Significa
- Comprender la Fiabilidad de una Prueba: Consistencia por Encima de la Precisión
- Test-Retest, Consistencia Interna y Fiabilidad entre Evaluadores Explicados
- Fiable pero Equivocada, o Válida pero con Ruido: La Confusión Aclarada
- Un Plan Paso a Paso para Recopilar Evidencia de Validez y Fiabilidad
- Una Lista de Verificación Práctica para Evaluaciones más Sólidas
- Cómo las Plataformas de Evaluación Documentan la Validez en la Práctica
- Lo Que la Investigación Realmente Indica que Debes Priorizar
- Construye Evaluaciones Validadas Sin el Rastro Manual de Evidencia
- Fuentes
- Preguntas Frecuentes
Comprender la Validez de una Prueba: Lo Que Realmente Significa
La validez no es una propiedad que una prueba lleva consigo como una etiqueta de certificación. Es un argumento, construido a partir de evidencia, sobre si las interpretaciones de las puntuaciones respaldan un uso previsto específico. Una evaluación de programación puede ser muy válida para predecir el rendimiento en la depuración de errores en el trabajo y completamente inválida para predecir el potencial de liderazgo, aunque sea exactamente la misma prueba. La puntuación no cambió. Lo que cambió fue la afirmación que se hace sobre esa puntuación.
Aquí es donde comienza mucha confusión. La gente pregunta "¿es válida esta prueba?" como si la validez fuera binaria, pero los Estándares para las Pruebas Educativas y Psicológicas la enmarcan como un argumento de validez unificado, construido a partir de cinco fuentes de evidencia en lugar de una lista de "tipos" separados. Esas cinco fuentes son:
- Evidencia de contenido: ¿los ítems de la prueba realmente representan el dominio o la habilidad en cuestión?
- Evidencia de estructura interna: ¿los ítems agrupados estadísticamente coinciden con los constructos que se supone deben medir?
- Relaciones con otras variables: ¿la puntuación se correlaciona con medidas externas de la manera que predice la teoría? (esto abarca lo que los libros de texto más antiguos llamaban validez convergente, discriminante y de criterio).
- Evidencia de procesos de respuesta: ¿los examinados realmente están ejerciendo la habilidad que se pretende medir, o están aprovechando el formato?
- Evidencia de consecuencias: ¿el uso de la prueba produce resultados justos e intencionados, o un daño no deseado a grupos específicos?
El propósito determina qué evidencia se necesita más. Una prueba de programación para preselección de empleo se apoya principalmente en la evidencia de contenido y de criterio. Un inventario de personalidad utilizado para la distribución de equipos se apoya en la estructura interna y en la evidencia de relaciones. La validez descansa en última instancia en si la prueba predice el resultado que afirma predecir, no en si los ítems parecen pulidos.
Comprender la Fiabilidad de una Prueba: Consistencia por Encima de la Precisión
La fiabilidad mide si una prueba produce el mismo resultado bajo las mismas condiciones, de forma repetida. No tiene nada que ver con si el resultado es correcto. Una balanza de cocina que marca 400 gramos cada vez que colocas un peso de 450 gramos es perfectamente fiable y consistentemente errónea en 50 gramos.
La fiabilidad es la consistencia y reproducibilidad de una medición, lo que indica cuán confiables son los resultados a lo largo de pruebas repetidas, mientras que la validez es la pregunta separada sobre la precisión y el significado. Toda medición contiene cierta cantidad de error: ruido aleatorio proveniente de la fatiga, la distracción, la redacción ambigua o un evaluador inconsistente que aleja una puntuación observada de la puntuación "verdadera" de una persona. La fiabilidad es en realidad una estimación de cuánto de ese ruido existe.
- Una fiabilidad baja significa que las puntuaciones varían de forma impredecible entre intentos, sesiones o evaluadores.
- Una fiabilidad alta significa que las puntuaciones se mantienen estables cuando nada significativo de la persona ha cambiado.
- La fiabilidad establece un techo para la validez: una medida con mucho ruido no puede correlacionarse fuertemente con nada, incluido el resultado que se supone debe predecir.
Ese último punto merece énfasis, porque es el vínculo mecánico entre los dos conceptos. Una baja fiabilidad en cualquiera de las medidas limita la correlación observable máxima entre ellas, un efecto llamado atenuación. Tres formas comunes de fiabilidad —test-retest, consistencia interna y acuerdo entre evaluadores— capturan cada una una fuente diferente de ese ruido.
Test-Retest, Consistencia Interna y Fiabilidad entre Evaluadores Explicados
La fiabilidad test-retest mide la estabilidad a lo largo del tiempo. Se administra la misma prueba a las mismas personas dos veces, generalmente con dos a cuatro semanas de diferencia, y se correlacionan los dos conjuntos de puntuaciones. Se adapta bien a rasgos estables, como la capacidad cognitiva general o las dimensiones de personalidad, y es poco adecuada para constructos que se supone cambian rápidamente, como el estado de ánimo o el estrés a corto plazo.
La consistencia interna mide si los ítems de una sola prueba concuerdan entre sí, típicamente mediante el alfa de Cronbach. Es la verificación de fiabilidad más rápida de realizar porque solo necesita una administración, razón por la cual se usa en exceso. El alfa es sensible al número de ítems de una prueba, por lo que una prueba larga puede producir un alfa inflado incluso cuando los ítems individuales son mediocres. Los coeficientes omega manejan esto mejor para pruebas con calidad desigual de ítems, aunque el alfa sigue siendo el estándar de la industria.
La fiabilidad entre evaluadores importa siempre que un ser humano califique algo subjetivo: una muestra de escritura, una entrevista estructurada, una tarea basada en vídeo. La kappa de Cohen o un coeficiente de correlación intraclase (ICC) cuantifica el acuerdo entre evaluadores, corrigiendo el acuerdo que se esperaría solo por azar.
Consejo Profesional: Una correlación test-retest a un nivel razonablemente alto (a menudo cercano a +.80 o superior) se trata comúnmente como un punto de referencia práctico para rasgos estables. Cualquier valor significativamente inferior a ese en un rasgo que no debería cambiar de una semana a otra indica un problema de diseño que vale la pena investigar antes de construir cualquier argumento de validez sobre él.
El contexto decide qué forma importa más. Una prueba de habilidades calificada automáticamente necesita una fuerte consistencia interna pero ninguna verificación entre evaluadores. Una entrevista estructurada necesita acuerdo entre evaluadores por encima de casi todo lo demás.
Fiable pero Equivocada, o Válida pero con Ruido: La Confusión Aclarada
La manera más clara de ver la diferencia entre validez y fiabilidad de una prueba es a través de dos modos de fallo que no se parecen en nada entre sí, pero que ambos arruinan una evaluación.
- Fiable pero inválida: un termómetro sesgado que marca dos grados de más cada vez. Es perfectamente consistente, lo que lo hace fiable, pero cada lectura es incorrecta, lo que lo hace inválido.
- Válida pero poco fiable: una prueba de habilidades con solo tres ítems que abarca una competencia amplia. En promedio, entre muchos examinados, podría correlacionarse razonablemente con el rendimiento laboral, pero la puntuación de cualquier persona varía demasiado entre intentos como para confiar en ella individualmente.
Estos ejemplos responden a las dos preguntas que más busca la gente. ¿Cuál va primero? La fiabilidad, funcionalmente, porque no se puede construir un argumento de validez defendible sobre puntuaciones inconsistentes. ¿Puede una prueba ser fiable sin ser válida? Sí, fácilmente, y ocurre constantemente con pruebas que son internamente consistentes pero que simplemente miden el constructo equivocado para el uso previsto.
Si tu fiabilidad es sólida pero la evidencia de validez es escasa, la solución suele estar en el contenido: incorpora expertos en la materia y comprueba si los ítems realmente representan el puesto o el rasgo. Si la fiabilidad en sí misma es débil, ninguna cantidad de evidencia de validez salvará la prueba. Primero hay que corregir el ruido de medición, típicamente añadiendo ítems bien dirigidos o ajustando las reglas de puntuación, antes de que la cuestión de la validez sea siquiera respondible.
Un Plan Paso a Paso para Recopilar Evidencia de Validez y Fiabilidad
Construir un argumento de validez defendible es una secuencia, no un único estudio. Este es el orden que produce evidencia con la que realmente puedes respaldar tus afirmaciones.
- Define el uso previsto en una oración. "Esta evaluación predice el rendimiento durante los primeros 90 días en un puesto de atención al cliente" es lo suficientemente específico como para guiar cada decisión posterior.
- Construye un esquema de contenido. Enumera las habilidades o dominios de conocimiento que requiere el uso previsto, ponderados por importancia, antes de redactar un solo ítem.
- Realiza una revisión de contenido por expertos. Pide a dos o tres expertos en la materia que califiquen de forma independiente si cada ítem se corresponde con el esquema y que señalen cualquier cosa fuera de lugar.
- Realiza una prueba piloto con una muestra representativa. Incluso entre 40 y 80 respuestas revelan problemas a nivel de ítem: redacción confusa, efectos de techo, ítems que nadie falla.
- Realiza un análisis de estructura interna. Utiliza análisis factorial exploratorio o confirmatorio para verificar si los ítems se agrupan de la manera que predice tu esquema, y calcula el alfa de Cronbach u omega para cada subescala.
- Verifica las relaciones convergentes y discriminantes. Correlaciona las puntuaciones con una medida establecida del mismo constructo y con una no relacionada para confirmar que la prueba mide lo que afirma medir.
- Recopila datos de criterio cuando sea posible. Registra los resultados reales —calificaciones de rendimiento laboral, tasas de promoción, tasas de error— y correlalos con las puntuaciones originales.
- Informa el tamaño de la muestra, el contexto y los intervalos de confianza. Un coeficiente de fiabilidad basado en 30 personas de una oficina significa algo diferente a uno basado en 2.000 personas en cinco países.
- Documenta todo el argumento. Escribe qué evidencia se recopiló, por qué y cómo respalda el uso previsto específico definido en el paso uno.
Consejo Profesional: Omite el paso uno y todo lo que viene después será más difícil de defender. Los revisores, auditores e incluso tu propio equipo seguirán preguntando "¿válida para qué?" si el uso previsto nunca se escribió desde el principio.
Los equipos que crean pruebas de selección específicas para cada puesto a menudo se saltan directamente al pilotaje y omiten el paso del esquema, lo cual es exactamente al revés. El esquema es lo que hace interpretable cada paso posterior.
Una Lista de Verificación Práctica para Evaluaciones más Sólidas
La mayoría de los problemas de validez y fiabilidad se remontan a un puñado de decisiones de diseño corregibles. Antes de publicar o revisar una evaluación, verifica lo siguiente:
- Cada ítem debe estar vinculado a una línea específica de tu esquema de contenido; elimina cualquier cosa que no tenga su lugar.
- En general, más ítems bien dirigidos superan a menos ítems amplios, ya que los ítems adicionales reducen el ruido de medición y aumentan la consistencia interna.
- Estandariza las condiciones de administración —límites de tiempo, instrucciones, entorno— para que la variación en las puntuaciones refleje a la persona, no el contexto.
- Capacita a los evaluadores con una rúbrica compartida y verifica el acuerdo entre evaluadores antes de confiar en el juicio de un solo calificador.
- Realiza una prueba piloto antes del lanzamiento completo y trata la primera versión como un borrador que necesitará revisión.
- Recopila datos de criterio o convergentes siempre que puedas, incluso de manera informal, y regístralos junto al resto de tu evidencia.
Consejo Profesional: Los empleadores que crean pruebas de habilidades listas para auditoría a menudo descubren que la mayor ganancia en fiabilidad proviene de estandarizar la puntuación, no de añadir preguntas. Una rúbrica vaga deshará el beneficio de un banco de ítems bien construido en todo momento.
Vincular los ítems a una descripción del puesto real en lugar de a una etiqueta de habilidad genérica también refuerza considerablemente la evidencia de contenido, ya que las etiquetas genéricas invitan a ítems genéricos de baja relevancia.
Cómo las Plataformas de Evaluación Documentan la Validez en la Práctica
Recopilar esta evidencia a mano —hojas de cálculo con estadísticas de ítems, notas separadas de los evaluadores, una carpeta con datos piloto— es exactamente la razón por la que la mayoría de los equipos se detienen en una revisión de contenido y lo dan por terminado. Una plataforma construida en torno a pruebas estructuradas y específicas para cada rol puede comprimir ese ciclo en lugar de eliminar el rigor.
Generar ítems directamente a partir de una descripción del puesto o una lista de habilidades te proporciona un esquema de contenido desde el primer borrador, en lugar de crearlo a posteriori una vez que los ítems ya existen. La entrega aleatoria de ítems y el monitoreo antitrampas —incluidas las verificaciones de pantalla y cámara web— fortalecen la evidencia de procesos de respuesta y consecuencias al reducir la posibilidad de que una puntuación refleje trampa en lugar de habilidad. Las estadísticas de ítems exportables, las repeticiones de sesiones y los resúmenes de rendimiento convierten lo que antes era una carpeta de validación dispersa en algo más parecido a un registro continuo.
El enfoque de la plataforma trata cada evaluación completada como un dato dentro de un argumento de validez continuo, no solo como una decisión de contratación, y eso es lo que diferencia un programa de pruebas defendible de uno basado en la intuición.
Lo Que la Investigación Realmente Indica que Debes Priorizar
La mayor brecha entre el consejo convencional y lo que respalda la evidencia es la secuenciación. La mayoría de las orientaciones tratan la validez y la fiabilidad como listas de verificación paralelas que se deben completar una vez. No son paralelas. La fiabilidad es el piso; la validez es lo que se construye encima, y ninguna cantidad de revisión de contenido por expertos rescata una prueba cuyas puntuaciones varían de una sesión a otra.
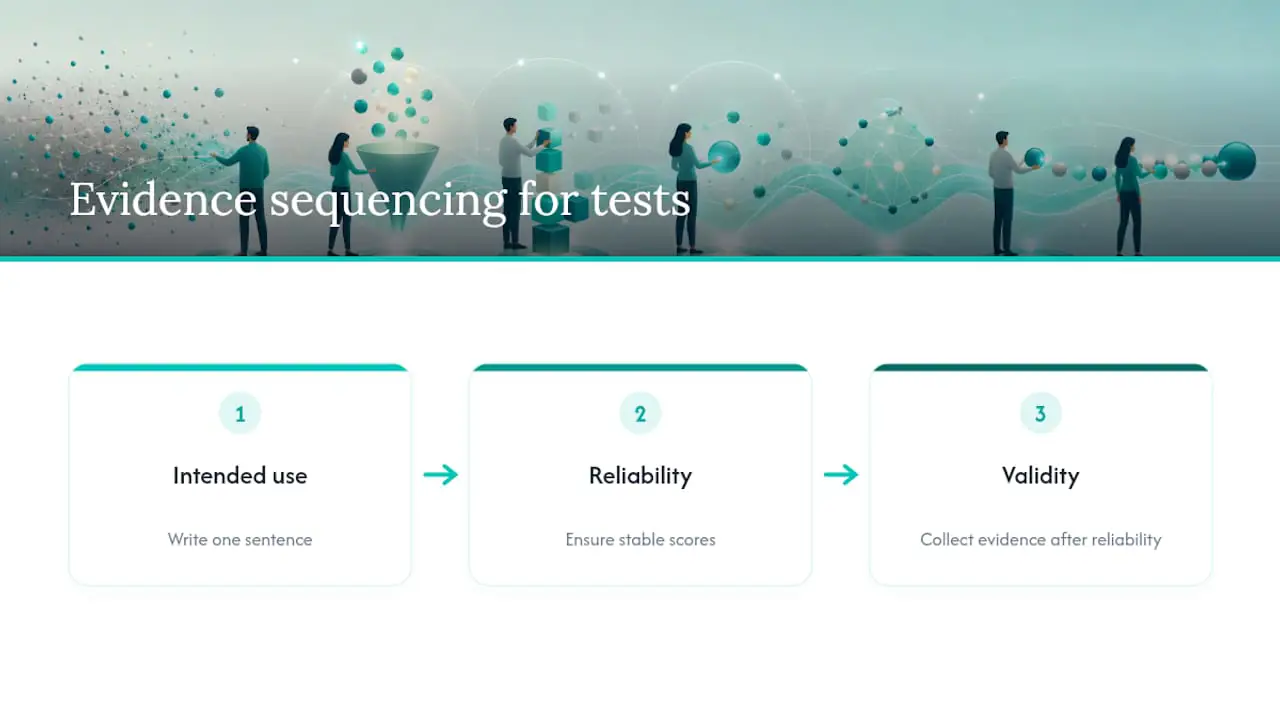
La segunda brecha es más incómoda: a los equipos les encanta la evidencia de contenido porque es barata y rápida —tres expertos, una tarde, listo. La evidencia de criterio —verificar realmente si las puntuaciones predicen el resultado que afirman predecir— se omite casi en todas partes fuera de la investigación académica, porque requiere paciencia y datos de resultados que la mayoría de los equipos de contratación nunca se molestan en recopilar.
Si te quedas con una sola cosa de esto, quédate con esta: escribe tu uso previsto en una sola oración antes de redactar un solo ítem. Todo lo demás —el esquema, las estadísticas, la formación de los evaluadores— solo funciona si esa oración es precisa. Un uso previsto vago produce evidencia vaga, sin importar lo sofisticado que parezca el análisis factorial.
— Jimmie
Construye Evaluaciones Validadas Sin el Rastro Manual de Evidencia
Documentar un argumento de validez a mano —rastreando estadísticas de ítems en una hoja de cálculo, notas de evaluadores en otra, datos piloto en otro lugar— es exactamente el tipo de trabajo que silenciosamente se omite bajo la presión de los plazos. Una herramienta genera ítems específicos para cada rol directamente a partir de una descripción del puesto, dándote un esquema de contenido antes de haber escrito una sola pregunta, mientras que el monitoreo antitrampas integrado y las repeticiones de sesiones añaden la evidencia de procesos de respuesta que la mayoría de los equipos nunca recopilan en absoluto.
No hay suscripción a la que comprometerse. Se paga por candidato completado, por lo que el costo escala con la contratación que realmente estás haciendo, no con una tarifa de licencia fija. Si estás evaluando habilidades para un puesto específico y deseas que la evidencia de fiabilidad y validez esté integrada en el proceso en lugar de ensamblarse después del hecho, explora la plataforma y descubre cómo una descripción del puesto se convierte en una evaluación comprobable y defendible en minutos.
Fuentes
Los libros de texto clásicos todavía enseñan la validez de contenido, constructo y criterio como si fueran tres casillas separadas a marcar. La psicometría moderna las trata como facetas de un único argumento, y algunos expertos argumentan explícitamente en contra de aislarlas porque una prueba puede parecer bien en una faceta y fallar gravemente en otra. Así es como la evidencia realmente se desglosa según cuándo y cómo se recopila:
- Fiabilidad vs Validez en la Investigación
- Una introducción a la validez en las pruebas educativas y psicológicas
- Validez para las Evaluaciones
- Fiabilidad y validez de la medición (LibreTexts)
Distinguir el juicio experto previo a los datos de las verificaciones estadísticas posteriores a los datos importa porque los equipos a menudo se detienen en el paso uno. Una revisión de contenido por tres expertos en la materia se siente exhaustiva, pero no dice nada sobre si la prueba predice algo real.
Preguntas Frecuentes
¿Qué Va Primero, la Validez o la Fiabilidad?
La fiabilidad va funcionalmente primero. No se puede construir un argumento de validez convincente sobre puntuaciones que no son consistentes, aunque la fiabilidad por sí sola nunca demuestra que una prueba sea válida.
¿Puede una Prueba Tener Fiabilidad Sin Validez?
Sí. Una prueba puede producir puntuaciones altamente consistentes que aun así midan el constructo equivocado por completo, el ejemplo clásico es una balanza que marca el mismo peso incorrecto cada vez.
¿Cuál Es la Diferencia Principal entre Fiabilidad y Validez?
La fiabilidad pregunta si una medición es consistente; la validez pregunta si esa medición realmente captura lo que afirma medir para un uso previsto específico.
¿Cuáles Son Algunos Ejemplos de Validez y Fiabilidad?
Un termómetro sesgado que siempre marca dos grados de más es fiable pero inválido; una prueba de tres ítems que predice el rendimiento laboral en promedio pero varía ampliamente para los individuos es válida pero poco fiable.
¿Cómo se Mide la Fiabilidad de una Prueba?
Los tres métodos más comunes son las correlaciones test-retest, las medidas de consistencia interna como el alfa de Cronbach, y las estadísticas de acuerdo entre evaluadores como la kappa o el ICC, elegidos según si la prueba se repite, se puntúa por ítems o es puntuada por evaluadores humanos.
Recomendado
- Equipos de RRHH: Haz que la Validez de las Pruebas de Habilidades Esté Lista para Auditoría, $5 por Evaluación
- Crea Rúbricas de Puntuación para Evaluaciones que los Educadores Puedan Pilotear y Escalar con IA
- Equipos de Contratación: 5 Pasos hacia una Analítica de Evaluaciones Orientada a la Medición
- Cómo las Descripciones de Puestos Impulsan Evaluaciones que Realmente Predicen…