
शोर ठीक करें: परीक्षण वैधता और विश्वसनीयता के लिए मूल्यांकनकर्ताओं हेतु 9 चरण
वैधता (Validity) यह पूछती है कि किसी स्कोर का अर्थ वही है जो आप चाहते हैं। विश्वसनीयता (Reliability) यह पूछती है कि यदि आप उसी व्यक्ति को कल फिर से मापें तो क्या वही स्कोर आएगा। दोनों आपस में संबंधित हैं, लेकिन एक-दूसरे के स्थान पर उपयोग नहीं किए जा सकते: विश्वसनीयता वैधता के लिए आवश्यक है, लेकिन पर्याप्त नहीं, क्योंकि एक परीक्षण बिल्कुल एकसमान स्कोर दे सकता है जो पूरी तरह गलत चीज़ मापते हों। आगे हम साक्ष्य के प्रकारों, प्रत्येक का अनुमान लगाने के लिए उपयोग किए जाने वाले आंकड़ों, और एक ऐसा मूल्यांकन बनाने के व्यावहारिक चरणों का विश्लेषण करेंगे जो दोनों कसौटियों पर खरा उतरे।
संक्षेप में (TL;DR):
- उच्च विश्वसनीयता पहले आवश्यक है, क्योंकि असंगत स्कोर किसी वैध मूल्यांकन का आधार नहीं बन सकते, विशेष रूप से तब जब ऐसे गुणों को मापा जा रहा हो जो समय के साथ स्थिर रहने चाहिए।
- वैधता इस बात पर निर्भर करती है कि परीक्षण के स्कोर इच्छित परिणाम की सटीक भविष्यवाणी करते हैं या नहीं; सामग्री, आंतरिक संरचना, चरों से संबंध, प्रतिक्रिया प्रक्रियाएं और परिणाम मुख्य साक्ष्य स्रोत हैं।
- मजबूत वैधता साक्ष्य एकत्र करने के लिए एक स्पष्ट उद्देश्य निर्धारित करना, एक सामग्री खाका (blueprint) बनाना, प्रतिनिधि नमूनों के साथ परीक्षण करना और निर्माण (construct) व कसौटी (criterion) संबंधों का विश्लेषण करना आवश्यक है।
- अधिकांश मूल्यांकन समस्याएं कमजोर मापन शोर (measurement noise) से उत्पन्न होती हैं, जिसे केवल सामग्री समीक्षा से नहीं, बल्कि लक्षित प्रश्न डिज़ाइन और मानकीकृत प्रशासन द्वारा दूर किया जा सकता है।
- भूमिका-विशिष्ट प्रश्न निर्माण और अंतर्निहित धोखा-रोधी उपकरणों का उपयोग सत्यापन को सरल बनाता है, जिससे अत्यधिक मैन्युअल कार्य के बिना निरंतर साक्ष्य मिलता रहता है, विशेष रूप से भूमिका-आधारित मूल्यांकनों के लिए।
विषय सूची
- परीक्षण वैधता को समझना: इसका वास्तविक अर्थ क्या है
- परीक्षण विश्वसनीयता को समझना: सटीकता से पहले संगति
- Test-Retest, आंतरिक संगति और Interrater विश्वसनीयता की व्याख्या
- विश्वसनीय लेकिन गलत, या वैध लेकिन अस्थिर: भ्रम दूर करना
- वैधता और विश्वसनीयता साक्ष्य एकत्र करने की चरण-दर-चरण योजना
- बेहतर मूल्यांकन के लिए एक व्यावहारिक चेकलिस्ट
- मूल्यांकन प्लेटफ़ॉर्म व्यवहार में वैधता का दस्तावेज़ीकरण कैसे करते हैं
- शोध वास्तव में आपको किसे प्राथमिकता देने के लिए कहता है
- मैन्युअल साक्ष्य ट्रेल के बिना मान्य मूल्यांकन बनाएं
- स्रोत
- अक्सर पूछे जाने वाले प्रश्न (FAQ)
परीक्षण वैधता को समझना: इसका वास्तविक अर्थ क्या है
वैधता कोई ऐसी विशेषता नहीं है जो किसी परीक्षण में प्रमाणपत्र की तरह चिपकी हो। यह एक तर्क है, साक्ष्य से निर्मित, इस बारे में कि क्या स्कोर की व्याख्याएं किसी विशिष्ट इच्छित उपयोग का समर्थन करती हैं। एक कोडिंग मूल्यांकन नौकरी में डीबगिंग प्रदर्शन की भविष्यवाणी के लिए अत्यधिक वैध हो सकता है और नेतृत्व क्षमता की भविष्यवाणी के लिए पूरी तरह अवैध हो सकता है, भले ही वह बिल्कुल वही परीक्षण हो। स्कोर नहीं बदला। स्कोर के बारे में आपका दावा बदला।
यहीं से बहुत सारी भ्रांति शुरू होती है। लोग पूछते हैं "क्या यह परीक्षण वैध है?" जैसे कि वैधता द्विआधारी हो, लेकिन शैक्षिक और मनोवैज्ञानिक परीक्षण के मानक इसे एक एकीकृत वैधता तर्क के रूप में प्रस्तुत करते हैं, जो अलग-अलग "प्रकारों" की चेकलिस्ट के बजाय साक्ष्य के पांच स्रोतों से निर्मित है। वे पांच स्रोत हैं:
- सामग्री साक्ष्य — क्या परीक्षण के प्रश्न वास्तव में संबंधित क्षेत्र या कौशल का प्रतिनिधित्व करते हैं?
- आंतरिक संरचना साक्ष्य — क्या एक साथ समूहीकृत प्रश्न सांख्यिकीय रूप से उन निर्माणों (constructs) से मेल खाते हैं जिन्हें उन्हें मापना चाहिए?
- अन्य चरों से संबंध — क्या स्कोर बाहरी मापों के साथ उस प्रकार सहसंबद्ध होता है जैसा सिद्धांत भविष्यवाणी करता है (इसमें वह शामिल है जिसे पुरानी पाठ्यपुस्तकें अभिसारी, विभेदक और कसौटी वैधता कहती थीं)?
- प्रतिक्रिया प्रक्रिया साक्ष्य — क्या परीक्षार्थी वास्तव में उस कौशल में संलग्न हो रहे हैं जिसे आप मापना चाहते हैं, या प्रारूप का फायदा उठा रहे हैं?
- परिणाम साक्ष्य — क्या परीक्षण का उपयोग उचित, इच्छित परिणाम देता है, या विशिष्ट समूहों को अनायास नुकसान पहुंचाता है?
उद्देश्य यह तय करता है कि आपको किस साक्ष्य की सर्वाधिक आवश्यकता है। एक पूर्व-रोजगार कोडिंग परीक्षण सामग्री और कसौटी साक्ष्य पर बहुत अधिक निर्भर करता है। टीम नियोजन के लिए उपयोग की जाने वाली एक व्यक्तित्व सूची आंतरिक संरचना और संबंध साक्ष्य पर निर्भर करती है। वैधता अंततः इस बात पर टिकी है कि परीक्षण उस परिणाम की भविष्यवाणी करता है जिसका वह दावा करता है, न कि इस बात पर कि प्रश्न कितने परिष्कृत दिखते हैं।
परीक्षण विश्वसनीयता को समझना: सटीकता से पहले संगति
विश्वसनीयता मापती है कि एक परीक्षण समान परिस्थितियों में बार-बार एक ही परिणाम देता है या नहीं। इसका इस बात से कोई संबंध नहीं कि परिणाम सही है या नहीं। एक रसोई तराजू जो हर बार एक पाउंड का वजन रखने पर 14 औंस दिखाता है, वह पूरी तरह विश्वसनीय है और लगातार दो औंस गलत है।
विश्वसनीयता किसी माप की संगति और पुनरुत्पादनीयता है, जो बार-बार के परीक्षणों में परिणामों की निर्भरता को दर्शाती है, जबकि वैधता सटीकता और अर्थ का अलग प्रश्न है। प्रत्येक माप में कुछ मात्रा में त्रुटि होती है — थकान, ध्यान भटकना, अस्पष्ट शब्दावली या असंगत ग्रेडर से यादृच्छिक शोर जो देखे गए स्कोर को व्यक्ति के "वास्तविक" स्कोर से दूर धकेलता है। विश्वसनीयता वास्तव में इस बात का अनुमान है कि उस शोर की कितनी मात्रा मौजूद है।
- कम विश्वसनीयता का अर्थ है कि स्कोर प्रयासों, सत्रों या रेटरों के बीच अप्रत्याशित रूप से उछलते हैं।
- उच्च विश्वसनीयता का अर्थ है कि जब व्यक्ति के बारे में कुछ भी सार्थक नहीं बदला हो तो स्कोर स्थिर रहते हैं।
- विश्वसनीयता वैधता की एक सीमा निर्धारित करती है: एक बुरी तरह शोरगुल वाला माप किसी भी चीज़ के साथ दृढ़ता से सहसंबद्ध नहीं हो सकता, जिसमें वह परिणाम भी शामिल है जिसकी उसे भविष्यवाणी करनी है।
अंतिम बिंदु पर जोर देना उचित है, क्योंकि यह दोनों अवधारणाओं के बीच यांत्रिक कड़ी है। किसी भी माप में कम विश्वसनीयता उनके बीच अधिकतम देखे जा सकने वाले सहसंबंध को सीमित कर देती है, इस प्रभाव को क्षीणता (attenuation) कहते हैं। विश्वसनीयता के तीन सामान्य रूप — test-retest, आंतरिक संगति और interrater सहमति — प्रत्येक उस शोर का एक अलग स्रोत पकड़ते हैं।
Test-Retest, आंतरिक संगति और Interrater विश्वसनीयता की व्याख्या
Test-retest विश्वसनीयता समय के साथ स्थिरता मापती है। आप एक ही परीक्षण एक ही लोगों को दो बार देते हैं, आमतौर पर दो से चार सप्ताह के अंतराल पर, और दोनों स्कोर सेटों को सहसंबद्ध करते हैं। यह स्थिर गुणों, जैसे सामान्य संज्ञानात्मक क्षमता या व्यक्तित्व आयामों, के लिए उपयुक्त है; उन निर्माणों के लिए कम उपयुक्त जो जल्दी बदलने के लिए होते हैं, जैसे मनोदशा या अल्पकालिक तनाव।
आंतरिक संगति मापती है कि क्या एक परीक्षण के प्रश्न एक-दूसरे से सहमत हैं, आमतौर पर Cronbach's alpha के माध्यम से। यह सबसे तेज़ विश्वसनीयता जांच है क्योंकि इसके लिए केवल एक प्रशासन की आवश्यकता है, यही कारण है कि इसका अत्यधिक उपयोग होता है। Alpha परीक्षण में प्रश्नों की संख्या के प्रति संवेदनशील है, इसलिए एक लंबा परीक्षण एक बढ़ा-चढ़ाकर दिखाया गया alpha उत्पन्न कर सकता है, भले ही व्यक्तिगत प्रश्न औसत दर्जे के हों। असमान प्रश्न गुणवत्ता वाले परीक्षणों के लिए Omega गुणांक इसे बेहतर तरीके से संभालते हैं, हालांकि alpha उद्योग का मानक बना हुआ है।
Interrater विश्वसनीयता तब मायने रखती है जब कोई मानव व्यक्तिपरक चीज़ स्कोर करता है — एक लेखन नमूना, एक संरचित साक्षात्कार, एक वीडियो-आधारित कार्य। Cohen's kappa या intraclass correlation coefficient (ICC) रेटरों के बीच सहमति को मात्राबद्ध करता है, केवल संयोग से होने वाली सहमति को सुधारते हुए।
प्रो टिप: एक उचित उच्च स्तर पर test-retest सहसंबंध (अक्सर +.80 या उससे अधिक के करीब) को स्थिर गुणों के लिए एक व्यावहारिक मानक माना जाता है। किसी ऐसे गुण पर जो सप्ताह-दर-सप्ताह नहीं बदलना चाहिए, इससे सार्थक रूप से कम कुछ भी एक डिज़ाइन समस्या का संकेत देता है जो इससे पहले जांच के लायक है कि आप उस पर कोई वैधता तर्क बनाएं।
संदर्भ तय करता है कि कौन सा रूप सबसे अधिक मायने रखता है। एक स्वचालित रूप से स्कोर किया गया कौशल परीक्षण मजबूत आंतरिक संगति की मांग करता है लेकिन interrater जांच की बिल्कुल भी नहीं। एक संरचित साक्षात्कार को लगभग हर चीज़ से ऊपर interrater सहमति की आवश्यकता होती है।
विश्वसनीय लेकिन गलत, या वैध लेकिन अस्थिर: भ्रम दूर करना
परीक्षण वैधता बनाम विश्वसनीयता के बीच अंतर देखने का सबसे स्पष्ट तरीका दो विफलता मोड के माध्यम से है जो बिल्कुल अलग दिखते हैं, लेकिन दोनों एक मूल्यांकन को बर्बाद कर देते हैं।
- विश्वसनीय लेकिन अवैध: एक पक्षपाती थर्मामीटर जो हर बार दो डिग्री अधिक पढ़ता है। यह पूरी तरह से संगत है, जो इसे विश्वसनीय बनाता है, लेकिन हर रीडिंग गलत है, जो इसे अवैध बनाती है।
- वैध लेकिन अविश्वसनीय: एक कौशल परीक्षण जिसमें केवल तीन प्रश्न हों जो एक व्यापक दक्षता को कवर करते हों। औसतन कई परीक्षार्थियों में यह नौकरी प्रदर्शन के साथ उचित रूप से सहसंबद्ध हो सकता है, लेकिन किसी एक व्यक्ति का स्कोर प्रयासों के बीच इतना उछलता है कि व्यक्तिगत रूप से उस पर भरोसा नहीं किया जा सकता।
ये उदाहरण उन दो प्रश्नों का उत्तर देते हैं जिन्हें लोग सबसे अधिक खोजते हैं। पहले क्या आता है? विश्वसनीयता, कार्यात्मक रूप से, क्योंकि आप असंगत स्कोरों के आधार पर एक ठोस वैधता तर्क नहीं बना सकते, हालांकि विश्वसनीयता अकेले यह कभी सिद्ध नहीं करती कि एक परीक्षण वैध है। क्या कोई परीक्षण वैधता के बिना विश्वसनीय हो सकता है? हां, आसानी से, और यह उन परीक्षणों के साथ लगातार होता है जो आंतरिक रूप से संगत हैं लेकिन इच्छित उपयोग के लिए बस गलत निर्माण को मापते हैं।
यदि आपकी विश्वसनीयता मजबूत है लेकिन वैधता साक्ष्य पतला है, तो सुधार आमतौर पर सामग्री में होता है: विषय विशेषज्ञों को लाएं और जांचें कि क्या प्रश्न वास्तव में नौकरी या गुण का प्रतिनिधित्व करते हैं। यदि विश्वसनीयता स्वयं कमजोर है, तो वैधता साक्ष्य की कोई भी मात्रा परीक्षण को नहीं बचाएगी। आपको पहले मापन शोर को ठीक करना होगा — आमतौर पर अच्छी तरह से लक्षित प्रश्न जोड़कर या स्कोरिंग नियमों को कसकर — इससे पहले कि वैधता का प्रश्न भी उत्तर देने योग्य हो।
वैधता और विश्वसनीयता साक्ष्य एकत्र करने की चरण-दर-चरण योजना
एक ठोस वैधता तर्क बनाना एक क्रम है, न कि एक अध्ययन। यहां वह क्रम है जो ऐसा साक्ष्य उत्पन्न करता है जिसके पीछे आप वास्तव में खड़े हो सकते हैं।
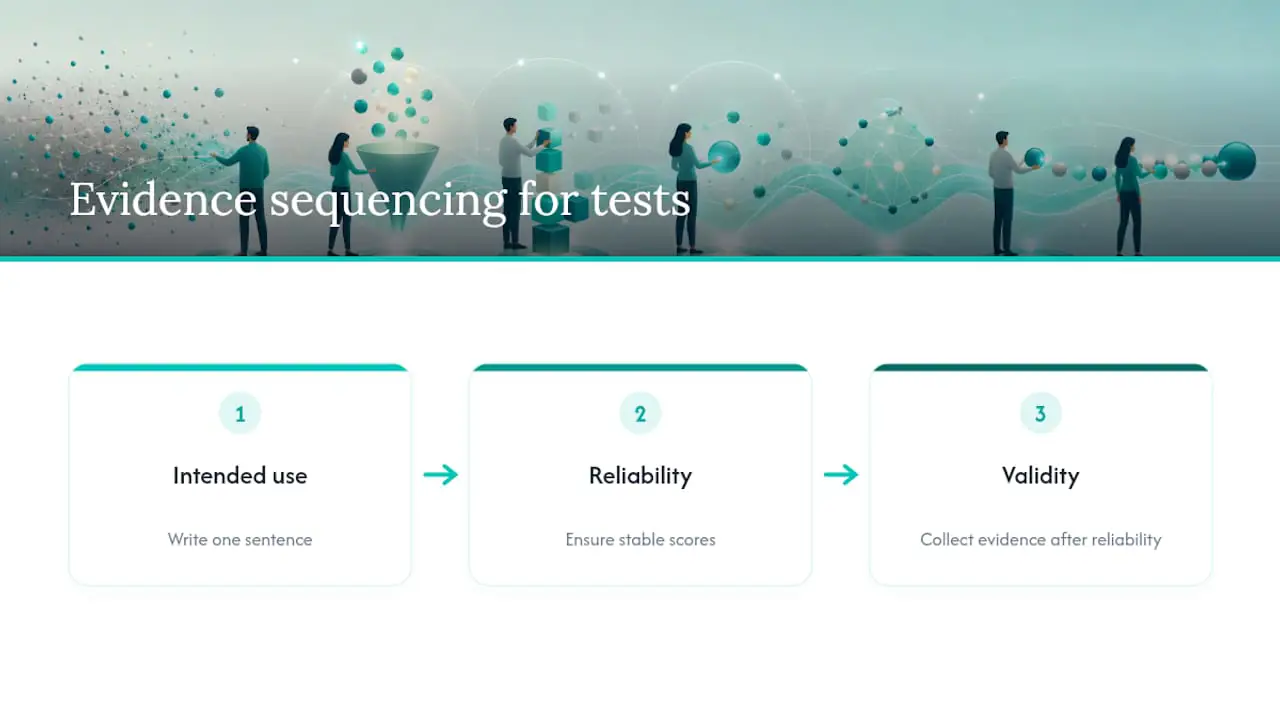
- इच्छित उपयोग को एक वाक्य में परिभाषित करें। "यह मूल्यांकन ग्राहक सहायता भूमिका के लिए पहले 90 दिनों के प्रदर्शन की भविष्यवाणी करता है" — यह इसके बाद के हर निर्णय को निर्देशित करने के लिए पर्याप्त विशिष्ट है।
- एक सामग्री खाका (blueprint) बनाएं। एक भी प्रश्न लिखने से पहले, इच्छित उपयोग के लिए आवश्यक कौशल या ज्ञान क्षेत्रों की सूची बनाएं, जो महत्व के अनुसार भारित हो।
- विशेषज्ञ सामग्री समीक्षा करें। दो या तीन विषय विशेषज्ञों से स्वतंत्र रूप से यह रेट करवाएं कि प्रत्येक प्रश्न खाके से मेल खाता है या नहीं और जो लक्ष्य से भटका हो उसे चिह्नित करें।
- प्रतिनिधि नमूने पर परीक्षण करें। 40 से 80 प्रतिक्रियाएं भी प्रश्न-स्तर की समस्याएं उजागर करती हैं — भ्रामक शब्दावली, सीलिंग इफेक्ट, ऐसे प्रश्न जिन्हें कोई गलत नहीं करता।
- आंतरिक संरचना विश्लेषण करें। यह जांचने के लिए खोजपूर्ण या पुष्टिकारक कारक विश्लेषण का उपयोग करें कि प्रश्न उस तरह समूहबद्ध होते हैं जैसा आपका खाका भविष्यवाणी करता है, और प्रत्येक उपमाप (subscale) के लिए Cronbach's alpha या omega की गणना करें।
- अभिसारी और विभेदक संबंधों की जांच करें। स्कोरों को उसी निर्माण के एक स्थापित माप के साथ और एक असंबंधित माप के साथ सहसंबद्ध करें ताकि पुष्टि हो सके कि परीक्षण वही मापता है जो वह दावा करता है।
- जब संभव हो कसौटी डेटा एकत्र करें। वास्तविक परिणामों को ट्रैक करें — नौकरी प्रदर्शन रेटिंग, पदोन्नति दर, त्रुटि दर — और उन्हें मूल स्कोरों से सहसंबद्ध करें।
- नमूना आकार, संदर्भ और विश्वास अंतराल रिपोर्ट करें। एक कार्यालय में 30 लोगों से प्राप्त विश्वसनीयता गुणांक का अर्थ पांच देशों में 2,000 लोगों पर आधारित गुणांक से बिल्कुल अलग है।
- पूरे तर्क का दस्तावेज़ीकरण करें। लिखें कि क्या साक्ष्य एकत्र किया गया, क्यों, और यह चरण एक में परिभाषित विशिष्ट इच्छित उपयोग का कैसे समर्थन करता है।
प्रो टिप: चरण एक छोड़ें और बाद में हर चीज़ का बचाव करना कठिन हो जाता है। समीक्षक, ऑडिटर और यहां तक कि आपकी अपनी टीम भी "किसके लिए वैध?" पूछती रहेगी यदि इच्छित उपयोग को पहले स्थान पर कभी लिखा ही नहीं गया।
भूमिका-विशिष्ट स्क्रीनिंग परीक्षण बनाने वाली टीमें अक्सर सीधे पायलटिंग पर जाती हैं और खाका (blueprint) चरण को छोड़ देती हैं, जो बिल्कुल उल्टा है। खाका ही वह है जो हर बाद के चरण को व्याख्या योग्य बनाता है।
बेहतर मूल्यांकन के लिए एक व्यावहारिक चेकलिस्ट
अधिकांश वैधता और विश्वसनीयता समस्याएं कुछ ठीक करने योग्य डिज़ाइन विकल्पों पर वापस जाती हैं। किसी मूल्यांकन को जारी करने या संशोधित करने से पहले, इनकी जांच करें:
- हर प्रश्न आपके सामग्री खाके की एक विशिष्ट पंक्ति से जुड़ा होना चाहिए; जो अपनी जगह नहीं बनाता उसे हटाएं।
- अधिक अच्छी तरह से लक्षित प्रश्न आमतौर पर कम व्यापक प्रश्नों से बेहतर होते हैं, क्योंकि अतिरिक्त प्रश्न मापन शोर को कम करते हैं और आंतरिक संगति बढ़ाते हैं।
- प्रशासन की स्थितियों को मानकीकृत करें — समय सीमा, निर्देश, वातावरण — ताकि स्कोरों में भिन्नता व्यक्ति को दर्शाए, न कि परिस्थिति को।
- रेटरों को एक साझा रूब्रिक पर प्रशिक्षित करें और किसी एक ग्रेडर के निर्णय पर भरोसा करने से पहले interrater सहमति की जांच करें।
- पूर्ण रोलआउट से पहले पायलट करें, और पहले संस्करण को एक ड्राफ्ट के रूप में मानें जिसे संशोधन की आवश्यकता होगी।
- जब भी संभव हो कसौटी या अभिसारी डेटा एकत्र करें, यहां तक कि अनौपचारिक रूप से, और इसे अपने बाकी साक्ष्य के साथ लॉग करें।
प्रो टिप: ऑडिट-तैयार कौशल परीक्षण बनाने वाले नियोक्ता अक्सर पाते हैं कि सबसे बड़ा विश्वसनीयता लाभ प्रश्न जोड़ने से नहीं, बल्कि स्कोरिंग को मानकीकृत करने से आता है। एक अस्पष्ट रूब्रिक हर बार एक अच्छी तरह से बनाए गए प्रश्न बैंक के फायदे को नष्ट कर देगा।
प्रश्नों को एक सामान्य कौशल लेबल के बजाय एक वास्तविक नौकरी विवरण से जोड़ना सामग्री साक्ष्य को काफी हद तक मजबूत करता है, क्योंकि सामान्य लेबल सामान्य, कम-प्रासंगिकता वाले प्रश्नों को आमंत्रित करते हैं।
मूल्यांकन प्लेटफ़ॉर्म व्यवहार में वैधता का दस्तावेज़ीकरण कैसे करते हैं
इस साक्ष्य को हाथ से एकत्र करना — प्रश्न आंकड़ों की स्प्रेडशीट, अलग रेटर नोट्स, पायलट डेटा का एक फ़ोल्डर — ठीक इसी कारण से अधिकांश टीमें एक सामग्री समीक्षा पर रुक जाती हैं और इसे पर्याप्त मान लेती हैं। संरचित, भूमिका-विशिष्ट परीक्षण के आसपास बना एक प्लेटफ़ॉर्म उस कठोरता को समाप्त करने के बजाय उस चक्र को संकुचित कर सकता है।
किसी नौकरी विवरण या कौशल सूची से सीधे प्रश्न उत्पन्न करना आपको पहले ड्राफ्ट से एक सामग्री खाका देता है, बजाय इसके कि प्रश्नों के अस्तित्व में आने के बाद एक को रिवर्स-इंजीनियर किया जाए। यादृच्छिक प्रश्न वितरण और धोखा-रोधी निगरानी — जिसमें स्क्रीन और वेबकैम जांच शामिल हैं — प्रतिक्रिया-प्रक्रिया और परिणाम साक्ष्य को मजबूत करती है, इस संभावना को कम करके कि एक स्कोर कौशल के बजाय धोखाधड़ी को दर्शाता है। निर्यात योग्य प्रश्न आंकड़े, सत्र रिप्ले और प्रदर्शन सारांश जो कभी एक बिखरा हुआ सत्यापन फ़ोल्डर था उसे एक चालू रिकॉर्ड के करीब कुछ बनाते हैं।
प्लेटफ़ॉर्म का दृष्टिकोण हर पूर्ण मूल्यांकन को एक चल रहे वैधता तर्क में एक डेटा बिंदु के रूप में मानता है, न कि केवल एक भर्ती निर्णय के रूप में, जो एक ठोस परीक्षण कार्यक्रम को एक अनुमान-आधारित कार्यक्रम से अलग करता है।
शोध वास्तव में आपको किसे प्राथमिकता देने के लिए कहता है
पारंपरिक सलाह और साक्ष्य जो समर्थन करता है उसके बीच सबसे बड़ा अंतर अनुक्रम में है। अधिकांश मार्गदर्शन वैधता और विश्वसनीयता को समानांतर चेकलिस्ट के रूप में मानता है जिन्हें एक बार चलाना होता है। वे समानांतर नहीं हैं। विश्वसनीयता आधार है; वैधता वह है जो आप उसके ऊपर बनाते हैं, और विशेषज्ञ सामग्री समीक्षा की कोई भी मात्रा उस परीक्षण को नहीं बचाएगी जिसके स्कोर एक बैठक से दूसरी बैठक तक उछलते रहते हैं।
दूसरा अंतर अधिक असहज करने वाला है: टीमें सामग्री साक्ष्य से प्यार करती हैं क्योंकि यह सस्ता और तेज़ है — तीन विशेषज्ञ, एक दोपहर, हो गया। कसौटी साक्ष्य — वास्तव में यह जांचना कि क्या स्कोर उस परिणाम की भविष्यवाणी करते हैं जो वे दावा करते हैं — लगभग हर जगह शैक्षणिक अनुसंधान के बाहर छोड़ा जाता है, क्योंकि इसके लिए धैर्य और परिणाम डेटा की आवश्यकता होती है जिसे अधिकांश भर्ती टीमें कभी एकत्र नहीं करतीं।
यदि आप इससे एक बात लेते हैं, तो यह लें: एक भी प्रश्न लिखने से पहले अपने इच्छित उपयोग को एक वाक्य में लिखें। बाकी सब — खाका, आंकड़े, रेटर प्रशिक्षण — तभी काम करता है जब वह वाक्य सटीक हो। अस्पष्ट इच्छित उपयोग अस्पष्ट साक्ष्य उत्पन्न करता है, चाहे कारक विश्लेषण कितना भी परिष्कृत दिखे।
— Jimmie
मैन्युअल साक्ष्य ट्रेल के बिना मान्य मूल्यांकन बनाएं
हाथ से एक वैधता तर्क का दस्तावेज़ीकरण करना — एक स्प्रेडशीट में प्रश्न आंकड़े ट्रैक करना, दूसरे में रेटर नोट्स, पायलट डेटा कहीं और — ठीक वह काम है जो समय-सीमा के दबाव में चुपचाप छोड़ दिया जाता है। एक टूल किसी नौकरी विवरण से सीधे भूमिका-विशिष्ट प्रश्न उत्पन्न करता है, जिससे आपको एक भी प्रश्न लिखने से पहले एक सामग्री खाका मिलता है, जबकि अंतर्निहित धोखा-रोधी निगरानी और सत्र रिप्ले वह प्रतिक्रिया-प्रक्रिया साक्ष्य जोड़ते हैं जो अधिकांश टीमें कभी एकत्र नहीं करतीं।
कोई सदस्यता नहीं लेनी है। आप प्रति पूर्ण उम्मीदवार भुगतान करते हैं, इसलिए लागत उस भर्ती के साथ बढ़ती है जो आप वास्तव में कर रहे हैं, न कि एक निश्चित लाइसेंस शुल्क के अनुसार। यदि आप किसी विशिष्ट भूमिका के लिए कौशल का मूल्यांकन कर रहे हैं और चाहते हैं कि विश्वसनीयता और वैधता साक्ष्य प्रक्रिया में निर्मित हो, न कि बाद में इकट्ठा किया जाए, तो प्लेटफ़ॉर्म देखें और जानें कि एक नौकरी विवरण मिनटों में एक परीक्षण योग्य, ठोस मूल्यांकन में कैसे बदलता है।
स्रोत
क्लासिक पाठ्यपुस्तकें अभी भी सामग्री, निर्माण और कसौटी वैधता को इस तरह पढ़ाती हैं जैसे वे तीन अलग-अलग बक्से हों जिन्हें जांचना है। आधुनिक मनोमिति (psychometrics) उन्हें एक तर्क के पहलुओं के रूप में मानती है, और कुछ विशेषज्ञ स्पष्ट रूप से उन्हें अलग करने के खिलाफ तर्क देते हैं क्योंकि एक परीक्षण एक पहलू पर ठीक दिख सकता है और दूसरे पर बुरी तरह विफल हो सकता है। यहां साक्ष्य वास्तव में इस बात के अनुसार विभाजित होता है कि आप इसे कब और कैसे एकत्र करते हैं:
- Reliability vs Validity in Research
- An introduction to validity in educational and psychological testing
- Validity for Assessments
- Reliability and validity of measurement (LibreTexts)
डेटा-पूर्व विशेषज्ञ निर्णय को डेटा-पश्चात सांख्यिकीय जांच से अलग करना मायने रखता है क्योंकि टीमें अक्सर चरण एक पर रुक जाती हैं। तीन विषय विशेषज्ञों की सामग्री समीक्षा संपूर्ण लगती है, लेकिन इससे यह नहीं पता चलता कि परीक्षण कुछ भी वास्तविक भविष्यवाणी करता है या नहीं।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
पहले क्या आता है, वैधता या विश्वसनीयता?
विश्वसनीयता कार्यात्मक रूप से पहले आती है। आप ऐसे स्कोरों पर एक ठोस वैधता तर्क नहीं बना सकते जो संगत नहीं हैं, हालांकि अकेली विश्वसनीयता कभी यह साबित नहीं करती कि एक परीक्षण वैध है।
क्या कोई परीक्षण वैधता के बिना विश्वसनीय हो सकता है?
हां। एक परीक्षण अत्यधिक संगत स्कोर दे सकता है जो फिर भी पूरी तरह गलत निर्माण को मापते हैं — क्लासिक उदाहरण एक तराजू है जो हर बार एक ही गलत वजन दिखाता है।
विश्वसनीयता और वैधता के बीच मुख्य अंतर क्या है?
विश्वसनीयता पूछती है कि क्या माप संगत है; वैधता पूछती है कि क्या वह माप वास्तव में एक विशिष्ट इच्छित उपयोग के लिए वह पकड़ता है जिसे वह मापने का दावा करता है।
वैधता और विश्वसनीयता के कुछ उदाहरण क्या हैं?
एक पक्षपाती थर्मामीटर जो हमेशा दो डिग्री अधिक दिखाता है वह विश्वसनीय है लेकिन अवैध है; एक तीन-प्रश्न वाला परीक्षण जो औसतन नौकरी प्रदर्शन की भविष्यवाणी करता है लेकिन व्यक्तियों के लिए व्यापक रूप से उतार-चढ़ाव करता है, वह वैध है लेकिन अविश्वसनीय है।
परीक्षण विश्वसनीयता को कैसे मापते हैं?
तीन सबसे सामान्य तरीके हैं test-retest सहसंबंध, आंतरिक संगति माप जैसे Cronbach's alpha, और interrater सहमति आंकड़े जैसे kappa या ICC — इस बात के आधार पर चुने जाते हैं कि परीक्षण दोहराया जाता है, प्रश्नों द्वारा स्कोर किया जाता है, या मानव रेटरों द्वारा स्कोर किया जाता है।