
Løs støjproblemer: 9 trin til testvaliditet og -pålidelighed
Validitet spørger, om en score betyder det, du har til hensigt, at den skal betyde. Reliabilitet spørger, om den pågældende score ville dukke op igen, hvis du målte den samme person i morgen. De to begreber er beslægtede, men ikke udskiftelige: reliabilitet er nødvendig, men ikke tilstrækkelig for validitet, fordi en test kan producere vidunderligt konsistente scores, der måler den forkerte ting fuldstændigt. Det følgende gennemgår typerne af evidens, de statistiske metoder, der bruges til at estimere hver enkelt, og de praktiske trin til at bygge en test, der holder til kritisk granskning på begge fronter.
TL;DR:
- Høj reliabilitet er afgørende i første omgang, da inkonsistente scores ikke kan understøtte en valid test, især når man måler egenskaber, der burde forblive stabile over tid.
- Validitet afhænger af, om testscores præcist forudsiger det tilsigtede resultat, hvor indhold, intern struktur, relationer til variabler, responsprocesser og konsekvenser tjener som centrale evidenskilder.
- Indsamling af stærk valideringsevidence kræver, at man definerer et klart formål, udarbejder en indholdsskabelon, pilottester med repræsentative stikprøver og analyserer konstrukt- og kriterierelationer.
- De fleste testproblemer stammer fra svag målestøj, som kan afhjælpes med målrettet itemdesign og standardiseret administration – ikke blot indholdsgranskning.
- Brug af rollespecifik itemgenerering og indbyggede anti-snyd-værktøjer strømliner valideringen og giver løbende evidens uden overdrevent manuelt arbejde, særligt for rollebaserede tests.
Indholdsfortegnelse
- Forståelse af testvaliditet: Hvad det faktisk betyder
- Forståelse af testreliabilitet: Konsistens frem for præcision
- Test-retest, intern konsistens og interrater-reliabilitet forklaret
- Reliabel men forkert, eller valid men støjfyldt: Forvirringen ryddet af vejen
- En trinvis plan for indsamling af validitets- og reliabilitetsevidens
- En praktisk tjekliste til stærkere tests
- Hvordan testplatforme dokumenterer validitet i praksis
- Hvad forskningen faktisk siger, du bør prioritere
- Byg validerede tests uden det manuelle evidensspor
- Kilder
- FAQ
Forståelse af testvaliditet: Hvad det faktisk betyder
Validitet er ikke en egenskab, en test bærer rundt på som et certificeringsmærkat. Det er et argument, bygget på evidens, om hvorvidt scoretolkninger understøtter en specifik tilsigtet anvendelse. En kodningstest kan være meget valid til at forudsige fejlfindingsevne på jobbet og fuldstændig ugyldig til at forudsige ledelsespotentiale, selvom det er præcis den samme test. Scoren ændrede sig ikke. Det, du påstår om scoren, gjorde.
Det er her, megen forvirring opstår. Folk spørger "er denne test valid?" som om validitet var binær, men Standards for Educational and Psychological Testing beskriver det som et samlet validitetsargument, bygget på fem evidenskilder snarere end en tjekliste over separate "typer." Disse fem kilder er:
- Indholdsevidens — repræsenterer testens items faktisk det pågældende domæne eller den pågældende færdighed?
- Intern strukturevidens — stemmer items, der er grupperet sammen, statistisk overens med de konstrukter, de formodes at måle?
- Relationer til andre variabler — korrelerer scoren med eksterne målinger på den måde, teorien forudsiger (dette dækker det, ældre lærebøger kaldte konvergent, diskriminant og kriterievaliditet)?
- Responsprocessevidens — engagerer testdeltagerne faktisk den færdighed, du har til hensigt at måle, eller udnytter de formatet?
- Konsekvensevidens — producerer brugen af testen retfærdige, tilsigtede resultater, eller utilsigtede skader for specifikke grupper?
Formålet afgør, hvilken evidens du har mest brug for. En foransættelseskodningstest lægger stor vægt på indholds- og kriterieevidens. Et personlighedsinventar til teamplacering lægger vægt på intern struktur og relationsevidens. Validitet hviler i sidste ende på, om testen forudsiger det resultat, den hævder at forudsige – ikke på, om items ser polerede ud.
Forståelse af testreliabilitet: Konsistens frem for præcision
Reliabilitet måler, om en test producerer det samme resultat under de samme betingelser, gentagne gange. Det har intet at gøre med, om resultatet er korrekt. En køkkenvægt, der viser 400 gram hver eneste gang, du lægger et halvkilogramslod på den, er fuldstændig reliabel og konsistent forkert med 100 gram.
Reliabilitet er konsistensen og reproduktionsbarheden af en måling, der angiver, hvor pålidelige resultaterne er på tværs af gentagne forsøg, mens validitet er det separate spørgsmål om præcision og mening. Enhver måling indeholder en vis mængde fejl – tilfældig støj fra træthed, distraktion, tvetydige formuleringer eller en inkonsistent bedømmer – der skubber en observeret score væk fra en persons "sande" score. Reliabilitet er i bund og grund et estimat af, hvor meget af den støj der eksisterer.
- Lav reliabilitet betyder, at scores hopper uforudsigeligt rundt mellem forsøg, sessioner eller bedømmere.
- Høj reliabilitet betyder, at scores forbliver stabile, når intet meningsfuldt ved personen har ændret sig.
- Reliabilitet sætter et loft for validitet: et kraftigt støjfyldt mål kan ikke korrelere stærkt med noget som helst, heller ikke det resultat, det formodes at forudsige.
Det sidste punkt fortjener at blive fremhævet, da det er den mekaniske forbindelse mellem de to begreber. Lav reliabilitet i en af målene begrænser den maksimale observerbare korrelation mellem dem – en effekt kaldet attenuation. Tre almindelige former for reliabilitet – test-retest, intern konsistens og interrater-overensstemmelse – fanger hver især en forskellig kilde til den støj.
Test-retest, intern konsistens og interrater-reliabilitet forklaret
Test-retest-reliabilitet måler stabilitet over tid. Du administrerer den samme test til de samme personer to gange, sædvanligvis to til fire uger fra hinanden, og korrelerer de to sæt scores. Det passer til stabile egenskaber, som generel kognitiv evne eller personlighedsdimensioner – dårligt egnede konstrukter er dem, der er tænkt til at ændre sig hurtigt, som humør eller kortvarig stress.
Intern konsistens måler, om items på en enkelt test er enige med hinanden, typisk via Cronbachs alfa. Det er den hurtigste reliabilitetscheck at udføre, fordi den kun kræver én administration, hvilket er grunden til, at den overanvendes. Alfa er følsom over for antallet af items på en test, så en lang test kan producere en oppustet alfa, selv når individuelle items er middelmådige. Omega-koefficienter håndterer dette bedre for tests med ulige itemkvalitet, selvom alfa forbliver industristandarden.
Interrater-reliabilitet er vigtig, når et menneske bedømmer noget subjektivt – en skriftlig prøve, et struktureret interview, en videobaseret opgave. Cohens kappa eller en intraklassekorrelationskoefficient (ICC) kvantificerer overensstemmelse mellem bedømmere og korrigerer for den overensstemmelse, man ville forvente af ren tilfældighed.
Pro tip: En test-retest-korrelation på et rimeligt højt niveau (ofte tæt på +.80 eller derover) behandles almindeligvis som en praktisk benchmark for stabile egenskaber. Noget, der er meningsfuldt under dette for en egenskab, der ikke burde ændre sig fra uge til uge, signalerer et designproblem, der er værd at undersøge, inden du bygger et validitetsargument ovenpå det.
Konteksten afgør, hvilken form der er mest vigtig. En færdighedstest, der scores automatisk, kræver stærk intern konsistens, men ingen interrater-check overhovedet. Et struktureret interview kræver interrater-overensstemmelse frem for næsten alt andet.
Reliabel men forkert, eller valid men støjfyldt: Forvirringen ryddet af vejen
Den klareste måde at se forskellen mellem testvaliditet og -reliabilitet på er gennem to fejltyper, der ikke ligner hinanden det mindste, men som begge ødelægger en test.
- Reliabel men ugyldig: et forvrænget termometer, der altid viser to grader for højt. Det er fuldstændig konsistent, hvilket gør det reliabelt, men hver aflæsning er forkert, hvilket gør det ugyldigt.
- Valid men upålidelig: en færdighedstest med kun tre items, der dækker en bred kompetence. I gennemsnit på tværs af mange testdeltagere korrelerer den måske rimeligt med jobpræstation, men en enkelt persons score hopper for meget rundt mellem forsøg til at stole på individuelt.
Disse eksempler besvarer de to spørgsmål, folk oftest søger efter. Hvad kommer først? Reliabilitet, funktionelt set, fordi man ikke kan bygge et forsvarligt validitetsargument på inkonsistente scores. Kan en test være reliabel uden at være valid? Ja, nemt – og det sker konstant med tests, der er internt konsistente, men simpelthen måler det forkerte konstrukt til den tilsigtede anvendelse.
Hvis din reliabilitet er stærk, men valideringsevidensen er tynd, er løsningen sædvanligvis indhold: inddrag fageksperter og kontroller, om items faktisk repræsenterer jobbet eller egenskaben. Hvis reliabiliteten selv er svag, vil ingen mængde valideringsevidens redde testen. Du er nødt til at rette målestøjen først – typisk ved at tilføje velrettede items eller stramme scoringsreglerne – inden validitetsspørgsmålet overhovedet kan besvares.
En trinvis plan for indsamling af validitets- og reliabilitetsevidens
At bygge et forsvarligt validitetsargument er en sekvens, ikke et enkelt studie. Her er den rækkefølge, der producerer evidens, du faktisk kan stå bag.
- Definer den tilsigtede anvendelse i én sætning. "Denne test forudsiger præstation i de første 90 dage i en kundesupportrolle" er specifik nok til at vejlede alle beslutninger derefter.
- Udarbejd en indholdsskabelon. List de færdigheder eller vidensdomæner, den tilsigtede anvendelse kræver, vægtet efter vigtighed, inden du skriver et eneste item.
- Gennemfør en ekspertindholdsgranskning. Lad to eller tre fageksperter uafhængigt vurdere, om hvert item passer til skabelonen, og markere alt, der er off-target.
- Pilotttest testen på en repræsentativ stikprøve. Selv 40 til 80 besvarelser afslører problemer på itemniveau – forvirrende ordlyd, lofteffekter, items ingen svarer forkert på.
- Kør en intern strukturanalyse. Brug eksplorativ eller konfirmatorisk faktoranalyse til at kontrollere, om items klynger sig, som din skabelon forudsiger, og beregn Cronbachs alfa eller omega for hver delskala.
- Kontroller konvergente og diskriminante relationer. Korrelér scores mod et etableret mål for det samme konstrukt og mod et urelateret for at bekræfte, at testen måler det, den hævder at måle.
- Indsaml kriteriedata, når det er muligt. Spor faktiske resultater – jobpræstationsvurderinger, forfremmelsesrater, fejlrater – og korrelér dem med de oprindelige scores.
- Rapportér stikprøvestørrelse, kontekst og konfidensintervaller. En reliabilitetskoefficient fra 30 personer på ét kontor betyder noget andet end én baseret på 2.000 personer på tværs af fem lande.
- Dokumentér hele argumentet. Skriv ned, hvilken evidens der blev indsamlet, hvorfor, og hvordan den understøtter den specifikke tilsigtede anvendelse defineret i trin ét.
Pro tip: Spring trin ét over, og alt nedstrøms bliver sværere at forsvare senere. Revisorer, auditører og selv dit eget team vil blive ved med at spørge "valid til hvad?" hvis den tilsigtede anvendelse aldrig blev skrevet ned i første omgang.
Teams, der bygger jobspecifikke screeningstests, springer ofte direkte til pilottestning og springer skabelontrinnet over, hvilket er præcis bagvendt. Skabelonen er det, der gør hvert efterfølgende trin fortolkeligt.
En praktisk tjekliste til stærkere tests
De fleste validitets- og reliabilitetsproblemer kan spores tilbage til en håndfuld rettelige designvalg. Inden du udgiver eller reviderer en test, bør du kontrollere følgende:
- Hvert item bør knyttes tilbage til en specifik linje i din indholdsskabelon; skær alt ud, der ikke tjener sin plads.
- Flere velrettede items slår generelt færre brede, da yderligere items reducerer målestøj og øger intern konsistens.
- Standardiser administrationsbetingelserne – tidsgrænser, instruktioner, miljø – så variation i scores afspejler personen, ikke omgivelserne.
- Træn bedømmere i en fælles rubrik og kontroller interrater-overensstemmelse, inden du stoler på en enkelt bedømmers vurdering.
- Pilotttest inden fuld udrulning, og behandl den første version som et udkast, der vil have brug for revision.
- Indsaml kriteriedata eller konvergente data, når du kan – også uformelt – og log dem sammen med resten af din evidens.
Pro tip: Arbejdsgivere, der bygger auditklare færdighedstests, finder ofte, at den største reliabilitetsgevinst kommer fra standardiseret scoring – ikke fra at tilføje spørgsmål. En uklar rubrik vil ophæve fordelen ved en velbygget itembank hver gang.
At knytte items tilbage til en faktisk jobbeskrivelse snarere end en generisk færdighedsbetegnelse strammer også indholdsevidensen betydeligt, da generiske betegnelser inviterer til generiske, lavrelevante items.
Hvordan testplatforme dokumenterer validitet i praksis
At indsamle denne evidens manuelt – regneark med itemstatistikker, separate bedømmernotes, en mappe med pilotdata – er præcis grunden til, at de fleste teams stopper ved en indholdsgranskning og kalder det færdigt. En platform bygget op om struktureret, rollespecifik testning kan komprimere den cyklus i stedet for at eliminere stringensen.
At generere items direkte fra en jobbeskrivelse eller færdighedsliste giver dig en indholdsskabelon fra første udkast, snarere end at skulle rekonstruere én, efter items allerede eksisterer. Tilfældig itemlevering og anti-snyd-overvågning – herunder skærm- og webkamtjek – styrker responsproces- og konsekvensevidensen ved at reducere chancen for, at en score afspejler snyd frem for færdighed. Eksporterbar itemstatistik, sessiongenafspilninger og præstationsoversigter forvandler det, der plejede at være en spredt valideringsmappe, til noget, der minder mere om et løbende register.
Platformens tilgang behandler hver gennemført test som et datapunkt i et løbende validitetsargument, ikke blot en ansættelsesbeslutning – og det er det, der adskiller et forsvarligt testprogram fra et mavefornemmelsesbaseret.
Hvad forskningen faktisk siger, du bør prioritere
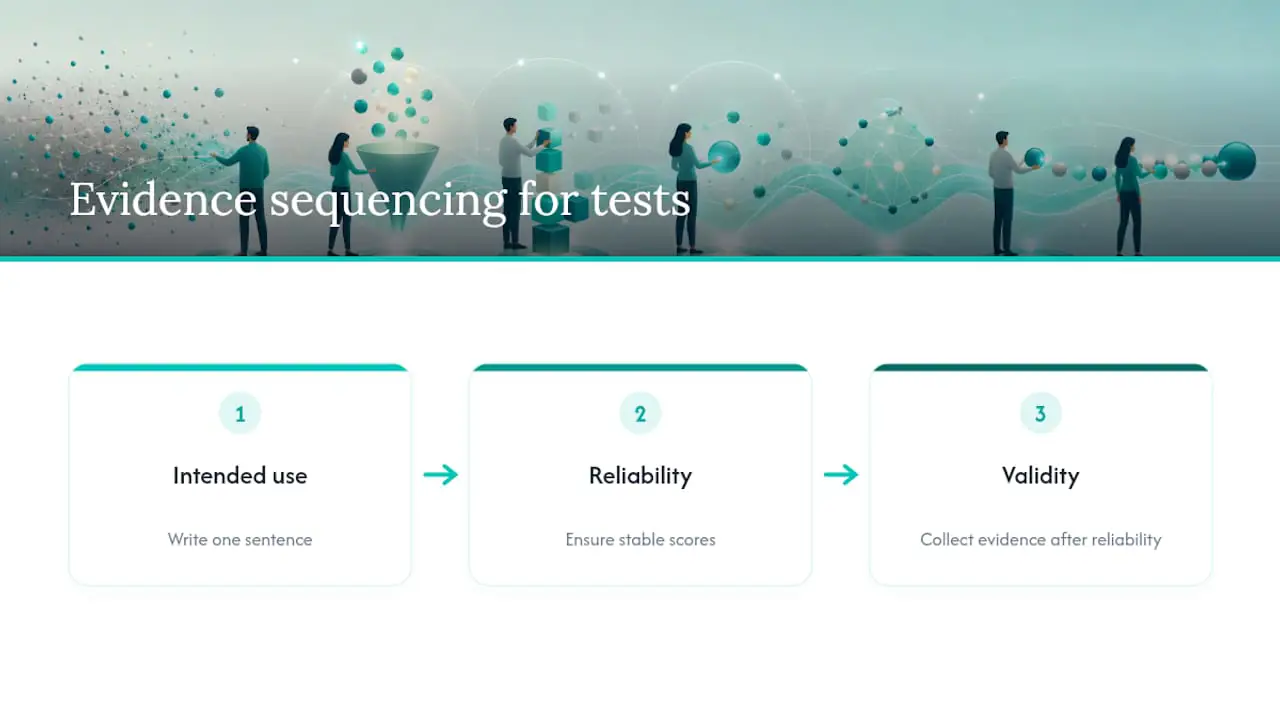
Det største hul mellem konventionel rådgivning og det, evidensen understøtter, er rækkefølge. De fleste vejledninger behandler validitet og reliabilitet som parallelle tjeklister, der skal gennemgås én gang. Det er de ikke. Reliabilitet er gulvet; validitet er det, du bygger ovenpå, og ingen mængde ekspertindholdsgranskning redder en test, hvis scores hopper rundt fra én session til den næste.
Det andet hul er mere ubehageligt: teams elsker indholdsevidens, fordi den er billig og hurtig – tre eksperter, én eftermiddag, færdigt. Kriterieevidens – faktisk at kontrollere, om scores forudsiger det resultat, de hævder at forudsige – springes over næsten overalt uden for akademisk forskning, fordi det kræver tålmodighed og resultatdata, som de fleste ansættelsesteams aldrig gider indsamle.
Hvis du tager én ting med fra dette, så tag dette: skriv din tilsigtede anvendelse ned i én enkelt sætning, inden du skriver et eneste item. Alt andet – skabelonen, statistikkerne, bedømmertræningen – fungerer kun, hvis den sætning er præcis. Vag tilsigtet anvendelse producerer vag evidens, uanset hvor sofistikeret faktoranalysen ser ud.
— Jimmie
Byg validerede tests uden det manuelle evidensspor
At dokumentere et validitetsargument manuelt – spore itemstatistik i ét regneark, bedømmernotes i et andet, pilotdata et tredje sted – er præcis den slags arbejde, der stille og roligt springes over under deadline-pres. Et værktøj genererer rollespecifikke items direkte fra en jobbeskrivelse og giver dig en indholdsskabelon, inden du har skrevet et eneste spørgsmål, mens indbygget anti-snyd-overvågning og sessiongenafspilninger tilføjer den responsprocessevidens, de fleste teams aldrig indsamler overhovedet.
Der er intet abonnement at forpligte sig til. Du betaler pr. gennemført kandidat, så omkostningerne skalerer med den ansættelse, du faktisk foretager – ikke et fast licensgebyr. Hvis du evaluerer færdigheder til en specifik rolle og ønsker reliabilitets- og valideringsevidensen indbygget i processen frem for samlet efter kendsgerningen, kan du tjekke platformen ud og se, hvordan en jobbeskrivelse bliver til en testbar, forsvarlig test på få minutter.
Kilder
Klassiske lærebøger underviser stadig i indhold, konstrukt og kriterievaliditet, som om de er tre separate bokse, der skal afkrydses. Moderne psykometri behandler dem som facetter af ét argument, og nogle eksperter argumenterer eksplicit imod at isolere dem, fordi en test kan se fin ud på én facet og fejle markant på en anden. Her er, hvordan evidensen faktisk fordeler sig efter hvornår og hvordan du indsamler den:
- Reliability vs Validity in Research
- An introduction to validity in educational and psychological testing
- Validity for Assessments
- Reliability and validity of measurement (LibreTexts)
At skelne mellem ekspertvurdering forud for data og statistiske kontroller efter data er vigtigt, fordi teams ofte stopper ved trin ét. En indholdsgranskning fra tre fageksperter føles grundig, men den siger ingenting om, hvorvidt testen forudsiger noget reelt.
FAQ
Hvad kommer først, validitet eller reliabilitet?
Reliabilitet kommer funktionelt set først. Du kan ikke bygge et overbevisende validitetsargument på scores, der ikke er konsistente – selvom reliabilitet alene aldrig beviser, at en test er valid.
Kan en test have reliabilitet uden validitet?
Ja. En test kan producere meget konsistente scores, der stadig måler det forkerte konstrukt fuldstændigt – det klassiske eksempel er en vægt, der viser den samme forkerte vægt hver gang.
Hvad er den vigtigste forskel mellem reliabilitet og validitet?
Reliabilitet spørger, om en måling er konsistent; validitet spørger, om den måling faktisk fanger det, den hævder at måle, til en specifik tilsigtet anvendelse.
Hvad er nogle eksempler på validitet og reliabilitet?
Et forvrænget termometer, der altid viser to grader for højt, er reliabelt men ugyldigt; en tre-items-test, der i gennemsnit forudsiger jobpræstation, men svinger meget for enkeltpersoner, er valid men upålidelig.
Hvordan måler man testreliabilitet?
De tre mest almindelige metoder er test-retest-korrelationer, mål for intern konsistens som Cronbachs alfa og interrater-overensstemmelsesstatistikker som kappa eller ICC – valgt ud fra, om testen gentages, scores på itemniveau eller scores af menneskelige bedømmere.