
Fiks støy: 9 trinn for assessorer om testvaliditet og reliabilitet
Validitet spør om en score betyr det du har tenkt at den skal bety. Reliabilitet spør om den samme scoren ville dukket opp igjen hvis du målte den samme personen i morgen. De to er relaterte, men ikke utskiftbare: reliabilitet er nødvendig, men ikke tilstrekkelig for validitet, fordi en test kan produsere forbløffende konsistente scores som måler fullstendig feil ting. Det som følger bryter ned typene av evidens, statistikken som brukes til å estimere hver av dem, og de praktiske stegene for å bygge en vurdering som holder mål under begge.
TL;DR:
- Høy reliabilitet er avgjørende først, siden inkonsistente scores ikke kan støtte en valid vurdering, særlig når man måler egenskaper som bør forbli stabile over tid.
- Validitet avhenger av om testscorene nøyaktig forutsier det tiltenkte utfallet, med innhold, intern struktur, relasjoner til variabler, responsprosesser og konsekvenser som viktige evidenskilder.
- Å samle inn solid valideringsbevis krever at man definerer et tydelig formål, bygger en innholdsplan, pilottester med representative utvalg og analyserer konstrukt- og kriterieforhold.
- De fleste vurderingsproblemer stammer fra svak målestøy, som kan utbedres gjennom målrettet oppgavedesign og standardisert gjennomføring, ikke bare innholdsgjennomgang.
- Bruk av rollespesifikk oppgavegenerering og innebygde anti-juks-verktøy effektiviserer valideringen og gir løpende bevis uten overdrevent manuelt arbeid, særlig for rollebaserte vurderinger.
Innholdsfortegnelse
- Forstå testvaliditet: Hva det faktisk betyr
- Forstå testreliabilitet: Konsistens fremfor nøyaktighet
- Test-retest, intern konsistens og interrater-reliabilitet forklart
- Reliabel men feil, eller valid men støyende: Forvirringen ryddet opp i
- En trinn-for-trinn-plan for å samle inn validitets- og reliabilitetsbevis
- En praktisk sjekkliste for sterkere vurderinger
- Hvordan vurderingsplattformer dokumenterer validitet i praksis
- Hva forskningen faktisk sier du bør prioritere
- Bygg validerte vurderinger uten det manuelle bevisspor
- Kilder
- FAQ
Forstå testvaliditet: Hva det faktisk betyr
Validitet er ikke en egenskap en test bærer rundt som et sertifiseringsmerke. Det er et argument, bygget på evidens, om hvorvidt scorefortolkninger støtter en spesifikk tiltenkt bruk. En kodingsvurdering kan være svært valid for å forutsi feilsøkingsprestasjon i jobben og fullstendig ugyldig for å forutsi lederpotensial, selv om det er nøyaktig den samme testen. Scoren endret seg ikke. Det er påstanden du gjør om scoren som endret seg.
Det er her mye forvirring starter. Folk spør «er denne testen valid?» som om validitet var binært, men Standards for Educational and Psychological Testing framstiller det som et enhetlig validitetsargument, bygget fra fem evidenskilder snarere enn en sjekkliste av separate «typer». Disse fem kildene er:
- Innholdsevidens — representerer testoppgavene faktisk domenet eller ferdigheten det gjelder?
- Intern strukturevidens — samsvarer oppgaver som er gruppert sammen statistisk med konstruktene de er ment å måle?
- Relasjoner til andre variabler — korrelerer scoren med eksterne mål slik teorien forutsier (dette dekker det eldre lærebøker kalte konvergent, diskriminant og kriterievaliditet)?
- Responsprossessevidens — engasjerer testdeltakerne faktisk den ferdigheten du har tenkt å måle, eller utnytter de formatet?
- Konsekvensevidens — produserer bruken av testen rettferdige, tiltenkte utfall, eller utilsiktede skader for bestemte grupper?
Formålet avgjør hvilken evidens du trenger mest. En forhåndsansettelsestest i koding støtter seg tungt på innholds- og kriteriebevis. Et personlighetsinventar brukt til teamplassering støtter seg på intern struktur og relasjonsevidens. Validitet hviler til syvende og sist på om testen forutsier det utfallet den hevder å forutsi, ikke på om oppgavene ser polerte ut.
Forstå testreliabilitet: Konsistens fremfor nøyaktighet
Reliabilitet måler om en test produserer det samme resultatet under de samme forholdene, gjentatte ganger. Det har ingenting å gjøre med om resultatet er korrekt. En kjøkkenvekt som viser 14 unser hver eneste gang du legger et halvkilolodd på den, er perfekt reliabel og konsekvent feil med to unser.
Reliabilitet er konsistensen og reproduserbarheten til en måling, og indikerer hvor pålitelige resultatene er over gjentatte forsøk, mens validitet er det separate spørsmålet om nøyaktighet og betydning. Enhver måling inneholder noe målefeil – tilfeldig støy fra tretthet, distraksjon, tvetydig ordlyd eller en inkonsistent bedømmer som dytter en observert score bort fra en persons «sanne» score. Reliabilitet er egentlig et estimat av hvor mye av denne støyen som eksisterer.
- Lav reliabilitet betyr at scorer spretter uforutsigbart mellom forsøk, sesjoner eller bedømmere.
- Høy reliabilitet betyr at scorer forblir stabile når ingenting meningsfylt ved personen har endret seg.
- Reliabilitet setter et tak på validitet: et kraftig støyende mål kan ikke korrelere sterkt med noe som helst, inkludert utfallet det er ment å forutsi.
Dette siste punktet fortjener vekt, fordi det er den mekaniske koblingen mellom de to begrepene. Lav reliabilitet i enten målet begrenser den maksimale observerbare korrelasjonen mellom dem – en effekt kalt attenuasjon. Tre vanlige former for reliabilitet – test-retest, intern konsistens og interrater-samsvar – fanger hver sin ulike kilde til denne støyen.
Test-retest, intern konsistens og interrater-reliabilitet forklart
Test-retest-reliabilitet måler stabilitet over tid. Du administrerer den samme testen til de samme personene to ganger, vanligvis to til fire uker fra hverandre, og korrelerer de to settene med scorer. Det passer stabile egenskaper, som generell kognitiv evne eller personlighetsdimensjoner, og er dårlig egnet for konstrukter som er ment å endre seg raskt, som humør eller kortsiktig stress.
Intern konsistens måler om oppgavene på en enkelt test er enige med hverandre, typisk via Cronbachs alfa. Det er den raskeste reliabilitetskontrollen å kjøre fordi den bare krever én administrering, noe som er grunnen til at den blir overbrukt. Alfa er sensitiv for antall oppgaver på en test, slik at en lang test kan gi oppblåst alfa selv når individuelle oppgaver er middelmådige. Omega-koeffisienter håndterer dette bedre for tester med ulik oppgavekvalitet, selv om alfa forblir bransjestandardens valg.
Interrater-reliabilitet er viktig når et menneske bedømmer noe subjektivt – en skriveprøve, et strukturert intervju, en videobasert oppgave. Cohens kappa eller en intraklassekorrelsjonskoeffisient (ICC) kvantifiserer samsvar mellom bedømmere og korrigerer for det samsvaret man ville forvente ved ren tilfeldighet.
Pro-tips: En test-retest-korrelasjon på et rimelig høyt nivå (ofte nær +.80 eller høyere) behandles vanligvis som en praktisk referanseverdi for stabile egenskaper. Noe som er meningsfylt lavere enn det på en egenskap som ikke burde endre seg fra uke til uke, signaliserer et designproblem det er verdt å undersøke før du bygger noe validitetsargument på toppen av det.
Konteksten avgjør hvilken form som er viktigst. En ferdighettest som scores automatisk trenger sterk intern konsistens, men ingen interrater-sjekk i det hele tatt. Et strukturert intervju trenger interrater-samsvar over nesten alt annet.
Reliabel men feil, eller valid men støyende: Forvirringen ryddet opp i
Den reneste måten å se forskjellen mellom testvaliditet og testreliabilitet er gjennom to feilmoduser som ikke ligner hverandre i det hele tatt, men som begge ødelegger en vurdering.
- Reliabel men ugyldig: et partisk termometer som leser to grader for høyt hver eneste gang. Det er fullstendig konsistent, noe som gjør det reliabelt, men hver avlesning er feil, noe som gjør det ugyldig.
- Valid men upålitelig: en ferdighettest med bare tre oppgaver som dekker en bred kompetanse. I gjennomsnitt på tvers av mange testdeltakere kan den korrelere rimelig godt med jobbprestasjon, men en hvilken som helst persons score spretter for mye mellom forsøk til å stole på individuelt.
Disse eksemplene besvarer de to spørsmålene folk søker mest etter. Hva kommer først? Reliabilitet, funksjonelt sett, fordi du ikke kan bygge et forsvarlig validitetsargument på toppen av inkonsistente scorer. Kan en test være reliabel uten å være valid? Ja, lett, og det skjer kontinuerlig med tester som er internt konsistente, men som rett og slett måler feil konstrukt for den tiltenkte bruken.
Hvis reliabiliteten din er sterk, men validitetsevidensen er tynn, er løsningen vanligvis innhold: trekk inn fageksperter og sjekk om oppgavene faktisk representerer jobben eller egenskapen. Hvis reliabiliteten i seg selv er svak, vil ingen mengde validitetsevidens redde testen. Du må fikse målestøyen først – typisk ved å legge til godt målrettede oppgaver eller stramme inn scoringsreglene – før validitetsspørsmålet i det hele tatt er besvart.
En trinn-for-trinn-plan for å samle inn validitets- og reliabilitetsbevis
Å bygge et forsvarlig validitetsargument er en sekvens, ikke én enkelt studie. Her er rekkefølgen som produserer bevis du faktisk kan stå bak.
- Definer den tiltenkte bruken i én setning. «Denne vurderingen forutsier prestasjon de første 90 dagene i en kundesupportrolle» er spesifikt nok til å veilede alle avgjørelser etter det.
- Bygg en innholdsplan. List opp ferdighetene eller kunnskapsdomene den tiltenkte bruken krever, vektet etter viktighet, før du skriver en eneste oppgave.
- Kjør en ekspertinnholdsgjennomgang. La to eller tre fageksperter uavhengig vurdere om hver oppgave kartlegges til planen og flagg alt som er utenfor mål.
- Pilottest testen på et representativt utvalg. Selv 40 til 80 svar avslører problemer på oppgavenivå – forvirrende ordlyd, takeffekter, oppgaver ingen svarer feil på.
- Kjør intern strukturanalyse. Bruk eksplorativ eller konfirmatorisk faktoranalyse for å sjekke om oppgavene klynger seg slik planen din forutsier, og beregn Cronbachs alfa eller omega for hver delskala.
- Sjekk konvergente og diskriminante relasjoner. Korreler scorer mot et etablert mål på det samme konstruktet og mot et urelatert for å bekrefte at testen måler det den hevder å måle.
- Samle inn kriteriedata når det er mulig. Spor faktiske utfall – jobbprestasjonsrangeringer, forfremmelsesrater, feilrater – og korreler dem mot de opprinnelige scorene.
- Rapporter utvalgsstørrelse, kontekst og konfidensintervaller. En reliabilitetskoeffisient fra 30 personer på ett kontor betyr noe annet enn én basert på 2 000 personer på tvers av fem land.
- Dokumenter hele argumentet. Skriv ned hvilken evidens som ble samlet inn, hvorfor, og hvordan det støtter den spesifikke tiltenkte bruken definert i trinn én.
Pro-tips: Hopp over trinn én, og alt nedstrøms blir vanskeligere å forsvare senere. Gjennomgangspersoner, revisorer og til og med ditt eget team vil fortsette å spørre «valid for hva?» hvis den tiltenkte bruken aldri ble skrevet ned i utgangspunktet.
Team som bygger jobspesifikke screener-tester snarveier ofte rett til pilottesting og hopper over plansteget, noe som er nøyaktig bakvendt. Planen er det som gjør hvert etterfølgende steg tolkbart.
En praktisk sjekkliste for sterkere vurderinger
De fleste validitets- og reliabilitetsproblemer kan spores tilbake til en håndfull fikserbare designvalg. Før du lanserer eller reviderer en vurdering, sjekk disse:
- Hver oppgave bør kartlegges tilbake til en spesifikk linje i innholdsplanen din; fjern alt som ikke tjener sin plass.
- Flere godt målrettede oppgaver slår generelt færre brede oppgaver, siden ekstra oppgaver reduserer målestøy og øker intern konsistens.
- Standardiser administrasjonsbetingelsene – tidsgrenser, instruksjoner, miljø – slik at variasjon i scorer gjenspeiler personen, ikke settingen.
- Tren bedømmere på en felles rubrikk og sjekk interrater-samsvar før du stoler på noen enkelt bedømmers vurdering.
- Pilottest før full utrulling, og behandle den første versjonen som et utkast som trenger revisjon.
- Samle inn kriterier eller konvergente data når du kan, selv uformelt, og logg det ved siden av resten av evidensen din.
Pro-tips: Arbeidsgivere som bygger revisjonsklare ferdighetstester opplever ofte at den største reliabilitetsgevinsten kommer fra å standardisere scoringen, ikke fra å legge til spørsmål. En vag rubrikk vil annullere fordelen med en godt bygget oppgavebank hver gang.
Å kartlegge oppgaver tilbake til en faktisk stillingsbeskrivelse snarere enn en generisk ferdighetsetikett strammer også inn innholdsevidensen betraktelig, siden generiske etiketter inviterer til generiske, lite relevante oppgaver.
Hvordan vurderingsplattformer dokumenterer validitet i praksis
Å samle inn denne evidensen for hånd – regneark med oppgavestatistikk, separate bedømmernotes, en mappe med pilotdata – er nøyaktig grunnen til at de fleste team stopper ved en innholdsgjennomgang og kaller det ferdig. En plattform bygget rundt strukturert, rollespesifikk testing kan komprimere den syklusen i stedet for å eliminere grundigheten.
Å generere oppgaver direkte fra en stillingsbeskrivelse eller ferdighetsliste gir deg en innholdsplan fra første utkast, i stedet for å baklengs-konstruere en etter at oppgavene allerede eksisterer. Tilfeldig oppgavelevering og anti-juks-overvåking – inkludert skjerm- og webkamerasjekker – styrker responsprosess- og konsekvensevidensen ved å redusere sjansen for at en score gjenspeiler juks snarere enn ferdighet. Eksporterbar oppgavestatistikk, sesjonsavspillinger og prestasjonssammendrag gjør det som tidligere var en spredt valideringsmappe til noe nærmere et løpende register.
Plattformens tilnærming behandler hver fullført vurdering som et datapunkt i et pågående validitetsargument, ikke bare en ansettelsesavgjørelse, og det er det som skiller et forsvarlig testprogram fra et magefølelse-basert program.
Hva forskningen faktisk sier du bør prioritere
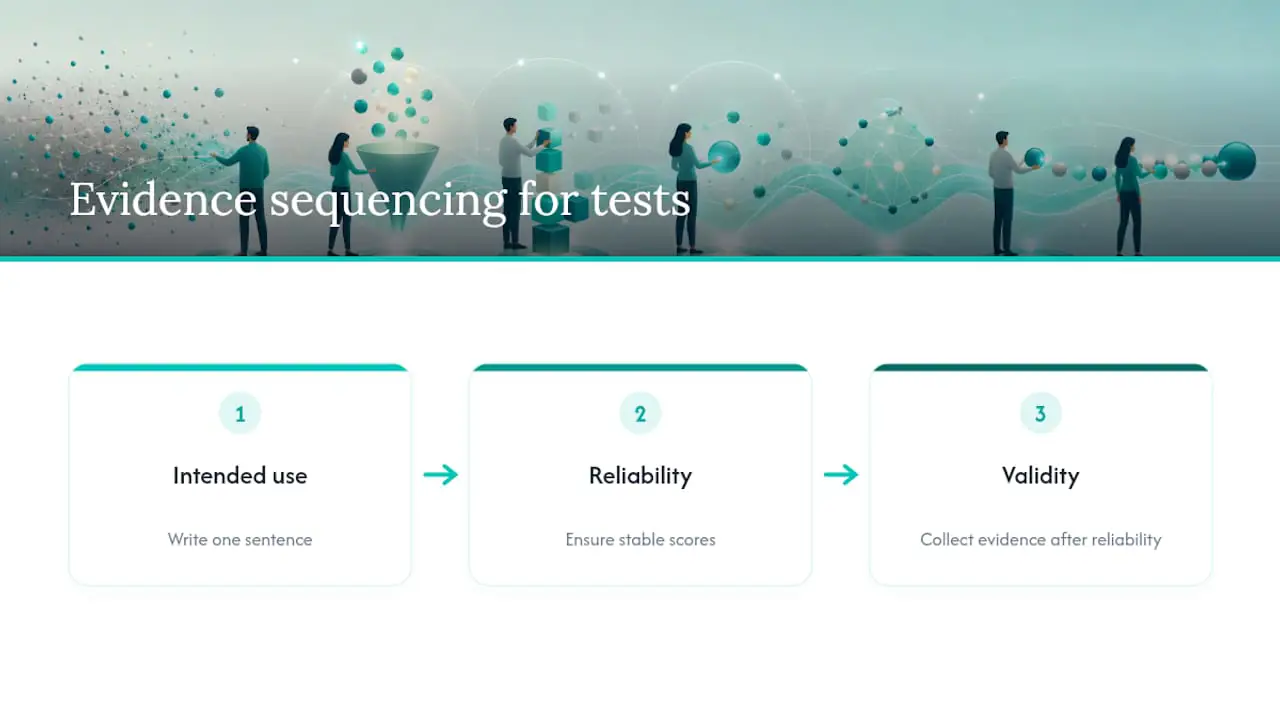
Det største gapet mellom konvensjonelle råd og det evidensen støtter, er sekvensering. De fleste veiledninger behandler validitet og reliabilitet som parallelle sjekklister man går gjennom én gang. Det er de ikke. Reliabilitet er gulvet; validitet er det du bygger oppå det, og ingen mengde ekspertinnholdsgjennomgang redder en test hvis scorer spretter fra én sittende til den neste.
Det andre gapet er mer ubehagelig: team elsker innholdsevidens fordi det er billig og raskt – tre eksperter, én ettermiddag, ferdig. Kriterievidens – å faktisk sjekke om scorer forutsier det utfallet du hevder de forutsier – hoppes over nesten overalt utenfor akademisk forskning, fordi det krever tålmodighet og utfallsdata som de fleste ansettelsesgrupper aldri gidder å samle inn.
Hvis du tar med deg én ting fra dette, ta dette: skriv ned den tiltenkte bruken din i én enkelt setning før du skriver en eneste oppgave. Alt annet – planen, statistikken, bedømmeropplæringen – fungerer bare hvis den setningen er presis. Vag tiltenkt bruk produserer vag evidens, uansett hvor sofistikert faktoranalysen ser ut.
— Jimmie
Bygg validerte vurderinger uten det manuelle bevisspor
Å dokumentere et validitetsargument for hånd – spore oppgavestatistikk i ett regneark, bedømmernotes i et annet, pilotdata et annet sted – er nøyaktig den typen arbeid som stille og rolig hoppes over under tidsfristpress. Et verktøy genererer rollespesifikke oppgaver rett fra en stillingsbeskrivelse og gir deg en innholdsplan før du har skrevet ett eneste spørsmål, mens innebygd anti-juks-overvåking og sesjonsavspillinger legger til responsprossess-evidensen de fleste team aldri samler inn i det hele tatt.
Det er ikke noe abonnement å binde seg til. Du betaler per fullført kandidat, slik at kostnaden skalerer med ansettelsen du faktisk gjør, ikke en fast lisensavgift. Hvis du vurderer ferdigheter for en spesifikk rolle og ønsker reliabilitets- og validitetsevidensen innebygd i prosessen snarere enn satt sammen i ettertid, sjekk ut plattformen og se hvordan en stillingsbeskrivelse blir til en testbar, forsvarlig vurdering på minutter.
Kilder
Klassiske lærebøker underviser fortsatt innholds-, konstrukt- og kriterievaliditet som om de er tre separate bokser å huke av. Moderne psykometri behandler dem som fasetter av ett argument, og noen eksperter argumenterer eksplisitt mot å isolere dem fordi en test kan se fin ut på én fasett og feile kraftig på en annen. Her er hvordan evidensen faktisk brytes ned etter når og hvordan du samler den inn:
- Reliabilitet vs. validitet i forskning
- En introduksjon til validitet i utdannings- og psykologisk testing
- Validitet for vurderinger
- Reliabilitet og validitet i måling (LibreTexts)
Å skille ekspertvurdering før data fra statistiske kontroller etter data er viktig fordi team ofte stopper ved trinn én. En innholdsgjennomgang fra tre fageksperter føles grundig, men den sier ingenting om hvorvidt testen forutsier noe reelt.
FAQ
Hva kommer først, validitet eller reliabilitet?
Reliabilitet kommer funksjonelt sett først. Du kan ikke bygge et overbevisende validitetsargument på scorer som ikke er konsistente, selv om reliabilitet alene aldri beviser at en test er valid.
Kan en test ha reliabilitet uten validitet?
Ja. En test kan produsere svært konsistente scorer som likevel måler fullstendig feil konstrukt – det klassiske eksempelet er en vekt som leser den samme feilaktige vekten hver gang.
Hva er den viktigste forskjellen mellom reliabilitet og validitet?
Reliabilitet spør om en måling er konsistent; validitet spør om den målingen faktisk fanger det den hevder å måle for en spesifikk tiltenkt bruk.
Hva er noen eksempler på validitet og reliabilitet?
Et partisk termometer som alltid leser to grader for høyt er reliabelt men ugyldig; en treoppgavetest som forutsier jobbprestasjon i gjennomsnitt, men svinger mye for enkeltpersoner, er valid men upålitelig.
Hvordan måler du testreliabilitet?
De tre vanligste metodene er test-retest-korrelasjoner, intern konsistensmål som Cronbachs alfa, og interrater-samsvarstatistikk som kappa eller ICC, valgt basert på om testen gjentas, scores etter oppgaver eller scores av menneskelige bedømmere.