
Rauschen beheben: 9 Schritte für Assessoren zu Testvalidität und -reliabilität
Validität fragt, ob ein Testergebnis das misst, was man mit ihm messen möchte. Reliabilität fragt, ob dieses Ergebnis morgen wieder erscheinen würde, wenn man dieselbe Person erneut testet. Die beiden Konzepte hängen zusammen, sind aber nicht austauschbar: Reliabilität ist notwendig, aber nicht hinreichend für Validität, denn ein Test kann wunderbar konsistente Ergebnisse liefern, die vollständig das Falsche messen. Im Folgenden werden die Arten von Evidenz, die zur Schätzung verwendeten Statistiken und die praktischen Schritte zum Aufbau eines Assessments erläutert, das beiden Anforderungen standhält.
Zusammenfassung:
- Hohe Reliabilität ist zunächst unerlässlich, da inkonsistente Ergebnisse kein valides Assessment stützen können – insbesondere wenn Eigenschaften gemessen werden, die über die Zeit stabil bleiben sollten.
- Validität hängt davon ab, ob die Testergebnisse das beabsichtigte Ergebnis zuverlässig vorhersagen; dabei dienen Inhalt, interne Struktur, Beziehungen zu anderen Variablen, Antwortprozesse und Konsequenzen als zentrale Evidenzquellen.
- Die Gewinnung belastbarer Validitätsnachweise erfordert eine klare Zweckdefinition, die Erstellung eines Inhaltsplans, Pilotierungen mit repräsentativen Stichproben sowie die Analyse von Konstrukt- und Kriteriumsbeziehungen.
- Die meisten Assessmentprobleme entstehen durch schwachen Messfehler, dem durch gezieltes Item-Design und standardisierte Durchführung begegnet werden kann – nicht nur durch inhaltliche Überprüfung.
- Rollenspezifische Item-Generierung und integrierte Anti-Betrugs-Tools vereinfachen die Validierung und liefern fortlaufend Evidenz ohne übermäßigen manuellen Aufwand, insbesondere bei rollenbasierten Assessments.
Inhaltsverzeichnis
- Testvalidität verstehen: Was sie wirklich bedeutet
- Testreliabilität verstehen: Konsistenz vor Genauigkeit
- Test-Retest-, interne Konsistenz- und Interrater-Reliabilität erklärt
- Reliabel, aber falsch – oder valide, aber fehlerbehaftet: Die Verwirrung aufgeklärt
- Ein Schritt-für-Schritt-Plan zur Gewinnung von Validitäts- und Reliabilitätsnachweisen
- Eine praktische Checkliste für bessere Assessments
- Wie Assessment-Plattformen Validität in der Praxis dokumentieren
- Was die Forschung wirklich empfiehlt zu priorisieren
- Validierte Assessments ohne manuelle Nachweispflege erstellen
- Quellen
- FAQ
Testvalidität verstehen: Was sie wirklich bedeutet
Validität ist keine Eigenschaft, die ein Test wie ein Zertifizierungsaufkleber mit sich trägt. Sie ist ein Argument, das aus Evidenz aufgebaut wird und beantwortet, ob Ergebnisinterpretationen einen bestimmten beabsichtigten Verwendungszweck stützen. Ein Coding-Assessment kann für die Vorhersage von Debugging-Leistung im Job hochvalide und für die Vorhersage von Führungspotenzial vollständig invalide sein – obwohl es exakt derselbe Test ist. Das Ergebnis hat sich nicht geändert. Die Aussage, die man über das Ergebnis trifft, schon.
Hier beginnt vielfach die Verwirrung. Menschen fragen „Ist dieser Test valide?", als ob Validität binär wäre, aber die Standards für pädagogisches und psychologisches Testen betrachten sie als ein einheitliches Validitätsargument, das aus fünf Evidenzquellen besteht, anstatt einer Checkliste separater „Typen". Diese fünf Quellen sind:
- Inhaltsevidence – Repräsentieren die Testitems tatsächlich den betreffenden Bereich oder die betreffende Fähigkeit?
- Evidence zur internen Struktur – Stimmen statistisch zusammengefasste Items mit den Konstrukten überein, die sie messen sollen?
- Beziehungen zu anderen Variablen – Korreliert das Ergebnis mit externen Maßen so, wie die Theorie es vorhersagt (dies umfasst das, was ältere Lehrbücher konvergente, diskriminante und Kriteriumsvalidität nannten)?
- Evidence zu Antwortprozessen – Nutzen die Testteilnehmer tatsächlich die Fähigkeit, die gemessen werden soll, oder umgehen sie das Format?
- Konsequenzenevidence – Führt der Einsatz des Tests zu fairen, beabsichtigten Ergebnissen oder zu unbeabsichtigten Nachteilen für bestimmte Gruppen?
Der Verwendungszweck bestimmt, welche Evidenz am dringendsten benötigt wird. Ein Coding-Test für Bewerbungen stützt sich stark auf Inhalts- und Kriteriumsevidence. Ein Persönlichkeitsinventar für die Teamzusammenstellung stützt sich auf Evidence zur internen Struktur und zu Beziehungen. Validität hängt letztlich davon ab, ob der Test das Ergebnis vorhersagt, das er vorherzusagen beansprucht – nicht davon, ob die Items poliert aussehen.
Testreliabilität verstehen: Konsistenz vor Genauigkeit
Reliabilität misst, ob ein Test unter gleichen Bedingungen wiederholt dasselbe Ergebnis liefert. Sie hat nichts damit zu tun, ob das Ergebnis korrekt ist. Eine Küchenwaage, die jedes Mal 400 Gramm anzeigt, wenn man ein 500-Gramm-Gewicht darauflegt, ist vollkommen reliabel und dabei konsequent um 100 Gramm falsch.
Reliabilität ist die Konsistenz und Reproduzierbarkeit einer Messung und gibt an, wie verlässlich die Ergebnisse über wiederholte Versuche hinweg sind, während Validität die separate Frage nach Genauigkeit und Bedeutung stellt. Jede Messung enthält eine gewisse Menge an Fehler – zufälliges Rauschen durch Müdigkeit, Ablenkung, unklare Formulierungen oder einen inkonsistenten Bewerter –, das einen beobachteten Wert vom „wahren" Wert einer Person wegschiebt. Reliabilität ist im Wesentlichen eine Schätzung, wie viel dieses Rauschens vorhanden ist.
- Niedrige Reliabilität bedeutet, dass Ergebnisse zwischen Versuchen, Sitzungen oder Bewertern unvorhersehbar schwanken.
- Hohe Reliabilität bedeutet, dass Ergebnisse stabil bleiben, wenn sich an der Person nichts Wesentliches geändert hat.
- Reliabilität setzt eine Obergrenze für Validität: Ein stark fehlerbehaftetes Maß kann mit nichts stark korrelieren, einschließlich des Ergebnisses, das es vorhersagen soll.
Dieser letzte Punkt verdient Betonung, denn er bildet die mechanische Verbindung zwischen den beiden Konzepten. Niedrige Reliabilität in einem der Maße begrenzt die maximal beobachtbare Korrelation zwischen ihnen – ein Effekt, der als Attenuierung bezeichnet wird. Drei häufige Formen der Reliabilität – Test-Retest, interne Konsistenz und Interrater-Übereinstimmung – erfassen jeweils eine andere Quelle dieses Rauschens.
Test-Retest-, interne Konsistenz- und Interrater-Reliabilität erklärt
Test-Retest-Reliabilität misst Stabilität über die Zeit. Man gibt denselben Personen denselben Test zweimal vor – üblicherweise zwei bis vier Wochen auseinander – und korreliert die beiden Ergebnismengen. Sie eignet sich für stabile Merkmale wie allgemeine kognitive Fähigkeiten oder Persönlichkeitsdimensionen, nicht für Konstrukte, die sich schnell ändern sollen, wie Stimmung oder kurzfristiger Stress.
Interne Konsistenz misst, ob die Items eines einzelnen Tests miteinander übereinstimmen, typischerweise über Cronbachs Alpha. Es ist die schnellste Reliabilitätsprüfung, da sie nur eine Durchführung erfordert – weshalb sie übermäßig eingesetzt wird. Alpha ist sensitiv für die Anzahl der Items in einem Test, sodass ein langer Test ein aufgeblähtes Alpha produzieren kann, selbst wenn einzelne Items mittelmäßig sind. Omega-Koeffizienten gehen mit dieser Situation bei Tests mit ungleicher Item-Qualität besser um, obwohl Alpha der Branchenstandard bleibt.
Interrater-Reliabilität ist wichtig, wenn Menschen etwas Subjektives bewerten – eine Schreibprobe, ein strukturiertes Interview, eine videobasierte Aufgabe. Cohens Kappa oder ein Intraklassen-Korrelationskoeffizient (ICC) quantifiziert die Übereinstimmung zwischen Bewertern und korrigiert dabei für die Übereinstimmung, die allein durch Zufall erwartet würde.
Profi-Tipp: Eine Test-Retest-Korrelation auf einem hinreichend hohen Niveau (oft nahe +,80 oder höher) gilt allgemein als praktischer Richtwert für stabile Merkmale. Alles, was bei einem Merkmal, das sich von Woche zu Woche nicht ändern sollte, deutlich darunter liegt, weist auf ein Designproblem hin, das es wert ist, untersucht zu werden, bevor man ein Validitätsargument darauf aufbaut.
Der Kontext entscheidet, welche Form am wichtigsten ist. Ein automatisch bewerteter Kompetenztest benötigt starke interne Konsistenz, aber keinerlei Interrater-Prüfung. Ein strukturiertes Interview benötigt Interrater-Übereinstimmung über nahezu allem anderen.
Reliabel, aber falsch – oder valide, aber fehlerbehaftet: Die Verwirrung aufgeklärt
Der klarste Weg, den Unterschied zwischen Testvalidität und -reliabilität zu sehen, sind zwei Versagensmuster, die völlig unterschiedlich aussehen, aber beide ein Assessment zunichtemachen.
- Reliabel, aber invalide: ein verzerrtes Thermometer, das jedes Mal zwei Grad zu hoch anzeigt. Es ist vollkommen konsistent – was es reliabel macht –, aber jede Messung ist falsch – was es invalide macht.
- Valide, aber unreliabel: ein Kompetenztest mit nur drei Items, die eine breite Fähigkeit abdecken. Im Durchschnitt über viele Testteilnehmer hinweg könnte er mäßig mit der Arbeitsleistung korrelieren, aber das Ergebnis einer einzelnen Person schwankt zwischen den Versuchen zu stark, um ihr individuell vertrauen zu können.
Diese Beispiele beantworten die zwei am häufigsten gesuchten Fragen. Was kommt zuerst? Reliabilität, funktional gesehen, denn man kann kein vertretbares Validitätsargument auf inkonsistenten Ergebnissen aufbauen. Kann ein Test reliabel sein ohne valide zu sein? Ja, leicht, und es passiert ständig bei Tests, die intern konsistent sind, aber schlicht das falsche Konstrukt für den beabsichtigten Verwendungszweck messen.
Wenn die Reliabilität stark ist, aber die Validitätsnachweise dünn sind, liegt die Lösung meist im Inhalt: Fachexperten hinzuziehen und prüfen, ob Items tatsächlich den Job oder das Merkmal repräsentieren. Wenn die Reliabilität selbst schwach ist, wird keine Menge an Validitätsnachweisen den Test retten. Man muss zuerst den Messfehler beheben – typischerweise durch Hinzufügen gezielt ausgerichteter Items oder das Straffen von Bewertungsregeln –, bevor die Validitätsfrage überhaupt beantwortbar ist.
Ein Schritt-für-Schritt-Plan zur Gewinnung von Validitäts- und Reliabilitätsnachweisen
Ein vertretbares Validitätsargument aufzubauen ist eine Abfolge, keine einzelne Studie. Hier ist die Reihenfolge, die Evidenz produziert, hinter der man wirklich stehen kann.
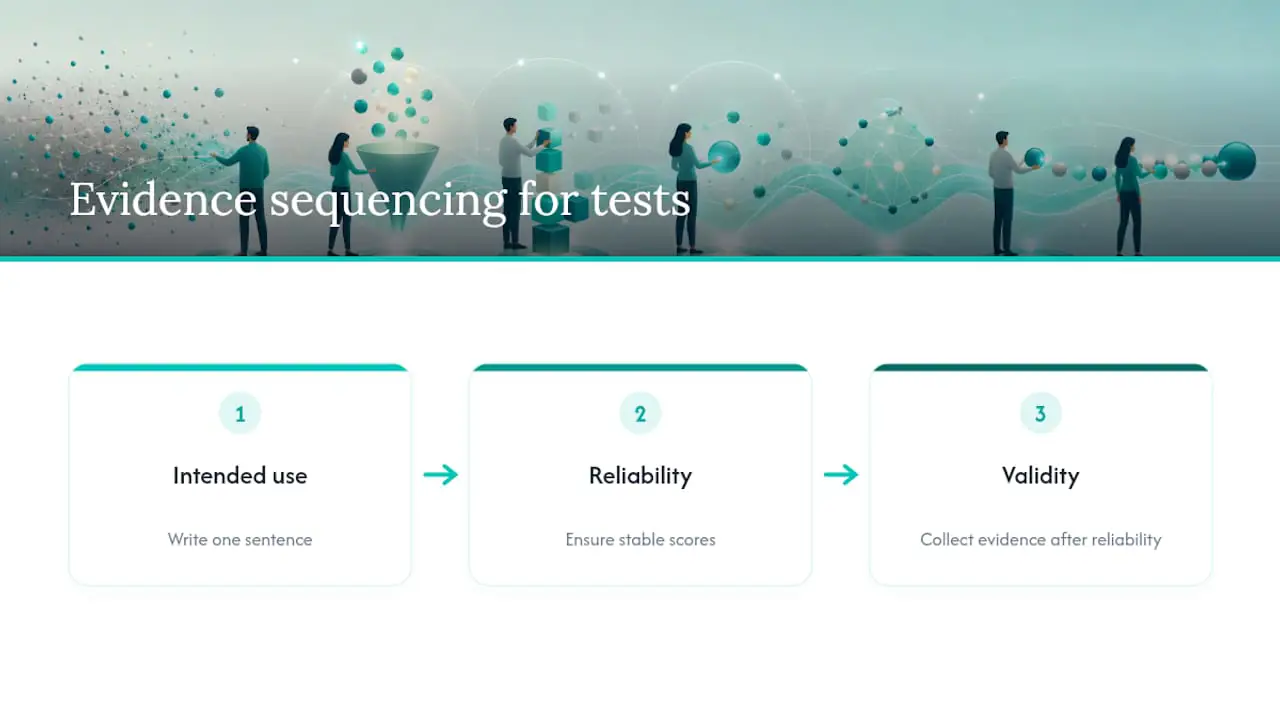
- Den beabsichtigten Verwendungszweck in einem Satz definieren. „Dieses Assessment sagt die Leistung in den ersten 90 Tagen für eine Kundenservice-Rolle vorher" ist spezifisch genug, um jede nachfolgende Entscheidung zu lenken.
- Einen Inhaltsplan erstellen. Die für den beabsichtigten Verwendungszweck erforderlichen Fähigkeiten oder Wissensbereiche nach Wichtigkeit gewichtet auflisten, bevor ein einziges Item geschrieben wird.
- Eine fachliche Inhaltsüberprüfung durchführen. Zwei bis drei Fachexperten unabhängig voneinander bewerten lassen, ob jedes Item dem Inhaltsplan entspricht, und alles Abweichende markieren.
- Den Test an einer repräsentativen Stichprobe pilotieren. Bereits 40 bis 80 Antworten zeigen itemspezifische Probleme auf – verwirrende Formulierungen, Deckeneffekte, Items, die niemand falsch beantwortet.
- Analyse der internen Struktur durchführen. Explorative oder konfirmatorische Faktorenanalyse einsetzen, um zu prüfen, ob Items so clustern, wie der Inhaltsplan es vorhersagt, und Cronbachs Alpha oder Omega für jede Subskala berechnen.
- Konvergente und diskriminante Beziehungen überprüfen. Ergebnisse mit einem etablierten Maß desselben Konstrukts und mit einem unverwandten korrelieren, um zu bestätigen, dass der Test misst, was er zu messen beansprucht.
- Kriteriumsdaten sammeln, wenn möglich. Tatsächliche Ergebnisse verfolgen – Leistungsbeurteilungen, Beförderungsraten, Fehlerquoten – und mit den ursprünglichen Ergebnissen korrelieren.
- Stichprobengröße, Kontext und Konfidenzintervalle berichten. Ein Reliabilitätskoeffizient von 30 Personen in einem Büro bedeutet etwas anderes als einer, der auf 2.000 Personen in fünf Ländern basiert.
- Das gesamte Argument dokumentieren. Aufschreiben, welche Evidenz gesammelt wurde, warum und wie sie den in Schritt eins definierten spezifischen beabsichtigten Verwendungszweck stützt.
Profi-Tipp: Schritt eins überspringen und alles Nachfolgende wird später schwerer zu verteidigen. Prüfer, Auditoren und sogar das eigene Team werden immer wieder fragen „Valide wofür?", wenn der beabsichtigte Verwendungszweck nie schriftlich festgehalten wurde.
Teams, die rollenspezifische Screening-Tests entwickeln, überspringen häufig direkt zur Pilotierung und lassen den Inhaltsplan-Schritt aus – was genau verkehrt herum ist. Der Inhaltsplan ist das, was jeden späteren Schritt interpretierbar macht.
Eine praktische Checkliste für bessere Assessments
Die meisten Validitäts- und Reliabilitätsprobleme lassen sich auf eine Handvoll behebbarer Designentscheidungen zurückführen. Bevor man ein Assessment einsetzt oder überarbeitet, sollte man Folgendes prüfen:
- Jedes Item sollte auf eine spezifische Zeile im Inhaltsplan zurückführbar sein; alles streichen, das keinen Platz verdient.
- Mehr gezielt ausgerichtete Items schlagen in der Regel weniger breite, da zusätzliche Items den Messfehler reduzieren und die interne Konsistenz erhöhen.
- Durchführungsbedingungen standardisieren – Zeitlimits, Anweisungen, Umgebung –, sodass Ergebnisvariation die Person widerspiegelt, nicht die Umgebung.
- Bewerter anhand einer gemeinsamen Rubrik schulen und die Interrater-Übereinstimmung prüfen, bevor man dem Urteil eines einzelnen Bewerters vertraut.
- Vor dem vollständigen Einsatz pilotieren und die erste Version als Entwurf behandeln, der überarbeitet werden muss.
- Kriteriums- oder konvergente Daten wann immer möglich sammeln – auch informell – und sie zusammen mit dem übrigen Evidenzmaterial dokumentieren.
Profi-Tipp: Arbeitgeber, die audit-fähige Kompetenztests entwickeln, stellen oft fest, dass der größte Reliabilitätsgewinn durch die Standardisierung der Bewertung entsteht, nicht durch das Hinzufügen von Fragen. Eine vage Rubrik macht den Vorteil einer gut aufgebauten Item-Bank jedes Mal zunichte.
Items auf eine tatsächliche Stellenbeschreibung statt auf ein generisches Fähigkeitslabel abzubilden, stärkt die Inhaltsevidenz erheblich, da generische Labels generische, wenig relevante Items begünstigen.
Wie Assessment-Plattformen Validität in der Praxis dokumentieren
Diese Evidenz manuell zu sammeln – Tabellen mit Item-Statistiken, separate Bewerternotizen, ein Ordner mit Pilotdaten – ist genau der Grund, warum die meisten Teams bei einer Inhaltsüberprüfung aufhören und es dabei belassen. Eine Plattform, die auf strukturiertes, rollenspezifisches Testen ausgerichtet ist, kann diesen Zyklus stattdessen verdichten, ohne die Strenge zu beseitigen.
Items direkt aus einer Stellenbeschreibung oder Fähigkeitsliste zu generieren, liefert bereits beim ersten Entwurf einen Inhaltsplan, anstatt ihn nachträglich zu rekonstruieren, wenn Items bereits existieren. Randomisierte Item-Zustellung und Anti-Betrugs-Monitoring – einschließlich Bildschirm- und Webcam-Prüfungen – stärken die Evidenz zu Antwortprozessen und Konsequenzen, indem sie die Wahrscheinlichkeit reduzieren, dass ein Ergebnis Betrug statt Kompetenz widerspiegelt. Exportierbare Item-Statistiken, Sitzungswiederholungen und Leistungszusammenfassungen verwandeln das, was früher ein unübersichtlicher Validierungsordner war, in etwas, das einem laufenden Protokoll näherkommt.
Der Ansatz der Plattform behandelt jedes abgeschlossene Assessment als Datenpunkt in einem fortlaufenden Validitätsargument, nicht nur als Einstellungsentscheidung – und genau das unterscheidet ein vertretbares Testprogramm von einem bauchgefühlsbasierten.
Was die Forschung wirklich empfiehlt zu priorisieren
Die größte Lücke zwischen konventionellen Ratschlägen und dem, was die Evidenz stützt, liegt in der Reihenfolge. Die meisten Leitfäden behandeln Validität und Reliabilität als parallele Checklisten, die einmal abgehakt werden. Das sind sie nicht. Reliabilität ist der Boden; Validität ist das, was man darauf aufbaut, und keine Menge fachlicher Inhaltsüberprüfung rettet einen Test, dessen Ergebnisse von einer Sitzung zur nächsten schwanken.
Die zweite Lücke ist unbehaglicher: Teams lieben Inhaltsevidenz, weil sie günstig und schnell ist – drei Experten, ein Nachmittag, fertig. Kriteriumsevidence – tatsächlich zu prüfen, ob Ergebnisse das vorhergesagte Ergebnis vorhersagen – wird fast überall außerhalb der akademischen Forschung übersprungen, weil sie Geduld und Ergebnisdaten erfordert, die die meisten Einstellungsteams nie erfassen.
Wenn man sich eines davon merkt, dann dieses: Den beabsichtigten Verwendungszweck in einem einzigen Satz aufschreiben, bevor man ein einziges Item schreibt. Alles andere – der Inhaltsplan, die Statistiken, das Bewertertraining – funktioniert nur, wenn dieser Satz präzise ist. Ein vager Verwendungszweck produziert vage Evidenz, ganz gleich wie ausgefeilt die Faktorenanalyse aussieht.
— Jimmie
Validierte Assessments ohne manuelle Nachweispflege erstellen
Ein Validitätsargument manuell zu dokumentieren – Item-Statistiken in einer Tabelle verfolgen, Bewerternotizen in einer anderen, Pilotdaten irgendwo anders –, ist genau die Art von Arbeit, die unter Termindruck stillschweigend übersprungen wird. Ein Tool generiert rollenspezifische Items direkt aus einer Stellenbeschreibung und liefert einen Inhaltsplan, bevor eine einzige Frage geschrieben wurde, während integriertes Anti-Betrugs-Monitoring und Sitzungswiederholungen die Evidenz zu Antwortprozessen ergänzen, die die meisten Teams überhaupt nie sammeln.
Es gibt kein Abonnement, zu dem man sich verpflichten muss. Man zahlt pro abgeschlossenem Kandidaten, sodass die Kosten mit dem tatsächlich durchgeführten Einstellungsverfahren skalieren – keine pauschale Lizenzgebühr. Wenn man Kompetenzen für eine bestimmte Rolle bewertet und Reliabilitäts- und Validitätsnachweise in den Prozess integriert haben möchte, anstatt sie nachträglich zusammenzusetzen, schaut man sich die Plattform an und sieht, wie eine Stellenbeschreibung in wenigen Minuten in ein testbares, vertretbares Assessment umgewandelt wird.
Quellen
Klassische Lehrbücher lehren Inhalts-, Konstrukt- und Kriteriumsvalidität noch immer so, als ob es drei separate Kästchen zum Abhaken gäbe. Moderne Psychometrie behandelt sie als Facetten eines einzigen Arguments, und einige Experten sprechen sich ausdrücklich gegen ihre Isolierung aus, weil ein Test bei einer Facette gut aussehen und bei einer anderen stark versagen kann. So lässt sich die Evidenz tatsächlich danach aufschlüsseln, wann und wie man sie sammelt:
- Reliabilität vs. Validität in der Forschung
- Eine Einführung in Validität im pädagogischen und psychologischen Testen
- Validität für Assessments
- Reliabilität und Validität von Messungen (LibreTexts)
Die Unterscheidung zwischen fachlichem Expertenurteil vor der Datenerhebung und statistischen Prüfungen nach der Datenerhebung ist wichtig, weil Teams oft bei Schritt eins aufhören. Eine Inhaltsüberprüfung durch drei Fachexperten fühlt sich gründlich an, sagt aber nichts darüber aus, ob der Test irgendetwas Reales vorhersagt.
FAQ
Was kommt zuerst, Validität oder Reliabilität?
Reliabilität kommt funktional zuerst. Man kann kein überzeugendes Validitätsargument auf Ergebnissen aufbauen, die nicht konsistent sind – wobei Reliabilität allein nie beweist, dass ein Test valide ist.
Kann ein Test reliabel sein ohne valide zu sein?
Ja. Ein Test kann hochkonsistente Ergebnisse produzieren, die dennoch vollständig das falsche Konstrukt messen – das klassische Beispiel ist eine Waage, die jedes Mal dasselbe falsche Gewicht anzeigt.
Was ist der Hauptunterschied zwischen Reliabilität und Validität?
Reliabilität fragt, ob eine Messung konsistent ist; Validität fragt, ob diese Messung tatsächlich das erfasst, was sie für einen bestimmten beabsichtigten Verwendungszweck zu erfassen beansprucht.
Was sind Beispiele für Validität und Reliabilität?
Ein verzerrtes Thermometer, das immer zwei Grad zu hoch anzeigt, ist reliabel, aber invalide; ein Dreiitem-Test, der Arbeitsleistung im Durchschnitt vorhersagt, aber für Einzelpersonen stark schwankt, ist valide, aber unreliabel.
Wie misst man Testreliabilität?
Die drei gängigsten Methoden sind Test-Retest-Korrelationen, Maße zur internen Konsistenz wie Cronbachs Alpha und Interrater-Übereinstimmungsstatistiken wie Kappa oder ICC – ausgewählt danach, ob der Test wiederholt, nach Items oder durch menschliche Bewerter bewertet wird.
Empfohlen
- HR-Teams: Kompetenztests audit-fähig machen, 5 $ pro Assessment
- Bewertungsrubriken für Assessments erstellen, die Lehrende mit KI pilotieren und skalieren können
- Einstellungsteams: 5 Schritte zu messungsorientierten Assessment-Analytics
- Wie Stellenbeschreibungen Assessments antreiben, die wirklich vorhersagen …