
Elimina il Rumore: 9 Passi per Valutatori su Validità e Affidabilità dei Test
La validità chiede se un punteggio significa ciò che si intende misurare. L'affidabilità chiede se quel punteggio riapparirebbe misurando la stessa persona il giorno dopo. Le due sono correlate ma non intercambiabili: l'affidabilità è necessaria ma non sufficiente per la validità, perché un test può produrre punteggi meravigliosamente coerenti che misurano la cosa sbagliata. Ciò che segue analizza i tipi di prove, le statistiche utilizzate per stimarle e i passi pratici per costruire una valutazione che regga sotto entrambi i profili.
TL;DR:
- Un'elevata affidabilità è essenziale in primo luogo, poiché punteggi incoerenti non possono supportare una valutazione valida, specialmente quando si misurano tratti che dovrebbero rimanere stabili nel tempo.
- La validità dipende dal fatto che i punteggi del test prevedano accuratamente il risultato desiderato, con contenuto, struttura interna, relazioni con le variabili, processi di risposta e conseguenze come principali fonti di prove.
- Raccogliere solide prove di validità richiede la definizione di uno scopo chiaro, la costruzione di un piano contenutistico, la sperimentazione con campioni rappresentativi e l'analisi delle relazioni tra costrutto e criterio.
- La maggior parte dei problemi di valutazione deriva da un rumore di misurazione debole, che può essere rimediato mediante una progettazione mirata degli item e un'amministrazione standardizzata, non solo da una revisione dei contenuti.
- L'utilizzo della generazione di item specifici per ruolo e di strumenti anti-imbroglio integrati semplifica la validazione, fornendo prove continuative senza un lavoro manuale eccessivo, soprattutto per le valutazioni basate sui ruoli.
Indice dei Contenuti
- Comprendere la Validità del Test: Cosa Significa Realmente
- Comprendere l'Affidabilità del Test: Coerenza Prima dell'Accuratezza
- Test-Retest, Coerenza Interna e Affidabilità tra Valutatori: Spiegazione
- Affidabile ma Sbagliato, o Valido ma Rumoroso: La Confusione Chiarita
- Un Piano Passo dopo Passo per Raccogliere Prove di Validità e Affidabilità
- Una Lista di Controllo Pratica per Valutazioni più Solide
- Come le Piattaforme di Valutazione Documentano la Validità in Pratica
- Cosa la Ricerca Vi Dice Realmente di Prioritizzare
- Costruire Valutazioni Validate Senza la Traccia di Prove Manuale
- Fonti
- FAQ
Comprendere la Validità del Test: Cosa Significa Realmente
La validità non è una proprietà che un test porta con sé come un adesivo di certificazione. È un argomento, costruito su prove, riguardo al fatto che le interpretazioni dei punteggi supportino un uso specifico intenzionale. Una valutazione di coding potrebbe essere altamente valida per prevedere le prestazioni di debugging sul lavoro e completamente non valida per prevedere il potenziale di leadership, anche se si tratta dello stesso identico test. Il punteggio non è cambiato. L'affermazione che si fa riguardo al punteggio sì.
È qui che inizia molta confusione. Le persone chiedono "è valido questo test?" come se la validità fosse binaria, ma gli Standards for Educational and Psychological Testing la inquadrano come un argomento di validità unitario, costruito su cinque fonti di prove piuttosto che su un elenco di "tipi" separati. Queste cinque fonti sono:
- Prove di contenuto — gli item del test rappresentano effettivamente il dominio o la competenza in questione?
- Prove sulla struttura interna — gli item raggruppati insieme statisticamente corrispondono ai costrutti che dovrebbero misurare?
- Relazioni con altre variabili — il punteggio si correla con misure esterne nel modo previsto dalla teoria (questo copre ciò che i vecchi libri di testo chiamavano validità convergente, discriminante e di criterio)?
- Prove sui processi di risposta — i partecipanti al test stanno effettivamente impegnando la competenza che si intende misurare, o stanno aggirando il formato?
- Prove sulle conseguenze — l'uso del test produce risultati equi e intenzionali, o danni non intenzionali a gruppi specifici?
Lo scopo determina quale prove sono più necessarie. Un test di coding pre-assunzione si affida fortemente alle prove di contenuto e di criterio. Un inventario della personalità utilizzato per la collocazione nei team si basa sulle prove di struttura interna e di relazioni. La validità si basa in ultima analisi sul fatto che il test preveda il risultato che afferma di prevedere, non sull'aspetto curato degli item.
Comprendere l'Affidabilità del Test: Coerenza Prima dell'Accuratezza
L'affidabilità misura se un test produce lo stesso risultato nelle stesse condizioni, ripetutamente. Non ha nulla a che fare con la correttezza del risultato. Una bilancia da cucina che legge 400 grammi ogni volta che ci si mette sopra un peso da mezzo chilo è perfettamente affidabile e costantemente sbagliata di 100 grammi.
L'affidabilità è la coerenza e la riproducibilità di una misurazione, che indica quanto i risultati siano attendibili nel corso di prove ripetute, mentre la validità è la questione separata dell'accuratezza e del significato. Ogni misurazione contiene una certa quantità di errore — rumore casuale dovuto a stanchezza, distrazione, formulazione ambigua o un valutatore incoerente — che allontana un punteggio osservato dal punteggio "vero" di una persona. L'affidabilità è in realtà una stima della quantità di quel rumore presente.
- Una bassa affidabilità significa che i punteggi oscillano in modo imprevedibile tra un tentativo e l'altro, tra sessioni o tra valutatori.
- Un'elevata affidabilità significa che i punteggi rimangono stabili quando nulla di significativo riguardo alla persona è cambiato.
- L'affidabilità pone un limite massimo alla validità: una misura molto rumorosa non può correlarsi fortemente con nulla, incluso il risultato che dovrebbe prevedere.
Quest'ultimo punto merita enfasi, perché rappresenta il collegamento meccanico tra i due concetti. Una bassa affidabilità in una delle due misure limita la correlazione massima osservabile tra di esse, un effetto chiamato attenuazione. Tre forme comuni di affidabilità — test-retest, coerenza interna e accordo tra valutatori — catturano ciascuna una diversa fonte di quel rumore.
Test-Retest, Coerenza Interna e Affidabilità tra Valutatori: Spiegazione
L'affidabilità test-retest misura la stabilità nel tempo. Si somministra lo stesso test alle stesse persone due volte, di solito a distanza di due-quattro settimane, e si correlano i due set di punteggi. È adatta a tratti stabili, come la capacità cognitiva generale o le dimensioni della personalità, e poco adatta a costrutti destinati a cambiare rapidamente, come l'umore o lo stress a breve termine.
La coerenza interna misura se gli item di un singolo test concordano tra loro, tipicamente tramite l'alpha di Cronbach. È il controllo di affidabilità più rapido da eseguire perché richiede una sola somministrazione, ed è per questo che viene utilizzato in modo eccessivo. L'alpha è sensibile al numero di item del test, quindi un test lungo può produrre un alpha gonfiato anche quando i singoli item sono mediocri. I coefficienti omega gestiscono meglio questa situazione per i test con qualità degli item disomogenea, sebbene l'alpha rimanga il valore predefinito del settore.
L'affidabilità tra valutatori è importante ogni volta che un essere umano valuta qualcosa di soggettivo: un campione di scrittura, un colloquio strutturato, un compito basato su video. Il kappa di Cohen o un coefficiente di correlazione intraclasse (ICC) quantifica l'accordo tra i valutatori, correggendo per l'accordo che ci si aspetterebbe per caso.
Suggerimento: Una correlazione test-retest a un livello ragionevolmente elevato (spesso vicino a +.80 o superiore) è comunemente considerata un riferimento pratico per tratti stabili. Qualsiasi valore significativamente inferiore su un tratto che non dovrebbe cambiare da una settimana all'altra segnala un problema di progettazione che vale la pena indagare prima di costruire qualsiasi argomentazione di validità su di esso.
Il contesto determina quale forma sia più importante. Un test di competenze valutato automaticamente necessita di una forte coerenza interna ma non di alcun controllo tra valutatori. Un colloquio strutturato necessita dell'accordo tra valutatori sopra quasi tutto il resto.
Affidabile ma Sbagliato, o Valido ma Rumoroso: La Confusione Chiarita
Il modo più chiaro per vedere la differenza tra validità e affidabilità di un test è attraverso due modalità di fallimento che non si assomigliano affatto ma che entrambe rovinano una valutazione.
- Affidabile ma non valido: un termometro distorto che legge sempre due gradi in più. È perfettamente coerente, il che lo rende affidabile, ma ogni lettura è sbagliata, il che lo rende non valido.
- Valido ma non affidabile: un test di competenze con soli tre item che coprono una competenza ampia. In media, su molti candidati potrebbe correlarsi ragionevolmente con le prestazioni lavorative, ma il punteggio di qualsiasi singola persona oscilla troppo tra un tentativo e l'altro per essere affidabile individualmente.
Questi esempi rispondono alle due domande che le persone cercano di più. Cosa viene prima? L'affidabilità, funzionalmente, perché non è possibile costruire un'argomentazione di validità difendibile su punteggi incoerenti. Un test può essere affidabile senza essere valido? Sì, facilmente, e accade costantemente con test che sono internamente coerenti ma misurano semplicemente il costrutto sbagliato per l'uso previsto.
Se la vostra affidabilità è solida ma le prove di validità sono scarse, la soluzione è di solito nel contenuto: coinvolgete esperti del settore e verificate se gli item rappresentano effettivamente il lavoro o il tratto. Se l'affidabilità stessa è debole, nessuna quantità di prove di validità salverà il test. Bisogna prima correggere il rumore di misurazione — tipicamente aggiungendo item ben mirati o stringendo le regole di valutazione — prima che la questione della validità sia anche solo affrontabile.
Un Piano Passo dopo Passo per Raccogliere Prove di Validità e Affidabilità
Costruire un'argomentazione di validità difendibile è una sequenza, non un singolo studio. Ecco l'ordine che produce prove su cui ci si può effettivamente basare.
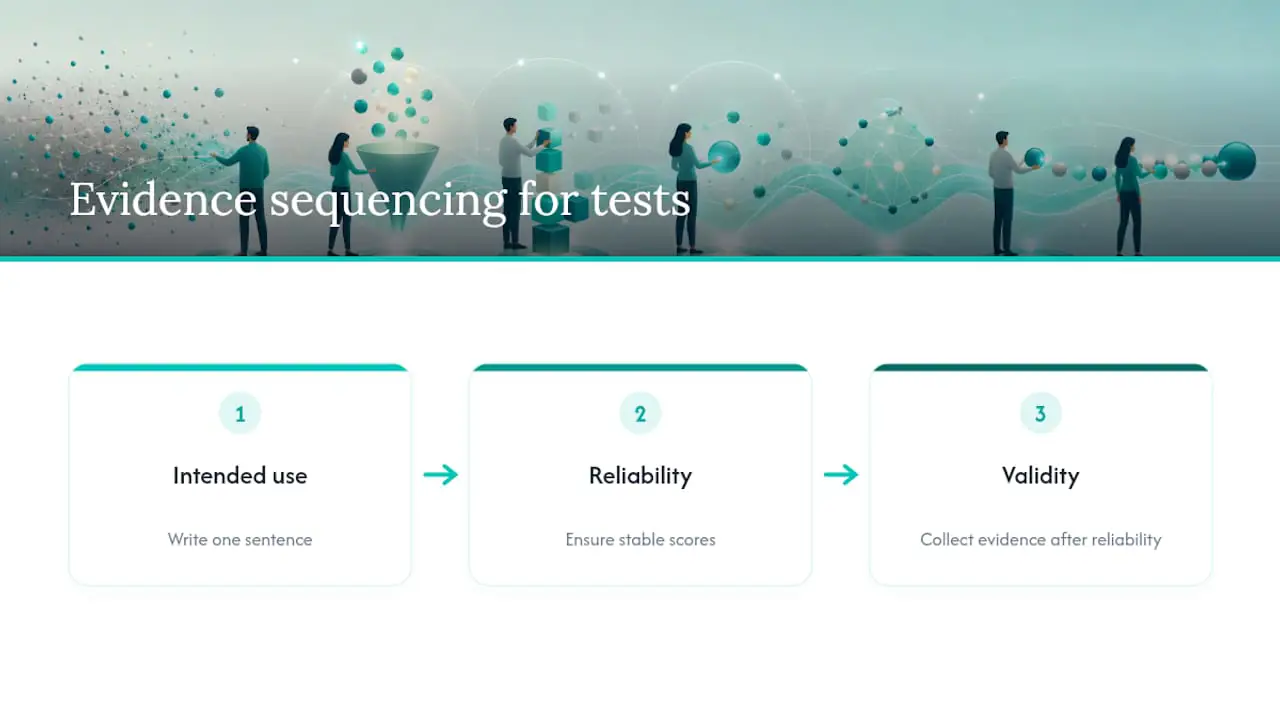
- Definire l'uso previsto in una frase. "Questa valutazione prevede le prestazioni nei primi 90 giorni per un ruolo di assistenza clienti" è abbastanza specifico da guidare ogni decisione successiva.
- Costruire un piano contenutistico. Elencare le competenze o i domini di conoscenza richiesti dall'uso previsto, ponderati per importanza, prima di scrivere un singolo item.
- Condurre una revisione dei contenuti da parte di esperti. Far sì che due o tre esperti della materia valutino indipendentemente se ogni item corrisponde al piano e segnalino tutto ciò che è fuori tema.
- Sperimentare il test su un campione rappresentativo. Anche 40-80 risposte rivelano problemi a livello di item: formulazioni confuse, effetti soffitto, item che nessuno sbaglia.
- Eseguire un'analisi della struttura interna. Utilizzare l'analisi fattoriale esplorativa o confermativa per verificare se gli item si raggruppano nel modo previsto dal piano e calcolare l'alpha o l'omega di Cronbach per ogni subscala.
- Verificare le relazioni convergenti e discriminanti. Correlare i punteggi con una misura consolidata dello stesso costrutto e con una misura non correlata per confermare che il test misuri ciò che afferma di misurare.
- Raccogliere dati di criterio quando possibile. Tracciare i risultati effettivi — valutazioni delle prestazioni lavorative, tassi di promozione, tassi di errore — e correlarli con i punteggi originali.
- Riportare la dimensione del campione, il contesto e gli intervalli di confidenza. Un coefficiente di affidabilità basato su 30 persone in un ufficio significa qualcosa di diverso rispetto a uno basato su 2.000 persone in cinque paesi.
- Documentare l'intera argomentazione. Annotare quali prove sono state raccolte, perché, e come supportano l'uso previsto specifico definito nel primo passaggio.
Suggerimento: Saltate il primo passaggio e tutto ciò che viene dopo diventa più difficile da difendere in seguito. Revisori, revisori contabili e persino il vostro stesso team continueranno a chiedere "valido per cosa?" se l'uso previsto non è mai stato scritto in primo luogo.
I team che costruiscono test di selezione specifici per ruolo spesso saltano direttamente alla sperimentazione e tralasciano il passaggio del piano, che è esattamente il contrario di ciò che si dovrebbe fare. Il piano è ciò che rende interpretabile ogni passaggio successivo.
Una Lista di Controllo Pratica per Valutazioni più Solide
La maggior parte dei problemi di validità e affidabilità risale a una manciata di scelte progettuali correggibili. Prima di distribuire o rivedere una valutazione, verificate questi punti:
- Ogni item dovrebbe ricollegarsi a una riga specifica nel vostro piano contenutistico; eliminate tutto ciò che non giustifica la sua presenza.
- Più item ben mirati battono generalmente meno item generici, poiché item aggiuntivi riducono il rumore di misurazione e aumentano la coerenza interna.
- Standardizzate le condizioni di somministrazione — limiti di tempo, istruzioni, ambiente — in modo che la variazione nei punteggi rifletta la persona, non il contesto.
- Formate i valutatori su una rubrica condivisa e verificate l'accordo tra valutatori prima di fidarsi del giudizio di un singolo esaminatore.
- Sperimentate prima del lancio completo e trattate la prima versione come una bozza che necessiterà di revisione.
- Raccogliete dati di criterio o convergenti ogni volta che potete, anche in modo informale, e registrateli insieme al resto delle vostre prove.
Suggerimento: I datori di lavoro che costruiscono test di competenze pronti per l'audit spesso constatano che il maggior guadagno in termini di affidabilità deriva dalla standardizzazione della valutazione, non dall'aggiunta di domande. Una rubrica vaga vanificherà il beneficio di una banca di item ben costruita ogni volta.
Mappare gli item rispetto a una descrizione del lavoro reale piuttosto che a un'etichetta di competenza generica stringe anche considerevolmente le prove di contenuto, poiché le etichette generiche invitano item generici e di scarsa rilevanza.
Come le Piattaforme di Valutazione Documentano la Validità in Pratica
Raccogliere queste prove a mano — fogli di calcolo con statistiche degli item, note separate dei valutatori, una cartella di dati pilota — è esattamente il motivo per cui la maggior parte dei team si ferma a una revisione dei contenuti e la considera sufficiente. Una piattaforma costruita attorno a test strutturati e specifici per ruolo può comprimere quel ciclo invece di eliminare il rigore.
Generare item direttamente da una descrizione del lavoro o da un elenco di competenze fornisce un piano contenutistico fin dalla prima bozza, piuttosto che crearne uno retroattivamente dopo che gli item già esistono. La consegna randomizzata degli item e il monitoraggio anti-imbroglio — inclusi i controlli dello schermo e della webcam — rafforzano le prove sui processi di risposta e sulle conseguenze riducendo la possibilità che un punteggio rifletta un tentativo di imbroglio piuttosto che una competenza. Le statistiche degli item esportabili, i replay delle sessioni e i riepiloghi delle prestazioni trasformano ciò che era una cartella di validazione dispersa in qualcosa di più simile a un registro continuo.
L'approccio della piattaforma tratta ogni valutazione completata come un punto dati in un'argomentazione di validità in corso, non solo come una decisione di assunzione, ed è questo che separa un programma di test difendibile da uno basato sull'istinto.
Cosa la Ricerca Vi Dice Realmente di Prioritizzare
Il divario più grande tra i consigli convenzionali e ciò che le prove supportano riguarda la sequenza. La maggior parte delle linee guida tratta validità e affidabilità come elenchi di controllo paralleli da seguire una volta. Non sono paralleli. L'affidabilità è il pavimento; la validità è ciò che si costruisce sopra, e nessuna quantità di revisione dei contenuti da parte di esperti salva un test i cui punteggi oscillano da una sessione all'altra.
Il secondo divario è più scomodo: i team amano le prove di contenuto perché sono economiche e veloci — tre esperti, un pomeriggio, fatto. Le prove di criterio — verificare effettivamente se i punteggi prevedono il risultato che si afferma di prevedere — vengono saltate quasi ovunque al di fuori della ricerca accademica, perché richiedono pazienza e dati sui risultati che la maggior parte dei team di assunzione non si preoccupa mai di raccogliere.
Se prendete una cosa da questo articolo, prendete questa: scrivete l'uso previsto in una singola frase prima di scrivere un singolo item. Tutto il resto — il piano, le statistiche, la formazione dei valutatori — funziona solo se quella frase è precisa. Un uso previsto vago produce prove vaghe, indipendentemente da quanto sofisticata sembri l'analisi fattoriale.
— Jimmie
Costruire Valutazioni Validate Senza la Traccia di Prove Manuale
Documentare un'argomentazione di validità a mano — tracciare le statistiche degli item in un foglio di calcolo, le note dei valutatori in un altro, i dati pilota da qualche altra parte — è esattamente il tipo di lavoro che viene silenziosamente saltato sotto pressione delle scadenze. Uno strumento genera item specifici per ruolo direttamente da una descrizione del lavoro, fornendovi un piano contenutistico prima ancora di aver scritto una singola domanda, mentre il monitoraggio anti-imbroglio integrato e i replay delle sessioni aggiungono le prove sui processi di risposta che la maggior parte dei team non raccoglie mai.
Non c'è alcun abbonamento a cui impegnarsi. Si paga per candidato completato, quindi il costo scala con le assunzioni che state effettivamente facendo, non con una tariffa fissa di licenza. Se state valutando le competenze per un ruolo specifico e volete che le prove di affidabilità e validità siano integrate nel processo piuttosto che assemblate a posteriori, date un'occhiata alla piattaforma e scoprite come una descrizione del lavoro si trasforma in una valutazione testabile e difendibile in pochi minuti.
Fonti
I libri di testo classici insegnano ancora la validità di contenuto, di costrutto e di criterio come se fossero tre caselle separate da spuntare. La psicometria moderna le tratta come sfaccettature di un unico argomento, e alcuni esperti sostengono esplicitamente di non isolarle perché un test può sembrare a posto su una sfaccettatura e fallire gravemente su un'altra. Ecco come le prove si suddividono effettivamente in base a quando e come le si raccoglie:
- Affidabilità vs Validità nella Ricerca
- Un'introduzione alla validità nei test educativi e psicologici
- Validità per le Valutazioni
- Affidabilità e validità della misurazione (LibreTexts)
Distinguere il giudizio esperto pre-dati dai controlli statistici post-dati è importante perché i team spesso si fermano al primo passaggio. Una revisione dei contenuti da parte di tre esperti della materia sembra approfondita, ma non dice nulla riguardo al fatto che il test preveda qualcosa di reale.
FAQ
Cosa Viene Prima, la Validità o l'Affidabilità?
L'affidabilità viene prima, funzionalmente. Non è possibile costruire un'argomentazione di validità convincente su punteggi che non sono coerenti, sebbene l'affidabilità da sola non provi mai che un test sia valido.
Un Test Può Avere Affidabilità Senza Validità?
Sì. Un test può produrre punteggi altamente coerenti che misurano comunque il costrutto sbagliato — l'esempio classico è una bilancia che legge sempre lo stesso peso sbagliato.
Qual È la Principale Differenza tra Affidabilità e Validità?
L'affidabilità chiede se una misurazione è coerente; la validità chiede se quella misurazione cattura effettivamente ciò che afferma di misurare per un uso previsto specifico.
Quali Sono Alcuni Esempi di Validità e Affidabilità?
Un termometro distorto che legge sempre due gradi in più è affidabile ma non valido; un test con tre item che in media prevede le prestazioni lavorative ma oscilla ampiamente per i singoli individui è valido ma non affidabile.
Come Si Misura l'Affidabilità di un Test?
I tre metodi più comuni sono le correlazioni test-retest, le misure di coerenza interna come l'alpha di Cronbach, e le statistiche di accordo tra valutatori come il kappa o l'ICC, scelti in base al fatto che il test venga ripetuto, valutato per item, o valutato da esaminatori umani.
Consigliati
- Team HR: Rendere i Test di Competenze Pronti per l'Audit, 5$ per Valutazione
- Costruire Rubriche di Valutazione che gli Educatori Possono Sperimentare e Scalare con l'IA
- Team di Assunzione: 5 Passi verso Analytics di Valutazione Basate sulla Misurazione
- Come le Descrizioni del Lavoro Guidano Valutazioni che Prevedono Davvero…