
Corrija o Ruído: 9 Passos para Avaliadores sobre Validade e Confiabilidade de Testes
A validade questiona se uma pontuação significa o que você pretende que ela signifique. A confiabilidade questiona se essa pontuação apareceria novamente se você medisse a mesma pessoa amanhã. As duas estão relacionadas, mas não são intercambiáveis: a confiabilidade é necessária, mas não suficiente para a validade, pois um teste pode produzir pontuações maravilhosamente consistentes que medem a coisa errada por completo. O que se segue descreve os tipos de evidências, as estatísticas usadas para estimar cada uma delas e as etapas práticas para construir uma avaliação que resista a ambos os critérios.
Resumo:
- Alta confiabilidade é essencial em primeiro lugar, pois pontuações inconsistentes não podem sustentar uma avaliação válida, especialmente ao medir traços que deveriam permanecer estáveis ao longo do tempo.
- A validade depende de se as pontuações do teste preveem com precisão o resultado pretendido, sendo o conteúdo, a estrutura interna, as relações com variáveis, os processos de resposta e as consequências as principais fontes de evidência.
- Coletar evidências sólidas de validade exige definir um propósito claro, construir um plano de conteúdo, realizar um piloto com amostras representativas e analisar as relações de construto e critério.
- A maioria dos problemas de avaliação decorre de ruído fraco de medição, que pode ser corrigido por meio de design direcionado de itens e administração padronizada, não apenas por revisão de conteúdo.
- O uso de geração de itens específicos para cada função e ferramentas antitrapaça integradas agiliza a validação, fornecendo evidências contínuas sem trabalho manual excessivo, especialmente para avaliações baseadas em função.
Índice
- Compreendendo a Validade de Testes: O Que Ela Realmente Significa
- Compreendendo a Confiabilidade de Testes: Consistência Acima da Precisão
- Teste-Reteste, Consistência Interna e Confiabilidade entre Avaliadores Explicados
- Confiável mas Errado, ou Válido mas Ruidoso: A Confusão Esclarecida
- Um Plano Passo a Passo para Reunir Evidências de Validade e Confiabilidade
- Uma Lista de Verificação Prática para Avaliações Mais Robustas
- Como as Plataformas de Avaliação Documentam a Validade na Prática
- O Que a Pesquisa Realmente Diz para Você Priorizar
- Construa Avaliações Validadas Sem o Rastro Manual de Evidências
- Fontes
- FAQ
Compreendendo a Validade de Testes: O Que Ela Realmente Significa
A validade não é uma propriedade que um teste carrega como um adesivo de certificação. É um argumento, construído a partir de evidências, sobre se as interpretações de pontuação apoiam um uso pretendido específico. Uma avaliação de programação pode ser altamente válida para prever o desempenho em depuração no trabalho e completamente inválida para prever o potencial de liderança, mesmo sendo exatamente o mesmo teste. A pontuação não mudou. A afirmação que você está fazendo sobre a pontuação, sim.
É aqui que começa muita confusão. As pessoas perguntam "este teste é válido?" como se a validade fosse binária, mas os Padrões para Testes Educacionais e Psicológicos enquadram-na como um argumento de validade unificado, construído a partir de cinco fontes de evidências, em vez de uma lista de verificação de "tipos" separados. Essas cinco fontes são:
- Evidência de conteúdo — os itens do teste realmente representam o domínio ou a habilidade em questão?
- Evidência de estrutura interna — os itens agrupados estatisticamente correspondem aos construtos que deveriam medir?
- Relações com outras variáveis — a pontuação se correlaciona com medidas externas da forma que a teoria prevê (isso abrange o que os livros didáticos mais antigos chamavam de validade convergente, discriminante e de critério)?
- Evidência de processos de resposta — os candidatos estão realmente exercitando a habilidade que você pretende medir, ou estão explorando o formato do teste?
- Evidência de consequências — o uso do teste produz resultados justos e pretendidos, ou danos não intencionais a grupos específicos?
O propósito determina qual evidência você mais precisa. Um teste de programação pré-emprego depende fortemente de evidências de conteúdo e critério. Um inventário de personalidade usado para alocação de equipes depende de evidências de estrutura interna e relações. A validade, em última análise, reside em se o teste prevê o resultado que afirma prever, não em se os itens parecem bem elaborados.
Compreendendo a Confiabilidade de Testes: Consistência Acima da Precisão
A confiabilidade mede se um teste produz o mesmo resultado nas mesmas condições, repetidamente. Não tem nada a ver com se o resultado está correto. Uma balança de cozinha que marca 400 gramas toda vez que você coloca um peso de 453 gramas nela é perfeitamente confiável e consistentemente errada por 53 gramas.
A confiabilidade é a consistência e a reprodutibilidade de uma medição, indicando quão confiáveis são os resultados ao longo de tentativas repetidas, enquanto a validade é a questão separada de precisão e significado. Toda medição contém alguma quantidade de erro — ruído aleatório proveniente de fadiga, distração, formulação ambígua ou um avaliador inconsistente — que afasta uma pontuação observada da pontuação "verdadeira" de uma pessoa. A confiabilidade é, na verdade, uma estimativa de quanto desse ruído existe.
- Baixa confiabilidade significa que as pontuações oscilam de forma imprevisível entre tentativas, sessões ou avaliadores.
- Alta confiabilidade significa que as pontuações permanecem estáveis quando nada significativo na pessoa mudou.
- A confiabilidade estabelece um teto para a validade: uma medida muito ruidosa não pode se correlacionar fortemente com nada, incluindo o resultado que deveria prever.
Esse último ponto merece destaque, pois é o elo mecânico entre os dois conceitos. A baixa confiabilidade em qualquer das medidas limita a correlação observável máxima entre elas, um efeito chamado atenuação. Três formas comuns de confiabilidade — teste-reteste, consistência interna e concordância entre avaliadores — capturam cada uma uma fonte diferente desse ruído.
Teste-Reteste, Consistência Interna e Confiabilidade entre Avaliadores Explicados
A confiabilidade teste-reteste mede a estabilidade ao longo do tempo. Você administra o mesmo teste às mesmas pessoas duas vezes, geralmente com duas a quatro semanas de intervalo, e correlaciona os dois conjuntos de pontuações. É adequada para traços estáveis, como habilidade cognitiva geral ou dimensões de personalidade; é mal adequada para construtos que devem mudar rapidamente, como humor ou estresse de curto prazo.
A consistência interna mede se os itens de um único teste concordam entre si, tipicamente por meio do alfa de Cronbach. É a verificação de confiabilidade mais rápida de realizar porque precisa de apenas uma administração, razão pela qual é utilizada em excesso. O alfa é sensível ao número de itens em um teste, portanto um teste longo pode produzir um alfa inflado mesmo quando os itens individuais são mediocres. Os coeficientes ômega lidam melhor com isso para testes com qualidade desigual de itens, embora o alfa continue sendo o padrão da indústria.
A confiabilidade entre avaliadores importa sempre que um humano avalia algo subjetivo — uma amostra de redação, uma entrevista estruturada, uma tarefa em vídeo. O kappa de Cohen ou um coeficiente de correlação intraclasse (ICC) quantifica a concordância entre avaliadores, corrigindo para a concordância que seria esperada apenas pelo acaso.
Dica Profissional: Uma correlação teste-reteste em um nível razoavelmente alto (geralmente próximo de +.80 ou superior) é comumente tratada como um patamar prático para traços estáveis. Qualquer valor significativamente abaixo disso em um traço que não deveria mudar de uma semana para outra sinaliza um problema de design que vale a pena investigar antes de construir qualquer argumento de validade sobre ele.
O contexto decide qual forma é mais importante. Um teste de habilidades pontuado automaticamente precisa de forte consistência interna, mas não precisa de nenhuma verificação entre avaliadores. Uma entrevista estruturada precisa de concordância entre avaliadores acima de quase tudo mais.
Confiável mas Errado, ou Válido mas Ruidoso: A Confusão Esclarecida
A maneira mais clara de ver a diferença entre validade e confiabilidade de testes é por meio de dois modos de falha que parecem completamente diferentes, mas ambos arruínam uma avaliação.
- Confiável mas inválido: um termômetro tendencioso que marca dois graus a mais toda vez. É perfeitamente consistente, o que o torna confiável, mas cada leitura está errada, o que o torna inválido.
- Válido mas não confiável: um teste de habilidades com apenas três itens cobrindo uma competência ampla. Em média, entre muitos candidatos, pode se correlacionar razoavelmente com o desempenho no trabalho, mas a pontuação de qualquer pessoa oscila demais entre tentativas para ser confiável individualmente.
Esses exemplos respondem às duas perguntas que as pessoas mais buscam. Qual vem primeiro? A confiabilidade, funcionalmente, porque você não pode construir um argumento de validade defensável sobre pontuações inconsistentes. Um teste pode ser confiável sem ser válido? Sim, facilmente, e isso acontece constantemente com testes que são internamente consistentes, mas simplesmente medem o construto errado para o uso pretendido.
Se sua confiabilidade é forte, mas as evidências de validade são escassas, a solução geralmente está no conteúdo: recorra a especialistas no assunto e verifique se os itens realmente representam o trabalho ou traço. Se a própria confiabilidade é fraca, nenhuma quantidade de evidências de validade salvará o teste. Você precisa corrigir o ruído de medição primeiro — tipicamente adicionando itens bem direcionados ou apertando as regras de pontuação — antes que a questão da validade possa sequer ser respondida.
Um Plano Passo a Passo para Reunir Evidências de Validade e Confiabilidade
Construir um argumento de validade defensável é uma sequência, não um único estudo. Aqui está a ordem que produz evidências nas quais você pode realmente se apoiar.
- Defina o uso pretendido em uma frase. "Esta avaliação prevê o desempenho nos primeiros 90 dias em uma função de suporte ao cliente" é específico o suficiente para orientar todas as decisões posteriores.
- Construa um plano de conteúdo. Liste as habilidades ou domínios de conhecimento que o uso pretendido exige, ponderados por importância, antes de escrever um único item.
- Realize uma revisão de conteúdo por especialistas. Peça a dois ou três especialistas no assunto que avaliem independentemente se cada item corresponde ao plano e que sinalizem qualquer coisa fora do alvo.
- Faça um piloto do teste com uma amostra representativa. Mesmo 40 a 80 respostas revelam problemas no nível do item — formulação confusa, efeitos de teto, itens que ninguém erra.
- Realize análise de estrutura interna. Use análise fatorial exploratória ou confirmatória para verificar se os itens se agrupam da forma que seu plano prevê, e calcule o alfa de Cronbach ou ômega para cada subescala.
- Verifique as relações convergentes e discriminantes. Correlacione as pontuações com uma medida estabelecida do mesmo construto e com uma não relacionada para confirmar que o teste mede o que afirma medir.
- Colete dados de critério quando viável. Acompanhe os resultados reais — avaliações de desempenho no trabalho, taxas de promoção, taxas de erro — e correlacione-os com as pontuações originais.
- Relate o tamanho da amostra, o contexto e os intervalos de confiança. Um coeficiente de confiabilidade baseado em 30 pessoas em um escritório significa algo diferente de um baseado em 2.000 pessoas em cinco países.
- Documente o argumento completo. Registre quais evidências foram coletadas, por quê, e como elas apoiam o uso pretendido específico definido na etapa um.
Dica Profissional: Pule a etapa um e tudo o que vem depois se torna mais difícil de defender. Revisores, auditores e até mesmo sua própria equipe continuarão perguntando "válido para quê?" se o uso pretendido nunca foi escrito em primeiro lugar.
Equipes que constroem testes de triagem específicos para cada função frequentemente pulam direto para o piloto e ignoram a etapa do plano, o que é exatamente o contrário do correto. O plano é o que torna cada etapa posterior interpretável.
Uma Lista de Verificação Prática para Avaliações Mais Robustas
A maioria dos problemas de validade e confiabilidade remonta a um punhado de escolhas de design corrigíveis. Antes de lançar ou revisar uma avaliação, verifique estas:
- Cada item deve remeter a uma linha específica do seu plano de conteúdo; elimine qualquer coisa que não justifique seu lugar.
- Mais itens bem direcionados geralmente superam menos itens amplos, pois itens adicionais reduzem o ruído de medição e aumentam a consistência interna.
- Padronize as condições de administração — limites de tempo, instruções, ambiente — para que a variação nas pontuações reflita a pessoa, não o contexto.
- Treine os avaliadores com uma rubrica compartilhada e verifique a concordância entre avaliadores antes de confiar no julgamento de qualquer avaliador individual.
- Faça um piloto antes do lançamento completo e trate a primeira versão como um rascunho que precisará de revisão.
- Colete dados de critério ou convergentes sempre que possível, mesmo de forma informal, e registre-os junto com o restante das suas evidências.
Dica Profissional: Empregadores que constroem testes de habilidades prontos para auditoria frequentemente descobrem que o maior ganho de confiabilidade vem da padronização da pontuação, não da adição de perguntas. Uma rubrica vaga desfará o benefício de um banco de itens bem construído todas as vezes.
Mapear itens de volta a uma descrição de cargo real, em vez de um rótulo genérico de habilidade, também fortalece consideravelmente as evidências de conteúdo, pois rótulos genéricos convidam itens genéricos de baixa relevância.
Como as Plataformas de Avaliação Documentam a Validade na Prática
Coletar essas evidências manualmente — planilhas de estatísticas de itens, notas separadas de avaliadores, uma pasta de dados de piloto — é exatamente o motivo pelo qual a maioria das equipes para na revisão de conteúdo e considera o trabalho concluído. Uma plataforma construída em torno de testes estruturados e específicos para cada função pode comprimir esse ciclo em vez de eliminar o rigor.
Gerar itens diretamente a partir de uma descrição de cargo ou lista de habilidades fornece um plano de conteúdo desde o primeiro rascunho, em vez de engenharia reversa após a existência dos itens. A entrega aleatória de itens e o monitoramento antitrapaça — incluindo verificações de tela e webcam — fortalecem as evidências de processos de resposta e consequências, reduzindo a chance de que uma pontuação reflita trapaça em vez de habilidade. Estatísticas de itens exportáveis, replays de sessão e resumos de desempenho transformam o que costumava ser uma pasta de validação dispersa em algo mais próximo de um registro contínuo.
A abordagem da plataforma trata cada avaliação concluída como um ponto de dados em um argumento de validade contínuo, não apenas como uma decisão de contratação, o que separa um programa de testes defensável de um baseado em intuição.
O Que a Pesquisa Realmente Diz para Você Priorizar
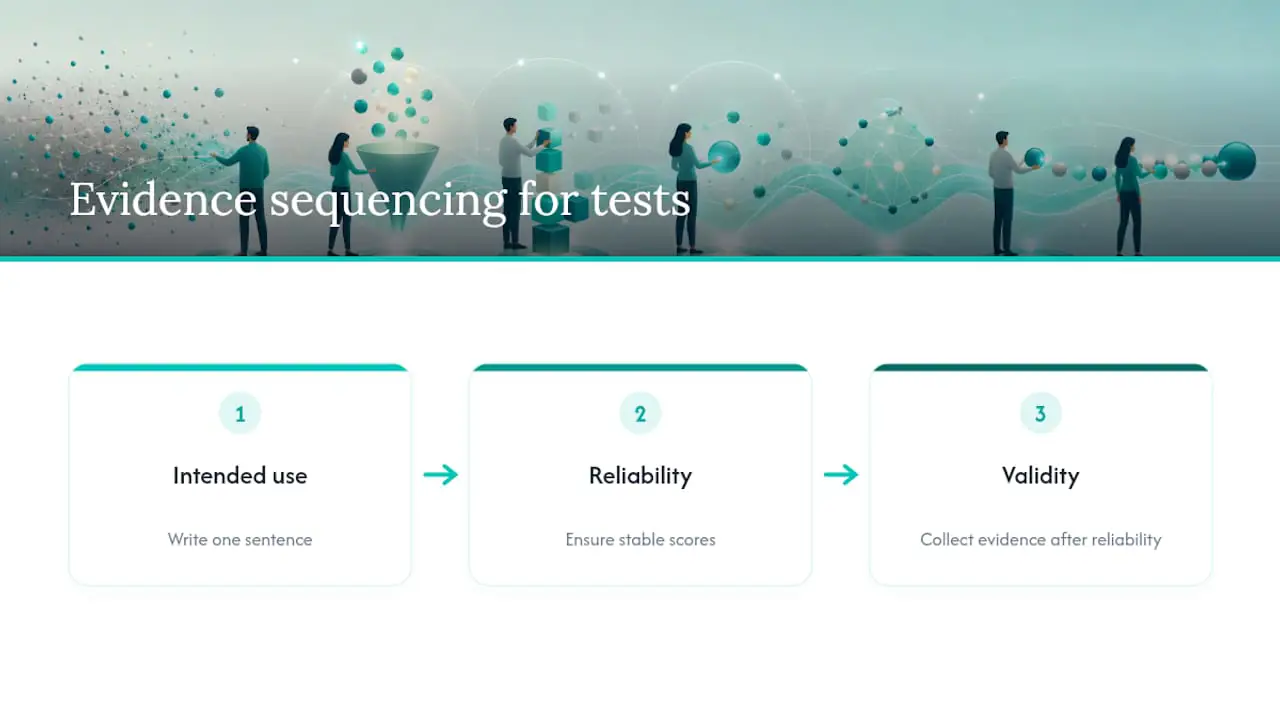
A maior lacuna entre os conselhos convencionais e o que as evidências apoiam é o sequenciamento. A maioria das orientações trata validade e confiabilidade como listas de verificação paralelas a serem executadas uma vez. Elas não são paralelas. A confiabilidade é o alicerce; a validade é o que você constrói sobre ela, e nenhuma quantidade de revisão de conteúdo por especialistas salva um teste cujas pontuações oscilam de uma sessão para a próxima.
A segunda lacuna é mais desconfortável: as equipes adoram evidências de conteúdo porque são baratas e rápidas — três especialistas, uma tarde, pronto. Evidências de critério — verificar realmente se as pontuações preveem o resultado que afirmam prever — são ignoradas em quase todos os lugares fora da pesquisa acadêmica, porque exigem paciência e dados de resultado que a maioria das equipes de contratação nunca se preocupa em coletar.
Se você levar uma coisa deste artigo, leve esta: escreva seu uso pretendido em uma única frase antes de escrever um único item. Todo o resto — o plano, as estatísticas, o treinamento de avaliadores — só funciona se essa frase for precisa. O uso pretendido vago produz evidências vagas, não importa quão sofisticada pareça a análise fatorial.
— Jimmie
Construa Avaliações Validadas Sem o Rastro Manual de Evidências
Documentar um argumento de validade manualmente — rastrear estatísticas de itens em uma planilha, notas de avaliadores em outra, dados de piloto em algum outro lugar — é exatamente o tipo de trabalho que silenciosamente é ignorado sob pressão de prazo. Uma ferramenta gera itens específicos para cada função diretamente a partir de uma descrição de cargo, fornecendo um plano de conteúdo antes de você ter escrito uma única pergunta, enquanto o monitoramento antitrapaça integrado e os replays de sessão adicionam as evidências de processo de resposta que a maioria das equipes nunca coleta.
Não há assinatura a comprometer. Você paga por candidato concluído, portanto o custo escala com a contratação que você está realmente fazendo, não uma taxa de licença fixa. Se você está avaliando habilidades para uma função específica e deseja que as evidências de confiabilidade e validade estejam integradas ao processo, em vez de montadas após o fato, confira a plataforma e veja como uma descrição de cargo se transforma em uma avaliação testável e defensável em minutos.
Fontes
Os livros didáticos clássicos ainda ensinam validade de conteúdo, construto e critério como se fossem três caixas separadas a verificar. A psicometria moderna as trata como facetas de um argumento, e alguns especialistas argumentam explicitamente contra isolá-las porque um teste pode parecer bem em uma faceta e falhar gravemente em outra. Veja como as evidências se distribuem de acordo com quando e como você as coleta:
- Confiabilidade versus Validade na Pesquisa
- Uma introdução à validade em testes educacionais e psicológicos
- Validade para Avaliações
- Confiabilidade e validade de medição (LibreTexts)
Distinguir o julgamento especializado pré-dados das verificações estatísticas pós-dados importa porque as equipes frequentemente param na etapa um. Uma revisão de conteúdo feita por três especialistas no assunto parece completa, mas não diz nada sobre se o teste prevê algo real.
FAQ
O Que Vem Primeiro, Validade ou Confiabilidade?
A confiabilidade vem funcionalmente primeiro. Você não pode construir um argumento de validade convincente sobre pontuações que não são consistentes, embora a confiabilidade sozinha nunca prove que um teste é válido.
Um Teste Pode Ter Confiabilidade Sem Validade?
Sim. Um teste pode produzir pontuações altamente consistentes que ainda medem o construto errado por completo — o exemplo clássico é uma balança que marca o mesmo peso errado todas as vezes.
Qual É a Principal Diferença Entre Confiabilidade e Validade?
A confiabilidade pergunta se uma medição é consistente; a validade pergunta se essa medição realmente captura o que afirma medir para um uso pretendido específico.
Quais São Alguns Exemplos de Validade e Confiabilidade?
Um termômetro tendencioso que sempre marca dois graus a mais é confiável mas inválido; um teste de três itens que prevê o desempenho no trabalho em média, mas oscila muito para indivíduos, é válido mas não confiável.
Como Você Mede a Confiabilidade de um Teste?
Os três métodos mais comuns são correlações teste-reteste, medidas de consistência interna como o alfa de Cronbach, e estatísticas de concordância entre avaliadores como o kappa ou ICC, escolhidos com base em se o teste é repetido, pontuado por itens ou pontuado por avaliadores humanos.
Recomendado
- Equipes de RH: Torne os Testes de Habilidades Prontos para Auditoria, $5 por Avaliação
- Construa Rubricas de Pontuação de Avaliação que Educadores Possam Pilotar e Escalar com IA
- Equipes de Contratação: 5 Passos para Análise de Avaliações com Foco em Medição
- Como as Descrições de Cargo Orientam Avaliações que Realmente Preveem…