
شور کو ٹھیک کریں: ٹیسٹ کی درستگی اور قابل اعتمادیت کے لیے جائزہ کاروں کے 9 اقدامات
درستگی (Validity) یہ سوال اٹھاتی ہے کہ آیا ایک اسکور وہی معنی رکھتا ہے جو آپ چاہتے ہیں۔ قابلِ اعتماد ہونا (Reliability) یہ پوچھتا ہے کہ اگر آپ کل اسی شخص کو دوبارہ جانچیں تو کیا وہی اسکور سامنے آئے گا۔ یہ دونوں آپس میں متعلق ہیں لیکن ایک دوسرے کی جگہ استعمال نہیں کیے جا سکتے: قابلِ اعتماد ہونا درستگی کے لیے ضروری ہے لیکن کافی نہیں، کیونکہ ایک ٹیسٹ بالکل یکساں اسکور دے سکتا ہے جو بالکل غلط چیز کو ناپتا ہو۔ آگے آنے والے حصوں میں ثبوت کی اقسام، ہر ایک کا تخمینہ لگانے کے لیے استعمال ہونے والے اعداد و شمار، اور ایسی جانچ بنانے کے عملی اقدامات بیان کیے گئے ہیں جو دونوں پہلوؤں پر پوری اترے۔
خلاصہ:
- اعلیٰ قابلِ اعتمادی پہلے ضروری ہے، کیونکہ غیر یکساں اسکور کسی درست جانچ کی بنیاد نہیں بن سکتے، خاص طور پر جب ایسی خصوصیات کو ناپا جا رہا ہو جو وقت کے ساتھ مستحکم رہنی چاہئیں۔
- درستگی اس بات پر منحصر ہے کہ ٹیسٹ اسکور مطلوبہ نتیجے کو درستی سے پیش گوئی کرتے ہیں یا نہیں، اور مواد، داخلی ساخت، متغیرات سے تعلقات، جواب دینے کے عمل، اور نتائج اس کے اہم ثبوتی ذرائع ہیں۔
- مضبوط درستگی کے ثبوت جمع کرنے کے لیے واضح مقصد متعین کرنا، مواد کا خاکہ بنانا، نمائندہ نمونوں پر آزمائشی ٹیسٹ چلانا، اور ساخت اور معیار کے تعلقات کا تجزیہ کرنا ضروری ہے۔
- جانچ کے زیادہ تر مسائل کمزور پیمائشی شور سے جنم لیتے ہیں، جسے ہدفِ مخصوص سوال کے ڈیزائن اور معیاری انتظام سے درست کیا جا سکتا ہے، نہ کہ صرف مواد کے جائزے سے۔
- کردار کے مطابق سوال بنانا اور بلٹ اِن دھوکہ دہی مخالف ٹولز کا استعمال توثیق کو آسان بناتا ہے، اور خاص طور پر کردار پر مبنی جانچ کے لیے ضرورت سے زیادہ دستی کام کے بغیر مسلسل ثبوت فراہم کرتا ہے۔
فہرستِ مضامین
- ٹیسٹ کی درستگی کو سمجھنا: اس کا اصل مطلب کیا ہے
- ٹیسٹ کی قابلِ اعتمادی کو سمجھنا: درستی سے زیادہ یکسانی
- ٹیسٹ-ری ٹیسٹ، داخلی یکسانی، اور انٹر ریٹر قابلِ اعتمادی کی وضاحت
- قابلِ اعتماد مگر غلط، یا درست مگر شور بھرا: الجھن دور ہوئی
- درستگی اور قابلِ اعتمادی کے ثبوت جمع کرنے کا مرحلہ وار منصوبہ
- مضبوط جانچ کے لیے ایک عملی چیک لسٹ
- جانچ پلیٹ فارم عملی طور پر درستگی کی دستاویز کیسے کرتے ہیں
- تحقیق واقعی آپ کو کس چیز کو ترجیح دینے کی تلقین کرتی ہے
- دستی ثبوت کے بغیر توثیق شدہ جانچ بنائیں
- ماخذ
- عمومی سوالات
ٹیسٹ کی درستگی کو سمجھنا: اس کا اصل مطلب کیا ہے
درستگی کوئی ایسی خاصیت نہیں جو ایک ٹیسٹ سرٹیفیکیشن اسٹیکر کی طرح اپنے ساتھ لے کر چلتا ہو۔ یہ ایک دلیل ہے، ثبوتوں پر استوار، اس بارے میں کہ آیا اسکور کی تعبیریں کسی مخصوص مطلوبہ مقصد کی حمایت کرتی ہیں۔ ایک کوڈنگ جانچ نوکری پر ڈیبگنگ کی کارکردگی کی پیش گوئی کے لیے بہت زیادہ درست ہو سکتی ہے اور قیادت کی صلاحیت کی پیش گوئی کے لیے بالکل غلط، حالانکہ یہ بالکل وہی ٹیسٹ ہے۔ اسکور نہیں بدلا۔ آپ اسکور کے بارے میں جو دعویٰ کر رہے ہیں وہ بدل گیا۔
یہیں سے بہت سی الجھن شروع ہوتی ہے۔ لوگ پوچھتے ہیں "کیا یہ ٹیسٹ درست ہے؟" گویا درستگی دو حالتوں میں سے کوئی ایک ہو، لیکن تعلیمی اور نفسیاتی جانچ کے معیارات اسے ایک متحد درستگی دلیل کے طور پر پیش کرتے ہیں، جو الگ الگ "اقسام" کی چیک لسٹ کے بجائے پانچ ثبوتی ذرائع سے مل کر بنتی ہے۔ وہ پانچ ذرائع یہ ہیں:
- مواد کا ثبوت — کیا ٹیسٹ کے سوالات واقعی متعلقہ شعبے یا مہارت کی نمائندگی کرتے ہیں؟
- داخلی ساخت کا ثبوت — کیا اعداد و شمار کے لحاظ سے ایک ساتھ رکھے گئے سوالات ان تصورات سے میل کھاتے ہیں جنہیں وہ ناپنے کے لیے ہیں؟
- دیگر متغیرات سے تعلقات — کیا اسکور بیرونی پیمانوں سے اس طرح وابستہ ہے جیسا نظریہ پیش گوئی کرتا ہے (یہ وہ چیز ہے جسے پرانی کتابیں اکٹھا، علیحدہ، اور معیاری درستگی کہتی تھیں)؟
- جواب دینے کے عمل کا ثبوت — کیا ٹیسٹ دینے والے واقعی وہ مہارت استعمال کر رہے ہیں جسے آپ ناپنا چاہتے ہیں، یا وہ فارمیٹ کو گیم کر رہے ہیں؟
- نتائج کا ثبوت — کیا ٹیسٹ استعمال کرنے سے منصفانہ اور مطلوبہ نتائج پیدا ہوتے ہیں، یا مخصوص گروہوں کو غیر ارادی نقصان پہنچتا ہے؟
مقصد طے کرتا ہے کہ آپ کو کس ثبوت کی سب سے زیادہ ضرورت ہے۔ نوکری سے پہلے کی کوڈنگ جانچ مواد اور معیاری ثبوت پر بھاری انحصار کرتی ہے۔ ٹیم کی تعیناتی کے لیے استعمال ہونے والی شخصیت کی فہرست داخلی ساخت اور تعلقات کے ثبوت پر۔ درستگی بالآخر اس بات پر منحصر ہے کہ آیا ٹیسٹ اس نتیجے کی پیش گوئی کرتا ہے جس کا وہ دعویٰ کرتا ہے، نہ کہ اس بات پر کہ سوالات چمک دار نظر آتے ہیں۔
ٹیسٹ کی قابلِ اعتمادی کو سمجھنا: درستی سے زیادہ یکسانی
قابلِ اعتمادی یہ ناپتی ہے کہ آیا ایک ٹیسٹ یکساں حالات میں بار بار ایک ہی نتیجہ دیتا ہے۔ اس کا نتیجے کے درست ہونے یا نہ ہونے سے کوئی تعلق نہیں۔ ایک کچن کا ترازو جو ہر بار ایک پاؤنڈ وزن رکھنے پر 14 اونس دکھاتا ہے وہ بالکل قابلِ اعتماد ہے اور مسلسل دو اونس غلط۔
قابلِ اعتمادی ایک پیمائش کی یکسانی اور دوبارہ پیدا ہونے کی صلاحیت ہے، جو یہ ظاہر کرتی ہے کہ بار بار کی گئی آزمائشوں میں نتائج کتنے قابلِ بھروسا ہیں، جبکہ درستگی درستی اور معنی کا الگ سوال ہے۔ ہر پیمائش میں کچھ نہ کچھ غلطی ہوتی ہے — تھکاوٹ، توجہ کی کمی، مبہم الفاظ، یا کسی غیر یکساں گریڈر کی وجہ سے بے ترتیب شور — جو کسی شخص کے "اصل" اسکور سے مشاہدہ شدہ اسکور کو دور کر دیتا ہے۔ قابلِ اعتمادی دراصل اس بات کا تخمینہ ہے کہ یہ شور کتنا ہے۔
- کم قابلِ اعتمادی کا مطلب ہے کہ اسکور کوششوں، سیشنوں، یا ریٹرز کے درمیان غیر متوقع طور پر بدلتے رہتے ہیں۔
- اعلیٰ قابلِ اعتمادی کا مطلب ہے کہ جب شخص میں کوئی بامعنی تبدیلی نہ آئی ہو تو اسکور مستحکم رہتے ہیں۔
- قابلِ اعتمادی درستگی کی حد مقرر کرتی ہے: بہت زیادہ شور والی پیمائش کا کسی بھی چیز سے، بشمول اس نتیجے کے جسے اسے پیش گوئی کرنی چاہیے، مضبوط تعلق نہیں ہو سکتا۔
یہ آخری نکتہ توجہ کا مستحق ہے، کیونکہ یہ دونوں تصورات کے درمیان میکانکی ربط ہے۔ کسی بھی پیمانے میں کم قابلِ اعتمادی ان کے درمیان زیادہ سے زیادہ قابلِ مشاہدہ تعلق کو محدود کر دیتی ہے، ایک اثر جسے کمزور پڑنا (attenuation) کہتے ہیں۔ قابلِ اعتمادی کی تین عام اشکال — ٹیسٹ-ری ٹیسٹ، داخلی یکسانی، اور انٹر ریٹر اتفاق — ہر ایک اس شور کا ایک مختلف ذریعہ پکڑتی ہیں۔
ٹیسٹ-ری ٹیسٹ، داخلی یکسانی، اور انٹر ریٹر قابلِ اعتمادی کی وضاحت
ٹیسٹ-ری ٹیسٹ قابلِ اعتمادی وقت کے ساتھ استحکام ناپتی ہے۔ آپ ایک ہی ٹیسٹ انہی لوگوں کو دو بار، عام طور پر دو سے چار ہفتوں کے وقفے سے، دیتے ہیں اور دونوں اسکور سیٹوں کا تعلق جانچتے ہیں۔ یہ مستحکم خصوصیات جیسے عمومی علمی صلاحیت یا شخصیت کے پہلوؤں کے لیے موزوں ہے، اور ان تصورات کے لیے ناقص جو جلدی بدلنے کے لیے ہوتے ہیں، جیسے موڈ یا قلیل مدتی دباؤ۔
داخلی یکسانی یہ ناپتی ہے کہ ایک ٹیسٹ کے سوالات آپس میں متفق ہیں یا نہیں، عام طور پر Cronbach's alpha کے ذریعے۔ یہ سب سے تیز قابلِ اعتمادی جانچ ہے کیونکہ اسے صرف ایک مرتبہ کے انتظام کی ضرورت ہے، یہی وجہ ہے کہ اسے ضرورت سے زیادہ استعمال کیا جاتا ہے۔ Alpha ٹیسٹ میں سوالات کی تعداد کے لیے حساس ہے، اس لیے ایک لمبا ٹیسٹ بڑھا ہوا alpha دے سکتا ہے حتیٰ کہ جب انفرادی سوالات اوسط درجے کے ہوں۔ Omega coefficients غیر مساوی سوال کے معیار والے ٹیسٹوں کے لیے اسے بہتر طریقے سے سنبھالتے ہیں، اگرچہ alpha صنعتی معیار بنا ہوا ہے۔
انٹر ریٹر قابلِ اعتمادی اہم ہوتی ہے جب بھی کوئی انسان کچھ ذاتی رائے پر مبنی چیز اسکور کرے — ایک تحریری نمونہ، ایک منظم انٹرویو، ایک ویڈیو پر مبنی کام۔ Cohen's kappa یا intraclass correlation coefficient (ICC) ریٹرز کے درمیان اتفاق کو مقداری شکل دیتا ہے، اتفاق کو درست کرتے ہوئے جو محض اتفاق سے متوقع ہوگا۔
ماہرانہ مشورہ: ایک معقول حد پر ٹیسٹ-ری ٹیسٹ تعلق (اکثر +.80 یا اس سے زیادہ کے قریب) عام طور پر مستحکم خصوصیات کے لیے عملی معیار سمجھا جاتا ہے۔ کسی ایسی خصوصیت پر اس سے نمایاں طور پر کم جو ہفتے بہ ہفتے نہیں بدلنی چاہیے، ڈیزائن کے کسی مسئلے کی علامت ہے جسے کوئی بھی درستگی کا مقدمہ اس پر بنانے سے پہلے جانچ کے قابل ہے۔
سیاق و سباق طے کرتا ہے کہ کون سی شکل سب سے زیادہ اہمیت رکھتی ہے۔ خودکار طریقے سے اسکور ہونے والے مہارت کے ٹیسٹ کو مضبوط داخلی یکسانی کی ضرورت ہے لیکن انٹر ریٹر جانچ کی بالکل نہیں۔ ایک منظم انٹرویو کو تقریباً ہر چیز سے بڑھ کر انٹر ریٹر اتفاق کی ضرورت ہے۔
قابلِ اعتماد مگر غلط، یا درست مگر شور بھرا: الجھن دور ہوئی
ٹیسٹ کی درستگی بمقابلہ قابلِ اعتمادی کا فرق دیکھنے کا سب سے واضح طریقہ دو ناکامی کے طریقوں کے ذریعے ہے جو بالکل مختلف نظر آتے ہیں لیکن دونوں ایک جانچ کو تباہ کر دیتے ہیں۔
- قابلِ اعتماد مگر غلط: ایک متعصب تھرمامیٹر جو ہر بار دو ڈگری زیادہ پڑھتا ہے۔ یہ بالکل یکساں ہے، جو اسے قابلِ اعتماد بناتا ہے، لیکن ہر پڑھائی غلط ہے، جو اسے ناقابلِ درست بناتی ہے۔
- درست مگر غیر قابلِ اعتماد: ایک وسیع قابلیت کا احاطہ کرنے والے صرف تین سوالوں کا مہارت ٹیسٹ۔ اوسطاً بہت سے ٹیسٹ دینے والوں میں یہ نوکری کی کارکردگی سے معقول حد تک تعلق رکھ سکتا ہے، لیکن کسی ایک شخص کا اسکور کوششوں کے درمیان اتنا بدلتا ہے کہ انفرادی طور پر بھروسا نہیں کیا جا سکتا۔
یہ مثالیں ان دو سوالوں کا جواب دیتی ہیں جو لوگ سب سے زیادہ ڈھونڈتے ہیں۔ کون پہلے آتا ہے؟ قابلِ اعتمادی، عملی طور پر، کیونکہ آپ غیر یکساں اسکور پر درستگی کا قابلِ دفاع مقدمہ نہیں بنا سکتے۔ کیا ایک ٹیسٹ بغیر درست ہوئے قابلِ اعتماد ہو سکتا ہے؟ ہاں، بآسانی، اور ایسا ان ٹیسٹوں کے ساتھ مسلسل ہوتا ہے جو اندرونی طور پر یکساں ہیں لیکن مطلوبہ استعمال کے لیے بالکل غلط تصور ناپتے ہیں۔
اگر آپ کی قابلِ اعتمادی مضبوط ہے لیکن درستگی کا ثبوت کمزور ہے، تو حل عام طور پر مواد میں ہے: موضوع کے ماہرین کو شامل کریں اور جانچیں کہ سوالات واقعی نوکری یا خصوصیت کی نمائندگی کرتے ہیں یا نہیں۔ اگر قابلِ اعتمادی خود کمزور ہے، تو درستگی کا کوئی بھی ثبوت ٹیسٹ کو نہیں بچائے گا۔ آپ کو پہلے پیمائشی شور درست کرنا ہوگا — عام طور پر اچھی طرح ہدفبند سوالات شامل کر کے یا اسکورنگ کے اصول سخت کر کے — اس سے پہلے کہ درستگی کا سوال بھی قابلِ جواب ہو۔
درستگی اور قابلِ اعتمادی کے ثبوت جمع کرنے کا مرحلہ وار منصوبہ
قابلِ دفاع درستگی کا مقدمہ بنانا ایک ترتیب ہے، کوئی واحد مطالعہ نہیں۔ یہاں وہ ترتیب ہے جو ایسے ثبوت پیدا کرتی ہے جس پر آپ واقعی کھڑے رہ سکتے ہیں۔
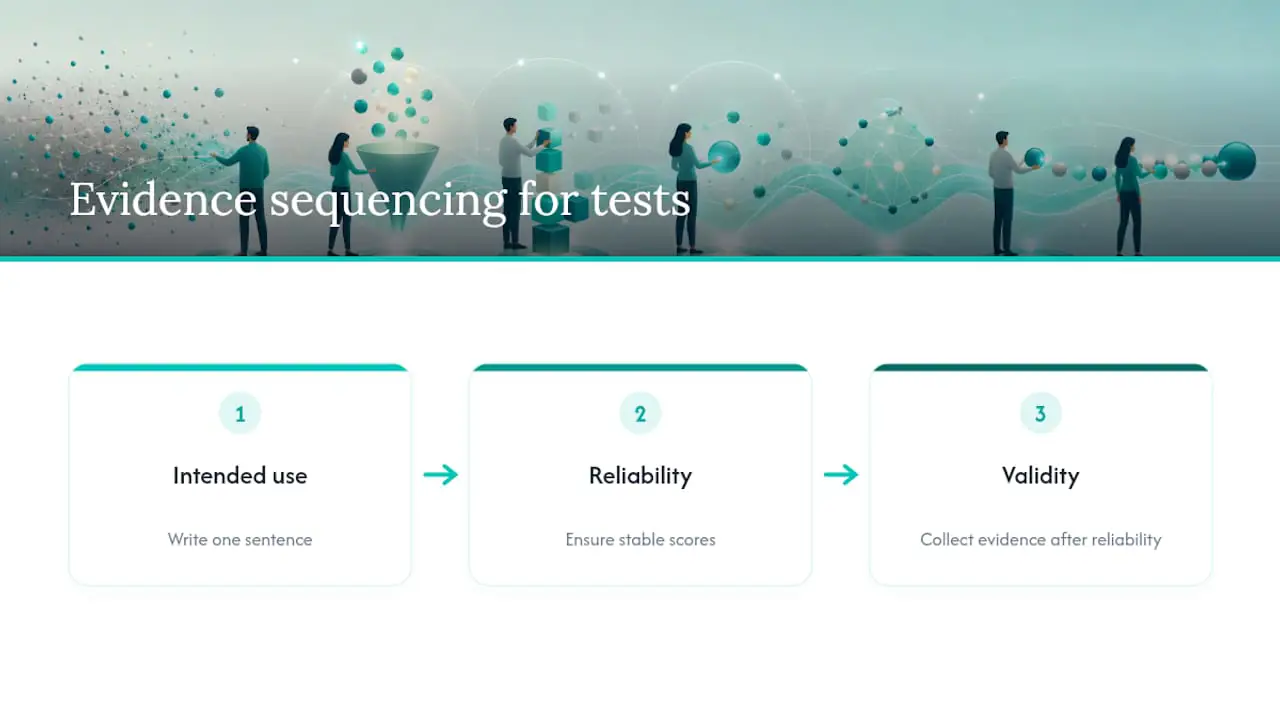
- مطلوبہ استعمال کو ایک جملے میں بیان کریں۔ "یہ جانچ کسٹمر سپورٹ کے کردار کے لیے پہلے 90 دنوں کی کارکردگی کی پیش گوئی کرتی ہے" اس کے بعد آنے والے ہر فیصلے کو رہنمائی دینے کے لیے کافی مخصوص ہے۔
- مواد کا خاکہ بنائیں۔ کوئی ایک سوال لکھنے سے پہلے، مطلوبہ استعمال کے لیے درکار مہارتوں یا علم کے شعبوں کی فہرست بنائیں، اہمیت کے لحاظ سے وزن دے کر۔
- ماہرانہ مواد کا جائزہ لیں۔ دو یا تین موضوعی ماہرین سے آزادانہ طور پر یہ اندازہ لگوائیں کہ آیا ہر سوال خاکے سے میل کھاتا ہے اور ہدف سے باہر کی کسی بھی چیز کو نشان زد کریں۔
- نمائندہ نمونے پر ٹیسٹ آزمائیں۔ یہاں تک کہ 40 سے 80 جوابات سوال کی سطح پر مسائل ظاہر کرتے ہیں — الجھن بھرے الفاظ، چھت کے اثرات، ایسے سوالات جو کوئی غلط نہیں کرتا۔
- داخلی ساخت کا تجزیہ کریں۔ ایکسپلوریٹری یا تصدیقی فیکٹر تجزیہ استعمال کریں تاکہ جانچیں کہ کیا سوالات آپ کے خاکے کی پیش گوئی کے مطابق گروہوں میں آتے ہیں، اور ہر ذیلی پیمانے کے لیے Cronbach's alpha یا omega حساب کریں۔
- اکٹھے اور علیحدہ تعلقات جانچیں۔ اسکورز کو اسی تصور کے ایک قائم شدہ پیمانے اور ایک غیر متعلقہ پیمانے سے وابستہ کریں تاکہ تصدیق ہو کہ ٹیسٹ وہی ناپتا ہے جس کا وہ دعویٰ کرتا ہے۔
- جب ممکن ہو تو معیاری ڈیٹا جمع کریں۔ اصل نتائج ٹریک کریں — نوکری کی کارکردگی کی درجہ بندی، ترقی کی شرح، غلطی کی شرح — اور انہیں اصل اسکورز سے وابستہ کریں۔
- نمونے کا سائز، سیاق و سباق، اور اعتماد کے وقفے رپورٹ کریں۔ ایک دفتر میں 30 لوگوں سے قابلِ اعتمادی کا گتانک پانچ ممالک میں 2,000 لوگوں پر مبنی گتانک سے مختلف معنی رکھتا ہے۔
- پوری دلیل کی دستاویز کریں۔ لکھیں کہ کون سے ثبوت جمع کیے گئے، کیوں، اور وہ پہلے مرحلے میں بیان کردہ مخصوص مطلوبہ استعمال کی کیسے حمایت کرتے ہیں۔
ماہرانہ مشورہ: پہلا مرحلہ چھوڑیں اور بعد میں آنے والی ہر چیز کا دفاع کرنا مشکل ہو جاتا ہے۔ جائزہ کنندگان، آڈیٹرز، اور یہاں تک کہ آپ کی اپنی ٹیم بھی یہ پوچھتی رہے گی "کس لیے درست؟" اگر مطلوبہ استعمال کبھی لکھا ہی نہیں گیا۔
نوکری کے لیے مخصوص اسکریننگ ٹیسٹ بنانے والی ٹیمیں اکثر خاکے کے مرحلے کو چھوڑ کر سیدھے آزمائش کی طرف چلی جاتی ہیں، جو بالکل الٹا ہے۔ خاکہ ہی وہ چیز ہے جو بعد کے ہر مرحلے کو قابلِ تشریح بناتی ہے۔
مضبوط جانچ کے لیے ایک عملی چیک لسٹ
درستگی اور قابلِ اعتمادی کے زیادہ تر مسائل چند قابلِ اصلاح ڈیزائن انتخابوں میں واپس جاتے ہیں۔ کوئی جانچ بھیجنے یا اس میں ترمیم کرنے سے پہلے یہ جانچیں:
- ہر سوال کو آپ کے مواد کے خاکے میں کسی مخصوص لائن سے جڑا ہونا چاہیے؛ جو کچھ بھی اپنی جگہ نہ کماتا ہو اسے ہٹا دیں۔
- اچھی طرح ہدفبند مزید سوالات عام طور پر کم وسیع سوالوں سے بہتر ہوتے ہیں، کیونکہ اضافی سوالات پیمائشی شور کو کم کرتے ہیں اور داخلی یکسانی بڑھاتے ہیں۔
- انتظامی حالات کو معیاری بنائیں — وقت کی حدود، ہدایات، ماحول — تاکہ اسکور میں تغیر شخص کو ظاہر کرے، سیٹنگ کو نہیں۔
- مشترکہ معیار پر ریٹرز کو تربیت دیں اور کسی ایک گریڈر کے فیصلے پر بھروسا کرنے سے پہلے انٹر ریٹر اتفاق جانچیں۔
- مکمل اجراء سے پہلے آزمائش کریں، اور پہلے ورژن کو ایک مسودہ سمجھیں جسے نظرثانی کی ضرورت ہوگی۔
- جب بھی ممکن ہو معیاری یا اکٹھا ڈیٹا جمع کریں، یہاں تک کہ غیر رسمی طور پر، اور اسے اپنے باقی ثبوت کے ساتھ لاگ کریں۔
ماہرانہ مشورہ: آڈٹ کے لیے تیار مہارت کے ٹیسٹ بنانے والے آجر اکثر پاتے ہیں کہ قابلِ اعتمادی میں سب سے بڑا فائدہ اسکورنگ کو معیاری بنانے سے آتا ہے، نہ کہ سوالات شامل کرنے سے۔ ایک مبہم معیار ہر بار ایک اچھی طرح سے بنائے گئے سوال کے بینک کے فائدے کو ختم کر دے گا۔
سوالوں کو کسی عام مہارت کے لیبل کے بجائے اصل ملازمت کی تفصیل سے جوڑنا بھی مواد کا ثبوت کافی حد تک مضبوط کرتا ہے، کیونکہ عام لیبل عام، کم متعلقہ سوالات کو دعوت دیتے ہیں۔
جانچ پلیٹ فارم عملی طور پر درستگی کی دستاویز کیسے کرتے ہیں
اس ثبوت کو ہاتھ سے جمع کرنا — سوالوں کے اعداد و شمار کی اسپریڈشیٹ، ریٹر کے الگ نوٹس، آزمائشی ڈیٹا کا ایک فولڈر — بالکل وہی کام ہے جسے زیادہ تر ٹیمیں مواد کے جائزے پر رک کر ختم شدہ قرار دے دیتی ہیں۔ منظم، کردار کے لیے مخصوص جانچ کے گرد بنایا گیا پلیٹ فارم اس چکر کو سکڑا سکتا ہے بجائے سختی کو ختم کرنے کے۔
ملازمت کی تفصیل یا مہارت کی فہرست سے براہِ راست سوالات بنانا آپ کو پہلے مسودے سے ہی ایک مواد کا خاکہ دیتا ہے، بجائے اس کے کہ سوالات پہلے سے موجود ہونے کے بعد الٹا انجینئرنگ کی جائے۔ بے ترتیب سوالوں کی فراہمی اور دھوکہ دہی مخالف نگرانی — بشمول اسکرین اور ویب کیم چیکس — جواب دینے کے عمل اور نتائج کے ثبوت کو مضبوط کرتی ہے، اس امکان کو کم کرتے ہوئے کہ اسکور مہارت کے بجائے دھوکہ دہی کی عکاسی کرتا ہے۔ قابلِ برآمد سوال کے اعداد و شمار، سیشن ریپلے، اور کارکردگی کے خلاصے جو کبھی بکھرا ہوا توثیقی فولڈر تھا اسے ایک جاری ریکارڈ کے قریب کر دیتے ہیں۔
پلیٹ فارم کا طریقہ ہر مکمل جانچ کو ایک جاری درستگی دلیل میں ڈیٹا پوائنٹ کے طور پر سمجھتا ہے، نہ کہ صرف ایک ملازمت کا فیصلہ، اور یہی چیز ایک قابلِ دفاع جانچ پروگرام کو بے بنیاد فیصلوں سے الگ کرتی ہے۔
تحقیق واقعی آپ کو کس چیز کو ترجیح دینے کی تلقین کرتی ہے
روایتی مشورے اور جو ثبوت حمایت کرتے ہیں اس کے درمیان سب سے بڑا فرق ترتیب میں ہے۔ زیادہ تر رہنمائی درستگی اور قابلِ اعتمادی کو متوازی چیک لسٹ کے طور پر پیش کرتی ہے جن سے ایک بار گزرنا ہوتا ہے۔ یہ متوازی نہیں ہیں۔ قابلِ اعتمادی بنیاد ہے؛ درستگی وہ چیز ہے جو آپ اس پر بناتے ہیں، اور ماہر مواد کے جائزے کی کوئی بھی مقدار اس ٹیسٹ کو نہیں بچاتی جس کے اسکور ایک نشست سے دوسری نشست تک اچھلتے رہتے ہیں۔
دوسرا فرق زیادہ تکلیف دہ ہے: ٹیمیں مواد کا ثبوت پسند کرتی ہیں کیونکہ یہ سستا اور تیز ہے — تین ماہرین، ایک دوپہر، کام ختم۔ معیاری ثبوت — واقعی یہ جانچنا کہ آیا اسکور اس نتیجے کی پیش گوئی کرتا ہے جس کا آپ دعویٰ کرتے ہیں — تقریباً ہر جگہ تعلیمی تحقیق سے باہر چھوڑ دیا جاتا ہے، کیونکہ اس کے لیے صبر اور نتائج کے ڈیٹا کی ضرورت ہوتی ہے جسے زیادہ تر ملازمت دینے والی ٹیمیں جمع کرنے کی زحمت نہیں کرتیں۔
اگر آپ اس سے ایک چیز لیں، یہ لیں: کوئی ایک سوال لکھنے سے پہلے اپنا مطلوبہ استعمال ایک جملے میں لکھیں۔ باقی سب کچھ — خاکہ، اعداد و شمار، ریٹر کی تربیت — صرف اسی صورت میں کام کرتا ہے جب وہ جملہ درست ہو۔ مبہم مطلوبہ استعمال مبہم ثبوت پیدا کرتا ہے، چاہے فیکٹر تجزیہ کتنا بھی پیچیدہ لگے۔
— Jimmie
دستی ثبوت کے بغیر توثیق شدہ جانچ بنائیں
ہاتھ سے درستگی کا مقدمہ دستاویز کرنا — ایک اسپریڈشیٹ میں سوالوں کے اعداد و شمار ٹریک کرنا، دوسری میں ریٹر کے نوٹس، آزمائشی ڈیٹا کسی اور جگہ — بالکل وہی کام ہے جو ڈیڈ لائن کے دباؤ میں خاموشی سے چھوڑ دیا جاتا ہے۔ ایک ٹول ملازمت کی تفصیل سے براہِ راست کردار کے لیے مخصوص سوالات بناتا ہے، آپ کو کوئی ایک سوال لکھنے سے پہلے مواد کا خاکہ دیتا ہے، جبکہ بلٹ اِن دھوکہ دہی مخالف نگرانی اور سیشن ریپلے جواب دینے کے عمل کا ثبوت شامل کرتے ہیں جسے زیادہ تر ٹیمیں بالکل بھی جمع نہیں کرتیں۔
سبسکرائب کرنے کی کوئی پابندی نہیں۔ آپ مکمل امیدوار کے حساب سے ادا کرتے ہیں، اس لیے لاگت آپ کی اصل بھرتی کے ساتھ بڑھتی ہے، فلیٹ لائسنس فیس نہیں۔ اگر آپ کسی مخصوص کردار کے لیے مہارتوں کا جائزہ لے رہے ہیں اور چاہتے ہیں کہ قابلِ اعتمادی اور درستگی کا ثبوت عمل میں شامل ہو بجائے بعد میں جمع کیا جائے، تو پلیٹ فارم دیکھیں اور دیکھیں کہ ملازمت کی تفصیل منٹوں میں قابلِ آزمائش، قابلِ دفاع جانچ میں کیسے بدل جاتی ہے۔
ماخذ
کلاسک نصابی کتابیں ابھی بھی مواد، ساخت، اور معیاری درستگی کو الگ الگ خانوں کے طور پر پڑھاتی ہیں۔ جدید نفسیاتی پیمائش انہیں ایک دلیل کے پہلوؤں کے طور پر سمجھتی ہے، اور کچھ ماہرین واضح طور پر انہیں الگ کرنے کے خلاف دلیل دیتے ہیں کیونکہ ایک ٹیسٹ ایک پہلو پر ٹھیک نظر آ سکتا ہے اور دوسرے پر بری طرح ناکام ہو سکتا ہے۔ یہاں ثبوت کا حقیقی خلاصہ اس بنیاد پر ہے کہ آپ اسے کب اور کیسے جمع کرتے ہیں:
- تحقیق میں قابلِ اعتمادی بمقابلہ درستگی
- تعلیمی اور نفسیاتی جانچ میں درستگی کا تعارف
- جانچ کے لیے درستگی
- پیمائش کی قابلِ اعتمادی اور درستگی (LibreTexts)
ڈیٹا سے پہلے ماہر فیصلے کو ڈیٹا کے بعد اعداد و شمار کی جانچ سے الگ کرنا اہم ہے کیونکہ ٹیمیں اکثر پہلے مرحلے پر رک جاتی ہیں۔ تین موضوعی ماہرین کا مواد کا جائزہ مکمل لگتا ہے، لیکن یہ اس بارے میں کچھ نہیں بتاتا کہ آیا ٹیسٹ کسی حقیقی چیز کی پیش گوئی کرتا ہے۔
عمومی سوالات
پہلے کون آتا ہے، درستگی یا قابلِ اعتمادی؟
قابلِ اعتمادی عملی طور پر پہلے آتی ہے۔ آپ غیر یکساں اسکور پر قائل کن درستگی کا مقدمہ نہیں بنا سکتے، اگرچہ اکیلی قابلِ اعتمادی کبھی یہ ثابت نہیں کرتی کہ ٹیسٹ درست ہے۔
کیا ایک ٹیسٹ بغیر درستگی کے قابلِ اعتماد ہو سکتا ہے؟
ہاں۔ ایک ٹیسٹ انتہائی یکساں اسکور دے سکتا ہے جو پھر بھی بالکل غلط تصور ناپتے ہیں — کلاسک مثال وہ ترازو ہے جو ہر بار ایک ہی غلط وزن دکھاتا ہے۔
قابلِ اعتمادی اور درستگی کے درمیان بنیادی فرق کیا ہے؟
قابلِ اعتمادی یہ پوچھتی ہے کہ آیا پیمائش یکساں ہے؛ درستگی یہ پوچھتی ہے کہ آیا وہ پیمائش واقعی وہی پکڑتی ہے جس کا وہ کسی مخصوص مطلوبہ استعمال کے لیے دعویٰ کرتی ہے۔
درستگی اور قابلِ اعتمادی کی کچھ مثالیں کیا ہیں؟
ایک متعصب تھرمامیٹر جو ہمیشہ دو ڈگری زیادہ پڑھتا ہے قابلِ اعتماد ہے لیکن ناقابلِ درست؛ ایک تین سوالوں کا ٹیسٹ جو اوسطاً نوکری کی کارکردگی کی پیش گوئی کرتا ہے لیکن افراد کے لیے وسیع پیمانے پر بدلتا ہے وہ درست ہے لیکن غیر قابلِ اعتماد۔
ٹیسٹ کی قابلِ اعتمادی کیسے ناپتے ہیں؟
تین سب سے عام طریقے ٹیسٹ-ری ٹیسٹ تعلقات، داخلی یکسانی کے پیمانے جیسے Cronbach's alpha، اور انٹر ریٹر اتفاق کے اعداد و شمار جیسے kappa یا ICC ہیں، جن کا انتخاب اس بنیاد پر کیا جاتا ہے کہ آیا ٹیسٹ دہرایا جاتا ہے، سوالوں کے ذریعے اسکور کیا جاتا ہے، یا انسانی ریٹرز کے ذریعے۔
تجویز کردہ
- HR ٹیمیں: مہارت کے ٹیسٹ کی درستگی کو آڈٹ کے لیے تیار بنائیں، $5 فی جانچ
- ایسے جانچ اسکورنگ کے معیار بنائیں جو معلمین AI کے ساتھ آزما اور پیمانے پر لے جا سکیں
- ملازمت دینے والی ٹیمیں: پیمائش کو پہلے رکھنے والے جانچ تجزیات کے 5 مراحل
- ملازمت کی تفصیلات ایسی جانچ کو کیسے چلاتی ہیں جو واقعی پیش گوئی کرتی ہے…