
Устранение помех: 9 шагов для оценщиков по валидности и надёжности тестов
Валидность проверяет, означает ли показатель то, что вы намерены им измерить. Надёжность проверяет, будет ли этот показатель воспроизведён, если завтра вы измерите того же человека. Оба понятия взаимосвязаны, но не взаимозаменяемы: надёжность необходима, но недостаточна для валидности, поскольку тест может давать замечательно стабильные результаты, измеряя при этом совершенно не то. Ниже подробно рассмотрены виды доказательств, статистические методы оценки каждого из них, а также практические шаги по созданию инструмента оценки, который выдержит проверку по обоим критериям.
Кратко:
- Высокая надёжность — это необходимое условие в первую очередь, поскольку непоследовательные результаты не могут обеспечить валидную оценку, особенно при измерении черт, которые должны оставаться стабильными во времени.
- Валидность зависит от того, насколько точно результаты теста предсказывают целевой исход; ключевыми источниками доказательств служат содержание, внутренняя структура, связи с переменными, процессы ответа и последствия.
- Сбор убедительных доказательств валидности требует чёткого определения цели, создания плана содержания, пилотного тестирования на репрезентативных выборках, а также анализа конструктных и критериальных взаимосвязей.
- Большинство проблем с оценкой вызваны слабым измерительным шумом, который можно устранить целенаправленным составлением заданий и стандартизацией проведения, а не только проверкой содержания.
- Использование ролевой генерации заданий и встроенных инструментов защиты от мошенничества упрощает валидацию, обеспечивая постоянное накопление доказательств без избыточной ручной работы, особенно для ролевых оценок.
Содержание
- Понимание валидности теста: что это на самом деле означает
- Понимание надёжности теста: стабильность важнее точности
- Ретестовая надёжность, внутренняя согласованность и надёжность между экспертами: объяснение
- Надёжный, но ошибочный, или валидный, но зашумлённый: путаница устранена
- Пошаговый план сбора доказательств валидности и надёжности
- Практический чеклист для более качественных оценок
- Как платформы оценки документируют валидность на практике
- Что исследования на самом деле рекомендуют приоритизировать
- Создавайте валидированные оценки без ручного сбора доказательств
- Источники
- Часто задаваемые вопросы
Понимание валидности теста: что это на самом деле означает
Валидность — это не свойство, которое тест носит с собой как сертификационный знак. Это аргумент, выстроенный на доказательствах, о том, обоснованы ли интерпретации результатов для конкретного предполагаемого применения. Тест на навыки программирования может быть высоковалидным для прогнозирования эффективности отладки кода на рабочем месте и совершенно невалидным для прогнозирования лидерского потенциала — даже если это один и тот же тест. Результат не изменился. Изменилось утверждение, которое вы делаете об этом результате.
Именно здесь начинается основная путаница. Люди спрашивают «валиден ли этот тест?», как будто валидность бинарна, но Стандарты образовательного и психологического тестирования рассматривают её как единый аргумент валидности, выстраиваемый из пяти источников доказательств, а не как перечень отдельных «видов». Эти пять источников таковы:
- Доказательства содержания — действительно ли задания теста представляют рассматриваемую область или навык?
- Доказательства внутренней структуры — соответствуют ли сгруппированные задания статистически конструктам, которые они должны измерять?
- Связи с другими переменными — коррелирует ли результат с внешними показателями так, как предсказывает теория (это охватывает то, что в устаревших учебниках называлось конвергентной, дискриминантной и критериальной валидностью)?
- Доказательства процессов ответа — действительно ли испытуемые задействуют тот навык, который вы намерены измерить, или же они используют особенности формата?
- Доказательства последствий — приводит ли применение теста к справедливым, ожидаемым результатам или к непреднамеренному вреду для отдельных групп?
Цель определяет, какие доказательства наиболее важны. Тест на навыки программирования для предварительного отбора кандидатов в значительной мере опирается на доказательства содержания и критерия. Опросник личности для формирования команд опирается на доказательства внутренней структуры и связей. Валидность в конечном счёте определяется тем, предсказывает ли тест тот исход, который заявлен, а не тем, насколько безупречно выглядят задания.
Понимание надёжности теста: стабильность важнее точности
Надёжность измеряет, даёт ли тест один и тот же результат в одинаковых условиях при повторном применении. Это никак не связано с тем, является ли результат правильным. Кухонные весы, которые каждый раз показывают 400 граммов при взвешивании гири в полкилограмма, абсолютно надёжны и при этом неизменно ошибаются на 100 граммов.
Надёжность — это согласованность и воспроизводимость измерения, отражающая стабильность результатов при повторных испытаниях, тогда как валидность — это отдельный вопрос точности и смысла. Каждое измерение содержит определённый уровень ошибки — случайного шума, вызванного усталостью, невнимательностью, неоднозначными формулировками или непоследовательным экспертом, — который смещает наблюдаемый результат от «истинного» результата человека. Надёжность, по сути, является оценкой того, насколько велик этот шум.
- Низкая надёжность означает, что результаты непредсказуемо варьируются между попытками, сеансами или экспертами.
- Высокая надёжность означает, что результаты остаются стабильными, когда в человеке ничего существенно не изменилось.
- Надёжность устанавливает верхнюю планку для валидности: сильно зашумлённый показатель не может сильно коррелировать ни с чем, включая тот исход, который он должен предсказывать.
Последний пункт заслуживает особого внимания, поскольку это механическая связь между двумя понятиями. Низкая надёжность любого из показателей ограничивает максимально наблюдаемую корреляцию между ними — этот эффект называется аттенуацией. Три распространённые формы надёжности — ретестовая, внутренняя согласованность и согласованность между экспертами — каждая фиксирует свой источник этого шума.
Ретестовая надёжность, внутренняя согласованность и надёжность между экспертами: объяснение
Ретестовая надёжность измеряет стабильность во времени. Вы проводите один и тот же тест с одними и теми же людьми дважды — как правило, с интервалом от двух до четырёх недель — и коррелируете два набора результатов. Этот метод подходит для стабильных черт, таких как общий когнитивный потенциал или личностные характеристики, и плохо подходит для конструктов, которые должны быстро меняться, например настроения или кратковременного стресса.
Внутренняя согласованность измеряет, согласуются ли задания одного теста друг с другом — как правило, с помощью альфа-коэффициента Кронбаха. Это самая быстрая проверка надёжности, так как требует только одного применения, — именно поэтому она используется слишком часто. Альфа чувствительна к количеству заданий в тесте, поэтому длинный тест может давать завышенное значение альфы даже тогда, когда отдельные задания посредственны. Коэффициенты омега лучше справляются с этим для тестов с неравным качеством заданий, хотя альфа по-прежнему остаётся отраслевым стандартом.
Надёжность между экспертами имеет значение всякий раз, когда человек оценивает что-то субъективное: письменный образец, структурированное интервью, видеозадание. Каппа Коэна или коэффициент внутриклассовой корреляции (ICC) количественно определяют согласие между экспертами, корректируя его с учётом случайного совпадения.
Совет эксперта: Ретестовая корреляция на достаточно высоком уровне (нередко около +0,80 и выше) обычно рассматривается как практический ориентир для стабильных черт. Всё, что существенно ниже этого значения для черты, которая не должна меняться от недели к неделе, сигнализирует о конструктивной проблеме, которую стоит изучить прежде, чем выстраивать на этой основе какие-либо доказательства валидности.
Контекст определяет, какая форма важнее всего. Тест навыков с автоматической проверкой нуждается в высокой внутренней согласованности, но не требует проверки согласованности между экспертами вовсе. Структурированное интервью нуждается в согласованности между экспертами превыше почти всего остального.
Надёжный, но ошибочный, или валидный, но зашумлённый: путаница устранена
Наиболее наглядный способ увидеть разницу между валидностью и надёжностью теста — рассмотреть два типа сбоев, которые выглядят совершенно по-разному, но одинаково разрушают оценку.
- Надёжный, но невалидный: смещённый термометр, который каждый раз показывает на два градуса больше. Он абсолютно стабилен, что делает его надёжным, но каждое показание неверно, что делает его невалидным.
- Валидный, но ненадёжный: тест навыков всего из трёх заданий, охватывающих широкую компетенцию. В среднем по многим испытуемым он может разумно коррелировать с эффективностью работы, однако результат отдельного человека слишком сильно варьируется между попытками, чтобы доверять ему индивидуально.
Эти примеры отвечают на два вопроса, которые чаще всего ищут. Что первично? Функционально — надёжность, поскольку невозможно выстроить убедительный аргумент валидности на основе непоследовательных результатов. Может ли тест быть надёжным, не будучи валидным? Да, и легко — так происходит постоянно с тестами, которые внутренне согласованы, но попросту измеряют не тот конструкт для предполагаемого применения.
Если надёжность высока, а доказательств валидности мало, решение, как правило, связано с содержанием: привлеките экспертов в предметной области и проверьте, действительно ли задания представляют требуемую работу или черту. Если надёжность сама по себе слаба, никакой объём доказательств валидности не спасёт тест. Сначала необходимо устранить измерительный шум — как правило, добавив точно нацеленные задания или ужесточив правила оценивания, — и только после этого вопрос о валидности становится вообще разрешимым.
Пошаговый план сбора доказательств валидности и надёжности
Выстраивание обоснованного аргумента валидности — это последовательность, а не единственное исследование. Ниже приведён порядок, который позволяет получить доказательства, способные выдержать проверку.
- Определите предполагаемое применение в одном предложении. Формулировка «Эта оценка предсказывает эффективность работы в первые 90 дней на должности специалиста по поддержке клиентов» достаточно конкретна, чтобы направлять все последующие решения.
- Создайте план содержания. Перечислите навыки или области знаний, требуемые для предполагаемого применения, взвешенные по значимости, — прежде чем составить хотя бы одно задание.
- Проведите экспертную проверку содержания. Попросите двух-трёх экспертов в предметной области независимо оценить, соответствует ли каждое задание плану, и отметить всё, что выходит за его рамки.
- Проведите пилотный тест на репрезентативной выборке. Даже 40–80 ответов позволяют выявить проблемы на уровне заданий: запутанные формулировки, эффекты потолка, задания, с которыми никто не ошибается.
- Проведите анализ внутренней структуры. Используйте эксплораторный или конфирматорный факторный анализ, чтобы проверить, группируются ли задания так, как предсказывает ваш план, и вычислите альфа Кронбаха или омегу для каждой подшкалы.
- Проверьте конвергентные и дискриминантные связи. Коррелируйте результаты с установленным показателем того же конструкта и с показателем несвязанного конструкта, чтобы убедиться, что тест измеряет именно то, что заявлено.
- Собирайте критериальные данные, когда это возможно. Отслеживайте реальные исходы — оценки эффективности работы, темпы продвижения, показатели ошибок — и коррелируйте их с исходными результатами.
- Указывайте объём выборки, контекст и доверительные интервалы. Коэффициент надёжности, полученный на 30 людях в одном офисе, означает нечто иное, чем полученный на 2000 людях в пяти странах.
- Задокументируйте весь аргумент. Запишите, какие доказательства были собраны, почему и как они подкрепляют конкретное предполагаемое применение, определённое на шаге первом.
Совет эксперта: Пропустите шаг первый — и всё последующее будет сложнее защитить. Рецензенты, аудиторы и даже ваша собственная команда будут постоянно спрашивать «валидно для чего?», если предполагаемое применение так и не было записано.
Команды, создающие скрининговые тесты для конкретных должностей, нередко сразу переходят к пилотированию, пропуская этап разработки плана содержания, — а это в корне неверно. Именно план делает интерпретируемым каждый последующий шаг.
Практический чеклист для более качественных оценок
Большинство проблем с валидностью и надёжностью сводятся к нескольким устранимым конструктивным решениям. Прежде чем запустить или пересмотреть оценку, проверьте следующее:
- Каждое задание должно соответствовать конкретному пункту плана содержания; уберите всё, что не оправдывает своего места.
- Больше точно нацеленных заданий, как правило, лучше, чем меньше широких, поскольку дополнительные задания снижают измерительный шум и повышают внутреннюю согласованность.
- Стандартизируйте условия проведения — временны́е ограничения, инструкции, обстановку, — чтобы вариации в результатах отражали особенности человека, а не условия проведения.
- Обучите экспертов единой рубрике и проверьте согласованность между ними, прежде чем доверять суждению любого одного оценщика.
- Проводите пилотирование перед полным запуском и рассматривайте первую версию как черновик, требующий доработки.
- Собирайте критериальные или конвергентные данные при каждой возможности — хотя бы в неформальном режиме — и фиксируйте их вместе с остальными доказательствами.
Совет эксперта: Работодатели, создающие аудиторски-готовые тесты навыков, нередко обнаруживают, что наибольший прирост надёжности достигается за счёт стандартизации оценивания, а не добавления вопросов. Размытая рубрика каждый раз сводит на нет преимущества даже хорошо выстроенного банка заданий.
Привязка заданий к реальному описанию должности, а не к обобщённым ярлыкам навыков, также существенно укрепляет доказательства содержания, поскольку обобщённые ярлыки провоцируют создание обобщённых, малорелевантных заданий.
Как платформы оценки документируют валидность на практике
Ручной сбор всех этих доказательств — статистики по заданиям в одной таблице, заметок экспертов в другой, данных пилотирования в отдельной папке — это именно та работа, которую большинство команд молча пропускает под давлением дедлайнов. Платформа, созданная для структурированного ролевого тестирования, способна сжать этот цикл, не жертвуя строгостью.
Генерация заданий непосредственно из описания должности или перечня навыков даёт вам план содержания уже с первого черновика, вместо того чтобы восстанавливать его постфактум. Случайная выдача заданий и мониторинг защиты от мошенничества — включая проверки экрана и веб-камеры — укрепляют доказательства процессов ответа и последствий, снижая вероятность того, что результат отражает обман, а не навык. Экспортируемая статистика по заданиям, записи сеансов и сводки по результатам превращают то, что раньше было разрозненной папкой с материалами валидации, во что-то близкое к постоянно пополняемой документации.
Подход платформы состоит в том, чтобы рассматривать каждую завершённую оценку как точку данных в непрекращающемся аргументе валидности, а не просто как решение о найме, — именно это отличает обоснованную систему тестирования от интуитивной.
Что исследования на самом деле рекомендуют приоритизировать
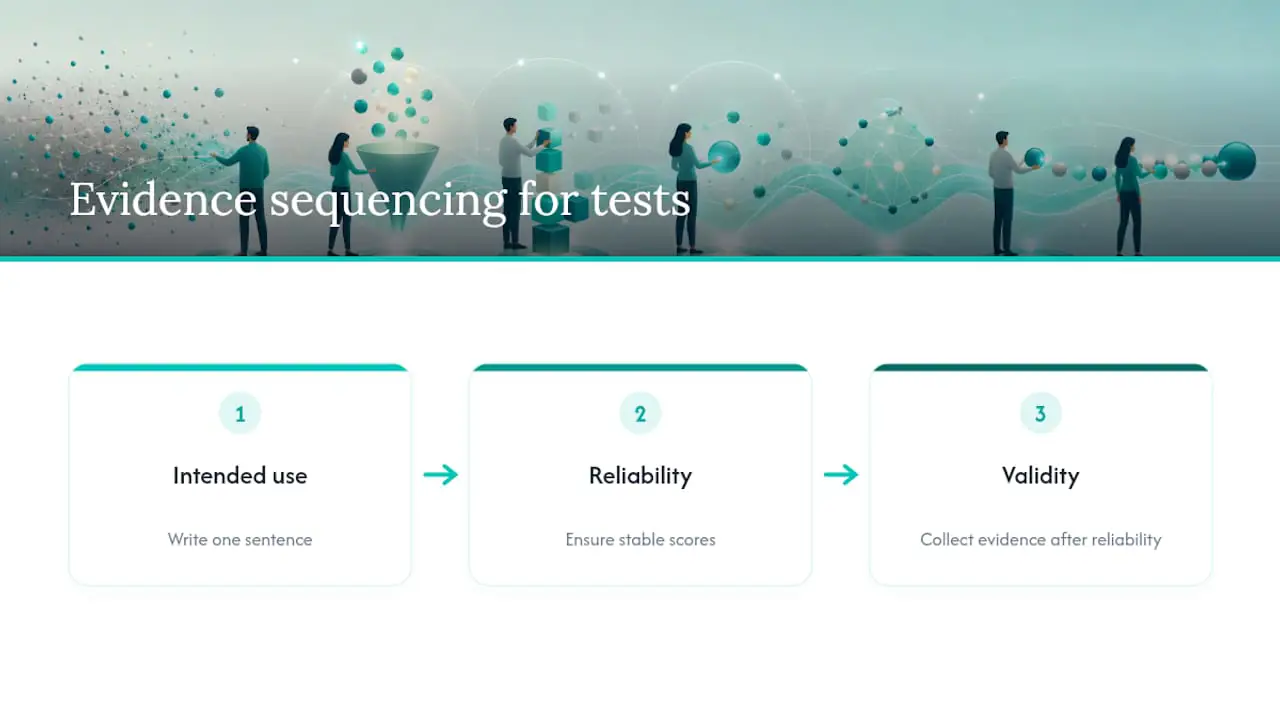
Наибольший разрыв между общепринятыми рекомендациями и тем, что подтверждают доказательства, касается последовательности. Большинство руководств рассматривают валидность и надёжность как параллельные контрольные списки, которые нужно пройти по одному разу. Но они не параллельны. Надёжность — это основание; валидность — то, что строится на нём, и никакая экспертная проверка содержания не спасёт тест, чьи результаты скачут от одного сеанса к другому.
Второй разрыв ещё более неудобен: команды любят доказательства содержания, потому что они дёшевы и быстры — три эксперта, один день, готово. Критериальные доказательства — фактическая проверка того, предсказывают ли результаты тот исход, который заявлен, — почти повсеместно пропускаются за пределами академических исследований, поскольку требуют терпения и данных об исходах, которые большинство команд по подбору персонала никогда не утруждаются собирать.
Если вы вынесете из этого материала только одно, пусть это будет следующее: запишите предполагаемое применение в одном предложении, прежде чем составить хотя бы одно задание. Всё остальное — план содержания, статистика, обучение экспертов — работает только в том случае, если это предложение точно. Расплывчатое предполагаемое применение порождает расплывчатые доказательства, сколь бы изощрённым ни выглядел факторный анализ.
— Jimmie
Создавайте валидированные оценки без ручного сбора доказательств
Документирование аргумента валидности вручную — статистика заданий в одной таблице, заметки экспертов в другой, данные пилотирования где-то ещё — это именно та работа, которая тихо отбрасывается под давлением дедлайнов. Инструмент генерирует ролевые задания непосредственно из описания должности, давая вам план содержания ещё до того, как вы написали хоть один вопрос, тогда как встроенный мониторинг защиты от мошенничества и записи сеансов добавляют доказательства процессов ответа, которые большинство команд не собирают вовсе.
Никаких обязательных подписок. Вы платите за каждого завершившего оценку кандидата, поэтому затраты масштабируются вместе с реальным объёмом найма, а не в виде фиксированной лицензионной платы. Если вы оцениваете навыки для конкретной роли и хотите, чтобы доказательства надёжности и валидности были встроены в процесс, а не собирались постфактум, ознакомьтесь с платформой и убедитесь, как описание должности превращается в проверяемую, обоснованную оценку за считанные минуты.
Источники
В классических учебниках содержательная, конструктная и критериальная валидность по-прежнему преподаются как три отдельных пункта для проверки. Современная психометрия рассматривает их как аспекты единого аргумента, и некоторые эксперты прямо выступают против их разделения, поскольку тест может выглядеть удовлетворительно по одному аспекту и резко провалиться по другому. Вот как доказательства на самом деле распределяются по тому, когда и как их собирают:
- Надёжность и валидность в исследованиях
- Введение в валидность в образовательном и психологическом тестировании
- Валидность для оценок
- Надёжность и валидность измерения (LibreTexts)
Разграничение экспертной оценки до сбора данных и статистических проверок после него важно, поскольку команды нередко останавливаются на первом шаге. Проверка содержания тремя экспертами кажется тщательной, но ничего не говорит о том, предсказывает ли тест что-либо реальное.
Часто задаваемые вопросы
Что первично: валидность или надёжность?
Функционально первична надёжность. Невозможно выстроить убедительный аргумент валидности на основе непоследовательных результатов, хотя одна лишь надёжность никогда не доказывает валидность теста.
Может ли тест быть надёжным без валидности?
Да. Тест может давать высокостабильные результаты, которые тем не менее измеряют совершенно не тот конструкт — классический пример: весы, которые каждый раз показывают одно и то же неверное значение.
В чём главное различие между надёжностью и валидностью?
Надёжность спрашивает, является ли измерение стабильным; валидность спрашивает, действительно ли это измерение фиксирует то, что заявлено, для конкретного предполагаемого применения.
Каковы примеры валидности и надёжности?
Смещённый термометр, который всегда показывает на два градуса больше, надёжен, но невалиден; тест из трёх заданий, который в среднем предсказывает эффективность работы, но сильно варьируется для отдельных людей, валиден, но ненадёжен.
Как измеряется надёжность теста?
Три наиболее распространённых метода — ретестовые корреляции, показатели внутренней согласованности, такие как альфа Кронбаха, и статистики согласованности между экспертами, такие как каппа или ICC, — выбираются в зависимости от того, повторяется ли тест, оценивается ли по заданиям или проверяется людьми-экспертами.
Рекомендуем
- HR-команды: сделайте тесты навыков аудиторски-готовыми за $5 за оценку
- Создавайте рубрики оценивания, которые педагоги могут пилотировать и масштабировать с помощью ИИ
- Команды по найму: 5 шагов к аналитике оценок, основанной на измерениях
- Как описания должностей формируют оценки, которые действительно предсказывают…