
Prioritera hög säkerhet för HR-bedömningar: Börja med nivå 3
Inte alla kunskapstester bär samma risk, så den smartaste hållningen är ett riskindelat program: tillämpa enkla kontroller på låginsatsscenarion och starka kontroller på höginsats- och högvolymroller. Tre saker att göra den här veckan: inför identitetskontinuitet (ID plus selfie-matchning) på alla tester som är kopplade till ett slutgiltigt anställningsbeslut, aktivera automatiserad datalagring med raderingsloggar och se till att varje flaggad session granskas av en människa innan den påverkar en kandidat.
Sammanfattning:
- Låginsatsbedömningar för högvolymroller bör förlita sig på minimala identitetskontroller och automatisk flaggning, medan höginsatsroller kräver fullständig identitetsverifiering och mänsklig granskning.
- Att kombinera flera signaler som blickspårning, ljudanalys och enhetsfingeravtryck skapar ett flerskiktat säkerhetssystem som är svårare att manipulera och ger förklaringsbara bevis för granskning.
- Att utforma tester med roterande frågor, scenariobaserade problem och tidsbegränsade steg minskar effektiviteten hos fuskverktyg och delandets av svar.
- Kandidatdata bör lagras i 12 till 24 månader med strikt kryptering, åtkomstloggar och automatisk radering för att minimera säkerhetsrisker.
- Att använda nivåindelade kontroller och tydlig kommunikation med kandidater inför driftsättning av bedömningar hjälper till att förhindra negativa effekter på skyddade grupper och säkerställer rätt säkerhetsnivå.
Innehållsförteckning
- Vad är bästa praxis för bedömningssäkerhet?
- Hur bör du nivåindela bedömningsrisken?
- Vilka identitets- och övervakningskontroller fungerar egentligen?
- Hur utformar du tester som motstår fusk?
- Hur länge bör du spara kandidatbedömningsdata?
- Vilka leverantörs- och åtkomstkontroller bör du kräva?
- Hur övervakar du fusk i stor skala?
- Hur bör du lansera nya säkerhetskontroller?
- Varför detta är viktigare än de flesta säkerhetslistor medger
- Omsätt dessa säkerhetspraxis med Talent Approved
- Källor
- Vanliga frågor
Vad är bästa praxis för bedömningssäkerhet?
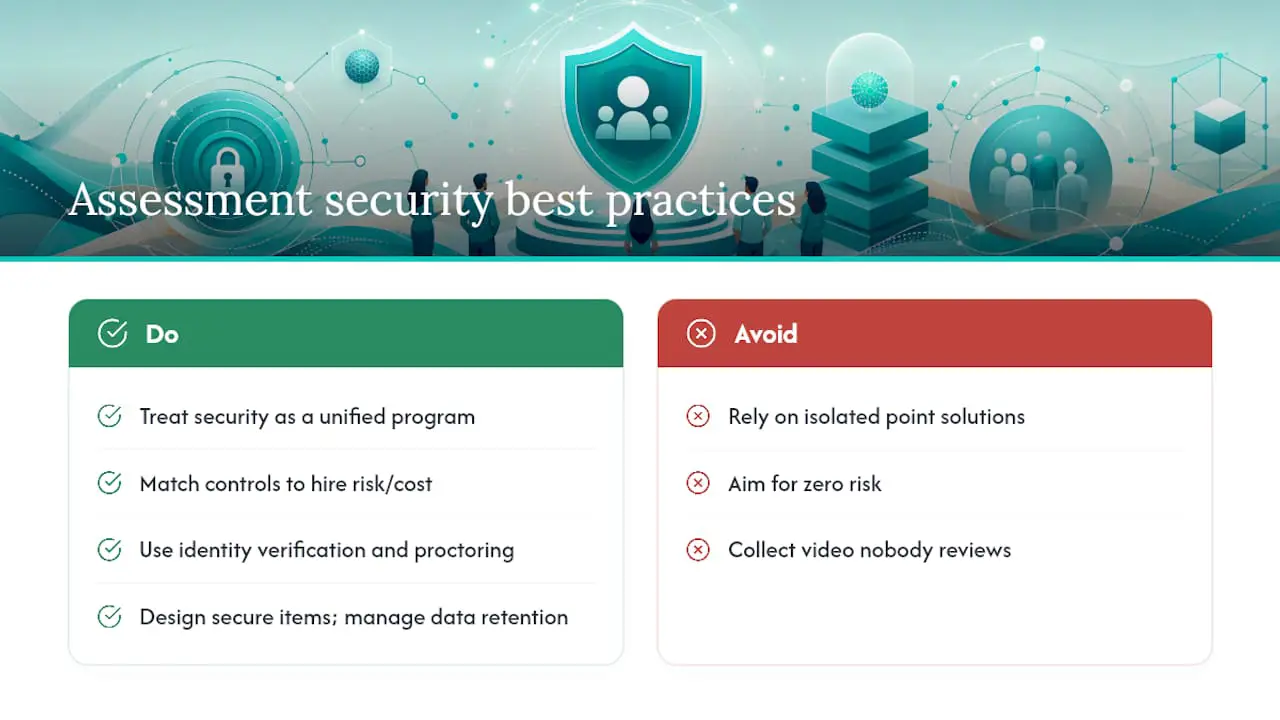
Bästa praxis för bedömningssäkerhet är de specifika kontroller som HR-team och rekryteringsansvariga använder för att skydda integriteten hos onlinekunskapstester och kandidatdatas integritet under den processen. Det omfattar identitetsverifiering, övervakning, uppgiftsutformning, datalagring, leverantörsgranskning och hur flaggade sessioner granskas. Disciplinen befinner sig i skärningspunkten mellan bästa praxis för testsäkerhet och dataskyddsstrategier, och att behandla det som ett enhetligt program – snarare än en lappkatalog av punktlösningar – är det som skiljer team som fångar fusk från team som bara samlar in video som ingen tittar på.
Målet är inte nollrisk. Det handlar om att matcha kostnaden för dina kontroller mot kostnaden för en felaktig rekrytering.
Hur bör du nivåindela bedömningsrisken?
Inte varje roll motiverar kontroll av statliga ID-handlingar och webbkameraövervakning. En Nivå 1-screening för en nybörjar- och högvolymroll (100+ sökande, låga individuella insatser) behöver enkla identitetskontroller och grundläggande webbläsarövervakning. En Nivå 2-bedömning på mellannivå för tekniska eller säljroller motiverar starkare identitetskontinuitet och flersidig övervakning. Nivå 3 täcker finala, höginsats- eller högt ersatta roller, där kostnaden för en dålig rekrytering eller en coachad kandidat är tillräckligt hög för att motivera fullständig identitetsverifiering, skiktad övervakning och obligatorisk mänsklig granskning av varje flagga.
- Nivå 1: lätt ID-kontroll, standardlåsning av webbläsare, enbart automatisk flaggning
- Nivå 2: selfie-matchning mot ID, sessionsinspelning, jämförelse mot beteendebaslinjer
- Nivå 3: statlig ID-handling plus live selfie-matchning, fullständig flersidig övervakning, 100 % mänsklig granskning innan avslag
Att framtidssäkra ditt program innebär att bygga modulära kontroller som du kan skruva upp eller ned per nivå istället för att bygga om bedömningar från grunden. Pilottesta din Nivå 3-process först, eftersom det är där ett misslyckande med säkerhetsbedömningsriktlinjer gör störst skada, och använd sedan tidiga resultat för att kalibrera att bygga ett högpresterande säljteam Nivå 1 och 2.
Vilka identitets- och övervakningskontroller fungerar egentligen?
Identitetskontinuitet är grunden. Ett kort kalibreingsklipp i början av ett test, följt av periodiska selfie-kontroller, fångar det vanligaste fuskmönstret: att någon annan slutför testet efter att den riktiga kandidaten loggat in. För Nivå 3-roller parar du detta med en statlig ID-handling plus live selfie-matchning vid start.
Flersidig övervakning slår alla enstaka dataströmmar. Att kombinera video, ljud, skärmtelemetri och tangenttrycksmönster mot kandidatens egna beteendebaslinjer skapar skiktade säkerhetssignaler som är mycket svårare att manipulera än webbkamerafilmer enbart, och de genererar förklaringsbara bevis som en granskare faktiskt kan agera på istället för ett vagt "misstänkt"-märke.
- Använd låsningsbara webbläsare för Nivå 3-tester; flagga (misslyckas inte automatiskt) flikbyten och urklippshändelser för Nivå 2
- Kombinera blickspårning, identifiering av ljudavvikelser och enhetsfingeravtryck för den starkaste signaluppsättningen
- Kör varje övervakningsflöde genom hjälpmedelstest innan lansering, med en alternativ verifieringsväg för kandidater som inte kan använda standardwebbkamerakontroller
Tips: Kör din egen övervakningsinställning genom en skärmläsare och en låg bandbreddsanslutning innan du lanserar den. Om ditt team inte kan slutföra testet smidigt, kommer många kandidater inte heller att kunna det – och du kommer att samla på dig falska positiva flaggor som inte har något med fusk att göra.
Hur utformar du tester som motstår fusk?
God design gör mer för att stoppa fusk än något övervakningsverktyg som skruvats på i efterhand. Fyra åtgärder spelar störst roll:
- Rotera stora frågebanker och pensionera frågor när analyser visar att de cirkulerar online eller utlöser ovanligt snabba och ovanligt korrekta svar.
- Bygg scenariobaserade flerstegsproblem med proprietärt sammanhang – som en fiktiv produktbeskrivning eller ett dataset unikt för din bedömning – så att skriptade svar från AI-verktyg eller forum slutar fungera.
- Tillämpa tidsbegränsningar per fråga kopplade till realistisk uppgiftstid, vilket begränsar hur mycket en kandidat kan lägga ut på entreprenad mitt i en fråga utan att bryta flödet.
- Blanda synkrona och asynkrona steg, kombinera ett tidsbegränsat livesegment med ett hemuppgiftsmoment, så att du kan triangulera om samma kompetensnivå visar sig i båda.
Det är här plagiatdetektering i bedömningar lönar sig: identiska svarssträngar hos kandidater, eller svar som matchar kända offentliga källor, är mycket lättare att fånga när din frågebank roterar regelbundet istället för att köra samma fasta frågeuppsättning i två år i sträck. En checklista för kandidatutvärdering hjälper till att hålla utformningen konsekvent mellan roller när du skalar upp detta.
Hur länge bör du spara kandidatbedömningsdata?
Varje del av bedömningsdata du sparar är en del du är ansvarig för om den läcker. Inspelade videor, transkript och biometriliknande artefakter är i praktiken oåterkalleliga när de väl exponerats, så att minimera insamlingen av allt utöver vad en roll faktiskt kräver är inte en valfri försiktighetsåtgärd – det är en grundläggande dataskyddsstrategi.
- Ange standardlagringstider i månader, inte år, med automatisk radering kopplad till milstolpar i rekryteringsbeslutet
- Kryptera känsliga fält på kolumnnivå och tillämpa TLS 1.3 för all data under överföring
- Föredra kundstyrda krypteringsnycklar där din leverantör stöder det
- Logga varje åtkomst- och exporthändelse med användare, tidsstämpel, IP-adress och angiven anledning
Dokumenterade lagringsriktlinjer pekar vanligen på 12 till 24 månader för icke antagna sökande, med verifierbara raderingsloggar som täcker videor, transkript och säkerhetskopior – inte bara den primära databasen. Om din leverantör inte kan producera en raderingslogg på begäran är det en verklig brist i dina säkerhetsbedömningsåtgärder, inte ett mindre pappersarbetsproblem.
Vilka leverantörs- och åtkomstkontroller bör du kräva?
Stark bedömningsutformning betyder ingenting om plattformen bakom den har svaga åtkomstkontroller eller en leverantör utan säkerhetsmeritförteckning. Inköp och IT bör kräva samma grundnivå som du skulle kräva av vilket system som helst som hanterar känsliga data.
- Bekräfta SOC 2 Typ II eller ISO 27001-attestation, ett undertecknat databehandlingsavtal, en aktuell lista över underleverantörer och SLA:er för incidentmeddelanden på 24 till 72 timmar
- Tillämpa SSO med MFA, rollbaserad åtkomstkontroll och kortlivade OAuth-token för alla integrationer, med kvartalsvisa granskningar av anslutna appar
- Lägg till bedömningsplattformen explicit i din incidentresponsplan med handlingsplaner för detektion, inneslutning och kandidatmeddelande
- Begränsa massexport av data bakom ett godkännandeflöde istället för att lämna dem öppna för alla inloggade användare
Det här är inga abstrakta IT-frågor. Härdad autentisering och centraliserad revisionsloggning är det som låter dig besvara en tillsynsmyndighets fråga eller en kandidats databegäran på timmar istället för veckor.
Hur övervakar du fusk i stor skala?
En integritetsdashboard som spårar flaggfrekvens, flaggtyp och utfallet av åtgärder över tid omvandlar anekdoter till bevis. Håll utkik efter identiska svarsmönster hos kandidater, enhetsfingeravtryck som återanvänds i till synes orelaterade sessioner och svarstider som inte matchar uppgiftens svårighetsgrad.
- Spåra andelen flaggade sessioner, fördelning per flaggtyp och tid till ärendelösning
- Led varje flaggad session genom mänsklig prövning innan något avslagsbeslut fattas
- Ge kandidater ett strukturerat sätt att bestrida en flagga med bevis
AI-genererade flaggor fungerar bäst som triage – för att lyfta fram förklaringsbara bevis som en person kan väga – och inte som en automatiserad avslagsmotor, vilket NIST:s riktlinjer för ansvarsfull AI behandlar som ett grundkrav för alla automatiserade system som påverkar verkliga människor.
Tips: Granska dashboardens andel falska positiva månadsvis, inte bara flaggantalet. En stigande flaggfrekvens med en oförändrad lösningsgrad innebär vanligtvis att dina regler behöver justeras – inte att fusket plötsligt ökat.
Hur bör du lansera nya säkerhetskontroller?
Börja smalt, kommunicera tydligt och skala sedan upp.
- Berätta för kandidaterna i förväg vad som samlas in, varför, hur länge det sparas och hur de begär anpassningar innan testet börjar.
- Tillhandahåll utrustningslistor och en provkörning så att tekniska problem inte förväxlas med misstänkt beteende.
- Pilottesta per roll eller region först och spåra avhoppsfrekvenser och mätvärden för negativ påverkan innan bredare utrullning.
- Testa varje övervakningsflöde med hjälpmedel och publicera en tydlig väg för anpassningar.
Håll koll på urvalsfrekvenser per grupp när du skalar upp. Om någon skyddad grupps urvalsfrekvens sjunker under 80 % av den högsta gruppens frekvens är det en signal om negativ påverkan som är värd att undersöka innan du rullar ut kontroller ytterligare – och tillgänglighetstestning i förväg förhindrar vanligtvis det problemet helt.
Varför detta är viktigare än de flesta säkerhetslistor medger
De flesta säkerhetsbedömningsriktlinjer som HR-team får läser ut som om de skrivits för ett datacenter, inte en rekryteringsprocess. De pratar om kryptering och åtkomstloggar och hoppar över den del där en nervös kandidat på en delad dator utlöser en övervakningsflagga som aldrig granskas av en människa och tyst plockas bort från processen. Det är inte en säkerhetsvinst. Det är ett rekryteringsmisslyckande iklätt ett säkerhetsmärke.
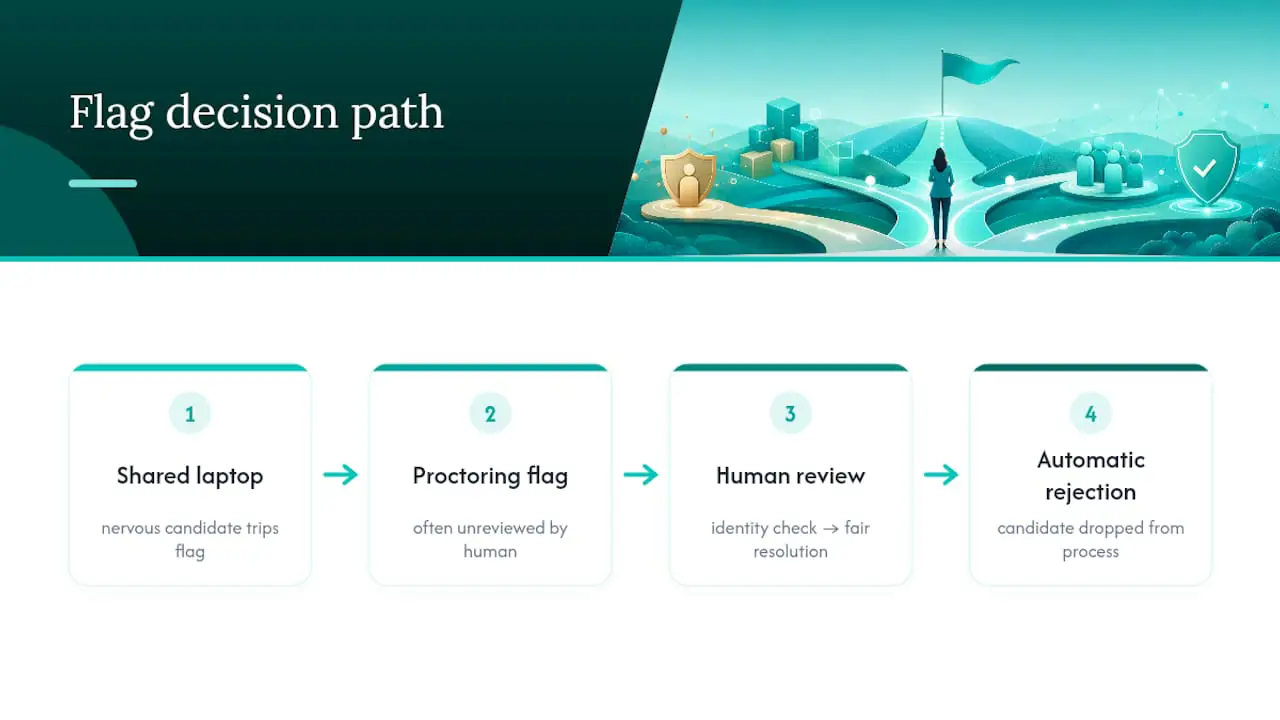
Den obehagliga sanningen är att det mesta fusket inte är sofistikerat. Det är någon som delar skärm med en vän, eller en coachad kandidat som läser från en andra bildskärm. Avancerade antifusksystem byggda för att fånga bedrägeri på nationalstatsnivå missar ofta det, samtidigt som de skapar friktion för legitima kandidater som bara har dåligt internet eller behöver en skärmläsare. Lösningen är inte mer övervakning. Det är bättre utformade frågor, tätare identitetskontinuitet vid de avgörande momenten och en människa som faktiskt tittar på flaggan innan någon avvisas.
Att bygga bedömningar med Magic Create på Talent Approved – som genererar rollspecifika tester från en arbetsbeskrivning på minuter – skapar en nyttig disciplin: när testet i sig är välutformat och kopplat till verkliga arbetsuppgifter behöver du mycket mindre övervakning för att fånga bedrägerier, eftersom det finns mindre generiskt, googlingsbart innehåll att fuska med från början.
— Jimmie
Omsätt dessa säkerhetspraxis med Talent Approved
Varje kontroll som den här guiden beskriver – nivåindelade identitetskontroller, skiktad övervakning, lagringsregler med revisionsloggar – mappas direkt till hur plattformar som Talent Approved är byggda. Vissa plattformar erbjuder verktyg som genererar rollspecifika bedömningar från en arbetsbeskrivning på minuter, vilket minskar generiska, lätt sökbara frågor innan du ens tänker på övervakning. Inbyggda antifuskverktyg som inkluderar skärm- och webbkameraövervakning, sessionsuppspelningar och AI-genererade sammanfattningar kan ge granskarna förklaringsbara bevis istället för en rå videofil att titta igenom från början till slut.
Det finns ingen prenumeration att binda sig till. Vissa bedömningsplattformar fungerar på en betala-per-användning-modell med en avgift per genomförd kandidat, vilket gör det möjligt att pilottesta en enda höginsatsroll innan du rullar ut kontroller ytterligare. Om du är redo att testa detta på din nästa Nivå 3-rekrytering, granska prissättning och kunskapsbedömningar och börja med en roll den här månaden.
Källor
- GDPR:s vägledning om datalagring
- Framtidssäkra din bedömningsplattform inför nästa våg av fuskverktyg
- Skydda dina rekryteringsdata: ATS-säkerhetschecklista
Vanliga frågor
Vad är det första steget i bedömningssäkerhet?
Börja med att nivåindela dina bedömningar efter risk och tillämpa sedan identitetsverifiering och övervakningsintensitet som matchar varje nivå istället för att använda en standard för varje roll.
Hur länge bör kandidatvideo sparas?
Vanlig praxis anger lagring på 12 till 24 månader för icke antagna sökande, med automatisk radering och en verifierbar raderingslogg som täcker videor, transkript och säkerhetskopior.
Ingår antifuskverktyg i Talent Approved?
Ja. Talent Approved inkluderar inbyggda antifuskmekanismer med skärm- och webbkameraövervakning, sessionsuppspelningar och AI-genererade sammanfattningar för att stödja mänsklig granskning av flaggade sessioner.
Bör AI flagga fusk automatiskt?
Nej. AI-genererade flaggor bör fungera som ett triageskikt som lyfter fram förklaringsbara bevis, med en mänsklig granskare som fattar det slutliga beslutet om varje åtgärd som påverkar en kandidat.
Hur mycket kostar Talent Approved?
Talent Approved använder en betala-per-användning-modell till 5 dollar per kandidat som slutför en bedömning, utan prenumerationskrav, enligt vad som anges på prissättningssidan.