
Guide RH américain sur les tests d'impact défavorable : Exécuter, Lire, Corriger
Si votre processus de recrutement produit un taux de sélection nettement inférieur pour un groupe protégé par rapport à votre groupe au taux le plus élevé, vous avez un signal qui mérite d'être examiné. Calculez le ratio d'impact et réalisez un test de signification (en utilisant des méthodes appropriées selon la taille des échantillons) avant de prendre une autre décision d'embauche avec cette procédure. Si l'un ou l'autre signale un problème, validez l'évaluation selon les critères de l'UGESP ou remplacez-la par une alternative moins discriminatoire qui prédit la performance au poste de manière comparable.
En bref :
- L'impact défavorable peut survenir même avec des procédures de sélection neutres, comme des tests ou des entretiens, produisant des disparités statistiquement significatives sans intention délibérée.
- Valider les évaluations implique de calculer les taux de sélection, les ratios d'impact inférieurs à 0,80, et de réaliser des tests de signification avec des tailles d'échantillon appropriées, en regroupant plusieurs cycles de recrutement pour plus de précision.
- Les organisations doivent conserver des enregistrements détaillés des données de candidature, des efforts de validation et des analyses d'impact afin de se conformer à l'UGESP et de se préparer aux audits, notamment pour les contractants fédéraux.
- Les évaluations spécifiques aux tâches et aux rôles, ainsi que les entretiens structurés, réduisent mieux les disparités que les filtres génériques, surtout lorsqu'elles sont conçues à partir d'une analyse de poste préalable.
- Le suivi continu des ratios d'impact et des outils d'IA, avec la validation des fournisseurs, est essentiel pour maintenir des pratiques de recrutement équitables et éviter des disparités récurrentes dans le temps.
Table des matières
- Ce que mesure réellement le test d'impact défavorable
- Comment effectuer les calculs : taux de sélection, ratios d'impact et tests de signification
- Interpréter les résultats sans surréagir ni sous-réagir
- Améliorer le pipeline : analyse de poste, entretiens structurés et meilleures évaluations
- Validation et tenue des dossiers : ce que l'UGESP attend de vous
- Maintenir les outils de sélection basés sur l'IA et les algorithmes sous contrôle
- Une liste de contrôle pratique pour créer des évaluations plus équitables
- À quoi ressemble le test d'impact défavorable selon les secteurs
- Les limites du test d'impact défavorable
- Intégrer les vérifications d'impact défavorable dans la gouvernance continue
- Créez des tests plus équitables plus rapidement avec Talent Approved
- Sources
- FAQ
Ce que mesure réellement le test d'impact défavorable
L'impact défavorable est un résultat statistique, non une intention. Il apparaît lorsqu'une procédure de sélection apparemment neutre — un test cognitif, une grille d'entretien, un filtre de CV — produit des taux de réussite significativement différents selon la race, le sexe, l'âge ou d'autres groupes protégés, indépendamment des intentions de quiconque. Cette distinction le sépare du traitement différencié, qui requiert la preuve que quelqu'un a été ciblé intentionnellement. L'analyse de l'impact défavorable pose une question plus froide : les chiffres se sont-ils distribués de manière inégale, et si oui, pourquoi ?
Le cadre juridique repose sur trois piliers. Le Titre VII de la loi sur les droits civiques interdit les pratiques d'emploi qui écartent de manière disproportionnée un groupe protégé, à moins que l'employeur ne puisse justifier cette pratique. Les Uniform Guidelines on Employee Selection Procedures (UGESP), adoptées conjointement par des agences fédérales en 1978, précisent comment les employeurs doivent évaluer leurs outils de sélection et à quel moment ils doivent fournir au gouvernement une étude de validation. L'EEOC applique le Titre VII et émet des orientations interprétatives, tandis que l'OFCCP applique des normes parallèles aux contractants fédéraux et réalise souvent les tests statistiques lors des audits de conformité.
La validation est déclenchée dès que l'analyse d'impact défavorable révèle une disparité qui franchit les seuils de signification statistique et pratique. À ce stade, les orientations de l'EEOC sont claires : l'employeur doit démontrer que la procédure est liée au poste et conforme à la nécessité professionnelle, ou adopter une alternative moins discriminatoire.
La législation fédérale protège ces groupes dans le contexte des tests d'emploi :
- Race et couleur
- Sexe, y compris la grossesse et l'identité de genre
- Origine nationale
- Religion
- Âge (40 ans et plus, en vertu de l'ADEA)
- Statut de handicap (ADA)
Chacune de ces catégories nécessite sa propre comparaison de taux de sélection. Les regrouper, ou ne vérifier que la race en ignorant l'âge, c'est ainsi que les disparités passent inaperçues jusqu'à ce qu'une plainte arrive sur votre bureau.
Comment effectuer les calculs : taux de sélection, ratios d'impact et tests de signification
Tester les biais dans votre pipeline de recrutement suit une séquence fixe. Sauter une étape vous fera soit manquer un vrai problème, soit courir après un problème inexistant.
- Calculez le taux de sélection pour chaque groupe. Divisez le nombre de candidats sélectionnés par le nombre de candidats dans ce groupe. Si 80 femmes ont postulé et 20 ont été embauchées, le taux de sélection est de 25 %.
- Identifiez le groupe ayant le taux de sélection le plus élevé. Celui-ci devient votre référence de comparaison, quelle que soit la taille du groupe.
- Calculez le ratio d'impact. Divisez le taux de sélection de chaque groupe par le taux du groupe de référence. Un ratio inférieur à 0,80 déclenche la règle des quatre cinquièmes.
- Effectuez un test de signification. Pour des échantillons de 30 candidats ou plus par groupe, utilisez le test Z binomial à deux échantillons. Pour des échantillons plus petits, utilisez le test exact de Fisher, qui ne repose pas sur des approximations de grands échantillons.
- Interprétez par rapport à votre niveau alpha. La plupart des praticiens utilisent un niveau alpha représentant environ 95 % de confiance, bien que certaines agences appliquent des seuils plus stricts pour les comparaisons bilatérales.
Point statistique à noter : L'OFCCP considère qu'une valeur Z absolue à un seuil jugé statistiquement significatif correspond approximativement à un niveau de confiance de 95 %, s'alignant globalement sur un seuil de confiance de 95 %. Ce chiffre, et pas seulement le ratio des quatre cinquièmes, est ce qu'un agent de conformité fédéral calculera réellement lors d'un audit.
La règle des quatre cinquièmes est un outil de filtrage, pas un verdict. Les orientations de l'EEOC la décrivent comme une règle empirique que les agences appliquent avec discernement. Un ratio de 0,79 dans un pool de six candidats ne signifie presque rien sur le plan statistique. Un ratio de 0,83 sur 4 000 candidats peut tout de même représenter une disparité réelle et significative. La règle indique où chercher. Le test Z ou le test exact de Fisher vous indique si ce que vous observez est du bruit statistique.
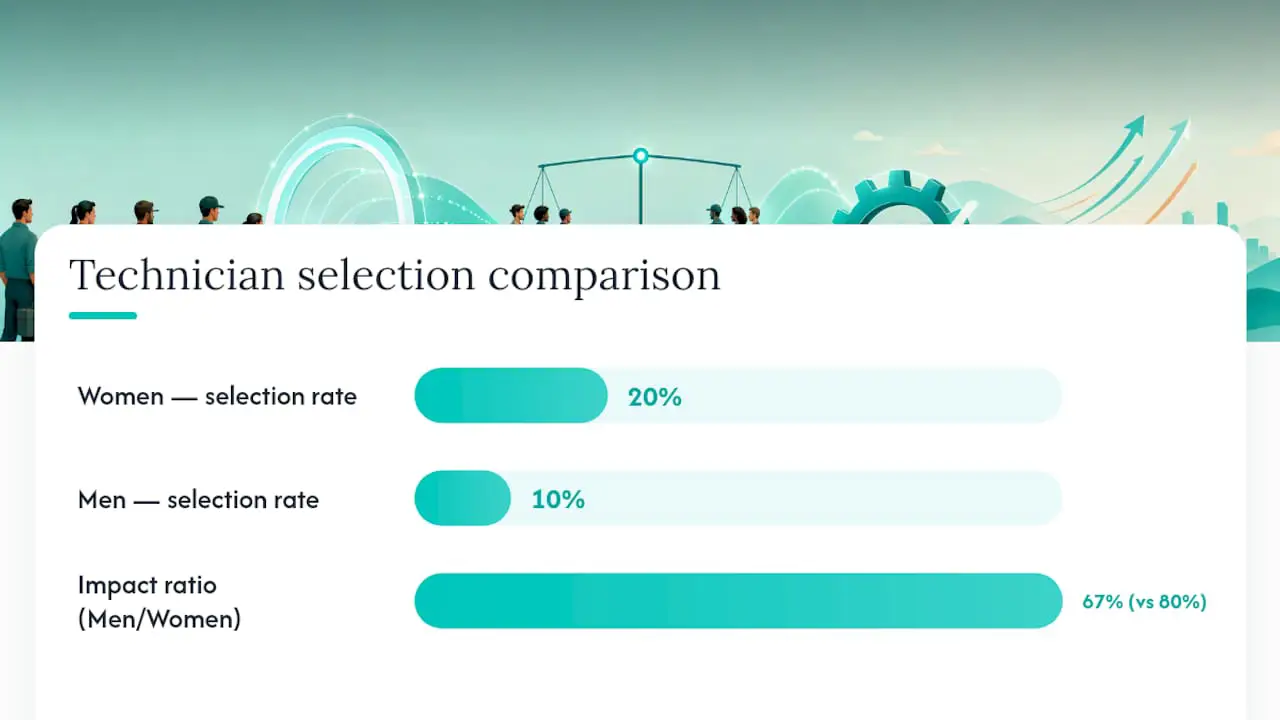
Voici un exemple simplifié. Supposons que 200 hommes et 150 femmes postulent à un poste de technicien. Le ratio d'impact est de 20/30, soit 0,67, bien en dessous du seuil de 0,80. L'application d'un test Z à deux échantillons sur ces chiffres (les deux groupes dépassent 30) vous indiquerait si cet écart de 10 points est probablement dû au hasard ou reflète un problème structurel dans l'évaluation elle-même.
Interpréter les résultats sans surréagir ni sous-réagir
Un ratio signalé est un point de départ pour l'enquête, pas une conclusion automatique de discrimination, et un ratio satisfaisant ne garantit pas que votre processus est équitable. Les petits pools de candidats faussent à la fois le ratio des quatre cinquièmes et les tests de signification : quelques embauches peuvent faire varier un taux de sélection de 10 à 15 points, de sorte qu'un seul cycle de recrutement suffit rarement à lui seul pour brosser le tableau complet.
Méfiez-vous de ces erreurs courantes :
- Tester des dizaines de sous-groupes sans ajuster votre alpha, ce qui augmente les chances d'un faux positif quelque part dans les données, purement par hasard.
- Ignorer les intervalles de confiance et traiter un ratio limite comme définitivement correct ou définitivement problématique.
- Surréagir à un mauvais trimestre au lieu de regrouper plusieurs cycles de recrutement pour voir si le schéma se confirme.
- Sous-réagir à un ratio des quatre cinquièmes « satisfaisant » qui masque un score Z statistiquement significatif, étant donné que les deux mesures répondent à des questions différentes.
Chaque test de signification implique un compromis entre l'erreur de type I (signaler comme biaisé un processus équitable) et l'erreur de type II (manquer un processus réellement biaisé). Un alpha plus strict réduit les fausses alarmes, mais facilite le passage des vraies disparités dans des échantillons plus petits — c'est précisément pourquoi les régulateurs privilégient le test exact de Fisher plutôt qu'un test Z lorsque les tailles des groupes sont faibles.
Conseil pratique : Regroupez au moins deux ou trois cycles de recrutement avant de décider si une disparité est réelle. Un trimestre atypique avec 12 candidats peut produire un ratio qui semble spectaculaire, mais qui disparaît une fois que vous ajoutez les 200 candidats suivants à l'ensemble de données.
Lorsqu'un résultat franchit à la fois le seuil des quatre cinquièmes et un test de signification sur plusieurs cycles, c'est le signal pour passer à la validation ou tester un remplacement — et non simplement surveiller en espérant que la situation se corrige d'elle-même.
Améliorer le pipeline : analyse de poste, entretiens structurés et meilleures évaluations
L'atténuation fonctionne mieux lorsqu'elle commence avant même que vous publiiez une offre d'emploi, et non après que l'analyse d'impact défavorable ait révélé un problème.
- Commencez par une analyse de poste. Définissez les tâches réelles et les compétences que le rôle exige avant de choisir ou de créer un test. Un filtre générique de capacités cognitives pour un poste de saisie de données invite à des disparités qu'un test de frappe et de précision basé sur les tâches éviterait.
- Privilégiez les évaluations spécifiques aux tâches et au rôle plutôt que les filtres généraux. Les tests structurés et pertinents pour le poste qui reflètent les tâches réelles du travail tendent à produire de plus petites différences entre groupes que les tests d'aptitude abstraits, tout en prédisant bien la performance.
- Utilisez des entretiens structurés avec des questions fixes et des grilles de notation. Les entretiens non structurés, où chaque intervieweur pose les questions qui lui viennent à l'esprit, sont là où le biais subjectif s'infiltre le plus facilement.
- Créez des grilles d'évaluation et formez les évaluateurs à les utiliser de manière cohérente. Deux intervieweurs notant la même réponse devraient aboutir à une note à un point près, et non à trois points d'écart.
- Testez des alternatives lorsqu'un outil signale un impact défavorable. L'UGESP exige des employeurs qu'ils évaluent les alternatives appropriées et adoptent celle qui présente une validité substantiellement égale et un impact moindre.
Conseil pratique : Ne retirez pas une évaluation uniquement parce qu'elle montre une disparité. Comparez d'abord sa validité avec celle du remplacement proposé. Échanger un test bien validé contre un test non testé peut troquer un risque juridique contre un risque de mauvaise embauche.
Les outils de filtrage structurés et basés sur les tâches, directement associés aux compétences du poste, surpassent constamment les filtres génériques tant sur le plan de l'équité que de la précision prédictive, principalement parce qu'ils mesurent ce que le poste exige réellement plutôt qu'un indicateur indirect.
Validation et tenue des dossiers : ce que l'UGESP attend de vous
L'UGESP exige une étude de validation dès que l'analyse d'impact défavorable franchit les seuils statistiques et pratiques, et les directives reconnaissent trois types de preuves : la validité de contenu (le test reflète directement les tâches du poste), la validité liée au critère (les scores sont corrélés à la performance réelle au travail) et la validité de construit (le test mesure un trait sous-jacent lié au succès dans le poste).
La validation locale, une étude menée sur votre propre population de candidats, a le plus de poids. La validité transportée, où vous vous appuyez sur une étude de validation provenant d'un poste similaire ailleurs, est acceptable lorsque les rôles et les contextes sont réellement comparables, mais les régulateurs examinent de près l'adéquation.
Conservez ces dossiers et tenez-les prêts pour les audits :
- Données de flux de candidatures ventilées par groupe protégé, pour chaque offre de poste
- Taux de sélection et calculs du ratio d'impact pour chaque cycle de recrutement
- Toute documentation d'étude de validation, y compris la méthodologie et les résultats
- Documents des fournisseurs décrivant comment une évaluation achetée a été construite et validée
Le CFR §1607.4 définit les exigences de tenue de dossiers directement liées à l'application de la règle des quatre cinquièmes. Traitez ces dossiers comme vous traiteriez des documents fiscaux : conservés pendant des années, organisés par cycle, et prêts à être remis à bref délai.
Maintenir les outils de sélection basés sur l'IA et les algorithmes sous contrôle
Un algorithme ne bénéficie d'aucune dérogation simplement parce qu'un être humain n'a pas rédigé les règles de notation à la main. Les orientations techniques de l'EEOC sont explicites : il n'existe pas d'exemption algorithmique. Les logiciels, les outils de classement de CV et les outils de sélection pilotés par l'IA doivent satisfaire aux mêmes exigences de pertinence pour le poste et de validation qu'un test papier-crayon de 1985.
Mettez en place un calendrier de surveillance, et non une vérification ponctuelle :
- Recalculez les ratios d'impact et les tests de signification à chaque cycle de recrutement ou chaque trimestre, selon ce qui arrive en premier
- Suivez les taux de sélection par groupe protégé à chaque étape que l'outil concerne, pas seulement la décision finale
- Demandez directement aux fournisseurs leurs preuves de validation, une description de leurs données d'entraînement et tout test d'équité qu'ils ont effectué
- Disposez d'un plan de remédiation prêt : ajustements du modèle, révision humaine supplémentaire ou remplacement par une évaluation alternative
Conseil pratique : Demandez la documentation sur l'impact défavorable d'un fournisseur avant de signer, et non après votre premier trimestre signalé. La surveillance continue des outils de sélection basés sur l'IA fonctionne bien mieux comme pratique permanente que comme mesure de rattrapage d'urgence.
Une liste de contrôle pratique pour créer des évaluations plus équitables
Un test équitable commence par la conception, pas par la gestion des dommages. Associez les tâches du poste au contenu du test, créez des items autour de ces tâches, testez avec un échantillon réel de candidats, mesurez les ratios d'impact, puis validez ou révisez avant le déploiement complet.
- Cartographiez les tâches essentielles du poste avant de rédiger la moindre question
- Créez des items basés sur les tâches, et non des questions d'aptitude génériques
- Testez avec un échantillon représentatif de candidats
- Mesurez les ratios d'impact et la signification avant le déploiement complet
- Validez ou itérez en fonction de ce que le test pilote révèle
Les dispositifs anti-triche et les résumés de notation générés par l'IA accélèrent considérablement ce cycle. Lorsque chaque candidat passe le même test basé sur les tâches dans les mêmes conditions surveillées, et que chaque note est accompagnée d'une justification documentée, vous obtenez des données plus propres pour les calculs de ratios d'impact et une piste d'audit prête pour un contrôle.
À quoi ressemble le test d'impact défavorable selon les secteurs
La mécanique reste la même partout, mais les outils qui font l'objet d'un examen minutieux varient selon le secteur. Dans la fabrication et la logistique, les tests d'aptitude physique et les évaluations de la force ont historiquement produit certains des écarts les plus importants entre les sexes, poussant de nombreux employeurs à se tourner vers des tests de simulation de tâches qui reflètent le levage ou les mouvements réels requis plutôt que des références de force brute.
Dans les secteurs technologiques et financiers, les tests de capacités cognitives et les évaluations de codage font l'objet de la plus grande attention. Un test générique de logique peut produire des disparités selon la race ou l'origine nationale qu'un défi de codage spécifique au rôle, noté selon le langage et la pile de tâches réels utilisés dans le poste, réduit souvent considérablement.
Le recrutement dans le commerce de détail et l'hôtellerie repose largement sur des entretiens structurés et des évaluations de la personnalité, où les formats d'entretien non structurés et improvisés demeurent l'une des sources les plus courantes de disparité liée à l'évaluateur. Les systèmes de santé testent de plus en plus des compétences adjacentes aux licences (précision de la documentation des patients, calcul des médicaments) plutôt que l'aptitude générale, en grande partie parce que ces mesures basées sur les tâches résistent mieux aux examens de validité et d'impact défavorable.
Le recrutement dans le secteur public et chez les contractants gouvernementaux fait l'objet du contrôle le plus strict de tous, car les examens de conformité de l'OFCCP extraient systématiquement les données de flux de candidatures et recalculent indépendamment le test Z. Tout employeur ayant des contrats fédéraux devrait supposer que ses chiffres seront recalculés par quelqu'un extérieur à l'organisation.
Les limites du test d'impact défavorable
La règle des quatre cinquièmes et les tests de signification sont des outils utiles, mais ils ont des limites. Les deux méthodes partagent une faiblesse structurelle : elles mesurent les résultats au niveau du groupe, ce qui signifie qu'elles peuvent manquer entièrement les inégalités au niveau individuel, ou signaler une disparité qui n'a rien à voir avec le test lui-même et tout à voir avec un pool de candidats non représentatif.
La taille de l'échantillon joue dans les deux sens. Trop peu de candidats dans un groupe et le ratio des quatre cinquièmes oscille énormément sur une ou deux embauches. Le test exact de Fisher gère mieux les petits échantillons qu'une approximation par test Z, mais même lui ne peut pas fabriquer de puissance statistique à partir d'un pool de huit candidats. À l'autre extrême, de très grands pools de candidats peuvent produire un score Z statistiquement significatif pour un écart si faible qu'il n'a aucune signification pratique pour les perspectives de carrière de quiconque.
La qualité des données constitue son propre point faible. Les données démographiques autodéclarées comportent des lacunes et des incohérences. Les entonnoirs de recrutement à plusieurs étapes facilitent la perte de trace des candidats qui se sont retirés volontairement par rapport à ceux qui ont été éliminés par l'outil que vous testez. Et tester des dizaines de catégories de postes ou de sites à la fois, sans ajuster pour les comparaisons multiples, augmente les chances que quelque chose semble signalé purement par hasard.
Rien de tout cela ne rend la méthodologie inutile. Cela signifie que le test d'impact défavorable est une entrée dans un jugement, pas une formule qui produit à elle seule un résultat clairement positif ou négatif.
Intégrer les vérifications d'impact défavorable dans la gouvernance continue
La plus grande erreur que je constate est de traiter cela comme un audit ponctuel plutôt que comme une discipline permanente. Calculez les ratios une fois, corrigez le test signalé, passez à autre chose, et le même écart resurgit souvent deux cycles de recrutement plus tard sous une forme légèrement différente. Intégrez-le dans les revues trimestrielles, formez les responsables du recrutement à repérer les signaux d'alarme avant que les RH n'aient à les attraper après coup, et réunissez les équipes juridique, RH et analytique dans la même salle lorsqu'un chiffre bouge. La répartition des responsabilités entre trois départements sans tableau de bord partagé est la façon dont les disparités persistent pendant des années sans être remarquées.
— Jimmie
Créez des tests plus équitables plus rapidement avec Talent Approved
Talent Approved propose des outils pour aider à créer rapidement des évaluations basées sur les tâches, ce qui peut être utile lorsque l'analyse d'impact défavorable indique la nécessité de tester rapidement une alternative. La fonctionnalité Magic Create génère des tests spécifiques au rôle directement à partir d'une description de poste ou d'une liste de compétences, le type d'évaluation associée aux tâches que ce guide recommande plutôt que les filtres cognitifs génériques.
La surveillance intégrée et les résumés de performance générés par l'IA visent à fournir des données de notation propres et documentées, utiles pour les études de validation ou les examens. Cette piste de documentation, directement liée aux étapes d'atténuation couvertes ci-dessus, fait souvent la différence entre une réponse de conformité rapide et une fouille dans d'anciens tableurs. Si votre outil de sélection actuel vous a déjà inquiété quant à ses taux de sélection entre groupes, commencez à créer une évaluation spécifique au rôle sur Talent Approved et voyez à quelle vitesse un test plus équitable peut être mis en place.
Sources
- Tests d'emploi et procédures de sélection | EEOC
- CFR §1607.4 — Définition de la discrimination : Relation entre l'utilisation des procédures de sélection et la discrimination
FAQ
Quelle est la différence entre l'impact défavorable et le traitement différencié ?
L'impact défavorable est une disparité statistique dans les résultats entre groupes protégés découlant d'une procédure neutre, tandis que le traitement différencié requiert la preuve d'une discrimination intentionnelle à l'encontre d'une personne ou d'un groupe spécifique.
Qu'est-ce que la règle des quatre cinquièmes dans les tests d'emploi ?
Elle signale un problème possible lorsque le taux de sélection d'un groupe protégé tombe en dessous de 80 % du taux du groupe ayant le taux de sélection le plus élevé, bien que les orientations de l'EEOC la considèrent comme un outil de filtrage et non comme une règle juridique absolue.
Quand utiliser un test Z plutôt que le test exact de Fisher ?
Utilisez le test Z binomial à deux échantillons lorsque chaque groupe compte 30 candidats ou plus ; utilisez le test exact de Fisher pour les échantillons plus petits, où les approximations de grands échantillons deviennent peu fiables.
Les outils de recrutement basés sur l'IA doivent-ils également faire l'objet d'un test d'impact défavorable ?
Oui. L'EEOC a précisé qu'il n'existe aucune exemption pour les outils algorithmiques en matière d'analyse d'impact défavorable, de sorte que les logiciels et les outils de sélection pilotés par l'IA doivent être testés et validés de la même manière que les évaluations traditionnelles.
Que se passe-t-il si mon évaluation révèle un impact défavorable ?
Vous devez démontrer que la procédure est liée au poste et conforme à la nécessité professionnelle, ou adopter une alternative moins discriminatoire présentant une validité comparable, et des plateformes comme Talent Approved peuvent vous aider à tester et documenter rapidement cette alternative.
Recommandé
- Directives de test de l'EEOC : ce que les employeurs doivent savoir
- Gérer les évaluations de recrutement à volume élevé : un guide pratique pour 2026
- Formats d'évaluation technique pour les RH : un guide 2026
- Arrêtez les recrutements biaisés : liste de contrôle de la stratégie de localisation des évaluations pour les RH