
US HR-håndbog om Adverse Impact-test: Kør, Læs, Ret
Hvis din ansættelsesproces producerer en markant lavere udvælgelsesrate for en beskyttet gruppe sammenlignet med din højest scorende gruppe, har du et signal, der er værd at undersøge. Kør impaktratioen og en signifikanstest (ved hjælp af passende metoder til større eller mindre stikprøver), inden du træffer endnu en ansættelsesbeslutning med denne procedure. Hvis en af dem identificerer et problem, skal du validere vurderingen i henhold til UGESP eller erstatte den med et mindre diskriminerende alternativ, der forudsiger jobpræstation på sammenlignelig vis.
TL;DR:
- Negativ påvirkning kan forekomme selv ved neutrale udvælgelsesprocedurer som tests eller interviews og kan producere statistisk signifikante forskelle uden bevidst hensigt.
- Validering af vurderinger indebærer beregning af udvælgelsesrater, impaktratiоer under 0,80 og udførelse af signifikanstests med passende stikprøvestørrelser, hvor flere ansættelsescyklusser slås sammen for at opnå nøjagtighed.
- Organisationer skal føre detaljerede registre over ansøgerdata, valideringsindsatser og påvirkningsanalyser for at overholde UGESP og forberede sig på revisioner, især for føderale underleverandører.
- Opgavespecifikke, rollebaserede vurderinger og strukturerede interviews reducerer uoverensstemmelser bedre end generiske screeninger, særligt når de er designet med en jobanalyse fra starten.
- Løbende overvågning af impaktratiоer og AI-værktøjer samt leverandørvalidering er afgørende for at opretholde fair ansættelsespraksis og undgå tilbagevendende uoverensstemmelser over tid.
Indholdsfortegnelse
- Hvad negativ påvirkningstestning faktisk måler
- Sådan kører du tallene: Udvælgelsesrater, impaktratiоer og signifikanstests
- Sådan læser du resultaterne uden at overreagere eller underreagere
- Sådan rettes pipeline-problemet: Jobanalyse, strukturerede interviews og bedre vurderinger
- Validering og registrering: Hvad UGESP forventer, at du opbevarer
- Sådan holder du AI- og algoritmiske screeningsværktøjer i skak
- En praktisk tjekliste til at bygge mere retfærdige vurderinger
- Hvordan negativ påvirkningstestning ser ud på tværs af brancher
- Hvor negativ påvirkningstestning kommer til kort
- Sådan integreres kontrol for negativ påvirkning i løbende governance
- Byg mere retfærdige tests hurtigere med Talent Approved
- Kilder
- FAQ
Hvad negativ påvirkningstestning faktisk måler
Negativ påvirkning er et statistisk udfald, ikke et motiv. Det opstår, når en tilsyneladende neutral udvælgelsesprocedure – en kognitiv test, et interviewskema, en CV-screening – producerer meningsfuldt forskellige beståelsesrater på tværs af race, køn, alder eller andre beskyttede grupper, uanset hvad nogen har haft til hensigt. Denne distinktion adskiller det fra ulige behandling, der kræver bevis for, at nogen bevidst er blevet udpeget. Analyse af negativ påvirkning stiller et koldere spørgsmål: landede tallene ujævnt, og i så fald, hvorfor?
Det juridiske fundament stammer fra tre steder. Title VII of the Civil Rights Act forbyder ansættelsespraksis, der uforholdsmæssigt screener en beskyttet gruppe ud, medmindre arbejdsgiveren kan begrunde praksissen. Uniform Guidelines on Employee Selection Procedures (UGESP), som føderale myndigheder vedtog i fællesskab i 1978, beskriver, hvordan arbejdsgivere bør evaluere deres udvælgelsesværktøjer, og hvornår de er forpligtet til at fremlægge en valideringsstudie for myndighederne. EEOC håndhæver Title VII og udsteder vejledende fortolkninger, mens OFCCP anvender parallelle standarder over for føderale underleverandører og ofte udfører statistisk testning under compliancegennemgange.
Validering udløses i det øjeblik, en analyse af negativ påvirkning afslører en uoverensstemmelse, der passerer tærskler for statistisk og praktisk signifikans. På det tidspunkt er EEOC's vejledning direkte: arbejdsgiveren skal vise, at proceduren er jobrelateret og i overensstemmelse med forretningsmæssig nødvendighed, eller gå over til et mindre diskriminerende alternativ.
Federal lovgivning beskytter følgende grupper i forbindelse med ansættelsesprøvning:
- Race og hudfarve
- Køn, herunder graviditet og kønsidentitet
- National oprindelse
- Religion
- Alder (40 år og derover, i henhold til ADEA)
- Handicapstatus (ADA)
Hver af disse kategorier kræver sin egen sammenligning af udvælgelsesrater. At samle dem eller kun kontrollere race og springe alder over er netop den måde, uoverensstemmelser går ubemærket hen, indtil en klage lander på dit skrivebord.
Sådan kører du tallene: Udvælgelsesrater, impaktratiоer og signifikanstests
Test for bias i din ansættelsespipeline følger en fast rækkefølge. Spring et trin over, og du enten overser et reelt problem eller jagter et fiktivt et.
- Beregn udvælgelsesraten for hver gruppe. Divider antallet af udvalgte med antallet af ansøgere i den pågældende gruppe. Hvis 80 kvinder søgte og 20 blev ansat, er udvælgelsesraten 25 %.
- Identificer den gruppe med den højeste udvælgelsesrate. Denne bliver din sammenligningsbaseline, uanset gruppestørrelse.
- Beregn impaktratioen. Divider hver gruppes udvælgelsesrate med basisgruppens rate. En ratio under 0,80 udløser firefemdels-reglen.
- Kør en signifikanstest. For stikprøver med 30 eller flere pr. gruppe bruges den tosidede binomiale Z-test. For mindre stikprøver bruges Fishers eksakte test, som ikke er afhængig af tilnærmelser til store stikprøver.
- Fortolk i forhold til dit alpha-niveau. De fleste praktikere anvender et alpha-niveau svarende til ca. 95 % konfidens, selvom nogle myndigheder anvender strengere tærskler for tosidede sammenligninger.
Statistisk bemærkning: OFCCP behandler en absolut Z-værdi ved en tærskel, der anses for statistisk signifikant svarende til ca. et 95 % konfidensniveau, der nogenlunde svarer til en 95 % konfidenstærskel. Det tal – ikke blot firefemdels-ratioen – er det, en føderal compliance-embedsmand faktisk vil beregne under en revision.
Firefemdels-reglen er et screeningsværktøj, ikke en dom. EEOC's vejledning beskriver den som en tommelfingerregel, som myndighederne anvender med skøn. En ratio på 0,79 i en pulje med seks ansøgere betyder næsten ingenting statistisk set. En ratio på 0,83 på tværs af 4.000 ansøgere kan stadig repræsentere en reel, signifikant uoverensstemmelse. Reglen markerer, hvor man skal se. Z-testen eller Fishers eksakte test fortæller, om det, du kigger på, er støj.
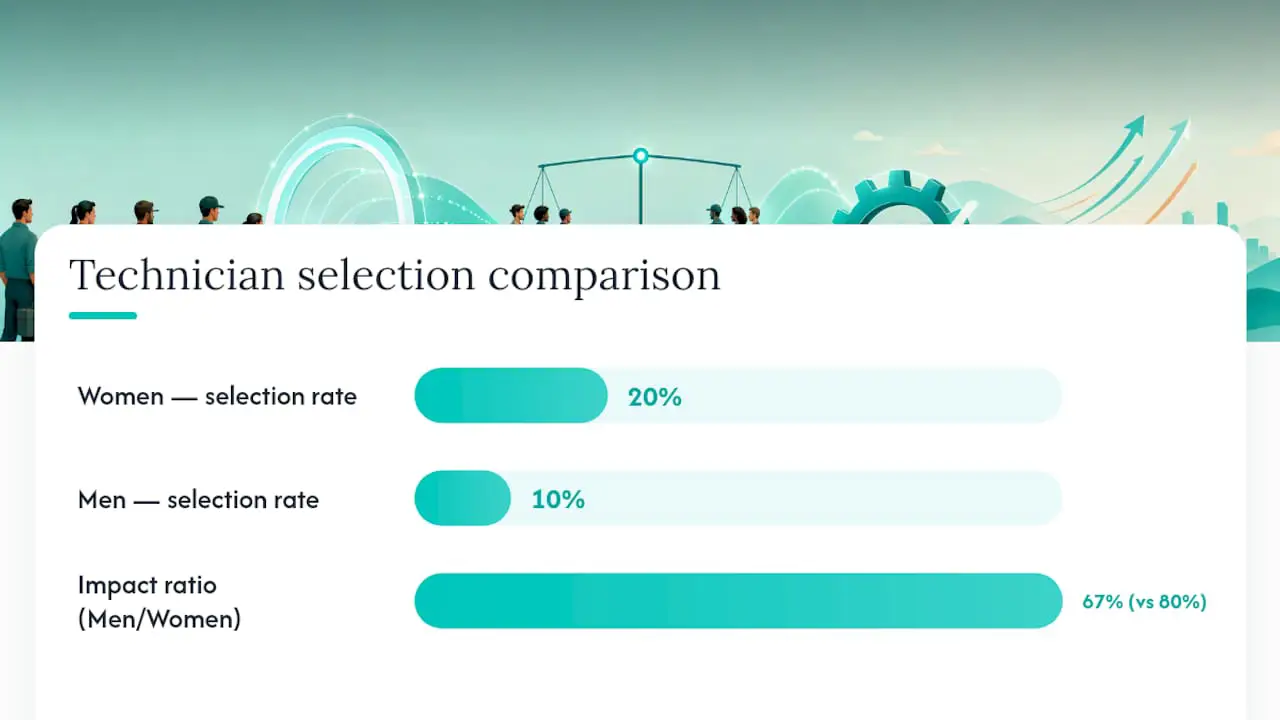
Her er en forenklet gennemgang. Antag, at 200 mænd og 150 kvinder ansøger om en teknikerstilling. Impaktratioen er 20/30, eller 0,67, langt under 0,80-tærsklen. At køre en tosamplet Z-test på disse tal (begge grupper overstiger 30) ville fortælle dig, om det 10-points-gap sandsynligvis skyldes tilfældighed eller afspejler et strukturelt problem i selve vurderingen.
Sådan læser du resultaterne uden at overreagere eller underreagere
En markeret ratio er et udgangspunkt for undersøgelse, ikke et automatisk fund af diskrimination, og en ren ratio garanterer ikke, at din proces er fair. Små ansøgerpuljer forvrider både firefemdels-ratioen og signifikanstests: en håndfuld ansættelser kan svinge en udvælgelsesrate med 10 eller 15 procentpoint, så en enkelt ansættelsescyklus fortæller sjældent den fulde historie på egen hånd.
Vær opmærksom på disse hyppige fejl:
- Test af snesevis af undergrupper uden at justere dit alpha, hvilket øger sandsynligheden for et falsk positiv resultat et sted i data rent tilfældigt.
- At ignorere konfidensintervaller og behandle en grænsetilfælde-ratio som definitivt fin eller definitivt brudt.
- At overreagere på ét dårligt kvartal i stedet for at samle flere ansættelsescyklusser for at se, om mønstret holder.
- At underreagere på en "bestået" firefemdels-ratio, der skjuler en statistisk signifikant Z-score, da de to mål besvarer forskellige spørgsmål.
Enhver signifikanstest indebærer en afvejning mellem Type I-fejl (at markere en fair proces som bias) og Type II-fejl (at overse en genuint bias proces). Et strengere alpha reducerer falske alarmer, men gør det lettere for reelle uoverensstemmelser at slippe igennem i mindre stikprøver – det er præcis derfor, regulatorer hælder til Fishers eksakte test frem for en Z-test, når gruppestørrelserne er små.
Pro-tip: Saml mindst to eller tre ansættelsescyklusser, før du beslutter, om en uoverensstemmelse er reel. Ét afvigende kvartal med 12 ansøgere kan producere en dramatisk udseende ratio, der forsvinder, når du føjer de næste 200 kandidater til datasættet.
Når et resultat passerer både firefemdels-tærsklen og en signifikanstest på tværs af flere cyklusser, er det dit signal til at gå videre med validering eller afprøve en erstatning – ikke blot at overvåge og håbe, at det retter sig selv.
Sådan rettes pipeline-problemet: Jobanalyse, strukturerede interviews og bedre vurderinger
Afhjælpning virker bedst, når den starter, inden du overhovedet slår en stilling op – ikke efter at analysen af negativ påvirkning har afsløret et problem.
- Start med en jobanalyse. Definer de faktiske opgaver og kompetencer, som rollen kræver, inden du vælger eller bygger en test. En generisk kognitiv evnetest til en dataindtastningsrolle inviterer til uoverensstemmelser, som en opgavebaseret skrive- og nøjagtighedstest ville undgå.
- Foretræk opgavebaserede, rollespecifikke vurderinger frem for brede screeninger. Strukturerede, jobrelevante tests, der afspejler faktiske jobopgaver, har tendens til at producere mindre gruppeforskelle end abstrakte egnetheds tests, samtidig med at de stadig forudsiger præstation godt.
- Brug strukturerede interviews med faste spørgsmål og evalueringsskemaer. Ustrukturerede interviews – hvor hver interviewer spørger om det, der falder dem ind – er der, hvor subjektiv bias sniger sig mest ind.
- Byg scorekort og træn bedømmere til at kalibrere i forhold til dem. To interviewere, der scorer det samme svar, bør lande inden for ét point af hinanden, ikke tre point fra hinanden.
- Afprøv alternativer, når et værktøj markerer negativ påvirkning. UGESP kræver, at arbejdsgivere evaluerer egnede alternativer og anvender det med væsentligt tilsvarende validitet og mindre påvirkning.
Pro-tip: Forkast ikke en vurdering, blot fordi den viser en uoverensstemmelse. Sammenlign dens validitet med den foreslåede erstatning først. At bytte en velvalideret test ud med en utestet kan erstatte en juridisk risiko med en risiko for dårlige ansættelser.
Strukturerede, opgavebaserede screeningsværktøjer mappet direkte til jobkompetencer overgår konsekvent generiske screeninger på både fairness og prædiktiv nøjagtighed – i høj grad fordi de måler, hvad jobbet faktisk kræver, frem for en stedfortræder herfor.
Validering og registrering: Hvad UGESP forventer, at du opbevarer
UGESP kræver en valideringsstudie, når analysen af negativ påvirkning overskrider statistiske og praktiske tærskler, og retningslinjerne anerkender tre typer beviser: indholdsvaliditet (testen afspejler jobopgaver direkte), kriteriumsrelateret validitet (scores korrelerer med faktisk jobpræstation) og konstruktvaliditet (testen måler en underliggende egenskab knyttet til succes i jobbet).
Lokal validering – en studie udført på din egen ansøgerpopulation – har størst vægt. Transporteret validitet, hvor du støtter dig til en valideringsstudie fra et tilsvarende job et andet sted, er acceptabel, når rollerne og miljøerne er genuint sammenlignelige, men regulatorer undersøger tilpasningen nøje.
Opbevar disse registre klar til revision:
- Ansøgerflowdata opdelt efter beskyttet gruppe, for hver rekvisition
- Udvælgelsesrater og beregninger af impaktratiоer for hver ansættelsescyklus
- Al dokumentation for valideringsstudier, herunder metodik og resultater
- Leverandørmaterialer, der beskriver, hvordan en købt vurdering er bygget og valideret
CFR §1607.4 beskriver registreringsforventninger direkte knyttet til håndhævelse af firefemdels-reglen. Behandl disse registre, som du ville behandle skatdokumenter: opbevaret i årevis, organiseret efter cyklus og klar til at blive udleveret med kort varsel.
Sådan holder du AI- og algoritmiske screeningsværktøjer i skak
En algoritme slipper ikke for krav, blot fordi et menneske ikke har skrevet scoringsreglerne i hånden. EEOC's tekniske vejledning er eksplicit om, at der ikke er nogen algoritmisk undtagelse. Software, CV-rangeringsværktøjer og AI-drevet screening skal opfylde den samme standard for jobrelateret validering, som en papir-og-blyant-test fra 1985.
Byg en overvågningskadence – ikke en engangscheck:
- Kør impaktratiоer og signifikanstests igen for hver ansættelsescyklus eller hvert kvartal, hvad end der kommer først
- Spor udvælgelsesrater pr. beskyttet gruppe på hvert trin, som værktøjet berører – ikke kun den endelige beslutning
- Spørg leverandører direkte om deres valideringsbevis, en beskrivelse af deres træningsdata og eventuelle fairnesstests, de har udført
- Hav en afhjælpningsplan klar: modelreguleringer, øget menneskelig gennemgang eller udskiftning med en alternativ vurdering
Pro-tip: Anmod om en leverandørs dokumentation for negativ påvirkning, inden du underskriver – ikke efter dit første markerede kvartal. Løbende tilsyn med AI-screeningsværktøjer fungerer langt bedre som en fast praksis end som en hasteforfølgning.
En praktisk tjekliste til at bygge mere retfærdige vurderinger
Fair testning starter med design, ikke skadesbekæmpelse. Kortlæg jobopgaver til testindhold, byg elementer omkring disse opgaver, afprøv med en reel ansøgerstikprøve, mål impaktratiоer, og valider eller revidér inden fuld udrulning.
- Kortlæg centrale jobopgaver, inden du skriver et eneste spørgsmål
- Byg opgavebaserede elementer, ikke generiske egnethedsspørgsmål
- Afprøv med en repræsentativ ansøgerstikprøve
- Mål impaktratiоer og signifikans inden fuld implementering
- Valider eller iterer baseret på, hvad piloten viser
Anti-snydebeskyttelse og AI-genererede scoringsopsummeringer accelererer denne cyklus betydeligt. Når alle kandidater tager den samme opgavebaserede test under de samme overvågede betingelser, og alle scores leveres med en dokumenteret begrundelse, får du renere data til beregninger af impaktratiоer og et papierspor klar til en revision.
Hvordan negativ påvirkningstestning ser ud på tværs af brancher
Mekanikken er den samme overalt, men de værktøjer, der udløser kontrol, varierer efter sektor. Inden for fremstilling og logistik har fysiske evnetests og styrketest historisk set produceret nogle af de største kønsmæssige forskelle, hvilket har fået mange arbejdsgivere til at gå over til opgavesimuleringtest, der afspejler den faktiske løftning eller bevægelse, jobbet kræver, frem for rå styrkemålinger.
Inden for tech og finans er det kognitive evnetests og kodningsvurderinger, der tiltrækker mest kontrol. En generisk logikpuslespilstest kan producere uoverensstemmelser efter race eller national oprindelse, som en rollespecifik kodningsudfordring – scoret i forhold til det faktiske programmeringssprog og opgavesæt, jobbet bruger – ofte indsnævrer betydeligt.
Ansættelse inden for detailhandel og hospitality hviler tungt på strukturerede interviews og personlighedsvurderinger, hvor ustrukturerede, fritflydende interviewformater stadig er en af de hyppigste kilder til bedømmerdreven uoverensstemmelse. Sundhedssystemer tester i stigende grad licensnære kompetencer (nøjagtighed i patientjournalering, medicindosering) frem for bred egnethed, i høj grad fordi disse opgavebaserede mål holder sig bedre under både validitets- og negativ påvirkningsgennemgang.
Ansættelse i den offentlige sektor og hos statslige underleverandører er underlagt den strammeste kontrol af alle, da OFCCP-compliancegennemgange rutinemæssigt henter ansøgerflowdata og kører Z-testen uafhængigt. Enhver arbejdsgiver med føderale kontrakter bør antage, at deres tal vil blive genberegnet af nogen uden for huset.
Hvor negativ påvirkningstestning kommer til kort
Firefemdels-reglen og signifikanstestning er nyttige værktøjer, men de har begrænsninger. Begge metoder deler en strukturel svaghed: de måler udfald på gruppeniveau, hvilket betyder, at de kan gå glip af uretfærdighed på individniveau helt – eller markere en uoverensstemmelse, der slet ikke har at gøre med testen selv, men alt med en ikke-repræsentativ ansøgerpulje.
Stikprøvestørrelse skærer begge veje. For få ansøgere i en gruppe og firefemdels-ratioen svinger vildt ved ét eller to ansættelser. Fishers eksakte test håndterer små stikprøver bedre end en Z-test-tilnærmelse, men selv det kan ikke frembringe statistisk styrke fra en pulje på otte ansøgere. I den anden ekstrem kan meget store ansøgerpuljer producere en statistisk signifikant Z-score for et gap, der er så lille, at det ikke har nogen praktisk betydning for nogens karriereudfald.
Datakvalitet er sin egen svaghed. Selvrapporterede demografiske data har huller og inkonsistenser. Flertrins-ansættelsestragte gør det let at miste overblikket over, hvilke kandidater der frivilligt faldt fra, kontra hvilke der blev screenet ud af det værktøj, du tester. Og at teste snesevis af jobkategorier eller lokationer på én gang – uden at justere for multiple sammenligninger – øger sandsynligheden for, at noget ser markeret ud rent tilfældigt.
Intet af dette gør metodologien ubrugelig. Det betyder, at testning for negativ påvirkning er ét input i en samlet vurdering – ikke en formel, der på egen hånd spytter et rent bestået eller dumper ud.
Sådan integreres kontrol for negativ påvirkning i løbende governance
Den største fejl, jeg ser, er at behandle dette som en engangsrevision frem for en fast disciplin. Kør ratiоerne én gang, ret den markerede test, gå videre – og det samme gap dukker ofte op igen to ansættelsescyklusser senere i en lidt anden forklædning. Byg det ind i kvartalsvise gennemgange, træn ansættelsesledere til at spotte advarselstegn, inden HR skal fange dem bagefter, og sæt juridisk, HR og analyse i samme rum, når et tal bevæger sig. Ansvar fordelt på tre afdelinger uden et fælles dashboard er netop den måde, uoverensstemmelser kan leve i årevis ubemærket.
— Jimmie
Byg mere retfærdige tests hurtigere med Talent Approved
Talent Approved tilbyder værktøjer til hurtigt at oprette opgavebaserede vurderinger, hvilket kan være nyttigt, når analysen af negativ påvirkning indikerer et behov for hurtigt at afprøve et alternativ. Funktionen Magic Create bygger rollespecifikke tests direkte ud fra en jobannonce eller kompetencelist – netop den slags opgavemappede vurdering, som denne guide anbefaler frem for generiske kognitive screeninger.
Indbygget overvågning og AI-genererede præstationsopsummeringer sigter mod at levere rene, dokumenterede scoringsdata, der er nyttige til valideringsstudier eller gennemgange. Det dokumentationsspor – direkte knyttet til de afhjælpningstrin, der er beskrevet ovenfor – er ofte forskellen mellem et hurtigt compliance-svar og en jagt gennem gamle regneark. Hvis dit nuværende screeningsværktøj nogensinde har gjort dig nervøs for dets udvælgelsesrater på tværs af grupper, kan du begynde at bygge en rollespecifik vurdering på Talent Approved og se, hvor hurtigt en mere retfærdig test tager form.
Kilder
- Ansættelsesprøver og udvælgelsesprocedurer | EEOC
- CFR §1607.4 — Diskrimination defineret: Forholdet mellem brug af udvælgelsesprocedurer og diskrimination
FAQ
Hvad er forskellen mellem negativ påvirkning og ulige behandling?
Negativ påvirkning er en statistisk uoverensstemmelse i udfald på tværs af beskyttede grupper som følge af en neutral procedure, mens ulige behandling kræver bevis for forsætlig diskrimination mod en specifik person eller gruppe.
Hvad er firefemdels-reglen i ansættelsesprøvning?
Den markerer et muligt problem, når en beskyttet gruppes udvælgelsesrate falder under 80 % af den gruppe med den højeste udvælgelsesrates rate, selvom EEOC's vejledning behandler den som et screeningsværktøj, ikke som et juridisk absolut.
Hvornår skal jeg bruge en Z-test kontra Fishers eksakte test?
Brug den tosidet binomiale Z-test, når hver gruppe har 30 eller flere ansøgere; brug Fishers eksakte test til mindre stikprøver, hvor tilnærmelser til store stikprøver bliver upålidelige.
Har AI-ansættelsesværktøjer også brug for testning for negativ påvirkning?
Ja. EEOC har præciseret, at der ikke er nogen undtagelse for algoritmiske værktøjer fra analysen af negativ påvirkning, så software og AI-drevne screeningsværktøjer skal testes og valideres på samme måde som traditionelle vurderinger.
Hvad sker der, hvis min vurdering viser negativ påvirkning?
Du skal vise, at proceduren er jobrelateret og i overensstemmelse med forretningsmæssig nødvendighed, eller anvende et mindre diskriminerende alternativ med sammenlignelig validitet – og platforme som Talent Approved kan hjælpe dig med hurtigt at afprøve og dokumentere det alternativ.