
Manual de RH dos EUA para Teste de Impacto Adverso: Execute, Interprete, Corrija
Se o seu processo de seleção está produzindo uma taxa de aprovação notavelmente menor para algum grupo protegido em comparação com o grupo de maior pontuação, você tem um sinal que merece investigação. Execute o índice de impacto e um teste de significância (usando métodos apropriados para amostras maiores ou menores) antes de tomar outra decisão de contratação com esse procedimento. Se algum deles indicar um problema, valide a avaliação de acordo com as UGESP ou substitua-a por uma alternativa menos discriminatória que preveja o desempenho no trabalho de forma comparável.
Resumo:
- O impacto adverso pode ocorrer mesmo com procedimentos de seleção neutros, como testes ou entrevistas, produzindo disparidades estatisticamente significativas sem intenção deliberada.
- A validação de avaliações envolve o cálculo das taxas de seleção, índices de impacto abaixo de 0,80 e a realização de testes de significância com tamanhos de amostra apropriados, agrupando múltiplos ciclos de contratação para maior precisão.
- As organizações devem manter registros detalhados dos dados dos candidatos, dos esforços de validação e das análises de impacto para cumprir as UGESP e se preparar para auditorias, especialmente no caso de contratantes federais.
- Avaliações específicas por função e orientadas para tarefas reduzem as disparidades de forma mais eficaz do que triagens genéricas, especialmente quando desenvolvidas com base em análise de cargo desde o início.
- O monitoramento contínuo dos índices de impacto e das ferramentas de IA, juntamente com a validação dos fornecedores, é essencial para manter práticas de contratação justas e evitar disparidades recorrentes ao longo do tempo.
Índice
- O Que o Teste de Impacto Adverso Realmente Mede
- Como Calcular os Números: Taxas de Seleção, Índices de Impacto e Testes de Significância
- Como Interpretar os Resultados Sem Exagerar ou Minimizar
- Corrigindo o Pipeline: Análise de Cargo, Entrevistas Estruturadas e Melhores Avaliações
- Validação e Manutenção de Registros: O Que as UGESP Esperam Que Você Guarde
- Mantendo as Ferramentas de Triagem por IA e Algoritmos sob Controle
- Uma Lista de Verificação Prática para Desenvolver Avaliações Mais Justas
- Como o Teste de Impacto Adverso Se Manifesta em Diferentes Setores
- Onde o Teste de Impacto Adverso Apresenta Limitações
- Incorporando Verificações de Impacto Adverso à Governança Contínua
- Desenvolva Testes Mais Justos com Mais Rapidez com o Talent Approved
- Fontes
- Perguntas Frequentes
O Que o Teste de Impacto Adverso Realmente Mede
O impacto adverso é um resultado estatístico, não uma motivação. Ele se manifesta quando um procedimento de seleção de aparência neutra — um teste cognitivo, um roteiro de entrevista, uma triagem de currículo — produz taxas de aprovação significativamente diferentes entre grupos raciais, de sexo, de idade ou outros grupos protegidos, independentemente da intenção de quem o aplica. Essa distinção o separa do tratamento desigual, que exige prova de que alguém foi deliberadamente prejudicado. A análise de impacto adverso faz uma pergunta mais fria: os números ficaram distribuídos de forma desigual e, em caso afirmativo, por quê?
A estrutura legal provém de três fontes. O Título VII da Lei dos Direitos Civis proíbe práticas de emprego que excluam desproporcionalmente um grupo protegido, salvo se o empregador puder justificar a prática. As Diretrizes Uniformes sobre Procedimentos de Seleção de Empregados (UGESP), adotadas conjuntamente por agências federais em 1978, especificam como os empregadores devem avaliar suas ferramentas de seleção e quando devem ao governo um estudo de validação. A EEOC aplica o Título VII e emite orientações interpretativas, enquanto o OFCCP aplica padrões paralelos a contratantes federais e frequentemente realiza os testes estatísticos durante auditorias de conformidade.
A validação é acionada no momento em que a análise de impacto adverso aponta uma disparidade que supera os limites de significância estatística e prática. Nesse ponto, a orientação da EEOC é direta: o empregador deve demonstrar que o procedimento está relacionado ao cargo e é compatível com a necessidade empresarial, ou adotar uma alternativa menos discriminatória.
A legislação federal protege os seguintes grupos no contexto de testes de emprego:
- Raça e cor
- Sexo, incluindo gravidez e identidade de gênero
- Origem nacional
- Religião
- Idade (40 anos ou mais, conforme a ADEA)
- Condição de deficiência (ADA)
Cada uma dessas categorias requer sua própria comparação de taxas de seleção. Agrupá-las ou verificar apenas a raça e ignorar a idade é a forma como as disparidades passam despercebidas até que uma denúncia chegue à sua mesa.
Como Calcular os Números: Taxas de Seleção, Índices de Impacto e Testes de Significância
O teste de viés no seu pipeline de contratação segue uma sequência fixa. Pular uma etapa faz com que você perca um problema real ou persiga um problema inexistente.
- Calcule a taxa de seleção para cada grupo. Divida o número de selecionados pelo número de candidatos naquele grupo. Se 80 mulheres se candidataram e 20 foram contratadas, a taxa de seleção é de 25%.
- Identifique o grupo com a maior taxa de seleção. Este se torna a sua linha de base de comparação, independentemente do tamanho do grupo.
- Calcule o índice de impacto. Divida a taxa de seleção de cada grupo pela taxa do grupo de referência. Um índice abaixo de 0,80 aciona a regra dos quatro quintos.
- Execute um teste de significância. Para amostras de 30 ou mais por grupo, use o teste Z binomial de duas amostras. Para amostras menores, use o teste exato de Fisher, que não depende de aproximações para grandes amostras.
- Interprete conforme o seu nível alfa. A maioria dos profissionais usa um nível alfa correspondente a aproximadamente 95% de confiança, embora algumas agências apliquem limites mais rigorosos para comparações bicaudais.
Destaque Estatístico: O OFCCP considera estatisticamente significativo um valor Z absoluto em um limiar que corresponde aproximadamente a um nível de confiança de 95%. Esse número, e não apenas o índice dos quatro quintos, é o que um fiscal de conformidade federal realmente calculará durante uma auditoria.
A regra dos quatro quintos é um instrumento de triagem, não um veredicto. A orientação da EEOC a descreve como uma regra geral que as agências aplicam com discrição. Um índice de 0,79 em um conjunto de seis candidatos não tem quase nenhum significado estatístico. Um índice de 0,83 em 4.000 candidatos pode ainda representar uma disparidade real e significativa. A regra indica onde olhar. O teste Z ou o teste exato de Fisher informa se o que você está observando é ruído ou não.
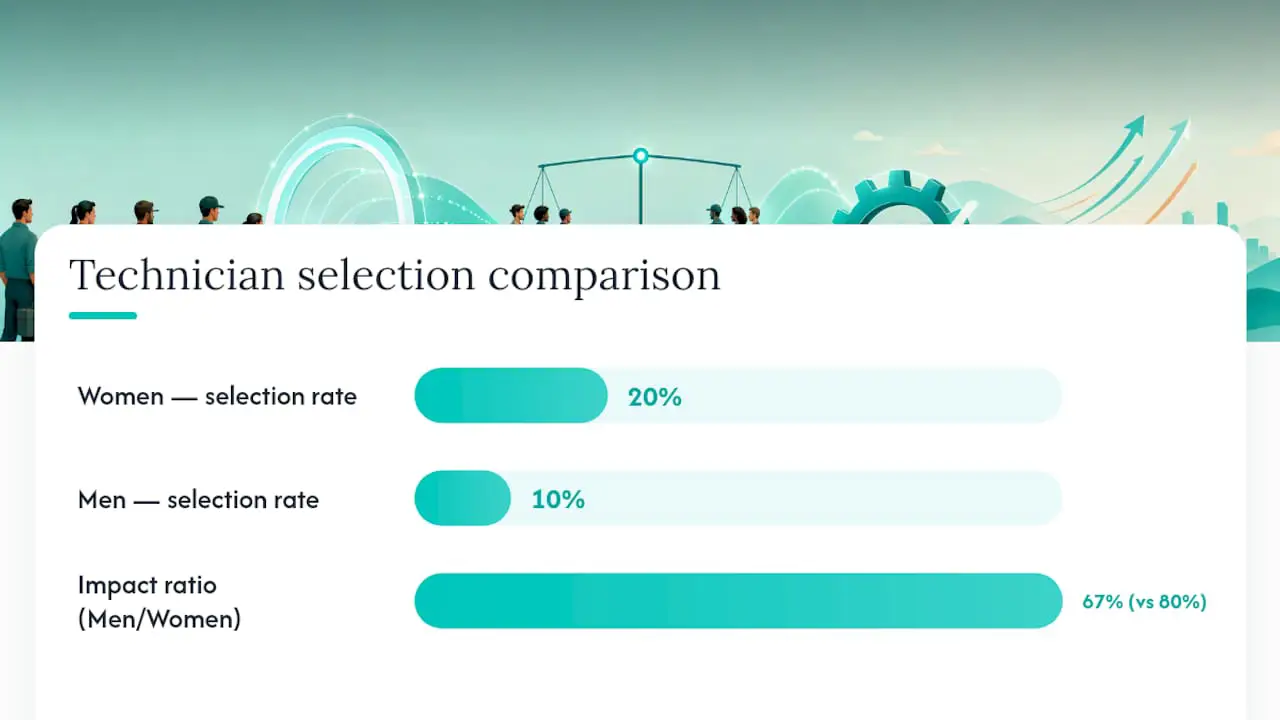
Veja um exemplo simplificado. Suponha que 200 homens e 150 mulheres se candidatem a uma função de técnico. O índice de impacto é 20/30, ou 0,67, bem abaixo do limiar de 0,80. Executar um teste Z de duas amostras com esses números (ambos os grupos superam 30) indicaria se essa diferença de 10 pontos provavelmente se deve ao acaso ou reflete um problema estrutural na própria avaliação.
Como Interpretar os Resultados Sem Exagerar ou Minimizar
Um índice sinalizado é um ponto de partida para investigação, não uma constatação automática de discriminação, e um índice sem problemas não garante que seu processo seja justo. Conjuntos pequenos de candidatos distorcem tanto o índice dos quatro quintos quanto os testes de significância: algumas contratações podem alterar uma taxa de seleção em 10 ou 15 pontos, de modo que um único ciclo de contratação raramente conta a história completa por si só.
Fique atento a estes erros comuns:
- Testar dezenas de subgrupos sem ajustar o seu alfa, o que aumenta as chances de um falso positivo em algum ponto dos dados puramente por acaso.
- Ignorar os intervalos de confiança e tratar um índice limítrofe como definitivamente correto ou definitivamente problemático.
- Reagir excessivamente a um mau trimestre em vez de agrupar vários ciclos de contratação para verificar se o padrão se mantém.
- Reagir de forma insuficiente a um índice dos quatro quintos "aprovado" que oculta um valor Z estatisticamente significativo, já que as duas medidas respondem a perguntas diferentes.
Todo teste de significância envolve uma troca entre o Erro Tipo I (sinalizar um processo justo como tendencioso) e o Erro Tipo II (deixar passar um genuinamente tendencioso). Um alfa mais rigoroso reduz os falsos alarmes, mas torna mais fácil que disparidades reais passem despercebidas em amostras menores, que é exatamente por isso que os reguladores preferem o teste exato de Fisher ao teste Z quando os tamanhos dos grupos são pequenos.
Dica Profissional: Agrupe pelo menos dois ou três ciclos de contratação antes de decidir se uma disparidade é real. Um trimestre atípico com 12 candidatos pode produzir um índice de aparência dramática que desaparece quando você adiciona os próximos 200 candidatos ao conjunto de dados.
Quando um resultado supera tanto o limiar dos quatro quintos quanto um teste de significância ao longo de múltiplos ciclos, este é o momento de avançar para a validação ou testar uma substituição — não apenas monitorar e esperar que se corrija sozinho.
Corrigindo o Pipeline: Análise de Cargo, Entrevistas Estruturadas e Melhores Avaliações
A mitigação funciona melhor quando começa antes mesmo de publicar uma vaga, e não depois que a análise de impacto adverso detecta um problema.
- Comece com uma análise de cargo. Defina as tarefas e competências reais que a função exige antes de selecionar ou desenvolver qualquer teste. Uma triagem genérica de capacidade cognitiva para uma função de digitação convida a disparidades que um teste de digitação e precisão baseado em tarefas evitaria.
- Prefira avaliações baseadas em tarefas e específicas por função a triagens genéricas. Testes estruturados e relevantes para o cargo que espelham as atividades reais da função tendem a produzir menores diferenças entre grupos do que testes de aptidão abstrata, ao mesmo tempo em que preveem bem o desempenho.
- Use entrevistas estruturadas com perguntas fixas e rubricas de pontuação. As entrevistas não estruturadas, em que cada entrevistador pergunta o que lhe vem à mente, são onde o viés subjetivo se infiltra com mais intensidade.
- Crie cartões de pontuação e treine os avaliadores para calibrá-los. Dois entrevistadores que pontuam a mesma resposta devem chegar a resultados dentro de um ponto de diferença, não três pontos.
- Teste alternativas quando uma ferramenta sinalizar impacto adverso. As UGESP exigem que os empregadores avaliem alternativas adequadas e adotem aquela com validade substancialmente igual e menor impacto.
Dica Profissional: Não descarte uma avaliação apenas por apresentar uma disparidade. Compare primeiro a sua validade com a da substituta proposta. Trocar um teste bem validado por um sem histórico pode substituir um risco legal por um risco de má contratação.
Ferramentas de triagem estruturadas e baseadas em tarefas mapeadas diretamente para as competências do cargo superam consistentemente as triagens genéricas tanto em equidade quanto em precisão preditiva, em grande parte porque medem o que o cargo realmente exige, e não um indicador substituto.
Validação e Manutenção de Registros: O Que as UGESP Esperam Que Você Guarde
As UGESP exigem um estudo de validação assim que a análise de impacto adverso ultrapassa os limiares estatísticos e práticos, e as diretrizes reconhecem três tipos de evidência: validade de conteúdo (o teste reflete diretamente as tarefas do cargo), validade de critério (as pontuações se correlacionam com o desempenho real no trabalho) e validade de constructo (o teste mede um traço subjacente relacionado ao sucesso no cargo).
A validação local — um estudo realizado com a sua própria população de candidatos — tem o maior peso. A validade transportada, em que você recorre a um estudo de validação de uma função semelhante em outro contexto, é aceitável quando as funções e os ambientes são genuinamente comparáveis, mas os reguladores analisam de perto essa adequação.
Mantenha estes registros em arquivo e prontos para auditoria:
- Dados de fluxo de candidatos discriminados por grupo protegido, para cada requisição
- Taxas de seleção e cálculos do índice de impacto para cada ciclo de contratação
- Toda documentação de estudos de validação, incluindo metodologia e resultados
- Materiais do fornecedor descrevendo como uma avaliação adquirida foi desenvolvida e validada
O CFR §1607.4 descreve as expectativas de manutenção de registros diretamente vinculadas à aplicação da regra dos quatro quintos. Trate esses registros da mesma forma que trataria documentos fiscais: mantidos por anos, organizados por ciclo e prontos para serem entregues em curto prazo.
Mantendo as Ferramentas de Triagem por IA e Algoritmos sob Controle
Um algoritmo não recebe uma isenção apenas porque um humano não escreveu as regras de pontuação manualmente. A orientação técnica da EEOC é explícita: não existe isenção algorítmica. Softwares, ferramentas de classificação de currículos e triagem impulsionada por IA devem atender ao mesmo padrão de relação com o cargo e validação que um teste em papel de 1985.
Estabeleça uma cadência de monitoramento, não uma verificação única:
- Recalcule os índices de impacto e os testes de significância a cada ciclo de contratação ou trimestre, o que ocorrer primeiro
- Acompanhe as taxas de seleção por grupo protegido em cada etapa que a ferramenta influencia, não apenas na decisão final
- Solicite diretamente aos fornecedores as evidências de validação, uma descrição dos dados de treinamento e quaisquer testes de equidade realizados
- Tenha um plano de remediação pronto: ajustes no modelo, revisão humana adicional ou substituição por uma avaliação alternativa
Dica Profissional: Solicite a documentação de impacto adverso do fornecedor antes de assinar, não após o seu primeiro trimestre sinalizado. A supervisão contínua das ferramentas de triagem por IA funciona muito melhor como uma prática permanente do que como uma corrida contra o tempo.
Uma Lista de Verificação Prática para Desenvolver Avaliações Mais Justas
Uma avaliação justa começa pelo design, não pelo controle de danos. Mapeie as tarefas do cargo para o conteúdo do teste, desenvolva itens com base nessas tarefas, aplique um piloto com uma amostra real de candidatos, meça os índices de impacto e, então, valide ou revise antes da implementação completa.
- Mapeie as tarefas centrais do cargo antes de escrever uma única pergunta
- Desenvolva itens baseados em tarefas, não perguntas genéricas de aptidão
- Aplique um piloto com uma amostra representativa de candidatos
- Meça os índices de impacto e a significância antes da implantação completa
- Valide ou repita o processo com base nos resultados do piloto
Salvaguardas antitrapaça e resumos de pontuação gerados por IA aceleram consideravelmente esse ciclo. Quando todos os candidatos fazem o mesmo teste baseado em tarefas nas mesmas condições monitoradas, e cada pontuação vem acompanhada de uma justificativa documentada, você obtém dados mais limpos para os cálculos do índice de impacto e um rastro de evidências pronto para uma auditoria.
Como o Teste de Impacto Adverso Se Manifesta em Diferentes Setores
A mecânica é a mesma em todos os lugares, mas as ferramentas que geram escrutínio variam por setor. Na manufatura e na logística, testes de capacidade física e de força historicamente produziram algumas das maiores disparidades por sexo, levando muitos empregadores a migrar para testes de simulação de tarefas que espelham o levantamento ou o movimento real exigido, em vez de benchmarks brutos de força.
Na tecnologia e nas finanças, testes de capacidade cognitiva e avaliações de programação atraem o maior escrutínio. Um teste genérico de lógica pode produzir disparidades por raça ou origem nacional que um desafio de programação específico para a função — pontuado com base na linguagem e no conjunto de tarefas reais que o cargo utiliza — frequentemente reduz consideravelmente.
A contratação no varejo e na hospitalidade depende muito de entrevistas estruturadas e avaliações de personalidade, onde os formatos de entrevista não estruturados e livres permanecem uma das fontes mais comuns de disparidade causada pelo avaliador. Os sistemas de saúde testam cada vez mais competências adjacentes a licenciamentos (precisão no registro de pacientes, cálculo de medicamentos) em vez de aptidão geral, em grande parte porque essas medidas baseadas em tarefas se sustentam melhor tanto na revisão de validade quanto na de impacto adverso.
A contratação no setor público e por contratantes governamentais está sob o escrutínio mais rigoroso de todos, pois as revisões de conformidade do OFCCP rotineiramente obtêm dados de fluxo de candidatos e recalculam o teste Z de forma independente. Qualquer empregador com contratos federais deve assumir que seus números serão recalculados por alguém de fora da organização.
Onde o Teste de Impacto Adverso Apresenta Limitações
A regra dos quatro quintos e os testes de significância são ferramentas úteis, mas têm limitações. Ambos os métodos compartilham uma fraqueza estrutural: medem resultados no nível do grupo, o que significa que podem deixar passar completamente injustiças no nível individual — ou sinalizar uma disparidade que não tem nada a ver com o próprio teste e tudo a ver com um conjunto de candidatos não representativo.
O tamanho da amostra age nos dois sentidos. Poucos candidatos em um grupo e o índice dos quatro quintos oscila fortemente com uma ou duas contratações. O teste exato de Fisher lida melhor com amostras pequenas do que uma aproximação do teste Z, mas mesmo assim não consegue criar poder estatístico a partir de um conjunto de oito candidatos. No outro extremo, conjuntos de candidatos muito grandes podem produzir um valor Z estatisticamente significativo para uma diferença tão pequena que não tem significado prático para a trajetória profissional de ninguém.
A qualidade dos dados é um ponto fraco em si. Dados demográficos autodeclarados apresentam lacunas e inconsistências. Funis de contratação em múltiplas etapas facilitam a perda de controle sobre quais candidatos desistiram voluntariamente versus quais foram eliminados pela ferramenta que você está testando. E testar dezenas de categorias de cargos ou locais simultaneamente, sem ajustar para comparações múltiplas, aumenta as chances de que algo pareça sinalizado puramente por acaso.
Nada disso torna a metodologia inútil. Significa que o teste de impacto adverso é um elemento de entrada em um julgamento, não uma fórmula que produz por si só um resultado limpo de aprovação ou reprovação.
Incorporando Verificações de Impacto Adverso à Governança Contínua
O maior erro que vejo é tratar isso como uma auditoria única em vez de uma disciplina permanente. Calcular os índices uma vez, corrigir o teste sinalizado, seguir em frente — e a mesma disparidade frequentemente ressurge dois ciclos de contratação depois, sob uma forma ligeiramente diferente. Incorpore isso às revisões trimestrais, treine os gestores de contratação para identificar sinais de alerta antes que o RH precise detectá-los após o fato, e coloque jurídico, RH e análise de dados na mesma sala quando um número se move. A responsabilidade dividida entre três departamentos sem um painel compartilhado é como as disparidades persistem por anos sem serem notadas.
— Jimmie
Desenvolva Testes Mais Justos com Mais Rapidez com o Talent Approved
O Talent Approved oferece ferramentas para ajudar a criar avaliações baseadas em tarefas rapidamente, o que pode ser útil quando a análise de impacto adverso indica a necessidade de testar prontamente uma alternativa. O recurso Magic Create constrói testes específicos por função diretamente a partir de uma descrição de cargo ou lista de competências — o tipo de avaliação mapeada para tarefas que este guia recomenda em vez de triagens cognitivas genéricas.
O monitoramento integrado e os resumos de desempenho gerados por IA têm como objetivo fornecer dados de pontuação limpos e documentados, úteis para estudos de validação ou revisões. Esse rastro de documentação, diretamente vinculado às etapas de mitigação abordadas acima, frequentemente representa a diferença entre uma resposta rápida de conformidade e uma corrida desesperada por planilhas antigas. Se a sua ferramenta de triagem atual já fez você se preocupar com suas taxas de seleção entre grupos, comece a desenvolver uma avaliação específica por função no Talent Approved e veja com que rapidez um teste mais justo pode ser criado.
Fontes
- Testes de emprego e procedimentos de seleção | EEOC
- CFR §1607.4 — Discriminação definida: Relação entre o uso de procedimentos de seleção e discriminação
Perguntas Frequentes
Qual É a Diferença Entre Impacto Adverso e Tratamento Desigual?
O impacto adverso é uma disparidade estatística nos resultados entre grupos protegidos decorrente de um procedimento neutro, enquanto o tratamento desigual exige prova de discriminação intencional contra uma pessoa ou grupo específico.
O Que É a Regra dos Quatro Quintos nos Testes de Emprego?
Ela sinaliza um possível problema quando a taxa de seleção de um grupo protegido cai abaixo de 80% da taxa do grupo com maior taxa de seleção, embora a orientação da EEOC a trate como uma ferramenta de triagem, não como um absoluto legal.
Quando Devo Usar o Teste Z em Vez do Teste Exato de Fisher?
Use o teste Z binomial de duas amostras quando cada grupo tiver 30 ou mais candidatos; use o teste exato de Fisher para amostras menores, onde as aproximações para grandes amostras se tornam não confiáveis.
As Ferramentas de Contratação por IA Também Precisam de Testes de Impacto Adverso?
Sim. A EEOC esclareceu que não há isenção para ferramentas algorítmicas em relação à análise de impacto adverso, de modo que softwares e ferramentas de triagem por IA devem ser testados e validados da mesma forma que as avaliações tradicionais.
O Que Acontece Se Minha Avaliação Apresentar Impacto Adverso?
Você deve demonstrar que o procedimento está relacionado ao cargo e é compatível com a necessidade empresarial, ou adotar uma alternativa menos discriminatória com validade comparável, e plataformas como o Talent Approved podem ajudá-lo a testar e documentar essa alternativa rapidamente.
Recomendado
- Diretrizes de Testes da EEOC: O Que os Empregadores Precisam Saber
- Gerenciar Avaliações de Contratação em Alto Volume: Um Manual para 2026
- Formatos de Avaliação Técnica para RH: Um Guia para 2026
- Acabe com a Contratação Tendenciosa: Lista de Verificação de Estratégia de Localização de Avaliações para RH