
Manual de RRHH para pruebas de impacto adverso: ejecutar, interpretar y corregir
Si su proceso de contratación produce una tasa de selección notablemente inferior para algún grupo protegido en comparación con el grupo de mayor puntuación, tiene una señal que vale la pena investigar. Calcule el índice de impacto y realice una prueba de significancia (usando métodos apropiados para muestras más grandes o más pequeñas) antes de tomar otra decisión de contratación con ese procedimiento. Si alguna de ellas señala un problema, valide la evaluación según las UGESP o adopte una alternativa menos discriminatoria que prediga el desempeño laboral de manera comparable.
TL;DR:
- El impacto adverso puede ocurrir incluso con procedimientos de selección neutrales, como pruebas o entrevistas, produciendo disparidades estadísticamente significativas sin intención deliberada.
- La validación de evaluaciones implica calcular tasas de selección, índices de impacto inferiores a 0.80 y realizar pruebas de significancia con tamaños de muestra apropiados, agrupando múltiples ciclos de contratación para mayor precisión.
- Las organizaciones deben mantener registros detallados de los datos de candidatos, los esfuerzos de validación y los análisis de impacto para cumplir con las UGESP y prepararse para auditorías, especialmente en el caso de los contratistas federales.
- Las evaluaciones específicas de tareas y basadas en el rol reducen las disparidades mejor que los filtros genéricos, especialmente cuando se diseñan con un análisis de puesto previo.
- El monitoreo continuo de los índices de impacto y las herramientas de inteligencia artificial, junto con la validación de proveedores, es esencial para mantener prácticas de contratación justas y evitar disparidades recurrentes a lo largo del tiempo.
Tabla de contenidos
- Qué mide realmente la prueba de impacto adverso
- Cómo calcular los números: tasas de selección, índices de impacto y pruebas de significancia
- Cómo interpretar los resultados sin reaccionar de más ni de menos
- Cómo mejorar el proceso: análisis del puesto, entrevistas estructuradas y mejores evaluaciones
- Validación y conservación de registros: qué esperan las UGESP que conserve
- Cómo mantener bajo control las herramientas de selección basadas en IA y algoritmos
- Una lista de verificación práctica para crear evaluaciones más justas
- Cómo se aplica la prueba de impacto adverso en diferentes industrias
- Dónde falla la prueba de impacto adverso
- Cómo integrar las verificaciones de impacto adverso en la gobernanza continua
- Cree pruebas más justas más rápido con Talent Approved
- Fuentes
- Preguntas frecuentes
Qué mide realmente la prueba de impacto adverso
El impacto adverso es un resultado estadístico, no una motivación. Se manifiesta cuando un procedimiento de selección de apariencia neutral —una prueba cognitiva, una rúbrica de entrevista, un filtro de currículum— produce tasas de aprobación significativamente diferentes entre grupos según raza, sexo, edad u otros grupos protegidos, independientemente de la intención de quienes lo aplican. Esta distinción lo separa del trato dispar, que requiere pruebas de que alguien fue señalado intencionalmente. El análisis de impacto adverso plantea una pregunta más fría: ¿los números resultaron desiguales y, de ser así, por qué?
El marco legal proviene de tres fuentes. El Título VII de la Ley de Derechos Civiles prohíbe las prácticas de empleo que excluyan de manera desproporcionada a un grupo protegido, a menos que el empleador pueda justificar dicha práctica. Las Directrices Uniformes sobre Procedimientos de Selección de Empleados (UGESP), adoptadas conjuntamente por agencias federales en 1978, especifican cómo los empleadores deben evaluar sus herramientas de selección y cuándo le deben al gobierno un estudio de validación. La EEOC hace cumplir el Título VII y emite orientación interpretativa, mientras que la OFCCP aplica estándares paralelos a los contratistas federales y, con frecuencia, realiza las pruebas estadísticas durante las auditorías de cumplimiento.
La validación se activa en el momento en que el análisis de impacto adverso detecta una disparidad que supera los umbrales de significancia estadística y práctica. En ese punto, la orientación de la EEOC es directa: el empleador debe demostrar que el procedimiento está relacionado con el puesto y es coherente con la necesidad empresarial, o bien adoptar una alternativa menos discriminatoria.
La ley federal protege a estos grupos en el contexto de las pruebas de empleo:
- Raza y color
- Sexo, incluidos el embarazo y la identidad de género
- Origen nacional
- Religión
- Edad (40 años o más, según la ADEA)
- Condición de discapacidad (ADA)
Cada una de estas categorías requiere su propia comparación de tasas de selección. Agruparlas entre sí, o verificar solo la raza y omitir la edad, es la forma en que las disparidades pasan desapercibidas hasta que un cargo llega a su escritorio.
Cómo calcular los números: tasas de selección, índices de impacto y pruebas de significancia
La detección de sesgos en su proceso de contratación sigue una secuencia fija. Omitir un paso significa pasar por alto un problema real o perseguir uno ficticio.
- Calcule la tasa de selección de cada grupo. Divida el número de seleccionados entre el número de candidatos de ese grupo. Si se postularon 80 mujeres y se contrató a 20, la tasa de selección es del 25%.
- Identifique el grupo con la tasa de selección más alta. Este se convierte en su línea de base de comparación, independientemente del tamaño del grupo.
- Calcule el índice de impacto. Divida la tasa de selección de cada grupo entre la tasa del grupo de referencia. Un índice inferior a 0.80 activa la regla de las cuatro quintas partes.
- Realice una prueba de significancia. Para muestras de 30 o más individuos por grupo, use la prueba Z binomial de dos muestras. Para muestras más pequeñas, use la prueba exacta de Fisher, que no depende de aproximaciones de muestras grandes.
- Interprete según su nivel alfa. La mayoría de los profesionales utilizan un nivel alfa que representa aproximadamente un 95% de confianza, aunque algunas agencias aplican umbrales más estrictos para comparaciones de dos colas.
Dato estadístico destacado: La OFCCP considera estadísticamente significativo un valor absoluto de Z aproximado a un umbral que corresponde aproximadamente a un nivel de confianza del 95%. Ese número, y no solo el índice de las cuatro quintas partes, es lo que un inspector de cumplimiento federal calculará realmente durante una auditoría.
La regla de las cuatro quintas partes es un mecanismo de detección, no un veredicto. La orientación de la EEOC la describe como una regla general que las agencias aplican con discreción. Un índice de 0.79 en un grupo de seis candidatos no significa prácticamente nada estadísticamente. Un índice de 0.83 con 4,000 candidatos podría seguir representando una disparidad real y significativa. La regla señala dónde hay que mirar. La prueba Z o la prueba exacta de Fisher indica si lo que se observa es ruido estadístico.
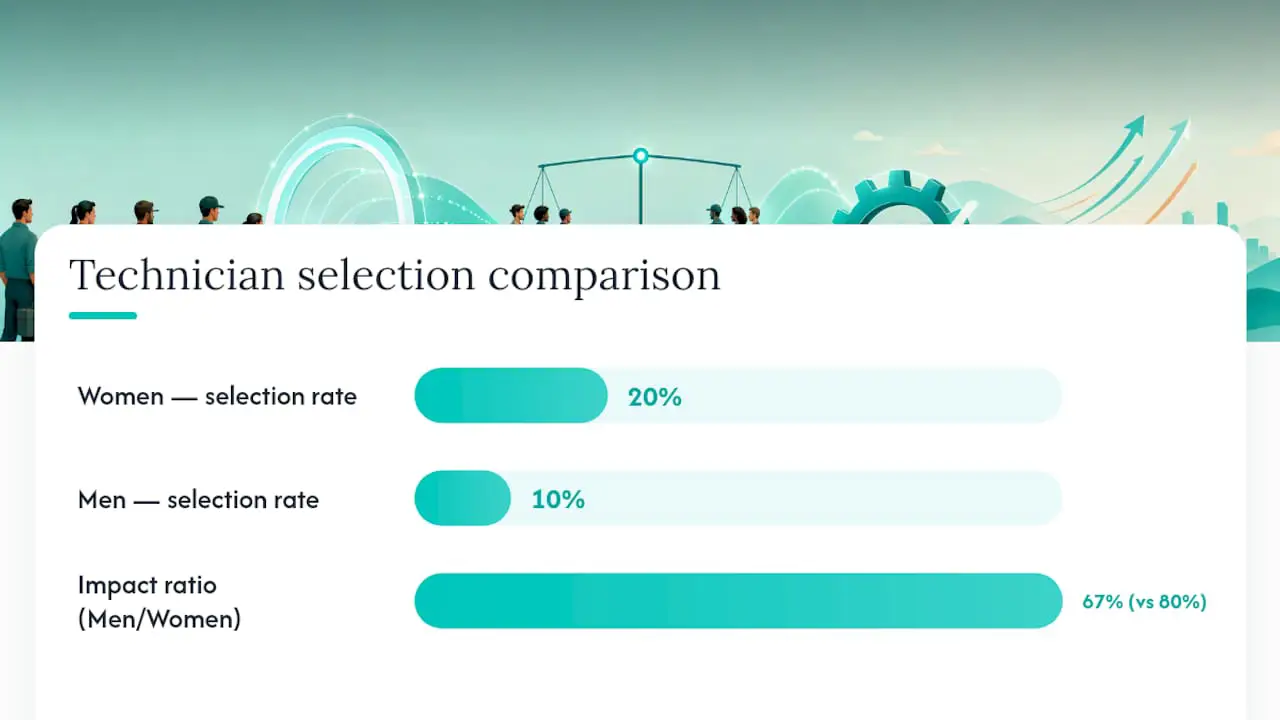
A continuación se presenta un ejemplo simplificado. Suponga que 200 hombres y 150 mujeres se postulan para un puesto de técnico. El índice de impacto es 20/30, o 0.67, muy por debajo del umbral de 0.80. Aplicar una prueba Z de dos muestras a esos números (ambos grupos superan los 30) le diría si esa brecha de 10 puntos se debe probablemente al azar o refleja un problema estructural en la propia evaluación.
Cómo interpretar los resultados sin reaccionar de más ni de menos
Un índice marcado es un punto de partida para la investigación, no una conclusión automática de discriminación, y un índice limpio no garantiza que su proceso sea justo. Los grupos de candidatos pequeños distorsionan tanto el índice de las cuatro quintas partes como las pruebas de significancia: unas pocas contrataciones pueden hacer oscilar una tasa de selección entre 10 y 15 puntos, por lo que un solo ciclo de contratación rara vez cuenta la historia completa por sí solo.
Esté atento a estos errores comunes:
- Evaluar docenas de subgrupos sin ajustar el nivel alfa, lo que infla las probabilidades de un falso positivo en algún punto de los datos puramente por azar.
- Ignorar los intervalos de confianza y tratar un índice límite como definitivamente correcto o definitivamente defectuoso.
- Reaccionar de más ante un mal trimestre en lugar de agrupar varios ciclos de contratación para ver si el patrón se mantiene.
- Reaccionar de menos ante un índice de cuatro quintas partes "aprobado" que oculta una puntuación Z estadísticamente significativa, ya que ambas medidas responden preguntas diferentes.
Toda prueba de significancia implica una compensación entre el error de Tipo I (marcar como sesgado un proceso justo) y el error de Tipo II (pasar por alto uno genuinamente sesgado). Un nivel alfa más estricto reduce las falsas alarmas, pero facilita que las disparidades reales pasen desapercibidas en muestras más pequeñas, que es exactamente por qué los reguladores recurren a la prueba exacta de Fisher en lugar de una prueba Z cuando los tamaños de los grupos son reducidos.
Consejo práctico: Agrupe al menos dos o tres ciclos de contratación antes de decidir si una disparidad es real. Un trimestre atípico con 12 candidatos puede producir un índice que llame mucho la atención, pero que desaparece una vez que se agregan los siguientes 200 candidatos al conjunto de datos.
Cuando un resultado supera tanto el umbral de las cuatro quintas partes como una prueba de significancia a lo largo de múltiples ciclos, esa es su señal para avanzar hacia la validación o probar un reemplazo, no solo monitorear y esperar que se corrija solo.
Cómo mejorar el proceso: análisis del puesto, entrevistas estructuradas y mejores evaluaciones
La mitigación funciona mejor cuando comienza antes de publicar una vacante, no después de que el análisis de impacto adverso detecte un problema.
- Comience con un análisis del puesto. Defina las tareas y competencias reales que requiere el rol antes de elegir o diseñar cualquier prueba. Un filtro genérico de capacidad cognitiva para un puesto de captura de datos invita a disparidades que una prueba específica de escritura y precisión evitaría.
- Prefiera evaluaciones basadas en tareas y específicas del rol frente a filtros amplios. Las pruebas estructuradas y relevantes para el puesto que reflejan las funciones laborales reales tienden a producir menores diferencias entre grupos que las pruebas de aptitud abstractas, al tiempo que predicen bien el desempeño.
- Use entrevistas estructuradas con preguntas fijas y rúbricas de puntuación. Las entrevistas no estructuradas, en las que cada entrevistador pregunta lo que se le ocurre, son donde el sesgo subjetivo se infiltra con más fuerza.
- Elabore tarjetas de puntuación y capacite a los evaluadores para calibrarlas. Dos entrevistadores que puntúan la misma respuesta deberían coincidir en un punto, no diferir en tres.
- Pruebe alternativas cuando una herramienta señale impacto adverso. Las UGESP requieren que los empleadores evalúen alternativas adecuadas y adopten la que tenga una validez sustancialmente igual y menor impacto.
Consejo práctico: No retire una evaluación solo porque muestre una disparidad. Primero compare su validez con la del reemplazo propuesto. Cambiar una prueba bien validada por una no probada puede sustituir un riesgo legal por un riesgo de mala contratación.
Las herramientas de selección estructuradas y basadas en tareas asignadas directamente a las competencias del puesto superan sistemáticamente a los filtros genéricos tanto en equidad como en precisión predictiva, en gran parte porque miden lo que el trabajo realmente exige en lugar de un indicador indirecto.
Validación y conservación de registros: qué esperan las UGESP que conserve
Las UGESP requieren un estudio de validación una vez que el análisis de impacto adverso supera los umbrales estadísticos y prácticos, y las directrices reconocen tres tipos de evidencia: validez de contenido (la prueba refleja directamente las tareas del puesto), validez de criterio (las puntuaciones se correlacionan con el desempeño laboral real) y validez de constructo (la prueba mide un rasgo subyacente vinculado al éxito en el puesto).
La validación local, un estudio realizado con su propia población de candidatos, tiene el mayor peso. La validez transportada, en la que se recurre a un estudio de validación de un puesto similar en otro lugar, es aceptable cuando los roles y contextos son genuinamente comparables, pero los reguladores examinan detenidamente su adecuación.
Mantenga estos registros en archivo y listos para auditoría:
- Datos de flujo de candidatos desglosados por grupo protegido, para cada requisición
- Tasas de selección y cálculos del índice de impacto para cada ciclo de contratación
- Cualquier documentación del estudio de validación, incluida la metodología y los resultados
- Materiales del proveedor que describan cómo se diseñó y validó una evaluación adquirida
El §1607.4 del CFR detalla las expectativas de conservación de registros vinculadas directamente a la aplicación de la regla de las cuatro quintas partes. Trate estos registros como trataría los documentos fiscales: conservados durante años, organizados por ciclo y listos para entregar con poco aviso.
Cómo mantener bajo control las herramientas de selección basadas en IA y algoritmos
Un algoritmo no queda exento simplemente porque un humano no escribió las reglas de puntuación a mano. La orientación técnica de la EEOC es explícita: no existe ninguna exención algorítmica. El software, las herramientas de clasificación de currículums y los filtros impulsados por IA deben cumplir el mismo estándar de relación con el puesto y validación que una prueba en papel y lápiz de 1985.
Establezca una cadencia de monitoreo, no una revisión única:
- Vuelva a calcular los índices de impacto y las pruebas de significancia en cada ciclo de contratación o trimestre, lo que ocurra primero
- Realice un seguimiento de las tasas de selección por grupo protegido en cada etapa en la que interviene la herramienta, no solo en la decisión final
- Solicite directamente a los proveedores su evidencia de validación, una descripción de sus datos de entrenamiento y cualquier prueba de equidad que hayan realizado
- Tenga preparado un plan de remediación: ajustes del modelo, revisión humana adicional o sustitución por una evaluación alternativa
Consejo práctico: Solicite la documentación de impacto adverso del proveedor antes de firmar, no después de su primer trimestre marcado. La supervisión continua de las herramientas de selección por IA funciona mucho mejor como práctica habitual que como respuesta de emergencia.
Una lista de verificación práctica para crear evaluaciones más justas
Una evaluación justa comienza en el diseño, no en el control de daños. Asigne las tareas del puesto al contenido de la prueba, elabore ítems en torno a esas tareas, realice una prueba piloto con una muestra real de candidatos, mida los índices de impacto y luego valide o revise antes de la implementación completa.
- Asigne las tareas fundamentales del puesto antes de redactar una sola pregunta
- Elabore ítems basados en tareas, no preguntas de aptitud genéricas
- Realice una prueba piloto con una muestra representativa de candidatos
- Mida los índices de impacto y la significancia antes de la implementación completa
- Valide o itere según lo que muestre la prueba piloto
Las salvaguardas contra trampas y los resúmenes de puntuación generados por IA aceleran considerablemente este ciclo. Cuando todos los candidatos realizan la misma prueba basada en tareas bajo las mismas condiciones supervisadas, y cada puntuación viene acompañada de una justificación documentada, se obtienen datos más limpios para los cálculos del índice de impacto y un registro listo para una auditoría.
Cómo se aplica la prueba de impacto adverso en diferentes industrias
La mecánica es la misma en todos los sectores, pero las herramientas que generan mayor escrutinio varían según el sector. En manufactura y logística, las pruebas de habilidad física y de fuerza han producido históricamente algunas de las mayores brechas por sexo, lo que ha llevado a muchos empleadores a adoptar pruebas de simulación de tareas que reflejan el levantamiento o movimiento real requerido, en lugar de medidas brutas de fuerza.
En tecnología y finanzas, las pruebas de capacidad cognitiva y las evaluaciones de programación son las que reciben más escrutinio. Una prueba genérica de razonamiento lógico puede producir disparidades por raza u origen nacional que un desafío de programación específico del rol, puntuado según el lenguaje real y el conjunto de tareas que usa el puesto, a menudo reduce considerablemente.
La contratación en comercio minorista y hotelería depende en gran medida de entrevistas estructuradas y evaluaciones de personalidad, donde los formatos de entrevista no estructurados y libres siguen siendo una de las fuentes más comunes de disparidad impulsada por el evaluador. Los sistemas de salud evalúan cada vez más habilidades adyacentes a la licencia (precisión en el registro de pacientes, cálculo de medicamentos) en lugar de aptitudes amplias, en gran parte porque esas medidas basadas en tareas resisten mejor tanto la revisión de validez como la de impacto adverso.
La contratación en el sector público y por parte de contratistas gubernamentales está bajo el escrutinio más estricto de todos, ya que las revisiones de cumplimiento de la OFCCP extraen rutinariamente datos de flujo de candidatos y recalculan la prueba Z de forma independiente. Cualquier empleador con contratos federales debe asumir que sus números serán recalculados por alguien fuera de la organización.
Dónde falla la prueba de impacto adverso
La regla de las cuatro quintas partes y las pruebas de significancia son herramientas útiles, pero tienen limitaciones. Ambos métodos comparten una debilidad estructural: miden los resultados a nivel de grupo, lo que significa que pueden pasar por alto completamente la injusticia a nivel individual, o señalar una disparidad que no tiene nada que ver con la propia prueba y todo que ver con un grupo de candidatos no representativo.
El tamaño de la muestra actúa en ambas direcciones. Con muy pocos candidatos en un grupo, el índice de las cuatro quintas partes oscila drásticamente con una o dos contrataciones. La prueba exacta de Fisher maneja mejor las muestras pequeñas que una aproximación de prueba Z, pero incluso esa no puede generar potencia estadística a partir de un grupo de ocho candidatos. En el extremo opuesto, grupos de candidatos muy grandes pueden producir una puntuación Z estadísticamente significativa para una brecha tan pequeña que no tiene ningún significado práctico para el resultado profesional de nadie.
La calidad de los datos es su propio punto débil. Los datos demográficos autodeclarados tienen lagunas e inconsistencias. Los embudos de contratación de múltiples etapas hacen que sea fácil perder de vista qué candidatos se retiraron voluntariamente frente a cuáles fueron eliminados por la herramienta que se está evaluando. Y evaluar decenas de categorías de puestos o ubicaciones a la vez, sin ajustar por comparaciones múltiples, infla las probabilidades de que algo aparezca marcado puramente por azar.
Nada de esto hace que la metodología sea inútil. Significa que la prueba de impacto adverso es un insumo para una decisión de juicio, no una fórmula que produce por sí sola un resultado limpio de aprobado o reprobado.
Cómo integrar las verificaciones de impacto adverso en la gobernanza continua
El mayor error que veo es tratar esto como una auditoría única en lugar de una disciplina permanente. Se calculan los índices una vez, se corrige la prueba marcada, se sigue adelante, y la misma brecha suele reaparecer dos ciclos de contratación después bajo una forma ligeramente diferente. Incorpórelo a las revisiones trimestrales, capacite a los gerentes de contratación para detectar señales de alerta antes de que RR. HH. tenga que captarlas a posteriori, y reúna a legal, RR. HH. y analítica en la misma sala cuando un número se mueva. La distribución de responsabilidades entre tres departamentos sin un panel compartido es la forma en que las disparidades persisten durante años sin ser detectadas.
— Jimmie
Cree pruebas más justas más rápido con Talent Approved
Talent Approved ofrece herramientas para ayudar a crear evaluaciones basadas en tareas rápidamente, lo que puede ser útil cuando el análisis de impacto adverso indica la necesidad de probar una alternativa con prontitud. La función Magic Create crea pruebas específicas para cada rol directamente a partir de una descripción de puesto o una lista de habilidades, el tipo de evaluación basada en tareas que esta guía recomienda por encima de los filtros cognitivos genéricos.
El monitoreo integrado y los resúmenes de desempeño generados por IA tienen como objetivo proporcionar datos de puntuación limpios y documentados, útiles para estudios de validación o revisiones. Ese registro de documentación, vinculado directamente a los pasos de mitigación descritos anteriormente, suele ser la diferencia entre una respuesta de cumplimiento rápida y una búsqueda desesperada entre viejas hojas de cálculo. Si su herramienta de selección actual alguna vez le ha generado inquietud respecto a sus tasas de selección entre grupos, comience a crear una evaluación específica del rol en Talent Approved y vea qué tan rápido puede construir una prueba más justa.
Fuentes
- Pruebas de empleo y procedimientos de selección | EEOC
- CFR §1607.4 — Discriminación definida: Relación entre el uso de procedimientos de selección y la discriminación
Preguntas frecuentes
¿Cuál es la diferencia entre impacto adverso y trato dispar?
El impacto adverso es una disparidad estadística en los resultados de los grupos protegidos a partir de un procedimiento neutral, mientras que el trato dispar requiere pruebas de discriminación intencional contra una persona o grupo específico.
¿Qué es la regla de las cuatro quintas partes en las pruebas de empleo?
Señala un posible problema cuando la tasa de selección de un grupo protegido cae por debajo del 80% de la tasa del grupo con mayor tasa de selección, aunque la orientación de la EEOC la trata como una herramienta de detección, no como un absoluto legal.
¿Cuándo debo usar una prueba Z en lugar de la prueba exacta de Fisher?
Use la prueba Z binomial de dos muestras cuando cada grupo tenga 30 o más candidatos; use la prueba exacta de Fisher para muestras más pequeñas, donde las aproximaciones de muestras grandes se vuelven poco confiables.
¿Las herramientas de contratación con IA también necesitan pruebas de impacto adverso?
Sí. La EEOC ha aclarado que no existe ninguna exención para las herramientas algorítmicas respecto al análisis de impacto adverso, por lo que el software y las herramientas de selección impulsadas por IA deben probarse y validarse de la misma manera que las evaluaciones tradicionales.
¿Qué sucede si mi evaluación muestra impacto adverso?
Debe demostrar que el procedimiento está relacionado con el puesto y es coherente con la necesidad empresarial, o adoptar una alternativa menos discriminatoria con validez comparable; y plataformas como Talent Approved pueden ayudarle a probar y documentar esa alternativa rápidamente.
Recomendado
- Directrices de pruebas de la EEOC: Lo que los empleadores deben saber
- Gestión de evaluaciones de contratación de alto volumen: Un manual para 2026
- Formatos de evaluación técnica para RR. HH.: Una guía para 2026
- Detenga la contratación sesgada: Lista de verificación de estrategia de localización de evaluaciones para RR. HH.