
US HR-Leitfaden zu Adverse Impact Tests: Durchführen, Auswerten, Beheben
Wenn Ihr Einstellungsprozess für eine geschützte Gruppe eine deutlich niedrigere Auswahlquote hervorbringt als für Ihre bestbewertete Gruppe, haben Sie ein Signal, das es zu untersuchen gilt. Berechnen Sie die Impact Ratio und führen Sie einen Signifikanztest durch (mit geeigneten Methoden für größere oder kleinere Stichproben), bevor Sie mit diesem Verfahren eine weitere Einstellungsentscheidung treffen. Wenn eines der beiden ein Problem anzeigt, validieren Sie die Beurteilung gemäß UGESP oder ersetzen Sie sie durch eine weniger diskriminierende Alternative, die die Arbeitsleistung vergleichbar vorhersagt.
Kurzzusammenfassung:
- Adverse Impact kann selbst bei neutralen Auswahlverfahren wie Tests oder Vorstellungsgesprächen auftreten und statistisch signifikante Unterschiede ohne jede Absicht erzeugen.
- Die Validierung von Beurteilungen umfasst die Berechnung von Auswahlquoten, Impact Ratios unter 0,80 sowie die Durchführung von Signifikanztests mit angemessenen Stichprobengrößen, wobei mehrere Einstellungszyklen für mehr Genauigkeit zusammengeführt werden.
- Organisationen müssen detaillierte Aufzeichnungen über Bewerberdaten, Validierungsbemühungen und Impact-Analysen führen, um die UGESP einzuhalten und auf Prüfungen vorbereitet zu sein – insbesondere für Bundesauftragnehmer.
- Aufgabenspezifische, rollenbasierte Beurteilungen und strukturierte Interviews reduzieren Unterschiede besser als allgemeine Vorauswahlverfahren, insbesondere wenn sie von vornherein auf einer Stellenanalyse basieren.
- Die kontinuierliche Überwachung von Impact Ratios und KI-Tools sowie die Validierung durch Anbieter sind unerlässlich, um faire Einstellungspraktiken aufrechtzuerhalten und wiederkehrende Ungleichheiten im Laufe der Zeit zu vermeiden.
Inhaltsverzeichnis
- Was Adverse Impact Testing tatsächlich misst
- Die Zahlen auswerten: Auswahlquoten, Impact Ratios und Signifikanztests
- Ergebnisse lesen, ohne über- oder unterzureagieren
- Die Pipeline verbessern: Stellenanalyse, strukturierte Interviews und bessere Beurteilungen
- Validierung und Dokumentation: Was UGESP von Ihnen erwartet
- KI- und algorithmische Vorauswahltools unter Kontrolle halten
- Eine praktische Checkliste für fairere Beurteilungen
- Wie Adverse Impact Testing in verschiedenen Branchen aussieht
- Wo Adverse Impact Testing an seine Grenzen stößt
- Adverse Impact-Prüfungen in die laufende Governance integrieren
- Fairere Tests schneller entwickeln mit Talent Approved
- Quellen
- FAQ
Was Adverse Impact Testing tatsächlich misst
Adverse Impact ist ein statistisches Ergebnis, keine Absicht. Er tritt auf, wenn ein auf den ersten Blick neutrales Auswahlverfahren – ein kognitiver Test, ein Interview-Bewertungsraster, eine Lebenslaufvorauswahl – messbar unterschiedliche Bestehensquoten bei Rasse, Geschlecht, Alter oder anderen geschützten Merkmalen erzeugt, unabhängig davon, was jemand beabsichtigt hat. Diese Unterscheidung trennt ihn von der ungleichen Behandlung (Disparate Treatment), die den Nachweis erfordert, dass jemand absichtlich benachteiligt wurde. Die Adverse Impact-Analyse stellt eine nüchternere Frage: Haben die Zahlen ungleichmäßig abgeschnitten, und wenn ja, warum?
Der rechtliche Rahmen ergibt sich aus drei Quellen. Title VII des Civil Rights Act verbietet Beschäftigungspraktiken, die eine geschützte Gruppe unverhältnismäßig stark ausschließen, es sei denn, der Arbeitgeber kann die Praxis rechtfertigen. Die Uniform Guidelines on Employee Selection Procedures (UGESP), die 1978 gemeinsam von Bundesbehörden verabschiedet wurden, legen fest, wie Arbeitgeber ihre Auswahlmethoden bewerten sollen und wann sie der Regierung eine Validierungsstudie schulden. Die EEOC setzt Title VII durch und gibt Auslegungshinweise, während die OFCCP parallele Standards für Bundesauftragnehmer anwendet und bei Compliance-Prüfungen häufig selbst die statistischen Tests durchführt.
Eine Validierung wird ausgelöst, sobald die Adverse Impact-Analyse eine Disparität aufzeigt, die statistische und praktische Signifikanzschwellen überschreitet. An diesem Punkt ist die EEOC-Leitlinie eindeutig: Der Arbeitgeber muss nachweisen, dass das Verfahren stellenbezogen und mit der geschäftlichen Notwendigkeit vereinbar ist, oder zu einer weniger diskriminierenden Alternative wechseln.
Das Bundesrecht schützt im Kontext von Eignungstests folgende Gruppen:
- Rasse und Hautfarbe
- Geschlecht, einschließlich Schwangerschaft und Geschlechtsidentität
- Nationale Herkunft
- Religion
- Alter (40 Jahre und älter, gemäß ADEA)
- Behinderungsstatus (ADA)
Jede dieser Kategorien erfordert einen eigenen Vergleich der Auswahlquoten. Wer sie zusammenfasst oder nur die Rasse prüft und das Alter außer Acht lässt, riskiert, dass Ungleichheiten erst dann auffallen, wenn eine Beschwerde auf dem Tisch liegt.
Die Zahlen auswerten: Auswahlquoten, Impact Ratios und Signifikanztests
Die Überprüfung auf Verzerrungen in Ihrer Einstellungspipeline folgt einer festen Abfolge. Überspringen Sie einen Schritt, und Sie übersehen entweder ein echtes Problem oder verfolgen ein Phantomproblem.
- Berechnen Sie die Auswahlquote für jede Gruppe. Teilen Sie die Anzahl der Ausgewählten durch die Anzahl der Bewerber in dieser Gruppe. Wenn sich 80 Frauen beworben haben und 20 eingestellt wurden, beträgt die Auswahlquote 25 %.
- Ermitteln Sie die Gruppe mit der höchsten Auswahlquote. Diese wird zu Ihrer Vergleichsbasis, unabhängig von der Gruppengröße.
- Berechnen Sie die Impact Ratio. Teilen Sie die Auswahlquote jeder Gruppe durch die Quote der Basisgruppe. Ein Verhältnis unter 0,80 löst die Vier-Fünftel-Regel aus.
- Führen Sie einen Signifikanztest durch. Bei Stichproben von 30 oder mehr Personen pro Gruppe verwenden Sie den Zwei-Stichproben-Binomial-Z-Test. Bei kleineren Stichproben verwenden Sie den exakten Fisher-Test, der nicht auf Großstichproben-Näherungen basiert.
- Interpretieren Sie das Ergebnis anhand Ihres Alpha-Niveaus. Die meisten Praktiker verwenden ein Alpha-Niveau, das etwa 95 % Konfidenz entspricht, obwohl einige Behörden für zweiseitige Vergleiche strengere Schwellenwerte anwenden.
Statistischer Hinweis: Die OFCCP behandelt einen absoluten Z-Wert an einer Schwelle, die als statistisch signifikant gilt und ungefähr einem Konfidenzniveau von 95 % entspricht, was grob mit einem 95 %-Konfidenz-Schwellenwert übereinstimmt. Diese Zahl – nicht nur die Vier-Fünftel-Ratio – ist das, was ein Bundesbeauftragter für Compliance-Prüfungen tatsächlich berechnen wird.
Die Vier-Fünftel-Regel ist ein Screening-Instrument, kein Urteil. Die EEOC-Leitlinien beschreiben sie als Faustregel, die Behörden nach eigenem Ermessen anwenden. Eine Ratio von 0,79 bei einem Pool von sechs Bewerbern bedeutet statistisch gesehen kaum etwas. Eine Ratio von 0,83 bei 4.000 Bewerbern kann dennoch eine echte, signifikante Ungleichheit darstellen. Die Regel zeigt an, wo man hinschauen soll. Der Z-Test oder der exakte Fisher-Test zeigt Ihnen, ob das, was Sie betrachten, Rauschen ist oder nicht.
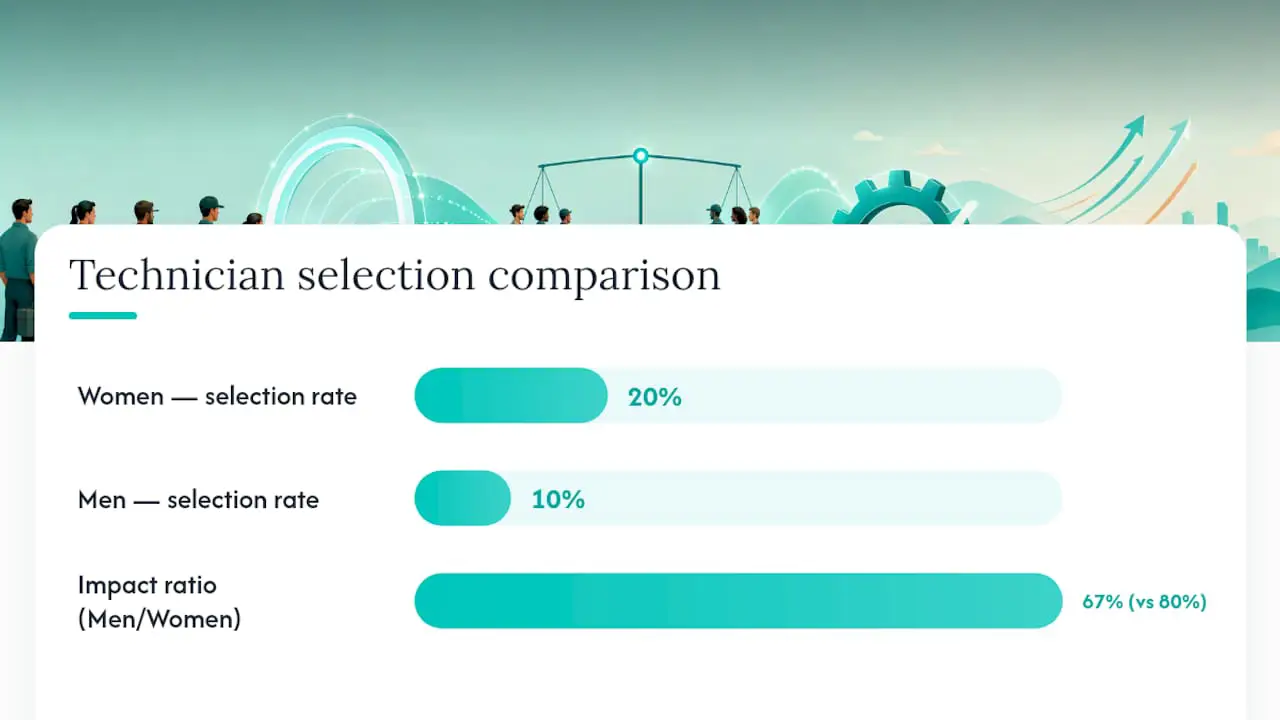
Hier ist eine vereinfachte Schritt-für-Schritt-Erklärung. Angenommen, 200 Männer und 150 Frauen bewerben sich auf eine Techniker-Stelle. Die Impact Ratio beträgt 20/30 bzw. 0,67 – deutlich unter dem Schwellenwert von 0,80. Ein Zwei-Stichproben-Z-Test für diese Zahlen (beide Gruppen übersteigen 30) würde zeigen, ob diese 10-Punkte-Lücke wahrscheinlich auf den Zufall zurückzuführen ist oder ein strukturelles Problem in der Beurteilung selbst widerspiegelt.
Ergebnisse lesen, ohne über- oder unterzureagieren
Eine markierte Ratio ist ein Ausgangspunkt für Untersuchungen, kein automatischer Diskriminierungsbefund – und eine unauffällige Ratio garantiert nicht, dass Ihr Prozess fair ist. Kleine Bewerberpools verzerren sowohl die Vier-Fünftel-Ratio als auch Signifikanztests: Eine Handvoll Einstellungen kann eine Auswahlquote um 10 oder 15 Punkte verschieben, sodass ein einzelner Einstellungszyklus selten die vollständige Geschichte erzählt.
Achten Sie auf diese häufigen Fehler:
- Testen von Dutzenden von Untergruppen ohne Anpassung Ihres Alpha-Niveaus, was die Wahrscheinlichkeit eines falsch-positiven Ergebnisses irgendwo in den Daten rein zufällig erhöht.
- Konfidenzintervalle ignorieren und eine Grenzwert-Ratio als eindeutig in Ordnung oder eindeutig problematisch behandeln.
- Überreagieren auf ein schlechtes Quartal, anstatt mehrere Einstellungszyklen zusammenzuführen, um zu sehen, ob das Muster anhält.
- Unterreagieren auf eine „bestehende" Vier-Fünftel-Ratio, die einen statistisch signifikanten Z-Score verbirgt – da die beiden Maßzahlen unterschiedliche Fragen beantworten.
Jeder Signifikanztest beinhaltet einen Kompromiss zwischen Typ-I-Fehler (einen fairen Prozess fälschlicherweise als verzerrt kennzeichnen) und Typ-II-Fehler (einen tatsächlich verzerrten übersehen). Ein strengeres Alpha reduziert Fehlalarme, erleichtert es aber echten Ungleichheiten, bei kleineren Stichproben unbemerkt zu bleiben – genau deshalb setzen Regulierungsbehörden bei geringen Gruppengrößen auf den exakten Fisher-Test statt auf einen Z-Test.
Praxis-Tipp: Führen Sie mindestens zwei oder drei Einstellungszyklen zusammen, bevor Sie entscheiden, ob eine Ungleichheit real ist. Ein einzelnes Ausreißer-Quartal mit 12 Bewerbern kann eine dramatisch wirkende Ratio erzeugen, die verschwindet, sobald Sie die nächsten 200 Kandidaten zum Datensatz hinzufügen.
Wenn ein Ergebnis sowohl den Vier-Fünftel-Schwellenwert als auch einen Signifikanztest über mehrere Zyklen hinweg überschreitet, ist das Ihr Signal, zur Validierung überzugehen oder einen Ersatz zu erproben – und nicht einfach zu beobachten und zu hoffen, dass sich das Problem von selbst korrigiert.
Die Pipeline verbessern: Stellenanalyse, strukturierte Interviews und bessere Beurteilungen
Abhilfemaßnahmen wirken am besten, wenn sie beginnen, bevor Sie überhaupt eine Stelle ausschreiben – nicht erst nachdem die Adverse Impact-Analyse ein Problem aufgedeckt hat.
- Beginnen Sie mit einer Stellenanalyse. Definieren Sie die tatsächlichen Aufgaben und Kompetenzen, die die Stelle erfordert, bevor Sie einen Test auswählen oder entwickeln. Ein allgemeiner kognitiver Eignungstest für eine Dateneingabe-Stelle lädt Ungleichheiten ein, die ein aufgabenbasierter Schreib- und Genauigkeitstest vermeiden würde.
- Bevorzugen Sie aufgabenbasierte, rollenspezifische Beurteilungen gegenüber breiten Vorauswahlverfahren. Strukturierte, stellenbezogene Tests, die tatsächliche Arbeitsaufgaben widerspiegeln, führen tendenziell zu kleineren Gruppenunterschieden als abstrakte Eignungstests und sagen die Leistung dabei trotzdem gut vorher.
- Verwenden Sie strukturierte Interviews mit festen Fragen und Bewertungsrastern. Bei unstrukturierten Interviews, bei denen jeder Interviewer fragt, was ihm gerade einfällt, schleicht sich subjektive Verzerrung am stärksten ein.
- Entwickeln Sie Bewertungsbögen und schulen Sie Bewerter darin, sich daran zu orientieren. Zwei Interviewer, die dieselbe Antwort bewerten, sollten maximal einen Punkt voneinander abweichen – nicht drei.
- Erproben Sie Alternativen, wenn ein Tool Adverse Impact anzeigt. UGESP verpflichtet Arbeitgeber, geeignete Alternativen zu bewerten und diejenige zu übernehmen, die eine im Wesentlichen gleichwertige Validität und geringere Auswirkungen aufweist.
Praxis-Tipp: Ersetzen Sie eine Beurteilung nicht allein deshalb, weil sie eine Ungleichheit aufzeigt. Vergleichen Sie zunächst ihre Validität mit der des vorgeschlagenen Ersatzes. Ein gut validiertes Testverfahren gegen ein ungeprüftes auszutauschen kann ein rechtliches Risiko gegen ein Fehlbesetzungsrisiko eintauschen.
Strukturierte, aufgabenbasierte Vorauswahltools, die direkt auf Stellenkompetenzen abgestimmt sind, übertreffen allgemeine Vorauswahlverfahren konsistent in Bezug auf Fairness und Vorhersagegenauigkeit – größtenteils weil sie messen, was die Stelle tatsächlich erfordert, und nicht ein Ersatzmerkmal dafür.
Validierung und Dokumentation: Was UGESP von Ihnen erwartet
UGESP erfordert eine Validierungsstudie, sobald die Adverse Impact-Analyse statistische und praktische Schwellenwerte überschreitet, und die Leitlinien erkennen drei Arten von Nachweisen an: Inhaltsvalidität (der Test spiegelt Arbeitsaufgaben direkt wider), kriteriumsbezogene Validität (Testergebnisse korrelieren mit der tatsächlichen Arbeitsleistung) und Konstruktvalidität (der Test misst ein zugrunde liegendes Merkmal, das mit dem Erfolg auf der Stelle verbunden ist).
Lokale Validierung – eine Studie, die an Ihrer eigenen Bewerberpopulation durchgeführt wird – hat das größte Gewicht. Transportierte Validität, bei der Sie sich auf eine Validierungsstudie aus einem ähnlichen Job an anderer Stelle stützen, ist akzeptabel, wenn die Stellen und Umgebungen wirklich vergleichbar sind, aber Regulierungsbehörden prüfen die Übereinstimmung genau.
Halten Sie diese Unterlagen bereit und prüfungsbereit:
- Bewerberflussdaten, aufgeschlüsselt nach geschützten Gruppen, für jede Stelle
- Auswahlquoten und Impact Ratio-Berechnungen für jeden Einstellungszyklus
- Dokumentation aller Validierungsstudien, einschließlich Methodik und Ergebnissen
- Anbietermaterialien, die beschreiben, wie eine erworbene Beurteilung entwickelt und validiert wurde
CFR §1607.4 beschreibt die Dokumentationsanforderungen, die direkt mit der Durchsetzung der Vier-Fünftel-Regel verknüpft sind. Behandeln Sie diese Unterlagen wie Steuerdokumente: jahrelang aufbewahrt, nach Zyklus geordnet und kurzfristig aushändigungsbereit.
KI- und algorithmische Vorauswahltools unter Kontrolle halten
Ein Algorithmus bekommt keinen Freifahrtschein, nur weil kein Mensch die Bewertungsregeln von Hand geschrieben hat. Die technischen Leitlinien der EEOC sind eindeutig: Es gibt keine algorithmische Ausnahme. Software, Tools zur Rangfolge von Lebensläufen und KI-gestützte Vorauswahlverfahren müssen denselben Anforderungen an Stellenbezug und Validierung genügen wie ein Papier-und-Bleistift-Test aus dem Jahr 1985.
Etablieren Sie einen regelmäßigen Überwachungsrhythmus – keine einmalige Prüfung:
- Führen Sie Impact Ratios und Signifikanztests in jedem Einstellungszyklus oder Quartal durch, je nachdem, was zuerst eintritt
- Verfolgen Sie Auswahlquoten nach geschützter Gruppe in jeder Phase, die das Tool berührt – nicht nur bei der endgültigen Entscheidung
- Fragen Sie Anbieter direkt nach ihren Validierungsnachweisen, einer Beschreibung ihrer Trainingsdaten und allen von ihnen durchgeführten Fairness-Tests
- Halten Sie einen Abhilfepfad bereit: Modellanpassungen, zusätzliche menschliche Überprüfung oder den Einsatz einer alternativen Beurteilung
Praxis-Tipp: Fordern Sie die Adverse Impact-Dokumentation eines Anbieters an, bevor Sie unterschreiben – nicht erst nach Ihrem ersten markierten Quartal. Die laufende Überwachung von KI-Vorauswahltools funktioniert als dauerhafte Praxis weitaus besser als ein hektisches Nacharbeiten.
Eine praktische Checkliste für fairere Beurteilungen
Faires Testen beginnt beim Design, nicht bei der Schadensbegrenzung. Ordnen Sie Arbeitsaufgaben Testinhalten zu, entwickeln Sie Fragen rund um diese Aufgaben, erproben Sie das Tool mit einer echten Bewerberstichprobe, messen Sie Impact Ratios, und validieren oder überarbeiten Sie das Tool dann vor dem vollständigen Rollout.
- Kernarbeitsaufgaben kartieren, bevor Sie eine einzige Frage schreiben
- Aufgabenbasierte Fragen entwickeln, keine allgemeinen Eignungsfragen
- Mit einer repräsentativen Bewerberstichprobe erproben
- Impact Ratios und Signifikanz vor dem vollständigen Einsatz messen
- Auf Basis der Pilotphase validieren oder iterieren
Betrugssicherungsmaßnahmen und KI-generierte Bewertungszusammenfassungen beschleunigen diesen Zyklus erheblich. Wenn jeder Kandidat denselben aufgabenbasierten Test unter denselben überwachten Bedingungen ablegt und jedes Ergebnis mit einer dokumentierten Begründung versehen ist, erhalten Sie sauberere Daten für Impact Ratio-Berechnungen und einen Prüfpfad, der für eine Prüfung bereit ist.
Wie Adverse Impact Testing in verschiedenen Branchen aussieht
Die Mechanik bleibt überall gleich, aber die Tools, die Aufmerksamkeit erregen, unterscheiden sich je nach Sektor. In der Fertigungs- und Logistikbranche haben körperliche Leistungstests und Krafttests historisch gesehen einige der größten geschlechtsspezifischen Lücken erzeugt, was viele Arbeitgeber dazu veranlasst hat, auf aufgabensimulationsbasierte Tests umzusteigen, die das tatsächlich erforderliche Heben oder die Bewegungsabläufe widerspiegeln, anstatt rohe Kraftmaßstäbe zu verwenden.
In der Technologie- und Finanzbranche stehen kognitive Eignungstests und Programmiertests unter dem stärksten Scrutinium. Ein allgemeiner logischer Denktest kann Ungleichheiten nach Rasse oder nationaler Herkunft erzeugen, die eine rollenspezifische Programmieraufgabe – bewertet anhand der tatsächlichen Programmiersprache und des Aufgaben-Stacks der Stelle – oft deutlich verringert.
Das Einstellungsverfahren im Einzel- und Gastgewerbe stützt sich stark auf strukturierte Interviews und Persönlichkeitsbeurteilungen, wobei unstrukturierte, freie Interviewformate nach wie vor eine der häufigsten Quellen bewerterbedingter Ungleichheiten sind. Gesundheitssysteme testen zunehmend lizenzierungsnahe Fähigkeiten (Genauigkeit bei der Patientenakte, Rechnen mit Medikamentendosierungen) anstelle von allgemeiner Eignung – größtenteils weil diese aufgabenbasierten Maßnahmen sowohl bei Validierungs- als auch bei Adverse Impact-Überprüfungen besser abschneiden.
Die Einstellung im öffentlichen Sektor und bei Bundesauftragnehmern unterliegt der strengsten Kontrolle überhaupt, da OFCCP-Compliance-Prüfungen routinemäßig Bewerberflussdaten abrufen und den Z-Test unabhängig neu berechnen. Jeder Arbeitgeber mit Bundesverträgen sollte davon ausgehen, dass seine Zahlen von jemandem außerhalb des Unternehmens neu berechnet werden.
Wo Adverse Impact Testing an seine Grenzen stößt
Die Vier-Fünftel-Regel und Signifikanztests sind nützliche Instrumente, aber sie haben Einschränkungen. Beide Methoden teilen eine strukturelle Schwäche: Sie messen Ergebnisse auf Gruppenebene, was bedeutet, dass sie individuelle Ungleichheiten vollständig übersehen können – oder eine Ungleichheit markieren, die nichts mit dem Test selbst zu tun hat, sondern alles mit einem nicht repräsentativen Bewerberpool.
Die Stichprobengröße wirkt in beide Richtungen. Zu wenige Bewerber in einer Gruppe, und die Vier-Fünftel-Ratio schwankt bei einer oder zwei Einstellungen stark. Der exakte Fisher-Test verarbeitet kleine Stichproben besser als eine Z-Test-Näherung, aber auch er kann aus einem Pool von acht Bewerbern keine statistische Power herbeizaubern. Am anderen Extrem können sehr große Bewerberpools einen statistisch signifikanten Z-Score für eine Lücke erzeugen, die so klein ist, dass sie für die Berufsbiographie niemandem praktisch bedeutsam ist.
Datenqualität ist ein eigenständiger Schwachpunkt. Selbst gemeldete demografische Daten weisen Lücken und Inkonsistenzen auf. Mehrstufige Einstellungsprozesse machen es leicht, den Überblick darüber zu verlieren, welche Kandidaten freiwillig ausgeschieden sind und welche durch das zu testende Tool ausgesiebt wurden. Und wenn Dutzende von Stellenkategorien oder Standorten gleichzeitig getestet werden, ohne für mehrfache Vergleiche zu korrigieren, steigt die Wahrscheinlichkeit, dass etwas rein zufällig markiert wird.
Das macht die Methodik nicht nutzlos. Es bedeutet, dass Adverse Impact Testing ein Eingabefaktor für ein Urteil ist – keine Formel, die von sich aus ein sauberes Bestehen oder Nichtbestehen ausspuckt.
Adverse Impact-Prüfungen in die laufende Governance integrieren
Der größte Fehler, den ich beobachte, ist, dies als einmalige Prüfung statt als dauerhafte Disziplin zu behandeln. Die Ratios einmal berechnen, den markierten Test korrigieren, weitermachen – und dieselbe Lücke taucht oft zwei Einstellungszyklen später in leicht veränderter Form wieder auf. Integrieren Sie es in vierteljährliche Reviews, schulen Sie Einstellungsverantwortliche darin, Warnsignale zu erkennen, bevor die Personalabteilung sie nachträglich auffangen muss, und bringen Sie Rechtsabteilung, HR und Analytik in denselben Raum, wenn sich eine Zahl bewegt. Zuständigkeiten, die auf drei Abteilungen ohne gemeinsames Dashboard aufgeteilt sind, sind der Grund, warum Ungleichheiten jahrelang unbemerkt bleiben.
— Jimmie
Fairere Tests schneller entwickeln mit Talent Approved
Talent Approved bietet Tools, die dabei helfen, aufgabenbasierte Beurteilungen schnell zu erstellen – was nützlich sein kann, wenn die Adverse Impact-Analyse zeigt, dass eine Alternative zeitnah erprobt werden muss. Die Funktion Magic Create entwickelt rollenspezifische Tests direkt aus einer Stellenbeschreibung oder einer Kompetenzliste – genau die Art von aufgabenbasierter Beurteilung, die dieser Leitfaden gegenüber allgemeinen kognitiven Vorauswahlverfahren empfiehlt.
Integrierte Überwachung und KI-generierte Leistungszusammenfassungen sollen saubere, dokumentierte Bewertungsdaten liefern, die für Validierungsstudien oder Reviews nützlich sind. Dieser Dokumentationspfad – direkt an die oben beschriebenen Abhilfeschritte geknüpft – ist oft der Unterschied zwischen einer schnellen Compliance-Antwort und einem hektischen Durchsuchen alter Tabellenkalkulationen. Wenn Ihr aktuelles Vorauswahlverfahren Sie jemals besorgt hat, was die Auswahlquoten über Gruppen hinweg betrifft, beginnen Sie jetzt mit dem Aufbau einer rollenspezifischen Beurteilung auf Talent Approved und sehen Sie, wie schnell ein fairerer Test entsteht.
Quellen
- Beschäftigungstests und Auswahlverfahren | EEOC
- CFR §1607.4 — Diskriminierung definiert: Verhältnis zwischen der Verwendung von Auswahlverfahren und Diskriminierung
FAQ
Was ist der Unterschied zwischen Adverse Impact und Disparate Treatment?
Adverse Impact ist eine statistische Ungleichheit in den Ergebnissen geschützter Gruppen durch ein neutrales Verfahren, während Disparate Treatment den Nachweis einer vorsätzlichen Diskriminierung einer bestimmten Person oder Gruppe erfordert.
Was ist die Vier-Fünftel-Regel bei Eignungstests?
Sie markiert ein mögliches Problem, wenn die Auswahlquote einer geschützten Gruppe unter 80 % der Quote der Gruppe mit der höchsten Auswahlrate fällt, obwohl die EEOC-Leitlinien sie als Screening-Tool und nicht als absoluten rechtlichen Maßstab behandeln.
Wann sollte ich einen Z-Test gegenüber dem exakten Fisher-Test verwenden?
Verwenden Sie den Zwei-Stichproben-Binomial-Z-Test, wenn jede Gruppe 30 oder mehr Bewerber hat; verwenden Sie den exakten Fisher-Test bei kleineren Stichproben, bei denen Großstichproben-Näherungen unzuverlässig werden.
Müssen KI-Einstellungstools ebenfalls auf Adverse Impact getestet werden?
Ja. Die EEOC hat klargestellt, dass es für algorithmische Tools keine Ausnahme von der Adverse Impact-Analyse gibt, sodass Software und KI-gestützte Vorauswahltools auf dieselbe Weise wie traditionelle Beurteilungen getestet und validiert werden müssen.
Was passiert, wenn meine Beurteilung Adverse Impact aufzeigt?
Sie müssen nachweisen, dass das Verfahren stellenbezogen und mit der geschäftlichen Notwendigkeit vereinbar ist, oder eine weniger diskriminierende Alternative mit vergleichbarer Validität einführen – und Plattformen wie Talent Approved können Ihnen helfen, diese Alternative schnell zu erproben und zu dokumentieren.