
US HR-håndbok for testing av uønsket påvirkning: Kjør, les, fiks
Hvis ansettelsesprosessen din gir en merkbart lavere utvelgelsesrate for en hvilken som helst beskyttet gruppe sammenlignet med gruppen med høyest score, har du et signal som er verdt å undersøke. Kjør påvirkningsforholdet og en signifikanstest (ved hjelp av passende metoder for større eller mindre utvalg) før du tar en ny ansettelsesavgjørelse med den prosedyren. Hvis en av dem indikerer et problem, valider vurderingen i henhold til UGESP eller bytt til et mindre diskriminerende alternativ som predikerer arbeidsytelse på tilsvarende måte.
TL;DR:
- Negativ påvirkning kan forekomme selv med nøytrale utvelgelsesprosedyrer som tester eller intervjuer, og produsere statistisk signifikante forskjeller uten bevisst hensikt.
- Validering av vurderinger innebærer beregning av utvelgelsesrater, påvirkningsforhold under 0,80, og gjennomføring av signifikanstester med passende utvalgsstørrelser, ved å slå sammen flere ansettelsessykluser for nøyaktighet.
- Organisasjoner må føre detaljerte registre over søkerdata, valideringsarbeid og påvirkningsanalyser for å overholde UGESP og forberede seg på revisjoner, særlig for føderale entreprenører.
- Oppgavespesifikke, rollebaserte vurderinger og strukturerte intervjuer reduserer forskjeller bedre enn generiske screeningverktøy, særlig når de utformes med jobbanalyse i forkant.
- Kontinuerlig overvåking av påvirkningsforhold og AI-verktøy, med leverandørvalidering, er avgjørende for å opprettholde rettferdige ansettelsespraksis og unngå tilbakevendende forskjeller over tid.
Innholdsfortegnelse
- Hva testing av negativ påvirkning faktisk måler
- Slik kjører du tallene: Utvelgelsesrater, påvirkningsforhold og signifikanstester
- Å lese resultatene uten å overreagere eller underreagere
- Å fikse rekrutteringsprosessen: Jobbanalyse, strukturerte intervjuer og bedre vurderinger
- Validering og journalføring: Hva UGESP forventer at du oppbevarer
- Å holde AI- og algoritmiske screeningverktøy i sjakk
- En praktisk sjekkliste for å bygge mer rettferdige vurderinger
- Hvordan testing av negativ påvirkning ser ut på tvers av bransjer
- Hvor testing av negativ påvirkning kommer til kort
- Å bygge kontroller for negativ påvirkning inn i løpende styring
- Bygg mer rettferdige tester raskere med Talent Approved
- Kilder
- FAQ
Hva testing av negativ påvirkning faktisk måler
Negativ påvirkning er et statistisk utfall, ikke en hensikt. Det viser seg når en tilsynelatende nøytral utvelgelsesprosedyre – en kognitiv test, en intervjurubrikk, en CV-screening – gir meningsfullt forskjellige bestått-rater på tvers av rase, kjønn, alder eller andre beskyttede grupper, uavhengig av hva noen hadde til hensikt. Denne distinksjonen skiller det fra ulik behandling, som krever bevis for at noen ble pekt ut med hensikt. Analyse av negativ påvirkning stiller et kaldere spørsmål: landet tallene ulikt, og i så fall, hvorfor?
Det juridiske rammeverket kommer fra tre steder. Tittel VII i Civil Rights Act forbyr ansettelsespraksis som uforholdsmessig siler ut en beskyttet gruppe, med mindre arbeidsgiveren kan rettferdiggjøre praksisen. Uniform Guidelines on Employee Selection Procedures (UGESP), vedtatt i fellesskap av føderale etater i 1978, beskriver hvordan arbeidsgivere bør evaluere sine utvelgelsesverktøy og når de skylder myndighetene en valideringsstudie. EEOC håndhever Tittel VII og utgir fortolkningsveiledning, mens OFCCP anvender parallelle standarder for føderale entreprenører og kjører ofte den statistiske testingen under samsvarskontroller.
Validering utløses i det øyeblikket analyse av negativ påvirkning avdekker en forskjell som passerer terskler for statistisk og praktisk signifikans. På det tidspunktet er EEOCs veiledning direkte: arbeidsgiveren må vise at prosedyren er jobberelatert og i tråd med forretningsmessig nødvendighet, eller gå over til et mindre diskriminerende alternativ.
Føderal lov beskytter disse gruppene i konteksten av ansettelsestesting:
- Rase og hudfarge
- Kjønn, inkludert graviditet og kjønnsidentitet
- Nasjonal opprinnelse
- Religion
- Alder (40 år og eldre, under ADEA)
- Funksjonshemmingstatus (ADA)
Hver av disse kategoriene trenger sin egen sammenligning av utvelgelsesrater. Å slå dem sammen, eller bare sjekke rase og hoppe over alder, er hvordan forskjeller går ubemerket hen inntil en klage lander på skrivebordet ditt.
Slik kjører du tallene: Utvelgelsesrater, påvirkningsforhold og signifikanstester
Testing for skjevheter i rekrutteringsprosessen følger en fast rekkefølge. Hopp over et steg, og du enten overser et reelt problem eller jager et fiktivt ett.
- Beregn utvelgelsesraten for hver gruppe. Del antallet valgte med antallet søkere i den gruppen. Hvis 80 kvinner søkte og 20 ble ansatt, er utvelgelsesraten 25 %.
- Identifiser gruppen med høyest utvelgelsesrate. Denne blir ditt sammenligningsgrunnlag, uavhengig av gruppestørrelse.
- Beregn påvirkningsforholdet. Del hver gruppes utvelgelsesrate med grunnlagsgruppens rate. Et forhold under 0,80 utløser fire-femtedels-regelen.
- Kjør en signifikanstest. For utvalg på 30 eller flere per gruppe, bruk den tosample binomiale Z-testen. For mindre utvalg, bruk Fishers eksakte test, som ikke er avhengig av store-utvalgs-tilnærminger.
- Tolke mot ditt alfa-nivå. De fleste praktikere bruker et alfa-nivå som representerer omtrent 95 % konfidensintervall, selv om noen etater anvender strengere terskler for tohalede sammenligninger.
Statistisk merknad: OFCCP behandler en absolutt Z-verdi ved en terskel som anses statistisk signifikant tilnærmet tilsvarende et 95 % konfidensnivå, omtrent i tråd med en 95 % konfidens-terskel. Det tallet, ikke bare fire-femtedels-forholdet, er det en føderal samsvarskontrolør faktisk vil beregne under en revisjon.
Fire-femtedels-regelen er et screeningverktøy, ikke en dom. EEOCs veiledning beskriver den som en tommelfingerregel som etater anvender etter skjønn. Et forhold på 0,79 i en pool med seks søkere betyr nesten ingenting statistisk. Et forhold på 0,83 på tvers av 4 000 søkere kan fortsatt representere en reell, signifikant forskjell. Regelen markerer hvor man skal se. Z-testen eller Fishers eksakte test forteller deg om det du ser på er støy.
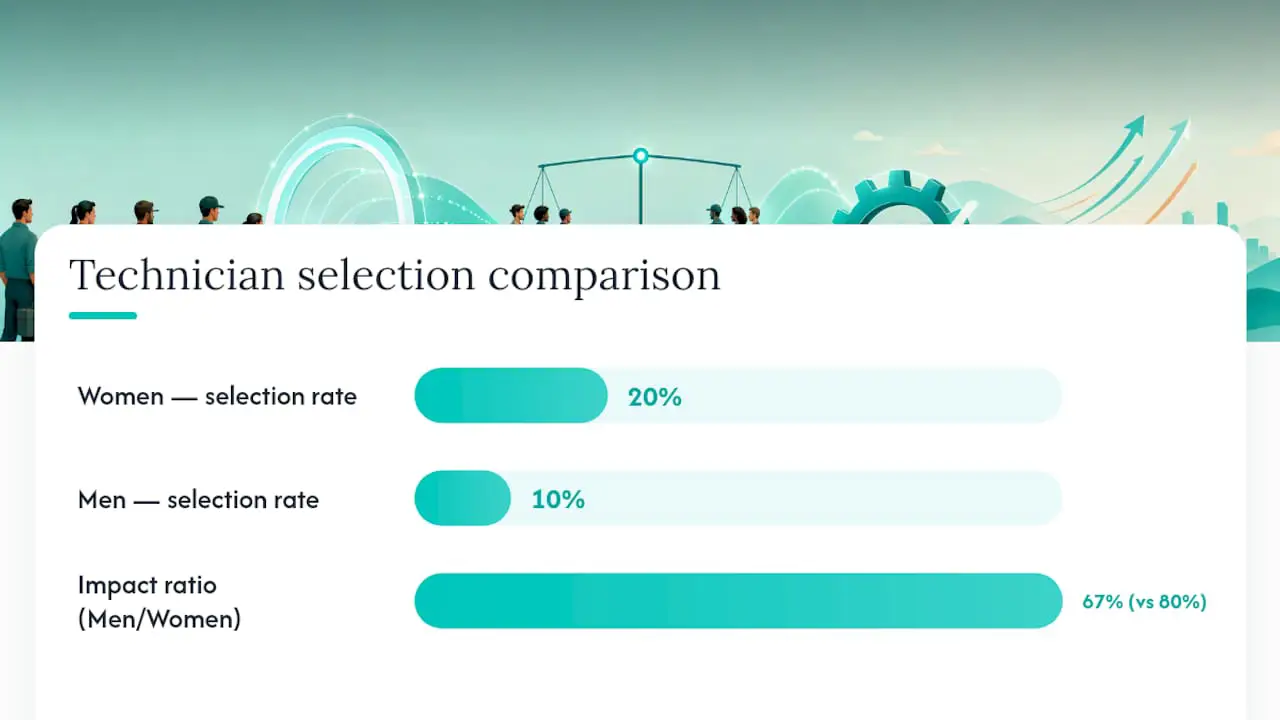
Her er en forenklet gjennomgang. Si at 200 menn og 150 kvinner søker på en teknikerstilling. Påvirkningsforholdet er 20/30, eller 0,67, godt under 0,80-terskelen. Å kjøre en tosample Z-test på disse tallene (begge grupper overskrider 30) vil fortelle deg om det 10-poengs gapet sannsynligvis skyldes tilfeldigheter eller gjenspeiler et strukturelt problem i selve vurderingen.
Å lese resultatene uten å overreagere eller underreagere
Et flagget forhold er et utgangspunkt for undersøkelse, ikke et automatisk funn av diskriminering, og et rent forhold garanterer ikke at prosessen din er rettferdig. Små søkerpooler forvrenger både fire-femtedels-forholdet og signifikanstester: en håndfull ansettelser kan svinge en utvelgelsesrate med 10 eller 15 prosentpoeng, så én enkelt ansettelsessyklus forteller sjelden hele historien på egen hånd.
Se opp for disse vanlige feiltrinnene:
- Testing av dusinvis av undergrupper uten å justere alfa-nivået, noe som øker oddsen for en falsk positiv et sted i dataene rent ved tilfeldighet.
- Ignorering av konfidensintervaller og behandling av et grensetilfelle-forhold som definitivt greit eller definitivt ødelagt.
- Overreagere på ett dårlig kvartal i stedet for å slå sammen flere ansettelsessykluser for å se om mønsteret holder seg.
- Underreagere på et «bestått» fire-femtedels-forhold som skjuler en statistisk signifikant Z-score, siden de to målene svarer på ulike spørsmål.
Hver signifikanstest innebærer en avveining mellom Type I-feil (flagging av en rettferdig prosess som partisk) og Type II-feil (å gå glipp av en genuint partisk prosess). Et strengere alfa reduserer falske alarmer, men gjør det lettere for reelle forskjeller å gli gjennom i mindre utvalg, noe som er nøyaktig grunnen til at regulatorer lener seg på Fishers eksakte test i stedet for en Z-test når gruppestørrelsene er små.
Pro-tips: Slå sammen minst to eller tre ansettelsessykluser før du bestemmer deg for om en forskjell er reell. Ett avvikende kvartal med 12 søkere kan produsere et dramatisk utseende forhold som forsvinner når du legger til de neste 200 kandidatene i datasettet.
Når et resultat passerer både fire-femtedels-terskelen og en signifikanstest på tvers av flere sykluser, er det din signal om å gå videre til validering eller pilotere en erstatning – ikke bare overvåke og håpe at det korrigerer seg selv.
Å fikse rekrutteringsprosessen: Jobbanalyse, strukturerte intervjuer og bedre vurderinger
Tiltak fungerer best når de starter før du noen gang publiserer en stilling, ikke etter at analyse av negativ påvirkning avdekker et problem.
- Start med en jobbanalyse. Definer de faktiske oppgavene og kompetansene rollen krever før du velger eller bygger noen test. En generisk kognitiv evnetest for en dataregistreringsstilling inviterer til forskjeller som en oppgavebasert skrive- og nøyaktighetstest ville unngå.
- Foretrekk oppgavebaserte, rollespesifikke vurderinger fremfor brede screeningverktøy. Strukturerte, jobbrelevante tester som speiler faktiske joboppgaver har en tendens til å produsere mindre gruppeforskjeller enn abstrakte evnetester, og predikerer samtidig ytelse godt.
- Bruk strukturerte intervjuer med faste spørsmål og poenggivingsrubrikker. Ustrukturerte intervjuer – der hver intervjuer spør om hva som faller dem inn – er der subjektiv skjevhet sniker seg inn hardest.
- Bygg scorekort og tren bedømmere til å kalibrere mot dem. To intervjuere som vurderer det samme svaret bør lande innenfor ett poeng av hverandre, ikke tre poeng fra hverandre.
- Pilot alternativer når et verktøy flagger negativ påvirkning. UGESP krever at arbeidsgivere evaluerer egnede alternativer og adopterer det med vesentlig lik gyldighet og mindre påvirkning.
Pro-tips: Ikke avvikl en vurdering bare fordi den viser en forskjell. Sammenlign dens gyldighet mot den foreslåtte erstatningen først. Å bytte ut en godt validert test mot en utestet kan bytte ut en juridisk risiko mot en dårlig-ansettelse-risiko.
Strukturerte, oppgavebaserte screeningverktøy kartlagt direkte til jobbkompetanser overgår konsekvent generiske screeningverktøy på både rettferdighet og prediktiv nøyaktighet – i stor grad fordi de måler hva jobben faktisk krever i stedet for et substitutt for det.
Validering og journalføring: Hva UGESP forventer at du oppbevarer
UGESP krever en valideringsstudie når analyse av negativ påvirkning krysser statistiske og praktiske terskler, og retningslinjene anerkjenner tre typer bevis: innholdsgyldighet (testen speiler joboppgaver direkte), kriteriumrelatert gyldighet (score korrelerer med faktisk arbeidsytelse), og konstruktgyldighet (testen måler en underliggende egenskap knyttet til suksess i jobben).
Lokal validering – en studie kjørt på din egen søkerpopulasjon – har størst tyngde. Transportert gyldighet, der du baserer deg på en valideringsstudie fra en lignende jobb andre steder, er akseptabelt når rollene og omgivelsene er genuint sammenlignbare, men regulatorer gransker tilpasningen nøye.
Hold disse registrene på fil og klar for revisjon:
- Søkerstrømdata brutt ned etter beskyttet gruppe, for hver utlysning
- Utvelgelsesrater og beregninger av påvirkningsforhold for hver ansettelsessyklus
- Eventuell valideringsstudiedokumentasjon, inkludert metodologi og resultater
- Leverandørmateriale som beskriver hvordan en innkjøpt vurdering ble bygget og validert
CFR §1607.4 beskriver journalføringsforventninger knyttet direkte til håndhevelse av fire-femtedels-regelen. Behandle disse registrene slik du ville behandlet skattedokumenter: oppbevart i årevis, organisert etter syklus, og klar til å overleveres med kort varsel.
Å holde AI- og algoritmiske screeningverktøy i sjakk
En algoritme får ikke fritak bare fordi et menneske ikke skrev scoringsreglene for hånd. EEOCs tekniske veiledning er eksplisitt på at det ikke finnes noe algoritmisk unntak. Programvare, CV-rangeringsverktøy og AI-drevne screeningverktøy må oppfylle den samme standarden for jobberelaterte krav og validering som en papir-og-blyant-test fra 1985.
Bygg en overvåkingsrutine, ikke en engangssjekk:
- Kjør påvirkningsforhold og signifikanstester på nytt hver ansettelsessyklus eller hvert kvartal, avhengig av hva som kommer først
- Spor utvelgelsesrater etter beskyttet gruppe på hvert trinn verktøyet berører, ikke bare den endelige avgjørelsen
- Spør leverandører direkte om deres valideringsbevis, en beskrivelse av treningsdataene deres, og eventuell rettferdighetstesting de har kjørt
- Ha en utbedringsvei klar: modelljusteringer, økt menneskelig gjennomgang, eller bytte til en alternativ vurdering
Pro-tips: Be om en leverandørs dokumentasjon om negativ påvirkning før du skriver under, ikke etter ditt første flaggede kvartal. Løpende tilsyn med AI-screeningverktøy fungerer langt bedre som en fast praksis enn som et hastverk.
En praktisk sjekkliste for å bygge mer rettferdige vurderinger
Rettferdig testing starter med design, ikke skadekontroll. Kartlegg joboppgaver til testinnhold, bygg oppgaver rundt disse, pilot med et reelt søkereutvalg, mål påvirkningsforhold, og valider eller revider før full utrulling.
- Kartlegg kjerneoppgaver i jobben før du skriver ett eneste spørsmål
- Bygg oppgavebaserte elementer, ikke generiske evnespørsmål
- Pilot med et representativt søkerutvalg
- Mål påvirkningsforhold og signifikans før full distribusjon
- Valider eller iterer basert på hva piloten viser
Juksesikringstiltak og AI-genererte scoringsoppsummeringer fremskynder denne syklusen betraktelig. Når alle kandidater tar den samme oppgavebaserte testen under de samme overvåkede forholdene, og hvert resultat leveres med en dokumentert begrunnelse, får du renere data for beregninger av påvirkningsforhold og et papirspor klart for en revisjon.
Hvordan testing av negativ påvirkning ser ut på tvers av bransjer
Mekanismen er den samme overalt, men verktøyene som utløser granskning varierer etter sektor. I produksjon og logistikk har fysiske evnetester og styrketester historisk sett produsert noen av de største kjønnsforskjellene, noe som har fått mange arbeidsgivere til å gå over til oppgavesimuleringstester som speiler den faktiske løftingen eller bevegelsen som kreves, i stedet for rene styrke-benchmarks.
I teknologi og finans er det kognitive evnetester og kodetester som tiltrekker seg størst oppmerksomhet. En generisk logikkpusle-test kan produsere forskjeller etter rase eller nasjonal opprinnelse som en rollespesifikk kodeutfordring – vurdert mot det faktiske språket og oppgavestakken jobben bruker – ofte innsnevrer betraktelig.
Ansettelse i detaljhandel og gjestfrihet lener seg tungt på strukturerte intervjuer og personlighetsvurderinger, der ustrukturerte, løse intervjuformater forblir en av de vanligste kildene til bedømmerdreven forskjell. Helsevesenssystemer tester i økende grad lisens-tilknyttede ferdigheter (nøyaktighet i pasientjournalføring, medikamentmatte) heller enn bred evne, i stor grad fordi disse oppgavebaserte målene holder seg bedre under både gyldighets- og negativ påvirkning-gjennomgang.
Offentlig sektor og ansettelse hos regjeringsentreprenører er underlagt den strengeste granskningen av alle, siden OFCCP-samsvarsvurderinger rutinemessig henter ut søkerstrømdata og kjører Z-testen på nytt uavhengig. Enhver arbeidsgiver med føderale kontrakter bør anta at tallene deres vil bli omberegnet av noen utenfor bygningen.
Hvor testing av negativ påvirkning kommer til kort
Fire-femtedels-regelen og signifikanstesting er nyttige verktøy, men har begrensninger. Begge metodene deler en strukturell svakhet: de måler utfall på gruppenivå, noe som betyr at de kan gå fullstendig glipp av urettferdighet på individnivå – eller flagge en forskjell som ikke har noe med selve testen å gjøre og alt å gjøre med en ikke-representativ søkerpool.
Utvalgsstørrelse virker begge veier. For få søkere i en gruppe og fire-femtedels-forholdet svinger villsomt på én eller to ansettelser. Fishers eksakte test håndterer små utvalg bedre enn en Z-test-tilnærming, men selv det kan ikke produsere statistisk styrke fra en pool med åtte søkere. I den andre enden kan meget store søkerpooler produsere en statistisk signifikant Z-score for et gap så lite at det ikke har noen praktisk betydning for noen karriereutfall.
Datakvalitet er sitt eget svake punkt. Selvrapporterte demografiske data har hull og uoverensstemmelser. Flertrinns ansettelsesprosesser gjør det lett å miste oversikten over hvilke kandidater som falt fra frivillig kontra hvilke som ble silt ut av verktøyet du tester. Og testing av dusinvis av jobbkategorier eller lokasjoner på én gang, uten å justere for multiple sammenligninger, øker oddsen for at noe ser flagget ut rent ved tilfeldighet.
Ingen av disse tingene gjør metodologien ubrukelig. Det betyr at testing av negativ påvirkning er ett innspill i en skjønnsmessig vurdering, ikke en formel som alene spytter ut en ren bestått eller stryk.
Å bygge kontroller for negativ påvirkning inn i løpende styring
Den største feilen jeg ser er å behandle dette som en engangsrevisjon i stedet for en fast disiplin. Kjør forholdene én gang, fiks den flaggede testen, gå videre, og det samme gapet dukker ofte opp igjen to ansettelsessykluser senere i en litt annen drakt. Bygg det inn i kvartalsvise gjennomganger, tren ansettelsesledere til å oppdage advarselstegn før HR må fange dem opp i etterkant, og ha juridisk, HR og analyse i samme rom når et tall beveger seg. Eierskap delt mellom tre avdelinger uten et felles dashboard er måten forskjeller forblir ubemerket i årevis.
— Jimmie
Bygg mer rettferdige tester raskere med Talent Approved
Talent Approved tilbyr verktøy for å hjelpe med å opprette oppgavebaserte vurderinger raskt, noe som kan være nyttig når analyse av negativ påvirkning indikerer et behov for å pilotere et alternativ umiddelbart. Funksjonen Magic Create bygger rollespesifikke tester direkte fra en stillingsbeskrivelse eller ferdighetsliste – den typen oppgavekartlagte vurderinger denne guiden anbefaler fremfor generiske kognitive screeningverktøy.
Innebygd overvåking og AI-genererte ytelsesoppsummeringer tar sikte på å gi rene, dokumenterte scoringsdata nyttige for valideringsstudier eller gjennomganger. Det dokumentasjonssporet – knyttet direkte til tiltaksstegene som er dekket ovenfor – er ofte forskjellen mellom et raskt samsvarsvar og et hastverk gjennom gamle regneark. Hvis ditt nåværende screeningverktøy noen gang har gjort deg nervøs for utvelgelsesratene på tvers av grupper, start å bygge en rollespesifikk vurdering på Talent Approved og se hvor raskt en mer rettferdig test kan komme sammen.
Kilder
- Ansettelsestester og utvelgelsesprosedyrer | EEOC
- CFR §1607.4 — Diskriminering definert: Forholdet mellom bruk av utvelgelsesprosedyrer og diskriminering
FAQ
Hva er forskjellen mellom negativ påvirkning og ulik behandling?
Negativ påvirkning er en statistisk forskjell i utfall på tvers av beskyttede grupper fra en nøytral prosedyre, mens ulik behandling krever bevis for bevisst diskriminering mot en bestemt person eller gruppe.
Hva er fire-femtedels-regelen i ansettelsestesting?
Den flaggerer et mulig problem når en beskyttet gruppes utvelgelsesrate faller under 80 % av gruppen med høyest utvelgelsesrate, selv om EEOCs veiledning behandler den som et screeningverktøy, ikke en juridisk absolutt.
Når bør jeg bruke en Z-test kontra Fishers eksakte test?
Bruk den tosample binomiale Z-testen når hver gruppe har 30 eller flere søkere; bruk Fishers eksakte test for mindre utvalg, der store-utvalgs-tilnærminger blir upålitelige.
Trenger AI-ansettelsesverktøy også testing av negativ påvirkning?
Ja. EEOC har klargjort at det ikke finnes noe unntak for algoritmiske verktøy fra analyse av negativ påvirkning, så programvare og AI-drevne screeningverktøy må testes og valideres på samme måte som tradisjonelle vurderinger.
Hva skjer hvis vurderingen min viser negativ påvirkning?
Du må vise at prosedyren er jobberelatert og i tråd med forretningsmessig nødvendighet, eller adoptere et mindre diskriminerende alternativ med sammenlignbar gyldighet, og plattformer som Talent Approved kan hjelpe deg med å pilotere og dokumentere det alternativet raskt.