
US HR-handbok för Adverse Impact-testning: Kör, Läs, Åtgärda
Om din rekryteringsprocess ger en märkbart lägre urvalsfrekvens för någon skyddad grupp jämfört med din grupp med högst poäng, har du en signal som är värd att undersöka. Kör impaktkvoten och ett signifikanstest (med lämpliga metoder för större eller mindre urval) innan du fattar ytterligare ett anställningsbeslut med den proceduren. Om något av dem indikerar ett problem, validera bedömningen enligt UGESP eller byt till ett mindre diskriminerande alternativ som förutsäger jobbprestanda på ett jämförbart sätt.
Sammanfattning:
- Negativ påverkan kan uppstå även med neutrala urvalsprocedurer som tester eller intervjuer och kan producera statistiskt signifikanta skillnader utan avsiktlig diskriminering.
- Att validera bedömningar innebär att beräkna urvalsfrekvenser, impaktkvoter under 0,80 och genomföra signifikanstest med lämpliga urvalsstorlekar, samt att samla data från flera anställningscykler för noggrannhet.
- Organisationer måste föra detaljerade register över sökandedata, valideringsarbete och konsekvensanalyser för att följa UGESP och förbereda sig för revisioner, särskilt för federala entreprenörer.
- Uppgiftsspecifika, rollbaserade bedömningar och strukturerade intervjuer minskar skillnaderna bättre än generella screeningar, särskilt när de utformas med jobbanalys i förväg.
- Kontinuerlig övervakning av impaktkvoter och AI-verktyg, med leverantörsvalidering, är avgörande för att upprätthålla rättvisa anställningsrutiner och undvika återkommande skillnader över tid.
Innehållsförteckning
- Vad testning av negativ påverkan faktiskt mäter
- Hur man räknar: urvalsfrekvenser, impaktkvoter och signifikanstest
- Att tolka resultaten utan att överreagera eller underreagera
- Att åtgärda pipeline: jobbanalys, strukturerade intervjuer och bättre bedömningar
- Validering och dokumentation: vad UGESP förväntar sig att du sparar
- Att hålla AI- och algoritmiska screeningverktyg under kontroll
- En praktisk checklista för att bygga rättvisare bedömningar
- Hur testning av negativ påverkan ser ut i olika branscher
- Var testning av negativ påverkan brister
- Att integrera kontroller av negativ påverkan i löpande styrning
- Bygg rättvisare tester snabbare med Talent Approved
- Källor
- Vanliga frågor
Vad testning av negativ påverkan faktiskt mäter
Negativ påverkan är ett statistiskt utfall, inte ett motiv. Det uppstår när en till synes neutral urvalsprocedur – ett kognitivt test, ett intervjuprotokoll, en granskning av CV – ger meningsfullt olika godkännandefrekvenser för olika grupper baserat på ras, kön, ålder eller andra skyddade egenskaper, oavsett vad någon avsett. Den skillnaden separerar det från avsiktlig diskriminering, som kräver bevis på att någon avsiktligt behandlades annorlunda. Analys av negativ påverkan ställer en kyligare fråga: landade siffrorna ojämnt, och i så fall varför?
Den rättsliga grunden kommer från tre ställen. Avdelning VII i medborgarrättslagen (Title VII of the Civil Rights Act) förbjuder anställningsmetoder som oproportionerligt gallrar bort en skyddad grupp om inte arbetsgivaren kan motivera metoden. Uniform Guidelines on Employee Selection Procedures (UGESP), gemensamt antagna av federala myndigheter 1978, specificerar hur arbetsgivare bör utvärdera sina urvalsverktyg och när de är skyldiga att tillhandahålla en valideringsstudie till myndigheterna. EEOC verkställer Title VII och utfärdar tolkningsvägledning, medan OFCCP tillämpar parallella standarder för federala entreprenörer och ofta genomför statistisk testning under efterlevnadsgranskningar.
Validering utlöses i det ögonblick analysen av negativ påverkan avslöjar en skillnad som överstiger tröskelvärdena för statistisk och praktisk signifikans. Vid den punkten är EEOC:s vägledning tydlig: arbetsgivaren måste visa att proceduren är jobbanknutet och förenlig med affärsmässig nödvändighet, eller övergå till ett mindre diskriminerande alternativ.
Federal lag skyddar dessa grupper i samband med anställningstestning:
- Ras och hudfärg
- Kön, inklusive graviditet och könsidentitet
- Nationellt ursprung
- Religion
- Ålder (40 år och äldre, enligt ADEA)
- Funktionshinderstatus (ADA)
Var och en av dessa kategorier behöver sin egen jämförelse av urvalsfrekvenser. Att slå ihop dem, eller kontrollera enbart ras och hoppa över ålder, är hur skillnader förblir oupptäckta tills ett klagomål hamnar på ditt skrivbord.
Hur man räknar: urvalsfrekvenser, impaktkvoter och signifikanstest
Att testa för partiskhet i din rekryteringspipeline följer en fast sekvens. Hoppar du över ett steg missar du antingen ett verkligt problem eller jagar ett som inte finns.
- Beräkna urvalsfrekvensen för varje grupp. Dela antalet valda med antalet sökande i den gruppen. Om 80 kvinnor sökte och 20 anställdes är urvalsfrekvensen 25 %.
- Identifiera gruppen med högst urvalsfrekvens. Denna blir din jämförelsebaseline, oavsett gruppstorleken.
- Beräkna impaktkvoten. Dela varje grupps urvalsfrekvens med baslinjegruppen. En kvot under 0,80 utlöser fyrafemtedelsregeln.
- Kör ett signifikanstest. För urval med 30 eller fler per grupp, använd det tvåsidiga binomiala Z-testet. För mindre urval, använd Fishers exakta test, som inte förlitar sig på approximationer för stora urval.
- Tolka mot din alfanivå. De flesta praktiker använder en alfanivå som representerar cirka 95 % konfidens, även om vissa myndigheter tillämpar striktare tröskelvärden för tvåsidiga jämförelser.
Statistisk notering: OFCCP behandlar ett absolut Z-värde vid ett tröskelvärde som anses statistiskt signifikant ungefär motsvarande en 95-procentig konfidensnivå, vilket i stort sett överensstämmer med ett 95 % konfidensintervall. Det är det talet, inte bara fyrafemtedelskvoten, som en federal efterlevnadstjänsteman faktiskt beräknar under en revision.
Fyrafemtedelsregeln är ett screeningverktyg, inte en dom. EEOC:s vägledning beskriver den som en tumregel som myndigheter tillämpar med diskretion. En kvot på 0,79 i en pool med sex sökande betyder nästan ingenting statistiskt. En kvot på 0,83 bland 4 000 sökande kan ändå representera en verklig, signifikant skillnad. Regeln pekar ut var man ska titta. Z-testet eller Fishers exakta test berättar om det du tittar på är brus.
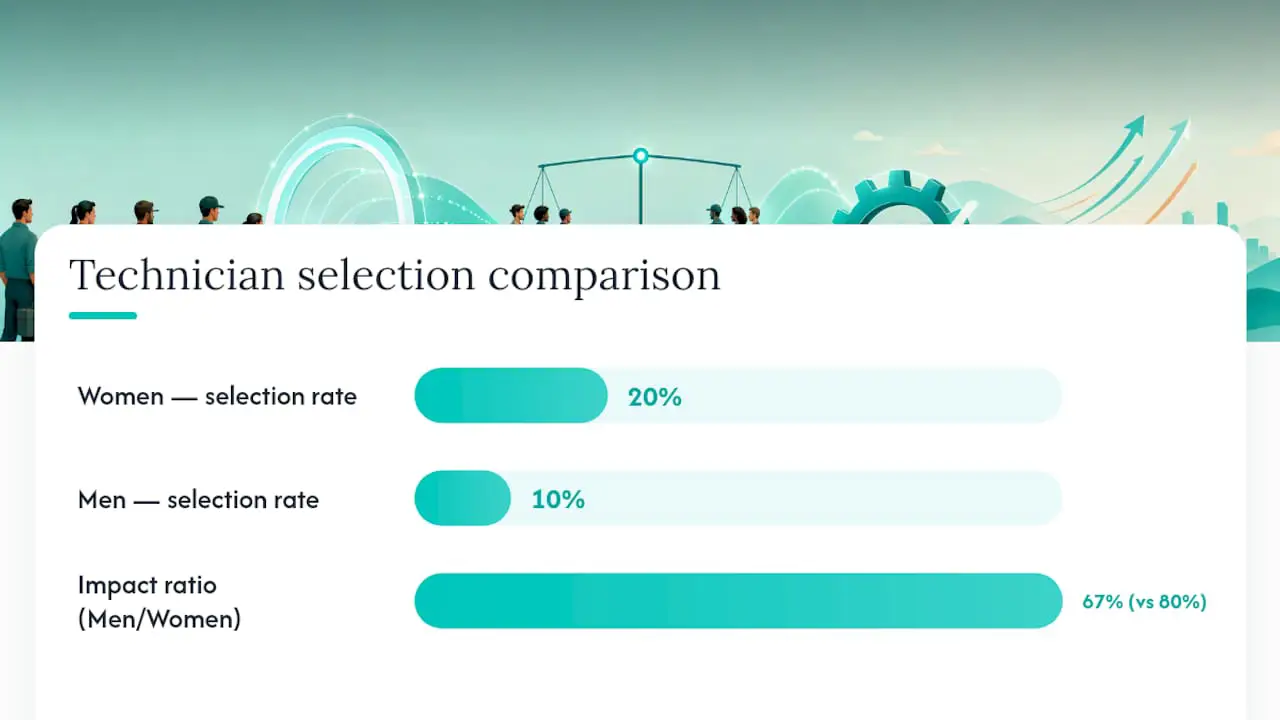
Här är ett förenklat genomgång. Säg att 200 män och 150 kvinnor söker en teknikertjänst. Impaktkvoten är 20/30, eller 0,67, väl under tröskelvärdet på 0,80. Att köra ett tvåsidigt Z-test på dessa siffror (båda grupper överstiger 30) skulle berätta om det 10-procentiga gapet troligen beror på slumpen eller om det återspeglar ett strukturellt problem i bedömningen.
Att tolka resultaten utan att överreagera eller underreagera
En flaggad kvot är en startpunkt för undersökning, inte ett automatiskt konstaterande av diskriminering, och en ren kvot garanterar inte att din process är rättvis. Små sökandegrupper snedvrider både fyrafemtedelskvoten och signifikanstesten: ett fåtal anställningar kan svänga en urvalsfrekvens med 10 eller 15 procentenheter, så en enda anställningscykel berättar sällan hela historien på egen hand.
Var uppmärksam på dessa vanliga misstag:
- Att testa dussintals undergrupper utan att justera din alfa, vilket ökar sannolikheten för ett falskt positivt resultat någonstans i data enbart av slumpen.
- Att ignorera konfidensintervall och behandla en gränskvot som definitivt fin eller definitivt trasig.
- Att överreagera på ett dåligt kvartal istället för att samla data från flera anställningscykler för att se om mönstret håller.
- Att underreagera på en "godkänd" fyrafemtedelskvot som döljer ett statistiskt signifikant Z-värde, eftersom de två måtten besvarar olika frågor.
Varje signifikanstest innebär en avvägning mellan Typ I-fel (att flagga en rättvis process som partisk) och Typ II-fel (att missa en genuint partisk sådan). En striktare alfa minskar falskt larm men gör det lättare för verkliga skillnader att slinka igenom i mindre urval, vilket är exakt varför regulatorer föredrar Fishers exakta test framför ett Z-test när gruppstorlekarna är små.
Tips: Samla data från minst två eller tre anställningscykler innan du avgör om en skillnad är verklig. Ett enstaka avvikande kvartal med 12 sökande kan ge ett dramatiskt utseende kvot som försvinner när du lägger till de nästa 200 kandidaterna i datamängden.
När ett resultat klarar både fyrafemtedelströskeln och ett signifikanstest över flera cykler, är det din signal att gå vidare till validering eller pilotera en ersättning – inte bara övervaka och hoppas att det korrigeras av sig självt.
Att åtgärda pipeline: jobbanalys, strukturerade intervjuer och bättre bedömningar
Åtgärder fungerar bäst när de börjar innan du någonsin publicerar en tjänst, inte efter att analysen av negativ påverkan avslöjar ett problem.
- Börja med en jobbanalys. Definiera de faktiska uppgifter och kompetenser som rollen kräver innan du väljer eller bygger något test. En generisk kognitiv screeningbedömning för en datainmatningsroll inbjuder till skillnader som ett uppgiftsbaserat skrivnings- och noggrannhetstest skulle undvika.
- Föredra uppgiftsbaserade, rollspecifika bedömningar framför breda screeningar. Strukturerade, jobbanknutna tester som speglar faktiska arbetsuppgifter tenderar att ge mindre gruppskillnader än abstrakta färdighetstester, och förutsäger ändå prestanda väl.
- Använd strukturerade intervjuer med fasta frågor och bedömningskriterier. Ostrukturerade intervjuer – där varje intervjuare frågar vad som faller dem in – är där subjektiv partiskhet smyger in som hårdast.
- Bygg poängsättningskort och träna bedömare att kalibrera mot dem. Två intervjuare som poängsätter samma svar bör landa inom ett poäng från varandra, inte tre.
- Pilotera alternativ när ett verktyg flaggar negativ påverkan. UGESP kräver att arbetsgivare utvärderar lämpliga alternativ och antar det med i princip likvärdig validitet och lägre påverkan.
Tips: Pensionera inte en bedömning bara för att den visar en skillnad. Jämför dess validitet mot den föreslagna ersättaren först. Att byta ett välvaliderat test mot ett oprövat kan byta en juridisk risk mot en dålig-anställning-risk.
Strukturerade, uppgiftsbaserade screeningverktyg mappade direkt till jobbkompetenser presterar konsekvent bättre än generiska screeningar vad gäller både rättvisa och prediktiv noggrannhet, till stor del för att de mäter vad jobbet faktiskt kräver snarare än ett substitut för det.
Validering och dokumentation: vad UGESP förväntar sig att du sparar
UGESP kräver en valideringsstudie när analysen av negativ påverkan överstiger statistiska och praktiska tröskelvärden, och riktlinjerna erkänner tre typer av bevis: innehållsvaliditet (testet speglar direkt arbetsuppgifter), kriterievaliditet (poäng korrelerar med faktisk jobbprestanda) och konstruktvaliditet (testet mäter en underliggande egenskap kopplad till framgång i jobbet).
Lokal validering – en studie genomförd på din egen sökandegrupp – väger tyngst. Transporterad validitet, där du förlitar dig på en valideringsstudie från ett liknande jobb någon annanstans, är acceptabel när rollerna och miljöerna är genuint jämförbara, men regulatorer granskar lämpligheten noga.
Behåll dessa register tillgängliga och revisionsklara:
- Sökandeflödesdata uppdelade per skyddad grupp, för varje rekvisition
- Urvalsfrekvenser och impaktkvotsberäkningar för varje anställningscykel
- All dokumentation från valideringsstudier, inklusive metodik och resultat
- Leverantörsmaterial som beskriver hur en inköpt bedömning byggdes och validerades
CFR §1607.4 beskriver dokumentationskrav direkt kopplade till verkställandet av fyrafemtedelsregeln. Behandla dessa register på samma sätt som du behandlar skattedokument: sparade i år, organiserade per cykel och redo att lämnas över med kort varsel.
Att hålla AI- och algoritmiska screeningverktyg under kontroll
En algoritm slipper inte undan bara för att en människa inte skrivit poängreglerna för hand. EEOC:s tekniska vägledning är tydlig om att det inte finns något algoritmiskt undantag. Programvara, rankningsverktyg för CV och AI-driven screening måste uppfylla samma krav på jobbankytning och validering som ett papper-och-penna-test från 1985.
Bygg en övervakningsrutin, inte en engångskontroll:
- Kör om impaktkvoter och signifikanstest varje anställningscykel eller kvartal, beroende på vilket som inträffar först
- Spåra urvalsfrekvenser per skyddad grupp i varje steg som verktyget berör, inte bara det slutliga beslutet
- Fråga leverantörer direkt om deras valideringsbevis, en beskrivning av deras träningsdata och eventuella rättvisetester de genomfört
- Ha en åtgärdsväg redo: modelljusteringar, utökad mänsklig granskning eller byte till en alternativ bedömning
Tips: Begär en leverantörs dokumentation om negativ påverkan innan du skriver under, inte efter ditt första flaggade kvartal. Löpande tillsyn av AI-screeningverktyg fungerar mycket bättre som en stående praxis än som en panikåtgärd.
En praktisk checklista för att bygga rättvisare bedömningar
Rättvis testning börjar med design, inte skadekontroll. Mappa arbetsuppgifter till testinnehåll, bygg frågor kring dessa uppgifter, pilotera med ett verkligt sökandeunderlag, mät impaktkvoter och validera eller revidera sedan innan fullständig lansering.
- Mappa kärnarbetsuppgifter innan du skriver en enda fråga
- Bygg uppgiftsbaserade frågor, inte generiska färdighetsfrågor
- Pilotera med ett representativt sökandeunderlag
- Mät impaktkvoter och signifikans innan fullständig lansering
- Validera eller iterera baserat på vad pilottestet visar
Fuskskydd och AI-genererade bedömningssammanfattningar påskyndar denna cykel avsevärt. När varje kandidat genomför samma uppgiftsbaserade test under samma övervakade förhållanden, och varje poäng åtföljs av ett dokumenterat resonemang, får du renare data för impaktkvotsberäkningar och ett pappersspår redo för en revision.
Hur testning av negativ påverkan ser ut i olika branscher
Mekaniken är densamma överallt, men de verktyg som utlöser granskning skiftar beroende på sektor. Inom tillverkning och logistik har fysiska förmågestester och styrketester historiskt sett producerat några av de största könsrelaterade skillnaderna, vilket har fått många arbetsgivare att gå över till uppgiftssimuleringstester som speglar det faktiska lyftandet eller rörelserna som krävs, snarare än råa styrkeriktmärken.
Inom teknik och finans är det kognitiva förmågetester och kodningsbedömningar som drar mest granskning. Ett generiskt logikpussel-test kan ge skillnader baserade på ras eller nationellt ursprung som en rollspecifik kodningsutmaning – bedömd mot det faktiska programspråket och den uppgiftsstapel som jobbet använder – ofta minskar avsevärt.
Rekrytering inom detaljhandel och gästfrihet lutar sig starkt mot strukturerade intervjuer och personlighetsbedömningar, där ostrukturerade, fria intervjuformat förblir en av de vanligaste källorna till bedömarstyrd ojämnhet. Sjukvårdssystem testar i allt högre grad licensieringsanknutna färdigheter (noggrannhet vid patientjournaläring, medicineringskalkyl) snarare än bred förmåga, till stor del för att dessa uppgiftsbaserade mått håller sig bättre under både validitets- och negativ-påverkan-granskning.
Offentlig sektor och rekrytering hos statliga entreprenörer utsätts för den hårdaste granskningen av alla, eftersom OFCCP:s efterlevnadsgranskningar rutinmässigt hämtar sökandeflödesdata och kör om Z-testet självständigt. Alla arbetsgivare med federala kontrakt bör anta att deras siffror kommer att omberäknas av någon utanför organisationen.
Var testning av negativ påverkan brister
Fyrafemtedelsregeln och signifikanstestning är användbara verktyg men har begränsningar. Båda metoderna delar en strukturell svaghet: de mäter utfall på gruppnivå, vilket innebär att de kan missa orättvisa på individnivå helt och hållet, eller flagga en skillnad som inte har något att göra med testet i sig utan allt med en icke-representativ sökandegrupp.
Urvalsstorlek skär åt båda håll. För få sökande i en grupp och fyrafemtedelskvoten svänger kraftigt på en eller två anställningar. Fishers exakta test hanterar små urval bättre än ett Z-test-approximation, men även det kan inte tillverka statistisk styrka från en pool med åtta sökande. I den andra extremen kan mycket stora sökandegrupper ge ett statistiskt signifikant Z-värde för ett gap så litet att det saknar praktisk betydelse för någons karriärresultat.
Datakvalitet är en egen svag punkt. Självrapporterade demografiska data har luckor och inkonsekvenser. Flerstegiga rekryteringspipelines gör det lätt att tappa bort vilka kandidater som hoppade av frivilligt kontra vilka som gallrades bort av verktyget du testar. Och att testa dussintals jobbkategorier eller platser på en gång, utan att justera för multipla jämförelser, ökar sannolikheten för att något ser flaggat ut rent av slumpen.
Inget av detta gör metoden oanvändbar. Det innebär att testning av negativ påverkan är ett inslag i en bedömning, inte en formel som av sig självt spottar ut ett rent godkänt eller underkänt resultat.
Att integrera kontroller av negativ påverkan i löpande styrning
Det största misstaget jag ser är att behandla detta som en engångsrevision istället för en stående disciplin. Kör kvoten en gång, åtgärda det flaggade testet, gå vidare, och samma gap dyker ofta upp igen två anställningscykler senare i en något annorlunda skepnad. Bygg in det i kvartalsvisa genomgångar, träna rekryteringschefer att upptäcka varningssignaler innan HR behöver fånga dem efter faktumet, och samla juridik, HR och analys i samma rum när ett tal rör sig. Ägarskap splittrat över tre avdelningar utan gemensam dashboard är hur skillnader kvarstår i år oupptäckta.
— Jimmie
Bygg rättvisare tester snabbare med Talent Approved
Talent Approved erbjuder verktyg för att snabbt skapa uppgiftsbaserade bedömningar, vilket kan vara användbart när analysen av negativ påverkan indikerar ett behov av att pilotera ett alternativ snabbt. Funktionen Magic Create bygger rollspecifika tester direkt från en jobbeskrivning eller kompetenslista – den typ av uppgiftsmappad bedömning som den här guiden rekommenderar framför generiska kognitiva screeningar.
Inbyggd övervakning och AI-genererade prestationssammanfattningar syftar till att ge ren, dokumenterad poängsättningsdata som är användbar för valideringsstudier eller genomgångar. Det dokumentationsspåret – direkt kopplat till de åtgärdssteg som behandlas ovan – är ofta skillnaden mellan ett snabbt efterlevnadssvar och att stressigt leta igenom gamla kalkylblad. Om ditt nuvarande screeningverktyg någonsin fått dig att oroa dig för dess urvalsfrekvenser mellan grupper, börja bygga en rollspecifik bedömning på Talent Approved och se hur snabbt ett rättvisare test tar form.
Källor
- Anställningstester och urvalsprocedurer | EEOC
- CFR §1607.4 — Diskriminering definierad: Förhållandet mellan användning av urvalsprocedurer och diskriminering
Vanliga frågor
Vad är skillnaden mellan negativ påverkan och avsiktlig diskriminering?
Negativ påverkan är en statistisk skillnad i utfall mellan skyddade grupper till följd av en neutral procedur, medan avsiktlig diskriminering kräver bevis på uppsåtlig diskriminering mot en specifik person eller grupp.
Vad är fyrafemtedelsregeln inom anställningstestning?
Den flaggar ett möjligt problem när en skyddad grupps urvalsfrekvens faller under 80 % av den grupp som har högst urvalsfrekvens, även om EEOC:s vägledning behandlar den som ett screeningverktyg, inte som ett juridiskt absolut.
När ska jag använda ett Z-test jämfört med Fishers exakta test?
Använd det tvåsidiga binomiala Z-testet när varje grupp har 30 eller fler sökande; använd Fishers exakta test för mindre urval, där approximationer för stora urval blir otillförlitliga.
Behöver AI-baserade anställningsverktyg också testas för negativ påverkan?
Ja. EEOC har klargjort att det inte finns något undantag för algoritmiska verktyg från analys av negativ påverkan, så programvara och AI-driven screening måste testas och valideras på samma sätt som traditionella bedömningar.
Vad händer om min bedömning visar negativ påverkan?
Du måste visa att proceduren är jobbanknutet och förenlig med affärsmässig nödvändighet, eller anta ett mindre diskriminerande alternativ med jämförbar validitet, och plattformar som Talent Approved kan hjälpa dig att snabbt pilotera och dokumentera det alternativet.