
Emplois nécessitant le souci du détail : les évaluations qui le prédisent vraiment
Le meilleur prédicteur de la performance en matière d'attention aux détails n'est pas un questionnaire de personnalité ni un exercice chronométré de repérage de motifs. C'est un test d'aptitude cognitive validé associé à un échantillon de travail spécifique au poste contenant des erreurs intentionnellement intégrées, complété par des questions d'entretien comportemental structuré. Les échantillons de travail affichent une validité méta-analytique d'environ r = ,54 pour prédire la performance professionnelle, et l'Attention to Detail Test (ADT) fournit des preuves basées sur la performance que ce type de test prédit les évaluations des superviseurs concernant les tâches axées sur le détail. Les tests axés uniquement sur la vitesse et les questionnaires d'autoévaluation ne résistent pas du tout aussi bien à l'analyse.
Voici la combinaison que nous recommandons pour évaluer les postes nécessitant une attention aux détails :
- Un test d'aptitude mentale générale (AMG) validé pour mesurer la capacité de raisonnement
- Un échantillon de travail spécifique au poste avec des erreurs délibérément intégrées, chronométré pour mesurer la précision plutôt que la vitesse
- Des questions d'entretien comportemental structuré liées à des incidents réels, et non des questions génériques d'autoévaluation
L'outil Magic Create de Talent Approved génère ces évaluations spécifiques au poste directement à partir d'une description de poste en quelques minutes, et sa surveillance anti-triche ainsi que ses résumés générés par IA accélèrent le processus d'examen sans sacrifier la rigueur.
Points clés à retenir
Une combinaison validée de tests d'aptitude cognitive, d'échantillons de travail spécifiques au poste contenant des erreurs intentionnelles et d'entretiens comportementaux structurés prédit la performance en matière d'attention aux détails de manière bien plus fiable que les tests de vitesse ou les questionnaires d'autoévaluation.
| Point | Détails |
|---|---|
| Éviter les tests axés uniquement sur la vitesse | Les puzzles de vitesse de traitement mesurent la rapidité de balayage, et non la détection d'erreurs réelles dans un contexte professionnel. |
| Les échantillons de travail dominent en termes de validité | Les échantillons de travail présentent une validité méta-analytique d'environ r = ,54, devançant légèrement les tests d'aptitude cognitive générale. |
| Évaluer à la fois le taux de détection et le taux de fausses alarmes | Un candidat qui signale trop de non-erreurs n'est pas plus rigoureux, il est simplement moins discriminant. |
| Effectuer un pilote avant de définir les seuils | Testez d'abord les titulaires de poste actuels pour établir des fourchettes réalistes de taux de détection plutôt que de deviner les seuils. |
| Créez des évaluations rapidement avec Talent Approved | Magic Create génère des tests spécifiques au poste à partir d'une description de poste, avec surveillance anti-triche et résumés IA intégrés. |
Table des matières
- Pourquoi les évaluations validées sont essentielles pour les postes nécessitant une attention aux détails
- Construire une combinaison d'évaluations qui fonctionne vraiment
- Comment concevoir des échantillons de travail spécifiques au poste avec des erreurs intentionnelles
- Des systèmes de notation qui distinguent les candidats rigoureux des chanceux
- Déployer les évaluations sans perdre en équité ni en cohérence
- Ce que les recruteurs font mal dans le recrutement axé sur l'attention aux détails
- Essayez un pilote spécifique au poste avec Talent Approved
- Sources
- FAQ
Pourquoi les évaluations validées sont essentielles pour les postes nécessitant une attention aux détails
Les recruteurs ont souvent le réflexe d'utiliser le premier test d'attention aux détails qui apparaît dans une recherche Google, et c'est une habitude coûteuse. Les recherches sur les méthodes de sélection sont sans ambiguïté : l'aptitude mentale générale prédit la performance professionnelle à environ r = ,51, et les échantillons de travail la surpassent légèrement à r = ,54, selon les travaux méta-analytiques de Schmidt et Hunter sur la validité des méthodes de sélection. Ces chiffres s'expliquent par le fait que les deux méthodes exigent des candidats qu'ils raisonnent véritablement à travers une tâche, plutôt que de simplement comparer deux images pour repérer une différence.
La compréhension est essentielle car la plupart des erreurs réelles ne sont pas visuelles, elles sont contextuelles. Une anomalie de facturation, une clause contractuelle non concordante ou un code d'expédition transposé nécessitent une compréhension du domaine, pas seulement un regard aiguisé. C'est précisément là que les tests basés sur la vitesse et les outils d'autoévaluation s'effondrent :
- Les tests de vitesse mesurent la rapidité à laquelle une personne balaie visuellement, ce que les praticiens notent comme une compétence différente de la détection d'une erreur substantielle sous une contrainte de temps réaliste
- Les questionnaires d'autoévaluation (« Êtes-vous axé sur les détails ? ») favorisent le biais de désirabilité sociale et corrèlent mal avec le comportement professionnel réel
- Les puzzles génériques de reconnaissance de motifs ressemblent rarement au contenu réel que les candidats auront à traiter dans leur poste
Construire une combinaison d'évaluations qui fonctionne vraiment
Aucun test unique ne capture l'attention aux détails à lui seul. Chaque composant d'une solide combinaison mesure quelque chose que les autres ne mesurent pas, et en omettre un laisse une lacune dans votre prédiction.
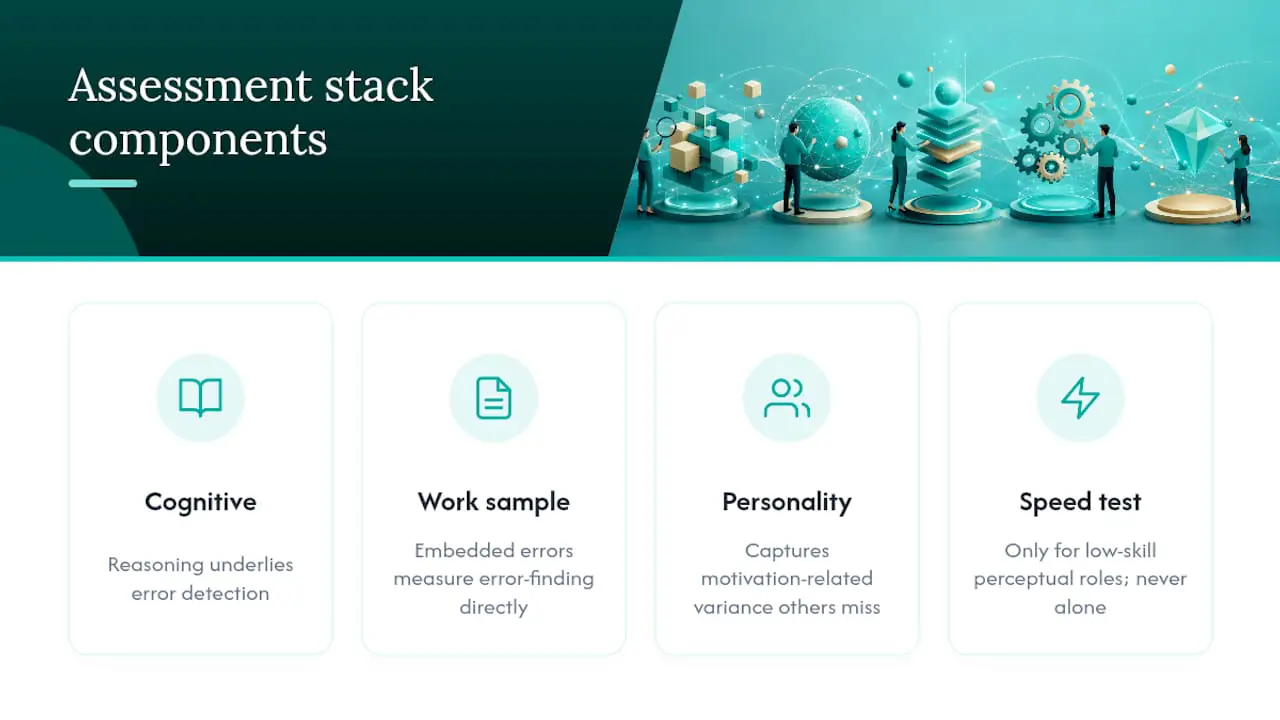
Le test d'aptitude cognitive vient en premier car le raisonnement est à la base de la détection des erreurs. Un candidat capable de maintenir plusieurs points de données en mémoire de travail tout en les comparant à un ensemble de règles surpassera celui qui se contente de rechercher des différences visuelles. Les scores cognitifs renforcent également la validité de l'échantillon de travail qui suit, car les candidats ont besoin d'une capacité de raisonnement de base pour interpréter correctement les instructions.
Les échantillons de travail avec des erreurs intégrées présentent la validité écologique la plus élevée de toutes les méthodes présentées ici, car ils mesurent directement le comportement cible plutôt qu'un indicateur de substitution. Un candidat au poste d'analyste financier qui examine une feuille de calcul contenant trois erreurs de formule intentionnellement intégrées vous en dit bien plus qu'un puzzle abstrait ne pourrait jamais le faire.
Les mesures de conscience professionnelle ou de personnalité ajoutent une couche plus petite mais réelle, en capturant la variance liée à la motivation que les tests cognitifs et les échantillons de travail n'expliquent pas entièrement. Un test de vitesse étroit n'est défendable que pour les postes perceptifs peu qualifiés, comme les tâches de tri de base ou le travail sur une chaîne d'inspection, et même dans ce cas, il ne devrait jamais être utilisé seul.
Conseil pratique : Associez chaque score cognitif ou d'échantillon de travail à une question comportementale structurée, comme « Parlez-moi d'une fois où vous avez détecté une erreur que quelqu'un d'autre avait manquée. » Cela fait remonter des incidents réels que vous pouvez vérifier, contrairement à une échelle d'autoévaluation.
Comment concevoir des échantillons de travail spécifiques au poste avec des erreurs intentionnelles
Créer un échantillon de travail qui prédit réellement la performance demande plus que d'insérer des fautes de frappe dans un document. Suivez cette séquence :
- Commencez par une analyse du poste. Identifiez les trois à cinq tâches où les erreurs ont le coût le plus élevé, et classifiez les types d'erreurs courants : omission, transposition, substitution ou violation de règle.
- Adaptez le format du stimulus au travail quotidien. Un poste en finance nécessite une feuille de calcul avec des erreurs de formule ; un poste en logistique nécessite un bordereau d'expédition ; un poste adjacent au droit nécessite un contrat avec des clauses modifiées.
- Intégrez délibérément un mélange de types d'erreurs, et non un seul motif répété. Les candidats qui ne voient qu'un seul type d'erreur peuvent obtenir un score élevé par reconnaissance de motifs sans démontrer une réelle vigilance.
- Définissez des limites de temps généreuses. L'objectif est de mesurer la précision, pas la vitesse ; donnez donc aux candidats suffisamment de temps pour effectuer une révision attentive plutôt qu'une lecture rapide.
- Testez avec les titulaires de poste actuels avant de déployer le test auprès des candidats, et utilisez leurs scores pour définir des objectifs réalistes de taux de détection et estimer les taux de fausses alarmes.
- Randomisez l'ordre des éléments et faites tourner plusieurs versions de stimuli pour réduire la mémorisation et le partage de réponses entre candidats.
Quelques bonnes pratiques de conception distinguent un échantillon de travail solide d'un faible :
- Faites correspondre les erreurs intégrées aux modes de défaillance réels du poste plutôt qu'à des éléments génériques de type « trouver les différences »
- Rédigez des instructions sans ambiguïté. Des instructions confuses font augmenter les taux de fausses alarmes pour des raisons qui n'ont rien à voir avec l'attention aux détails
- Retirez ou retravaillez les éléments que tous les participants au pilote réussissent parfaitement ou ratent complètement. Aucun des deux extrêmes ne permet de distinguer les candidats entre eux
Notre guide pour concevoir des tests de présélection spécifiques au poste parcourt ce processus avec davantage d'exemples, et notre cadre pour choisir les compétences à évaluer vous aide à déterminer quels types d'erreurs sont les plus importants pour un poste donné.
Des systèmes de notation qui distinguent les candidats rigoureux des chanceux
La précision brute seule dissimule trop d'informations. Un candidat qui détecte 9 erreurs sur 10 intentionnellement intégrées mais qui signale 15 non-erreurs comme problématiques n'est pas réellement plus rigoureux que celui qui en détecte 7 sur 10 et n'en signale aucune. C'est précisément pourquoi une approche de détection de signal est importante : communiquez à la fois le taux de détection (erreurs correctement identifiées) et le taux de fausses alarmes (non-erreurs incorrectement signalées) pour chaque candidat, une pratique soutenue par des sources académiques et praticiens sur la mesure de l'attention aux détails.
Un score composite simple peut combiner ces éléments en un seul chiffre sur lequel les recruteurs peuvent agir. Une formule praticable : Score de détail composite = 0,70 × précision + 0,30 × fidélité aux instructions, pondérant la précision brute plus fortement tout en récompensant les candidats qui suivent scrupuleusement les instructions de la tâche.
À partir de là, convertissez les scores composites en bandes établies à partir de vos propres données pilotes, et non de références empruntées :
| Bande | Plage de score composite | Action recommandée |
|---|---|---|
| À recruter | Quartile supérieur du pilote | Faire passer directement à l'entretien final |
| Limite | Plage intermédiaire, dérivée du pilote | Ajouter une question d'entretien comportemental structuré |
| À développer | Quartile inférieur du pilote | Éliminer ou orienter vers un niveau de poste différent |
Des points de départ et des délais suggérés pour les postes courants, incluant des échantillons de travail de 10 à 25 minutes avec des seuils de précision de 80 à 90 % pour les postes de comptabilité et d'assurance qualité, vous donnent une base raisonnable avant que vos propres données pilotes ne la remplacent. Présentez les résultats aux responsables du recrutement dans un langage clair : une étiquette de bande accompagnée de deux ou trois exemples de questions d'entretien liées au schéma d'erreurs spécifique du candidat.
Déployer les évaluations sans perdre en équité ni en cohérence
La cohérence entre les candidats n'est pas un luxe, c'est ce qui rend vos scores comparables. Chaque candidat a besoin d'instructions identiques, de temps alloués identiques et d'un environnement de test comparable, avec des procédures d'aménagement documentées pour les candidats qui en ont besoin.
Les mesures anti-triche comportent de véritables compromis à peser avant d'en choisir une :
- Le verrouillage du navigateur empêche la navigation dans d'autres onglets, mais ajoute des frictions pour les candidats utilisant des appareils anciens
- La relecture de session et les vérifications par webcam détectent les tentatives de collaboration, mais soulèvent des questions de confidentialité qui nécessitent une divulgation claire
- Les versions d'éléments aléatoires réduisent le partage de réponses sans nécessiter aucune surveillance
Côté intégration, les résumés générés par IA aident les évaluateurs à trier rapidement les grands viviers de candidats, mais un être humain doit toujours prendre la décision finale, surtout pour les scores limites. Effectuez une analyse d'impact défavorable sur vos données pilotes avant le déploiement complet, et conservez la documentation de votre processus de validation. C'est la différence entre une pratique de recrutement défendable et une pratique qui s'effondre face à une contestation juridique.
Conseil pratique : Conservez un registre écrit de chaque décision de seuil pilote et de qui l'a approuvée. Si une décision de recrutement est un jour remise en question, cette piste documentaire est ce qui vous protège.
Ce que les recruteurs font mal dans le recrutement axé sur l'attention aux détails
La plupart des équipes de recrutement traitent l'attention aux détails comme un trait de personnalité sur lequel on peut interroger directement les candidats. Ce n'est pas le cas, et c'est pourquoi tant de recrues « orientées détail » déçoivent dans les quatre-vingt-dix premiers jours. La vérité dissimulée dans les recherches sur la validité est que l'attention aux détails est un comportement démontré dans des conditions de tâche réalistes, et non une qualité autodéclarée ; et la seule façon fiable de mesurer un comportement est de l'observer.
Le conseil conventionnel — « ajoutez quelques puzzles de type "trouver les différences" à votre processus de présélection » — va activement à l'encontre d'un bon recrutement. Ces puzzles mesurent la vitesse de traitement visuel, une compétence réelle mais étroite qui a peu à voir avec le fait de repérer un code de remise mal appliqué ou un dossier patient non concordant. Les recruteurs qui s'appuient sur eux finissent par sélectionner des lecteurs rapides, et non des raisonneurs rigoureux.
Si vous ne retenez qu'une chose de ceci : donnez la priorité à la création d'un échantillon de travail avant d'acheter un quelconque test prêt à l'emploi. Une évaluation générique ne peut pas savoir que vos erreurs de facturation diffèrent de celles de vos concurrents. Les schémas d'erreurs spécifiques au poste sont tout l'enjeu, et sauter cette étape compromet tout le reste de la combinaison.
— Jimmie
Essayez un pilote spécifique au poste avec Talent Approved
Construire cette combinaison de zéro demandait autrefois des semaines de rédaction d'éléments et un consultant en validation sous contrat. Talent Approved réduit cela à une après-midi, ce qui compte particulièrement pour les équipes de recrutement qui ont besoin d'une évaluation spécifique au poste opérationnelle avant la clôture de la prochaine demande de recrutement, et non au trimestre suivant.
Voici une séquence pilote praticable avec la plateforme. Premièrement, insérez votre description de poste dans Magic Create et laissez-le générer une première ébauche d'évaluation adaptée au poste. Deuxièmement, examinez l'ébauche et intégrez les types d'erreurs spécifiques que votre analyse de poste a identifiés, qu'il s'agisse d'erreurs de transposition dans un poste de saisie de données ou de violations de règles dans une liste de contrôle de conformité. Troisièmement, activez la surveillance anti-triche intégrée et les résumés générés par IA afin que votre équipe d'évaluation puisse trier les résultats rapidement tout en conservant une piste d'audit complète. Quatrièmement, faites passer l'évaluation à 10 à 30 titulaires de poste actuels avant de l'ouvrir aux candidats, en utilisant leurs scores pour définir vos bandes « à recruter », « limite » et « à développer ».
Pour des modèles et des listes de contrôle de conception pendant votre phase de création, nos guides sur la conception d'échantillons de travail administratifs et sur le pilotage des évaluations dans un flux de travail ATS couvrent les deux sujets plus en profondeur. Si vous souhaitez des questions de suivi structurées une fois les scores obtenus, le générateur de questions d'entretien comportemental de NueCareer est un outil complémentaire solide.
Prêt à le voir en action ? Commencez à créer votre première évaluation et disposez d'un test prêt pour le pilote en moins d'une heure.
Sources
FAQ
Quelles compétences une évaluation de l'attention aux détails devrait-elle mesurer ?
Elle devrait mesurer la détection des erreurs dans des conditions de tâche réalistes, et non la vitesse de balayage visuel. Les évaluations les plus solides combinent un test d'aptitude cognitive validé avec un échantillon de travail spécifique au poste contenant des erreurs intentionnelles telles que des omissions, des transpositions ou des violations de règles.
Les questions d'autoévaluation sur l'attention aux détails sont-elles fiables ?
Non. Les questions d'autoévaluation comme « Êtes-vous axé sur les détails ? » favorisent le biais de désirabilité sociale et corrèlent mal avec la précision réelle dans l'exercice des fonctions, ce qui explique pourquoi les échantillons de travail basés sur la performance restent le meilleur choix.
Quelle durée devrait avoir un test d'échantillon de travail ?
La plupart des échantillons de travail spécifiques au poste durent de 10 à 25 minutes, suffisamment longtemps pour que les candidats effectuent une révision attentive sans transformer l'exercice en test de vitesse.
Talent Approved peut-il créer un test d'attention aux détails spécifique au poste ?
Oui. L'outil Magic Create de Talent Approved génère une évaluation personnalisée directement à partir d'une description de poste, et la surveillance anti-triche intégrée ainsi que les résumés générés par IA permettent un examen rapide et défendable.
Quel est un bon point de départ pour le seuil de précision ?
De nombreux postes en assurance qualité et en comptabilité commencent les benchmarks pilotes à environ 80 à 90 % de précision, bien que le seuil approprié pour votre organisation devrait être déterminé en testant d'abord vos propres titulaires de poste.