
Lavori che richiedono attenzione ai dettagli: valutazioni che la predicono davvero
Il predittore più forte delle prestazioni legate all'attenzione al dettaglio non è un quiz sulla personalità né un esercizio cronometrato di riconoscimento di pattern. È un test cognitivo validato abbinato a un campione di lavoro specifico per il ruolo che include errori inseriti deliberatamente, supportato da domande di colloquio comportamentale strutturate. I campioni di lavoro hanno una validità meta-analitica di circa r = .54 per la previsione delle prestazioni lavorative, e l'Attention to Detail Test (ADT) offre prove basate sulle prestazioni che questo tipo di test predice le valutazioni dei supervisori sulle attività orientate al dettaglio. I test basati solo sulla velocità e i questionari di auto-valutazione non reggono altrettanto bene.
Ecco lo stack che consigliamo per valutare i ruoli che richiedono attenzione al dettaglio:
- Un test validato di abilità mentale generale (GMA) per misurare la capacità di ragionamento
- Un campione di lavoro specifico per il ruolo con errori deliberatamente incorporati, cronometrato per misurare l'accuratezza piuttosto che la velocità
- Domande di colloquio comportamentale strutturate legate a episodi reali, non generiche domande di auto-valutazione
Lo strumento Magic Create di Talent Approved costruisce questi assessment specifici per il ruolo direttamente da una descrizione del lavoro in pochi minuti, e il monitoraggio anti-frode insieme ai riepiloghi generati dall'intelligenza artificiale rendono il processo di revisione rapido senza sacrificare il rigore.
Punti Chiave
Uno stack validato composto da test di abilità cognitiva, campioni di lavoro specifici per il ruolo con errori inseriti deliberatamente e colloqui comportamentali strutturati predice le prestazioni legate all'attenzione al dettaglio in modo molto più affidabile rispetto ai test di velocità o ai questionari di auto-valutazione.
| Punto | Dettagli |
|---|---|
| Evitare i test basati solo sulla velocità | I puzzle di velocità di elaborazione misurano la velocità di scansione, non il rilevamento reale degli errori sul lavoro. |
| I campioni di lavoro guidano la validità | I campioni di lavoro mostrano una validità meta-analitica intorno a r = .54, superando leggermente i test di abilità cognitiva generale. |
| Registrare sia i tassi di rilevamento che quelli di falso allarme | Un candidato che segnala troppi non-errori non è più attento, semplicemente è meno selettivo. |
| Fare un pilota prima di fissare le soglie | Testare prima i dipendenti attuali per stabilire fasce di rilevamento realistiche invece di indovinare le soglie. |
| Costruire assessment rapidamente con Talent Approved | Magic Create genera test specifici per il ruolo a partire da una descrizione del lavoro, con anti-frode e riepiloghi AI integrati. |
Indice dei Contenuti
- Perché gli Assessment Validati Sono Importanti per i Ruoli che Richiedono Attenzione al Dettaglio
- Costruire uno Stack di Assessment che Funzioni Davvero
- Come Progettare Campioni di Lavoro Specifici per il Ruolo con Errori Inseriti Deliberatamente
- Sistemi di Punteggio che Distinguono i Candidati Attenti da Quelli Fortunati
- Implementare gli Assessment senza Perdere Equità o Coerenza
- Cosa Sbagliano i Recruiter nell'Assunzione di Persone Attente al Dettaglio
- Prova un Pilota Specifico per il Ruolo con Talent Approved
- Fonti
- FAQ
Perché gli Assessment Validati Sono Importanti per i Ruoli che Richiedono Attenzione al Dettaglio
I recruiter spesso ricorrono al primo test sull'attenzione al dettaglio che appare su Google, e questa è un'abitudine costosa. La ricerca sui metodi di selezione è inequivocabile: l'abilità mentale generale predice le prestazioni lavorative con circa r = .51, e i campioni di lavoro la superano leggermente con r = .54, secondo il lavoro meta-analitico di Schmidt e Hunter sulla validità dei metodi di selezione. Questi numeri esistono perché entrambi i metodi richiedono ai candidati di ragionare effettivamente attraverso un compito, non solo di dare un'occhiata a due immagini e individuare quale sembra diversa.
La comprensione è importante perché la maggior parte degli errori nel mondo reale non è visiva, ma contestuale. Una discrepanza nella fatturazione, una clausola contrattuale non corrispondente o un codice di spedizione trasposto richiedono comprensione del dominio, non solo occhi acuti. È proprio qui che i test basati sulla velocità e gli strumenti di auto-valutazione si rivelano inadeguati:
- I test di velocità misurano quanto velocemente qualcuno scansiona, che i professionisti del settore notano essere un'abilità diversa dal rilevare un errore sostanziale sotto una pressione temporale realistica
- I questionari di auto-valutazione ("Sei orientato ai dettagli?") invitano alla distorsione da desiderabilità sociale e correlano scarsamente con il comportamento lavorativo effettivo
- I puzzle generici di corrispondenza di pattern raramente assomigliano ai contenuti reali che i candidati gestiranno sul lavoro
Costruire uno Stack di Assessment che Funzioni Davvero
Nessun singolo test coglie l'attenzione al dettaglio da solo. Ogni componente di uno stack solido misura qualcosa che gli altri non colgono, e saltarne uno lascia una lacuna nella tua previsione.
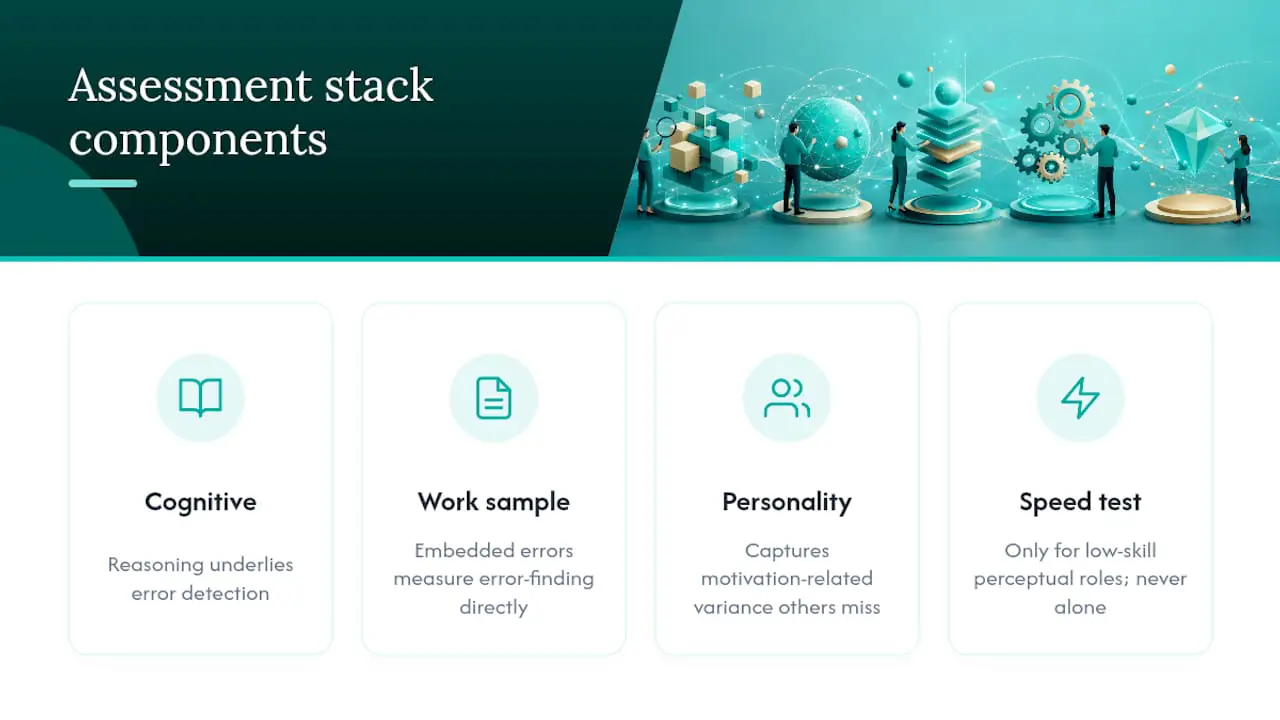
Il test di abilità cognitiva viene prima perché il ragionamento è alla base del rilevamento degli errori. Un candidato in grado di tenere più punti dati nella memoria di lavoro mentre li confronta con un insieme di regole supererà chi si limita a scansionare visivamente alla ricerca di discrepanze. I punteggi cognitivi rafforzano anche la validità del campione di lavoro che segue, poiché i candidati hanno bisogno di una capacità di ragionamento di base per interpretare correttamente le istruzioni.
I campioni di lavoro con errori incorporati hanno la più alta validità ecologica di qualsiasi metodo qui descritto, perché misurano il comportamento target direttamente invece di un suo indicatore indiretto. Un candidato analista finanziario che esamina un foglio di calcolo con tre errori di formula inseriti deliberatamente rivela molto di più di qualsiasi puzzle astratto.
Le misure di coscienziosità o personalità aggiungono uno strato più piccolo ma reale, catturando la varianza legata alla motivazione che i test cognitivi e i campioni di lavoro non spiegano completamente. Un test di velocità ristretto è difendibile solo per ruoli percettivi a bassa qualifica come lo smistamento di base o il lavoro su una linea di ispezione, e anche in quel caso non dovrebbe mai essere usato da solo.
Consiglio Pro: Abbina ogni punteggio cognitivo o di campione di lavoro a una domanda comportamentale strutturata, come "Raccontami di una volta in cui hai individuato un errore che qualcun altro aveva mancato." Fa emergere episodi reali che puoi verificare, a differenza di una scala di auto-valutazione.
Come Progettare Campioni di Lavoro Specifici per il Ruolo con Errori Inseriti Deliberatamente
Costruire un campione di lavoro che preveda davvero le prestazioni richiede più che inserire refusi in un documento. Segui questa sequenza:
- Esegui prima un'analisi del lavoro. Identifica le tre-cinque attività in cui gli errori hanno il costo più elevato e classifica i tipi di fallimento comuni: omissione, trasposizione, sostituzione o violazione di regola.
- Adatta il formato dello stimolo al lavoro quotidiano. Un ruolo finanziario ha bisogno di un foglio di calcolo con errori di formula; un ruolo logistico ha bisogno di un documento di spedizione; un ruolo legale ha bisogno di un contratto con clausole modificate.
- Incorpora una combinazione deliberata di tipi di errore, non un singolo pattern ripetuto. I candidati che vedono solo un tipo di errore possono riconoscerlo tramite il pattern e ottenere un punteggio elevato senza dimostrare una vera attenzione.
- Imposta limiti di tempo generosi. L'obiettivo è misurare l'accuratezza, non la velocità, quindi dai ai candidati abbastanza tempo per completare una revisione attenta piuttosto che una scansione frettolosa.
- Fai un pilota con i dipendenti attuali prima di somministrare il test ai candidati, e usa i loro punteggi per stabilire obiettivi realistici di tasso di rilevamento e stimare i tassi di falso allarme.
- Randomizza l'ordine degli elementi e ruota più versioni dello stimolo per ridurre la memorizzazione e la condivisione delle risposte tra i candidati.
Alcune abitudini di progettazione distinguono un buon campione di lavoro da uno debole:
- Adatta gli errori inseriti alle modalità di fallimento reali del ruolo piuttosto che a generici elementi "trova le differenze"
- Mantieni le istruzioni non ambigue. Istruzioni confuse aumentano i tassi di falso allarme per ragioni che non hanno nulla a che fare con l'attenzione
- Ritira o rielabora gli elementi che ogni partecipante al pilota risponde in modo perfettamente corretto o completamente sbagliato. Nessuno dei due estremi discrimina tra i candidati
La nostra guida alla progettazione di test di screening specifici per il lavoro illustra questo processo con più esempi, e il nostro framework per scegliere quali competenze testare ti aiuta a restringere quali tipi di errore sono più importanti per un determinato ruolo.
Sistemi di Punteggio che Distinguono i Candidati Attenti da Quelli Fortunati
L'accuratezza grezza da sola nasconde troppo. Un candidato che individua 9 errori su 10 inseriti deliberatamente ma segnala 15 non-errori come problemi non è effettivamente più attento di uno che ne individua 7 su 10 e non ne segnala nessuno. È esattamente per questo che una prospettiva di rilevamento del segnale è importante: riporta sia il tasso di rilevamento (errori correttamente identificati) sia il tasso di falso allarme (non-errori segnalati incorrettamente) per ogni candidato, una pratica supportata sia da fonti accademiche che professionali sulla misurazione dell'attenzione al dettaglio.
Un punteggio composito semplice può combinare questi elementi in un unico numero su cui i recruiter possono agire. Una formula funzionale: Punteggio Composito di Dettaglio = 0,70 × accuratezza + 0,30 × fedeltà alle istruzioni, ponderando l'accuratezza grezza più in alto pur premiando i candidati che seguono le istruzioni del compito con precisione.
Da lì, converti i punteggi compositi in fasce derivate dai tuoi dati pilota, non da benchmark presi in prestito:
| Fascia | Intervallo di Punteggio Composito | Azione Consigliata |
|---|---|---|
| Assumi | Quartile superiore del pilota | Avanza direttamente al colloquio finale |
| Borderline | Fascia intermedia, derivata dal pilota | Aggiungi una domanda di colloquio comportamentale strutturata |
| Da sviluppare | Quartile inferiore del pilota | Escludi o indirizza a un livello di ruolo diverso |
I punti di partenza suggeriti e i tempi per i ruoli comuni, inclusi campioni di lavoro da 10 a 25 minuti con soglie di accuratezza dall'80 al 90 percento per i ruoli contabili e di controllo qualità, ti forniscono una base ragionevole prima che i tuoi dati pilota la sostituiscano. Presenta i risultati ai responsabili delle assunzioni in un linguaggio semplice: un'etichetta di fascia più due o tre domande di colloquio campione legate allo specifico schema di errori del candidato.
Implementare gli Assessment senza Perdere Equità o Coerenza
La coerenza tra i candidati non è un optional, è ciò che rende i tuoi punteggi comparabili in assoluto. Ogni candidato ha bisogno di istruzioni identiche, tempi identici e un ambiente di test comparabile, con procedure di adattamento documentate per i candidati che ne hanno bisogno.
Le misure anti-frode comportano compromessi reali che vale la pena valutare prima di sceglierne una:
- Il blocco del browser impedisce il cambio di scheda ma aggiunge attrito per i candidati con dispositivi più vecchi
- La riproduzione della sessione e i controlli tramite webcam rilevano i tentativi di collaborazione ma sollevano considerazioni sulla privacy che richiedono una chiara comunicazione
- Le versioni degli elementi randomizzate riducono la condivisione delle risposte senza richiedere alcun monitoraggio
Sul fronte dell'integrazione, i riepiloghi generati dall'intelligenza artificiale aiutano i revisori a classificare rapidamente grandi pool di candidati, ma un essere umano dovrebbe sempre prendere la decisione finale, specialmente sui punteggi borderline. Esegui un'analisi dell'impatto negativo sui tuoi dati pilota prima del lancio completo e mantieni la documentazione del tuo processo di validazione. È la differenza tra una pratica di assunzione difendibile e una che crolla sotto una contestazione legale.
Consiglio Pro: Mantieni un registro scritto di ogni decisione sulle soglie del pilota e di chi l'ha approvata. Se una decisione di assunzione viene mai messa in discussione, è quella documentazione che ti protegge.
Cosa Sbagliano i Recruiter nell'Assunzione di Persone Attente al Dettaglio
La maggior parte dei team di assunzione tratta l'attenzione al dettaglio come un tratto della personalità su cui si può chiedere direttamente. Non lo è, e trattarla in questo modo è il motivo per cui tanti assunti "orientati al dettaglio" deludono entro i primi novanta giorni. La risposta onesta nascosta nella ricerca sulla validità è che l'attenzione al dettaglio è un comportamento dimostrato in condizioni di compito realistiche, non una qualità auto-riferita, e l'unico modo affidabile per misurare un comportamento è osservarlo.
Il consiglio convenzionale, "aggiungi qualche puzzle trova-le-differenze al tuo processo di selezione", lavora attivamente contro una buona assunzione. Quei puzzle misurano la velocità di elaborazione visiva, un'abilità reale ma ristretta che ha poco a che fare con il rilevamento di un codice sconto applicato erroneamente o di una cartella clinica non corrispondente. I recruiter che si affidano a essi finiscono per selezionare scanner veloci, non ragionatori attenti.
Se devi portare con te una sola cosa da questo articolo: dai la priorità alla costruzione di un campione di lavoro prima di acquistare qualsiasi test preconfezionato. Un assessment generico non può sapere che i tuoi errori di fatturazione sono diversi da quelli dei tuoi concorrenti. Gli schemi di errore specifici del lavoro sono l'intero punto della questione, e saltare questo passaggio mina tutto il resto dello stack.
— Jimmie
Prova un Pilota Specifico per il Ruolo con Talent Approved
Costruire questo stack da zero richiedeva settimane di scrittura degli elementi e un consulente di validazione in retainer. Talent Approved riduce tutto ciò a un pomeriggio, il che conta di più per i team di recruiting che hanno bisogno di un assessment specifico per il ruolo attivo prima della chiusura della prossima requisizione, non il trimestre successivo.
Ecco una sequenza pilota funzionale utilizzando la piattaforma. Prima, inserisci la descrizione del tuo lavoro in Magic Create e lascia che generi una prima bozza di assessment adattata al ruolo. Secondo, rivedi la bozza e incorpora i tipi di errore specifici che la tua analisi del lavoro ha evidenziato, che si tratti di errori di trasposizione in un ruolo di inserimento dati o di violazioni di regola in una checklist di conformità. Terzo, attiva il monitoraggio anti-frode integrato e i riepiloghi generati dall'intelligenza artificiale in modo che il tuo team di revisione possa classificare i risultati rapidamente mantenendo un registro completo. Quarto, esegui l'assessment con 10-30 dipendenti attuali prima di aprirlo ai candidati, usando i loro punteggi per stabilire le fasce di assunzione, borderline e sviluppo.
Per template e checklist di progettazione durante la costruzione, le nostre guide sulla progettazione di campioni di lavoro amministrativi e sul pilotaggio degli assessment in un workflow ATS coprono entrambi in modo più approfondito. Se vuoi domande di follow-up strutturate una volta che i punteggi arrivano, il generatore di domande di colloquio comportamentale di NueCareer è uno strumento complementare solido.
Pronto a vederlo in azione? Inizia a costruire il tuo primo assessment e avrai un test pronto per il pilota entro un'ora.
Fonti
FAQ
Quali Competenze Dovrebbe Misurare un Assessment sull'Attenzione al Dettaglio?
Dovrebbe misurare il rilevamento degli errori in condizioni di compito realistiche, non la velocità di scansione visiva. Gli assessment più efficaci combinano un test di abilità cognitiva validato con un campione di lavoro specifico per il ruolo contenente errori inseriti deliberatamente come omissioni, trasposizioni o violazioni di regole.
Le Domande di Auto-Valutazione sull'Attenzione al Dettaglio Sono Affidabili?
No. Le domande di auto-valutazione come "Sei orientato ai dettagli?" invitano alla distorsione da desiderabilità sociale e correlano scarsamente con l'accuratezza reale sul lavoro, motivo per cui i campioni di lavoro basati sulle prestazioni rimangono la scelta più valida.
Quanto Dovrebbe Durare un Test con Campione di Lavoro?
La maggior parte dei campioni di lavoro specifici per il ruolo dura dai 10 ai 25 minuti, abbastanza a lungo da consentire ai candidati di completare una revisione attenta senza trasformare l'esercizio in un test di velocità.
Talent Approved Può Costruire un Test sull'Attenzione al Dettaglio Specifico per il Ruolo?
Sì. Lo strumento Magic Create di Talent Approved genera un assessment su misura direttamente da una descrizione del lavoro, e il monitoraggio anti-frode integrato più i riepiloghi generati dall'intelligenza artificiale supportano una revisione rapida e difendibile.
Qual È un Buon Benchmark di Accuratezza di Partenza?
Molti ruoli di controllo qualità e contabilità iniziano i benchmark pilota intorno all'80-90 percento di accuratezza, anche se la soglia giusta per la tua organizzazione dovrebbe derivare dal pilotaggio del test con i tuoi dipendenti attuali.
Consigliati
- Come Adattare gli Assessment per Ruoli in Settori di Nicchia | TalentApproved
- Come Progettare Test di Screening dei Candidati Specifici per il Lavoro | TalentApproved
- Come Formare i Responsabili delle Assunzioni all'Uso degli Assessment | TalentApproved
- Come Scegliere le Competenze Giuste da Testare nei Candidati | TalentApproved