
Tarkkuutta Vaativat Työtehtävät: Arvioinnit, Jotka Todella Ennustavat Suoritusta
Vahvin ennustaja tarkkuutta vaativaan suoriutumiseen ei ole persoonallisuustesti eikä ajastettu kuvioidentifiointiharjoitus. Se on validoitu kognitiivisten kykyjen testi yhdistettynä roolikohtaiseen työesimerkkiin, joka sisältää istutettuja virheitä, ja jota tukevat rakenteelliset käyttäytymiseen perustuvat haastattelukysymykset. Työesimerkeillä on meta-analyyttinen validiteetti noin r = ,54 työn suoriutumisen ennustamisessa, ja Attention to Detail Test (ADT) tarjoaa suoritusperusteista näyttöä siitä, että tämänkaltainen testaus ennustaa esimiesten arvioita tarkkuutta vaativista tehtävistä. Pelkkää nopeutta mittaavat testit ja itsearviointikyselylomakkeet eivät kestä läheskään yhtä hyvin vertailua.
Tässä on kokonaisuus, jota suosittelemme tarkkuutta vaativien tehtävien arviointiin:
- Validoitu yleistä älyllistä kapasiteettia (GMA) mittaava testi päättelykyvyn arvioimiseksi
- Roolikohtainen työesimerkki tarkoituksella upotettuine virheineen, ajastettuna mittaamaan tarkkuutta eikä nopeutta
- Rakenteelliset käyttäytymiseen perustuvat haastattelutehtävät, jotka liittyvät todellisiin tilanteisiin, eivät yleisiin itsearviointikysymyksiin
Talent Approved'n Magic Create -työkalu rakentaa nämä roolikohtaiset arvioinnit suoraan tehtävänkuvauksesta minuuteissa, ja sen huijauksenesto-seuranta sekä tekoälyllä generoidut yhteenvedot tekevät arviointiprosessista nopean ilman, että tarkkuudesta joudutaan tinkimään.
Keskeiset huomiot
Validoitu kokonaisuus, joka muodostuu kognitiivisten kykyjen testauksesta, roolikohtaisista työesimerkeistä istutettuine virheineen ja rakenteellisista käyttäytymishaastatteluista, ennustaa tarkkuussuoriutumista huomattavasti luotettavammin kuin nopeus- tai itsearviointitestit.
| Kohta | Yksityiskohdat |
|---|---|
| Vältä pelkkää nopeutta mittaavia testejä | Prosessointinopeutta mittaavat tehtävät mittaavat skannausnopeutta, eivät todellista virheiden havaitsemista työssä. |
| Työesimerkit johtavat validiteetissa | Työesimerkit osoittavat meta-analyyttisen validiteetin noin r = ,54, ohittaen hieman yleiset kognitiiviset kykytestit. |
| Pistytä sekä osumien että väärän hälytyksen määrät | Ehdokas, joka merkitsee liikaa ei-virheitä, ei ole huolellisempi – hän on vain heikompi erottelemaan. |
| Pilotoi ennen raja-arvojen asettamista | Testaa ensin nykyisiä tehtävänhaltijoita asettaaksesi realistiset havaitsemisprosenttivälit arvaamisen sijaan. |
| Rakenna arviointeja nopeasti Talent Approved'n avulla | Magic Create generoi roolikohtaisia testejä tehtävänkuvauksesta, huijauksenesto ja tekoälyyhteenvedot sisäänrakennettuina. |
Sisällysluettelo
- Miksi validoidut arvioinnit ovat tärkeitä tarkkuutta vaativissa tehtävissä
- Toimivan arviointikokonaisuuden rakentaminen
- Roolikohtaisten työesimerkkien suunnitteleminen istutettuine virheineen
- Pisteytysjärjestelmät, jotka erottavat huolelliset ehdokkaat onnekkailta
- Arviointien käyttöönotto ilman oikeudenmukaisuuden tai johdonmukaisuuden menettämistä
- Mitä rekrytoijat tekevät väärin tarkkuutta vaativassa rekrytoinnissa
- Kokeile roolikohtaista pilottia Talent Approved'n kanssa
- Lähteet
- UKK
Miksi validoidut arvioinnit ovat tärkeitä tarkkuutta vaativissa tehtävissä
Rekrytoijat turvautuvat usein ensimmäiseen tarkkuustestiin, joka Google-haulla löytyy, ja se on kallis tapa. Valintamenetelmiä koskeva tutkimus on yksiselitteinen: yleinen älyllinen kapasiteetti ennustaa työn suoriutumista noin r = ,51, ja työesimerkit suoriutuvat siitä hieman paremmin arvolla r = ,54 Schmidtin ja Hunterin valintamenetelmien validiteettia käsittelevän meta-analyyttisen työn mukaan. Nämä luvut ovat olemassa siksi, että molemmat menetelmät edellyttävät ehdokkailta todellista tehtävän loogista läpikäymistä, eikä pelkästään kahden kuvan vertailua ja erojen bongaamista.
Ymmärtäminen on tärkeää, koska suurin osa tosielämän virheistä ei ole visuaalisia – ne ovat kontekstuaalisia. Laskutusristiriita, yhteensopimaton sopimuslauseke tai väärin siirretty toimitusnumero vaatii alan tuntemusta, ei pelkästään tarkkaa silmää. Juuri tässä kohtaa nopeuspohjaiset testit ja itsearviointityökalut pettävät:
- Nopeustesteillä mitataan, kuinka nopeasti joku skannaa – ja ammattilaiset huomauttavat, että se on eri taito kuin sisällöllisten virheiden havaitseminen realistisessa aikapaineessa
- Itsearviointikyselyt ("Oletko tarkkaan ottaen täsmällinen?") houkuttelevat sosiaaliseen suotavuusharhaan ja korreloivat heikosti todellisen työkäyttäytymisen kanssa
- Geneerisillä kuvioidentifiointitehtävillä on harvoin yhtäläisyyttä ehdokkaiden todellisessa työssä käsittelemän sisällön kanssa
Toimivan arviointikokonaisuuden rakentaminen
Yksikään testi ei yksinään kata tarkkuutta kokonaisuudessaan. Jokainen vahvan kokonaisuuden osa mittaa jotain, mitä muut eivät mittaa, ja yhden osan poisjättäminen jättää aukon ennusteeseen.
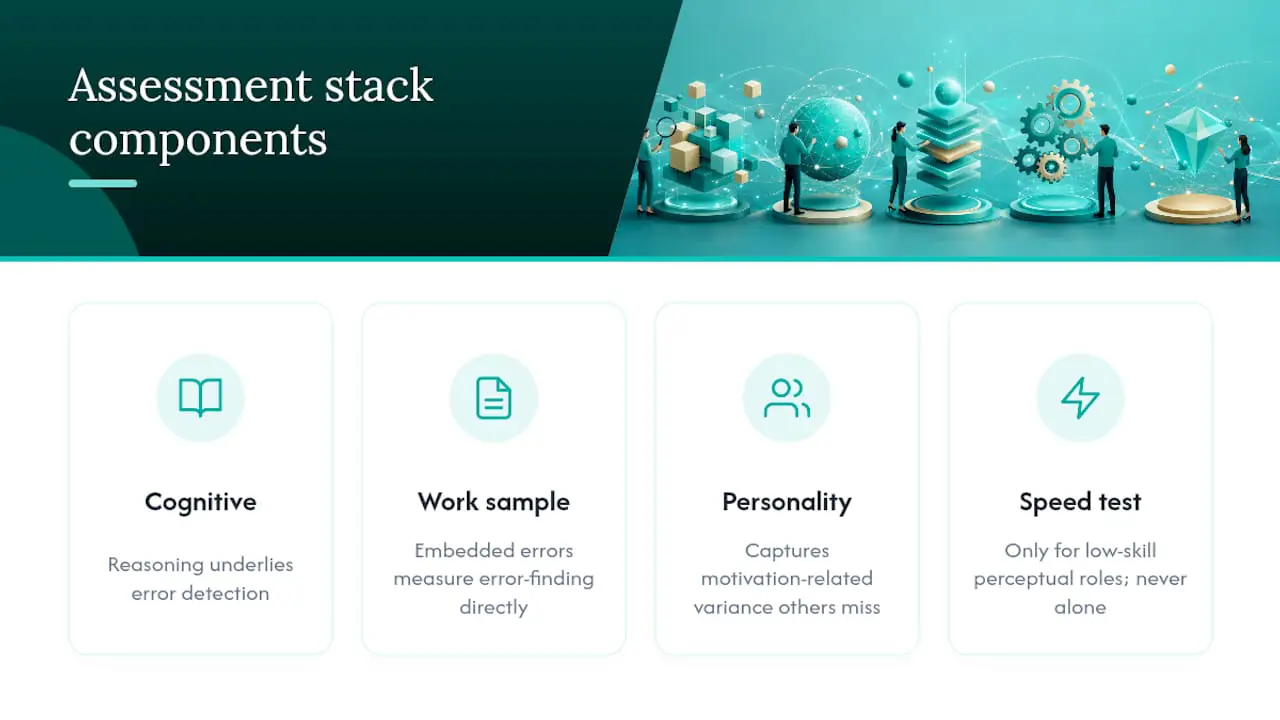
Kognitiivisten kykyjen testaus tulee ensin, koska päättelykyky on virheiden havaitsemisen perusta. Ehdokas, joka pystyy pitämään useita datapisteitä työmuistissaan samalla kun vertaa niitä sääntökokoelmaan, suoriutuu paremmin kuin sellainen, joka pelkästään skannaa visuaalisia eroja. Kognitiiviset pisteet vahvistavat myös seuraavan työesimerkin validiteettia, koska ehdokkaat tarvitsevat peruskapasiteettia ymmärtääkseen ohjeet oikein.
Upotettuine virheineen olevilla työesimerkeillä on kaikista tässä mainituista menetelmistä korkein ekologinen validiteetti, koska ne mittaavat tavoitekäyttäytymistä suoraan sen sijaan, että ne mittaisivat jotain sen sijaismuuttujaa. Talousanalyytikkoehdokas, joka tarkistaa laskentataulukon, johon on istutettu kolme kaavavirhettä, kertoo paljon enemmän kuin mikään abstrakti tehtävä voisi koskaan kertoa.
Tunnollisuus- tai persoonallisuusmittarit lisäävät pienemmän mutta todellisen kerroksen kattamalla motivaatioon liittyvän vaihtelun, jota kognitiiviset testit ja työesimerkit eivät täysin selitä. Kapea nopeustesti on puolustettavissa ainoastaan matalan osaamistason havainnointitehtävissä, kuten peruslajittelussa tai tarkastuslinjalla, ja silloinkaan sen ei pitäisi koskaan seistä yksin.
Vinkki: Yhdistä jokainen kognitiivinen tulos tai työesimerkkipistytys yhteen rakenteelliseen käyttäytymiskysymykseen, kuten "Kerro tilanteesta, jossa havaitsit virheen, jonka joku muu oli jättänyt huomaamatta." Se tuo esiin todellisia tapauksia, joita voi tarkistaa, toisin kuin itsearviointiasteikko.
Roolikohtaisten työesimerkkien suunnitteleminen istutettuine virheineen
Suoriutumista aidosti ennustavan työesimerkin rakentaminen vaatii enemmän kuin kirjoitusvirheiden lisäämistä asiakirjaan. Noudata tätä järjestystä:
- Tee ensin tehtäväanalyysi. Tunnista kolmesta viiteen tehtävää, joissa virheillä on suurin kustannus, ja luokittele yleiset virhetyypit: puuttuminen, siirtyminen, korvautuminen tai sääntörikkomus.
- Sovita ärsykteen muoto päivittäiseen työhön. Rahoitustehtävä tarvitsee laskentataulukon kaavavirheitä; logistiikkatehtävä tarvitsee lähetysluettelon; oikeudelliseen tehtävään liittyvä rooli tarvitsee sopimuksen muutetuine lausekkeineen.
- Upota tarkoituksellinen sekoitus virhetyyppejä, ei yhtä toistuvaa kaavaa. Ehdokkaat, jotka näkevät vain yhdenlaisia virheitä, voivat kuvioidentifioida tiensä korkeaan pisteeseen ilman todellista tarkkaavaisuutta.
- Aseta reilut aikarajat. Tavoitteena on tarkkuuden mittaaminen, ei nopeus, joten anna ehdokkaille riittävästi aikaa huolelliseen tarkistukseen pikaisemman silmäilyn sijaan.
- Pilotoi nykyisten tehtävänhaltijoiden kanssa ennen testin avaamista ehdokkaille ja käytä heidän pisteitään realististen havaitsemisprosenttitavoitteiden asettamiseen sekä väärän hälytyksen määrien arviointiin.
- Satunnaista tehtävien järjestys ja kierrätä useita ärsykeversioita vähentääksesi ulkoa opettelua ja vastausten jakamista ehdokkaiden välillä.
Muutamat suunnittelutavat erottavat vahvan työesimerkin heikosta:
- Sovita istutetut virheet roolin todellisiin virhemuotoihin geneeristen "etsi ero" -tehtävien sijaan
- Pidä ohjeet yksiselitteisinä. Sekavat ohjeet kasvattavat väärän hälytyksen määrää syistä, joilla ei ole mitään tekemistä tarkkaavaisuuden kanssa
- Poista tai uudista tehtävät, jotka jokainen pilottiosallistuja saa joko täysin oikein tai täysin väärin. Kumpikaan ääripää ei erota ehdokkaita toisistaan
Meidän opas tehtäväkohtaisten seulontatestien suunnitteluun käy läpi tämän prosessin lisää esimerkkejä käyttäen, ja meidän viitekehys testattavien taitojen valitsemiseen auttaa sinua rajaamaan, mitkä virhetyypit ovat tärkeimpiä kussakin roolissa.
Pisteytysjärjestelmät, jotka erottavat huolelliset ehdokkaat onnekkailta
Pelkkä raaka tarkkuus piilottaa liikaa. Ehdokas, joka havaitsee 9 kymmenestä istutetusta virheestä mutta merkitsee 15 ei-virhettä ongelmiksi, ei ole sen huolellisempi kuin sellainen, joka havaitsee 7 kymmenestä eikä merkitse yhtään. Juuri siksi signaalintunnistuksen näkökulma on tärkeä: raportoi sekä havaitsemisprosentti (oikein tunnistetut virheet) että väärän hälytyksen prosentti (virheellisesti merkityt ei-virheet) jokaiselle ehdokkaalle – käytäntö, jota tukevat sekä akateemiset että ammatilliset lähteet tarkkuusmittauksesta.
Yksinkertainen yhdistelmäpistytys voi koota nämä yhteen lukuun, jonka perusteella rekrytoijat voivat toimia. Yksi toimiva kaava: Yhdistelmätarkkuuspistytys = 0,70 × tarkkuus + 0,30 × ohjeiden noudattaminen – painottaa raakaa tarkkuutta enemmän samalla palkiten ehdokkaat, jotka noudattavat tehtäväohjeita tarkasti.
Muunna sen jälkeen yhdistelmäpisteet bändeiksi, jotka perustuvat omaan pilottidataasi eikä lainattuihin vertailuarvoihin:
| Bändi | Yhdistelmäpisteiden vaihteluväli | Suositeltava toimenpide |
|---|---|---|
| Palkkaa | Pilotin ylin neljännes | Vie suoraan loppuhaastatteluun |
| Rajanlyönti | Keskialue, pilotista johdettu | Lisää rakenteellinen käyttäytymishaastattelutehtävä |
| Kehitä | Pilotin alin neljännes | Karsinta tai ohjaus eri tehtävätasolle |
Ehdotetut lähtöpisteet ja ajoitus yleisille rooleille – mukaan lukien 10–25 minuutin työesimerkit ja 80–90 prosentin tarkkuuskynnykset kirjanpito- ja laadunvarmistusrooleille – antavat sinulle kohtuullisen lähtötilanteen ennen kuin oma pilottidatasi korvaa ne. Esitä tulokset rekrytointipäälliköille selkokielellä: bändimerkintä sekä kaksi tai kolme mallihaastattelukysymystä, jotka on kytketty ehdokkaan erityiseen virhekaavaan.
Arviointien käyttöönotto ilman oikeudenmukaisuuden tai johdonmukaisuuden menettämistä
Johdonmukaisuus ehdokkaiden välillä ei ole mukavuus – se tekee pisteitäsi vertailukelpoiset alun alkaen. Jokaisella ehdokkaalla täytyy olla identtiset ohjeet, identtiset aikarajoitukset ja vertailukelpoinen testausympäristö sekä dokumentoidut mukautusmenettelyt ehdokkaille, jotka niitä tarvitsevat.
Huijauksenestotoimenpiteissä on todellisia kompromisseja, jotka kannattaa punnita ennen valintaa:
- Selaimen lukitus estää välilehtien vaihtamisen, mutta lisää kitkaa vanhemmilla laitteilla olevien ehdokkaiden kohdalla
- Istunnon tallennus ja web-kameran tarkastukset paljastuvat yhteistyöyritykset, mutta herättävät yksityisyyttä koskevia näkökohtia, jotka vaativat selkeän tiedottamisen
- Satunnaistetut tehtäväversiot vähentävät vastausten jakamista ilman minkäänlaista valvontaa
Integraatiopuolella tekoälyllä generoidut yhteenvedot auttavat arvioijia triagoimaan suuret ehdokasjoukot nopeasti, mutta ihmisen tulee aina tehdä lopullinen päätös – erityisesti rajanlyöntipisteiden kohdalla. Tee haittavaikutusanalyysi pilottidatastasi ennen täyttä käyttöönottoa ja pidä validointiprosessisi dokumentaatio tallennettuina. Se on ero puolustettavan palkkaamiskäytännön ja sellaisen välillä, joka romahtaa oikeudellisen haasteen edessä.
Vinkki: Pidä kirjallinen rekisteri jokaisesta pilottikatkaisupäätöksestä ja siitä, kuka sen hyväksyi. Jos palkkaamispäätöstä koskaan kyseenalaistetaan, se paperiketju on se, mikä suojaa sinua.
Mitä rekrytoijat tekevät väärin tarkkuutta vaativassa rekrytoinnissa
Useimmat rekrytointitiimit käsittelevät tarkkuutta persoonallisuuden piirteenä, josta voi kysyä suoraan. Se ei ole sitä, ja juuri siksi niin monet "tarkat" rekrytoidut pettymyksiä tuottavat ensimmäisen yhdeksänkymmenen päivän sisällä. Validiteettitutkimukseen kätketty rehellinen vastaus on, että tarkkuus on osoitettua käyttäytymistä realistisissa tehtäväolosuhteissa, ei itseraportoitu ominaisuus, ja ainoa luotettava tapa mitata käyttäytymistä on havainnoida sitä.
Perinteinen neuvo – "lisää muutama etsi-ero-tehtävä seulontaprosessiin" – toimii aktiivisesti hyvää rekrytointia vastaan. Nämä tehtävät mittaavat visuaalista prosessointinopeutta, joka on todellinen mutta kapea taito, jolla on vähän tekemistä väärin sovelletun alennuskoodin tai yhteensopimattoman potilasrekisterin havaitsemisen kanssa. Niihin tukeutuvat rekrytoijat päätyvät valitsemaan nopeita skannaajia eikä huolellisia päättelijöitä.
Jos otat tästä yhden asian mukaasi: priorisoi työesimerkin rakentaminen ennen minkään valmiin testin ostamista. Geneerinen arviointi ei voi tietää, että laskutusvirheesi näyttävät erilaisilta kuin kilpailijasi. Tehtäväkohtaiset virhekaavat ovat koko pointti, ja tämän vaiheen ohittaminen heikentää kaiken muun kokonaisuudessa.
— Jimmie
Kokeile roolikohtaista pilottia Talent Approved'n kanssa
Tämän kokonaisuuden rakentaminen alusta asti tarkoitti aiemmin viikkoja tehtävien kirjoittelua ja validointikonsulttia pysyvästi palkattuina. Talent Approved lyhentää sen iltapäiväksi, mikä merkitsee eniten rekrytointitiimeille, jotka tarvitsevat roolikohtaisen arvioinnin käyttövalmiiksi ennen seuraavan rekrytointiprosessin sulkeutumista – eikä ensi kvartaalilla.
Tässä on toimiva pilottijärjestys alustan avulla. Ensiksi syötä tehtävänkuvauksesi Magic Create -työkaluun ja anna sen generoida ensimmäinen arviointiluonnos roolin mukaan räätälöitynä. Toiseksi tarkista luonnos ja upota tehtäväanalyysisi tunnistamia erityisiä virhetyyppejä – olipa kyse siirtymisvirheistä tietojen syöttämisroolissa tai sääntörikkomuksista vaatimustenmukaisuuden tarkistuslistassa. Kolmanneksi kytke päälle sisäänrakennettu huijauksenestoseuranta ja tekoälyllä generoidut yhteenvedot, jotta arviointitiimisi voi triagata tuloksia nopeasti samalla säilyttäen täydellisen auditointiketjun. Neljänneksi aja arviointi 10–30 tehtävänhaltijalle ennen sen avaamista ehdokkaille, ja käytä heidän pisteitään palkkaa-, rajanlyönti- ja kehitä-bändien asettamiseen.
Malleja ja suunnittelutarkistuslistoja rakentamisen tueksi löydät oppaistamme, jotka käsittelevät hallinnollisten työesimerkkien suunnittelua ja arviointien pilotointia ATS-työnkulussa – molemmat käsitellään niissä syvemmin. Jos haluat rakenteellisia jatkokysymyksiä pisteiden tultua, NueCareer'n käyttäytymishaastattelukysymysgeneraattori on loistava täydentävä työkalu.
Haluatko nähdä sen toiminnassa? Aloita ensimmäisen arviointisi rakentaminen ja sinulla on pilottivalmis testi tunnin sisällä.
Lähteet
UKK
Mitä taitoja tarkkuusarvioinnin tulisi mitata?
Sen tulisi mitata virheiden havaitsemista realistisissa tehtäväolosuhteissa, ei visuaalista skannausnopeutta. Vahvimmat arvioinnit yhdistävät validoidun kognitiivisten kykyjen testin roolikohtaiseen työesimerkkiin, joka sisältää istutettuja virheitä, kuten puuttumisia, siirtymisiä tai sääntörikkomuksia.
Ovatko itsearviointiin perustuvat tarkkuuskysymykset luotettavia?
Eivät. Itsearviointikysymykset, kuten "Oletko tarkkaan ottaen täsmällinen?", houkuttelevat sosiaaliseen suotavuusharhaan ja korreloivat heikosti todellisen työtarkkuuden kanssa – minkä vuoksi suorituspohjaiset työesimerkit pysyvät parempana valintana.
Kuinka kauan työesimerkkitestin tulisi kestää?
Useimmat roolikohtaiset työesimerkit kestävät 10–25 minuuttia – riittävän kauan, jotta ehdokkaat voivat tehdä huolellisen tarkistuksen ilman, että harjoituksesta tulee nopeustesti.
Voiko Talent Approved rakentaa roolikohtaisen tarkkuustestin?
Kyllä. Talent Approved'n Magic Create -työkalu generoi räätälöidyn arvioinnin suoraan tehtävänkuvauksesta, ja sisäänrakennettu huijauksenestoseuranta sekä tekoälyllä generoidut yhteenvedot tukevat nopeaa ja puolustettavaa arviointia.
Mikä on hyvä lähtökohtainen tarkkuusvertailuarvo?
Monet laadunvarmistus- ja kirjanpitoroolit aloittavat pilottikokeiluissa noin 80–90 prosentin tarkkuudella, vaikka oikea kynnys organisaatiollesi tulisi määrittyä ensin pilotoimalla testi omilla tehtävänhaltijoillasi.