
Detaljeorienterede Jobs: Tests der Faktisk Forudsiger Det
Den stærkeste prædiktor for præstationer inden for detaljeorientering er ikke en personlighedstest eller en tidsbestemt mønstergenkendelsesøvelse. Det er en valideret kognitiv evnetest parret med en rollespecifik arbejdsprøve med bevidst indlagte fejl, understøttet af strukturerede adfærdsbaserede interviewspørgsmål. Arbejdsprøver har en meta-analytisk validitet på ca. r = .54 for at forudsige jobpræstationer, og Attention to Detail Test (ADT) leverer præstationsbaseret evidens for, at denne type test forudsiger ledervurderinger af detaljeorienterede opgaver. Hastighedsbaserede tests og selvrapporterende spørgeskemaer holder langt fra så godt.
Her er den sammensætning, vi anbefaler til evaluering af jobs med krav om detaljeorientering:
- En valideret test af generel mental evne (GMA) til at måle ræsonneringskapacitet
- En rollespecifik arbejdsprøve med bevidst indlagte fejl, tidsbestemt til at måle nøjagtighed frem for hastighed
- Strukturerede adfærdsbaserede interviewspørgsmål knyttet til virkelige hændelser, ikke generiske selvvurderingsspørgsmål
Talent Approveds Magic Create-værktøj bygger disse rollespecifikke vurderinger direkte ud fra en jobbeskrivelse på få minutter, og dets snyd-forebyggende overvågning plus AI-genererede resuméer gør gennemgangsprocessen hurtig uden at gå på kompromis med grundigheden.
Vigtigste pointer
En valideret kombination af kognitiv evnetest, rollespecifikke arbejdsprøver med indlagte fejl og strukturerede adfærdsbaserede interviews forudsiger detaljeorienteringspræstationer langt mere pålideligt end hastighedstests eller selvrapporterende spørgeskemaer.
| Pointe | Detaljer |
|---|---|
| Undgå hastighedsbaserede tests | Gåder, der måler behandlingshastighed, måler scanningshastighed, ikke reel fejlopdagelse i praksis. |
| Arbejdsprøver leder validiteten | Arbejdsprøver viser meta-analytisk validitet på ca. r = .54, lidt over generelle kognitive evnetests. |
| Registrér både træfrate og falsk alarmrate | En kandidat, der markerer for mange ikke-fejl, er ikke mere omhyggelig, blot mindre diskriminerende. |
| Pilottest før du fastsætter grænseværdier | Test nuværende medarbejdere først for at fastsætte realistiske opdagelsesrater frem for at gætte på grænseværdier. |
| Byg vurderinger hurtigt med Talent Approved | Magic Create genererer rollespecifikke tests ud fra en jobbeskrivelse med indbygget snyd-forebyggelse og AI-resuméer. |
Indholdsfortegnelse
- Hvorfor validerede vurderinger er vigtige for jobs med krav om detaljeorientering
- Opbygning af en vurderingssammensætning, der rent faktisk virker
- Sådan designer du rollespecifikke arbejdsprøver med indlagte fejl
- Pointsystemer, der adskiller omhyggelige kandidater fra heldige
- Udrulning af vurderinger uden at miste fairness eller konsistens
- Hvad rekrutterere gør forkert ved ansættelse med fokus på detaljeorientering
- Prøv et rollespecifikt pilotprojekt med Talent Approved
- Kilder
- FAQ
Hvorfor validerede vurderinger er vigtige for jobs med krav om detaljeorientering
Rekrutterere falder ofte tilbage på den detaljeorienteringstest, der dukker op først i en Google-søgning, og det er en kostbar vane. Forskningen i udvælgelsesmetoder er utvetydig: generel mental evne forudsiger jobpræstationer ved ca. r = .51, og arbejdsprøver overgår det lidt med r = .54, ifølge Schmidt og Hunters meta-analytiske arbejde om validiteten af udvælgelsesmetoder. Disse tal eksisterer, fordi begge metoder kræver, at kandidaterne faktisk ræsonnerer sig igennem en opgave frem for blot at kaste et blik på to billeder og spotte, hvilket der ser anderledes ud.
Forståelse er afgørende, fordi de fleste fejl i den virkelige verden ikke er visuelle – de er kontekstuelle. En faktureringsuoverensstemmelse, en forkert kontraktklausul eller en ombyttet forsendelseskode kræver domæneforståelse, ikke blot skarpe øjne. Det er netop her, hastighedsbaserede tests og selvrapporterende værktøjer bryder sammen:
- Hastighedstests måler, hvor hurtigt nogen scanner, hvilket praktikere bemærker er en anden færdighed end at opdage en væsentlig fejl under realistisk tidspres
- Selvrapporterende spørgeskemaer ("Er du detaljeorienteret?") inviterer til social ønskelighed-bias og korrelerer dårligt med faktisk jobadfærd
- Generiske mønstergenkendelsespuslespil ligner sjældent det faktiske indhold, kandidaterne vil håndtere i jobbet
Opbygning af en vurderingssammensætning, der rent faktisk virker
Ingen enkelt test kan alene indfange detaljeorientering. Hver komponent i en stærk sammensætning måler noget, de andre går glip af, og udeladelse af én efterlader et hul i din forudsigelse.
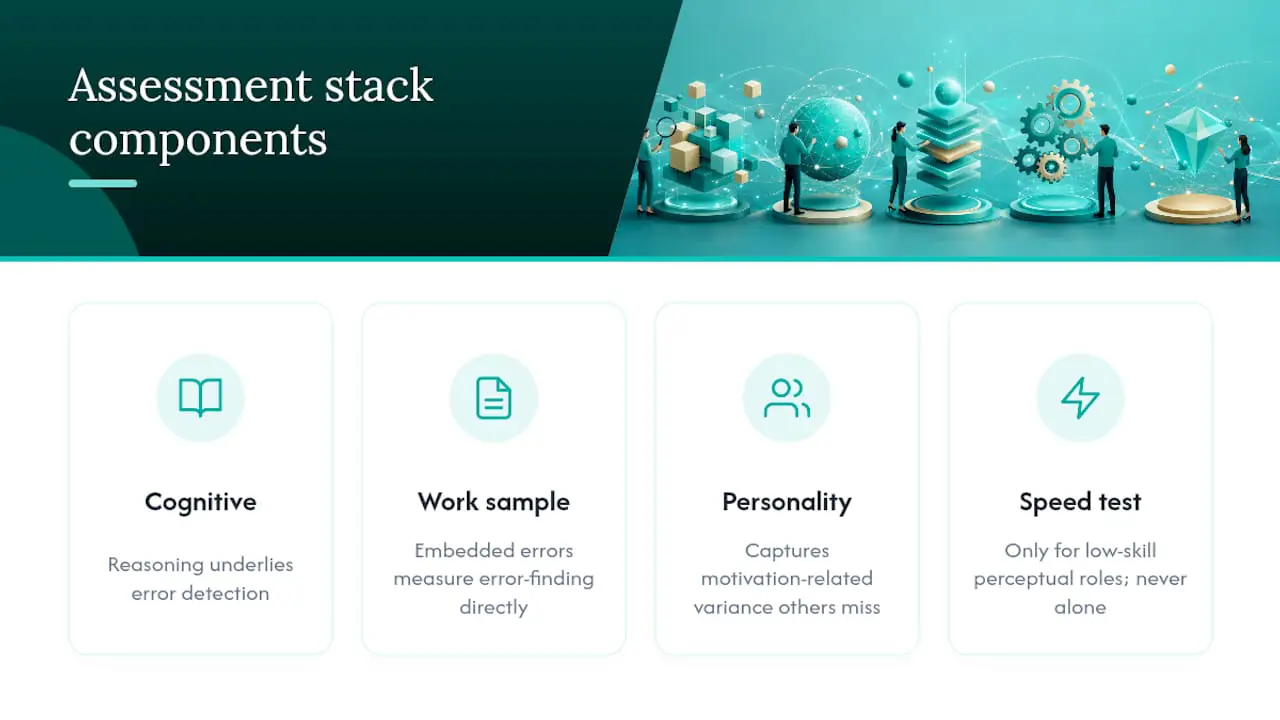
Kognitiv evnetest kommer først, fordi ræsonnering er grundlaget for fejlopdagelse. En kandidat, der kan holde flere datapunkter i arbejdshukommelsen og samtidig sammenligne dem med et regelsæt, vil klare sig bedre end én, der blot scanner efter visuelle afvigelser. Kognitive scores styrker også validiteten af den efterfølgende arbejdsprøve, da kandidaterne har brug for grundlæggende ræsonneringskapacitet til korrekt at fortolke instruktionerne.
Arbejdsprøver med indlagte fejl har den højeste økologiske validitet af alle metoder her, fordi de måler måladfærden direkte frem for en stedfortrædervariabel for den. En finansanalytikerkandidats gennemgang af et regneark med tre bevidst indlagte formeelfejl fortæller dig langt mere end en abstrakt gåde nogensinde ville kunne.
Samvittighedsfuldhed eller personlighedsmål tilføjer et mindre men reelt lag, der indfanger motivationsrelateret varians, som kognitive tests og arbejdsprøver ikke fuldt ud forklarer. En smal hastighedstest er kun forsvarlig til lavkvalificerede perceptuelle roller som grundlæggende sortering eller inspektionslinjearbejde, og selv der bør den aldrig stå alene.
Pro tip: Par hvert kognitivt eller arbejdsprøve-resultat med ét struktureret adfærdsspørgsmål, f.eks. "Fortæl mig om en gang, du opdagede en fejl, som andre havde overset." Det afdækker virkelige hændelser, du kan verificere, i modsætning til en selvvurderende skala.
Sådan designer du rollespecifikke arbejdsprøver med indlagte fejl
At bygge en arbejdsprøve, der rent faktisk forudsiger præstationer, kræver mere end blot at droppe stavefejl i et dokument. Følg denne rækkefølge:
- Gennemfør en jobanalyse først. Identificer de tre til fem opgaver, hvor fejl har de højeste omkostninger, og klassificér de almindelige fejltyper: udeladelse, ombytning, substitution eller regelovertrædelse.
- Match stimulusformatet til det daglige arbejde. En finansrolle har brug for et regneark med formeelfejl; en logistikrolle har brug for et forsendelsesmanifest; en juridisk-tilgrænsende rolle har brug for en kontrakt med ændrede klausuler.
- Indbyg en bevidst blanding af fejltyper, ikke et enkelt gentaget mønster. Kandidater, der kun ser én slags fejl, kan bruge mønstergenkendelse til en høj score uden at demonstrere reel opmærksomhed.
- Sæt generøse tidsgrænser. Målet er at måle nøjagtighed, ikke hastighed, så giv kandidaterne nok tid til at gennemføre en omhyggelig gennemgang frem for en hastig skimning.
- Pilottest med nuværende medarbejdere inden testen rulles ud til kandidaterne, og brug deres scores til at fastsætte realistiske opdagelsesratemål og estimere falske alarmrater.
- Randomisér rækkefølgen af spørgsmål og rotér flere stimulusversioner for at reducere memorering og svar-deling mellem kandidater.
Nogle designvaner adskiller en stærk arbejdsprøve fra en svag:
- Match indlagte fejl til rollens faktiske fejlmønstre frem for generiske "find fejlen"-opgaver
- Hold instruktionerne utvetydige. Forvirrende instruktioner øger falske alarmrater af årsager, der ikke har noget at gøre med opmærksomhed
- Pensionér eller omarbejd spørgsmål, som alle pilotdeltagere enten svarer perfekt rigtigt eller fuldstændigt forkert på. Ingen af ekstremerne diskriminerer mellem kandidaterne
Vores guide til design af jobspecifikke screeningstests gennemgår denne proces med flere eksempler, og vores rammeværk til at vælge, hvilke færdigheder der skal testes hjælper dig med at indsnævre, hvilke fejltyper der er vigtigst for en given rolle.
Pointsystemer, der adskiller omhyggelige kandidater fra heldige
Rå nøjagtighed alene skjuler for meget. En kandidat, der opdager 9 ud af 10 indlagte fejl, men markerer 15 ikke-fejl som problemer, er ikke mere omhyggelig end én, der opdager 7 ud af 10 og ikke markerer nogen. Det er præcis derfor, et signaldetektionsperspektiv er vigtigt: rapportér både opdagelsesraten (korrekt identificerede fejl) og den falske alarmrate (forkert markerede ikke-fejl) for hver kandidat – en praksis understøttet af både akademiske og praktikerkilde om måling af detaljeorientering.
En simpel sammensat score kan kombinere disse til ét tal, som rekrutterere kan handle på. En brugbar formel: Sammensat detailscore = 0,70 × nøjagtighed + 0,30 × instruktionstroskab, der vægter rå nøjagtighed højere og samtidig belønner kandidater, der følger opgaveinstruktionerne præcist.
Konvertér herefter sammensatte scores til bånd baseret på dine egne pilotdata, ikke lånte benchmarks:
| Bånd | Sammensat scoreinterval | Anbefalet handling |
|---|---|---|
| Ansæt | Øverste kvartil i pilotdata | Gå direkte videre til den afsluttende samtale |
| Grænsetilfælde | Midterområde, pilotbaseret | Tilføj et struktureret adfærdsbaseret interviewspørgsmål |
| Udvikl | Nederste kvartil i pilotdata | Frasorter eller henvis til et andet rolleniveau |
Foreslåede startpunkter og tidsrammer for almindelige roller – herunder arbejdsprøver på 10 til 25 minutter med nøjagtighedstærskler på 80 til 90 procent for regnskabs- og QA-roller – giver dig et rimeligt udgangspunkt, inden dine egne pilotdata erstatter det. Præsentér resultater for ansættende ledere i klart sprog: en båndmærkning plus to eller tre eksempel-interviewspørgsmål knyttet til kandidatens specifikke fejlmønster.
Udrulning af vurderinger uden at miste fairness eller konsistens
Konsistens på tværs af kandidater er ikke et luksusproblem – det er det, der gør dine scores sammenlignelige overhovedet. Alle kandidater har brug for identiske instruktioner, identiske tidstillæg og et sammenligneligt testmiljø samt dokumenterede tilpasningsprocedurer for kandidater, der har brug for dem.
Snyd-forebyggende foranstaltninger medfører reelle afvejninger, der er værd at overveje, inden du vælger én:
- Browserlåsning forhindrer faneskift, men tilføjer friktion for kandidater på ældre enheder
- Sessionsafspilning og webcam-kontrol opdager samarbejdsforsøg, men rejser privatlivsovervejelser, der kræver tydelig oplysning
- Randomiserede spørgsmålsversioner reducerer svar-deling uden at kræve nogen overvågning overhovedet
På integrationssiden hjælper AI-genererede resuméer bedømmere med hurtigt at triagere store kandidatpuljer, men et menneske bør altid træffe den endelige beslutning – særligt ved grænsetilfælde. Kør en analyse af negativ indvirkning på dine pilotdata inden fuld udrulning, og bevar dokumentation for din valideringsproces. Det er forskellen på en forsvarlig ansættelsespraksis og én, der falder fra hinanden under en juridisk udfordring.
Pro tip: Bevar et skriftligt optegnelse over hver pilotgrænseværdibeslutning og hvem der godkendte den. Hvis en ansættelsesbeslutning nogensinde bliver anfægtet, er det denne dokumentation, der beskytter dig.
Hvad rekrutterere gør forkert ved ansættelse med fokus på detaljeorientering
De fleste ansættelsesteams behandler detaljeorientering som et personlighedstræk, man kan spørge direkte om. Det er det ikke, og det er grunden til, at så mange "detaljeorienterede" ansatte skuffer inden for de første halvfems dage. Det ærlige svar, der er begravet i valideringsforskningen, er, at detaljeorientering er en demonstreret adfærd under realistiske opgaveforhold, ikke en selvrapporteret egenskab, og den eneste pålidelige måde at måle en adfærd på er at observere den.
Det konventionelle råd – "tilføj et par find-fejlen-gåder til din screeningsproces" – modvirker aktivt god ansættelse. Disse gåder måler visuel behandlingshastighed, en reel men snæver færdighed, der har lidt at gøre med at opdage en forkert anvendt rabatkode eller et misforholdsfuldt patientjournalpost. Rekrutterere, der stoler på dem, ender med at udvælge hurtige scannere frem for omhyggelige ræsonnatorer.
Hvis du tager én ting med fra dette: prioritér at bygge en arbejdsprøve, inden du køber nogen off-the-shelf-test. En generisk vurdering kan ikke vide, at dine faktureringsfejl ser anderledes ud end din konkurrents. Jobspecifikke fejlmønstre er hele pointen, og at springe det trin over underminerer alt andet i sammensætningen.
— Jimmie
Prøv et rollespecifikt pilotprojekt med Talent Approved
At bygge denne sammensætning fra bunden plejede at betyde uger med spørgsmålsskrivning og en valideringskonsulent på retainer. Talent Approved reducerer det til en eftermiddag, hvilket er vigtigst for rekrutteringsteams, der har brug for en rollespecifik vurdering live inden næste ansættelsesrunde lukker – ikke næste kvartal.
Her er en brugbar pilotsekvens ved hjælp af platformen. Først indfør din jobbeskrivelse i Magic Create og lad den generere en første udkast til vurdering tilpasset rollen. Dernæst gennemgå udkastet og indbyg de specifikke fejltyper, som din jobanalyse har identificeret – hvad enten det er ombytnningsfejl i en dataindtastningsrolle eller regelovertrædelser i en compliance-tjekliste. Tredje aktivér den indbyggede snyd-forebyggende overvågning og AI-genererede resuméer, så dit gennemgangsteam hurtigt kan triagere resultater og samtidig bevare et fuldt revisionsspor. Fjerde kør vurderingen med 10 til 30 nuværende medarbejdere, inden den åbnes for kandidater, og brug deres scores til at fastsætte dine ansæt-, grænsetilfælde- og udviklbånd.
For skabeloner og designtjeklister, mens du bygger, dækker vores guides om administrativ arbejdsprøvedesign og pilotering af vurderinger på tværs af et ATS-workflow begge dele mere dybdegående. Hvis du ønsker strukturerede opfølgningsspørgsmål, når scores er klar, er NueCareers generator til adfærdsbaserede interviewspørgsmål et solidt ledsageværktøj.
Klar til at se det i aktion? Begynd at bygge din første vurdering og hav en pilotfærdig test inden for en time.
Kilder
FAQ
Hvilke færdigheder bør en detaljeorienteringsvurdering måle?
Den bør måle fejlopdagelse under realistiske opgaveforhold, ikke visuel scanningshastighed. De stærkeste vurderinger kombinerer en valideret kognitiv evnetest med en rollespecifik arbejdsprøve indeholdende indlagte fejl som udeladelser, ombytninger eller regelovertrædelser.
Er selvrapporterende detaljeorienteringsspørgsmål pålidelige?
Nej. Selvrapporterende spørgsmål som "Er du detaljeorienteret?" inviterer til social ønskelighed-bias og korrelerer dårligt med faktisk nøjagtighed på jobbet, hvilket er grunden til, at præstationsbaserede arbejdsprøver forbliver det stærkere valg.
Hvor lang tid bør en arbejdsprøvetest tage?
De fleste rollespecifikke arbejdsprøver varer 10 til 25 minutter – lang nok til, at kandidaterne kan gennemføre en omhyggelig gennemgang uden at gøre øvelsen til en hastighedstest.
Kan Talent Approved bygge en rollespecifik detaljeorienteringstest?
Ja. Talent Approveds Magic Create-værktøj genererer en skræddersyet vurdering direkte ud fra en jobbeskrivelse, og indbygget snyd-forebyggende overvågning samt AI-genererede resuméer understøtter hurtig og forsvarlig gennemgang.
Hvad er et godt startmæssigt nøjagtighedsbenchmark?
Mange QA- og regnskabsroller starter pilotbenchmarks ved 80 til 90 procents nøjagtighed, selvom den rette tærskel for din organisation bør komme fra at pilotteste testen med dine egne nuværende medarbejdere først.