
Detailorientierte Jobs: Assessments, die es wirklich vorhersagen
Der stärkste Prädiktor für Detailgenauigkeit ist weder ein Persönlichkeitsquiz noch eine zeitgesteuerte Mustererkennungsübung. Es ist ein validierter kognitiver Fähigkeitstest, kombiniert mit einer rollenspezifischen Arbeitsprobe, die eingebettete Fehler enthält, ergänzt durch strukturierte verhaltensbezogene Interviewfragen. Arbeitsproben weisen eine metaanalytische Validität von etwa r = .54 zur Vorhersage von Arbeitsleistung auf, und der Attention to Detail Test (ADT) liefert leistungsbasierte Belege dafür, dass diese Art von Tests Vorgesetztenbeurteilungen detailorientierter Aufgaben vorhersagt. Reine Geschwindigkeitstests und Selbstauskunftsfragebögen schneiden dabei deutlich schlechter ab.
Hier ist der Ansatz, den wir zur Bewertung von Stellen mit Anforderungen an Detailgenauigkeit empfehlen:
- Ein validierter Test zur allgemeinen geistigen Leistungsfähigkeit (GMA), um die Denkkapazität zu messen
- Eine rollenspezifische Arbeitsprobe mit absichtlich eingebetteten Fehlern, zeitlich so bemessen, dass Genauigkeit statt Geschwindigkeit gemessen wird
- Strukturierte verhaltensbezogene Interviewfragen, die auf realen Ereignissen basieren, statt auf allgemeinen Selbsteinschätzungsfragen
Das Magic Create-Tool von Talent Approved erstellt diese rollenspezifischen Assessments direkt aus einer Stellenbeschreibung in wenigen Minuten, und seine Anti-Cheat-Überwachung sowie KI-generierte Zusammenfassungen machen den Auswertungsprozess schnell, ohne die Qualität zu beeinträchtigen.
Wichtigste Erkenntnisse
Eine validierte Kombination aus kognitivem Fähigkeitstest, rollenspezifischen Arbeitsproben mit eingebetteten Fehlern und strukturierten verhaltensbezogenen Interviews sagt Detailgenauigkeit weit zuverlässiger voraus als Geschwindigkeitstests oder Selbstauskunftsfragebögen.
| Punkt | Details |
|---|---|
| Reine Geschwindigkeitstests vermeiden | Verarbeitungsgeschwindigkeitsaufgaben messen Scangeschwindigkeit, nicht die reale Fehlererkennung im Arbeitsalltag. |
| Arbeitsproben führen bei der Validität | Arbeitsproben zeigen eine metaanalytische Validität von etwa r = .54 und übertreffen damit allgemeine kognitive Fähigkeitstests leicht. |
| Sowohl Trefferrate als auch Fehlalarmrate erfassen | Ein Kandidat, der zu viele Nicht-Fehler markiert, ist nicht sorgfältiger, sondern nur weniger differenziert. |
| Pilotphase vor dem Festlegen von Grenzwerten | Testen Sie zunächst aktuelle Stelleninhaber, um realistische Erkennungsratenbänder festzulegen, statt Schwellenwerte zu erraten. |
| Assessments schnell mit Talent Approved erstellen | Magic Create generiert rollenspezifische Tests aus einer Stellenbeschreibung, mit integrierter Anti-Cheat-Funktion und KI-Zusammenfassungen. |
Inhaltsverzeichnis
- Warum validierte Assessments für detailorientierte Stellen wichtig sind
- Ein Assessment-Stack aufbauen, der wirklich funktioniert
- Rollenspezifische Arbeitsproben mit eingebetteten Fehlern gestalten
- Bewertungssysteme, die sorgfältige Kandidaten von Glückspilzen trennen
- Assessments einführen ohne Fairness oder Konsistenz zu verlieren
- Was Recruiter bei der Einstellung detailorientierter Mitarbeiter falsch machen
- Einen rollenspezifischen Pilotversuch mit Talent Approved starten
- Quellen
- FAQ
Warum validierte Assessments für detailorientierte Stellen wichtig sind
Recruiter greifen häufig auf den ersten Detailgenauigkeitstest zurück, der bei einer Google-Suche erscheint – eine kostspielige Gewohnheit. Die Forschung zu Auswahlmethoden ist eindeutig: Allgemeine geistige Leistungsfähigkeit sagt Arbeitsleistung bei etwa r = .51 voraus, und Arbeitsproben übertreffen diesen Wert leicht mit r = .54, wie Schmidt und Hunters metaanalytische Arbeiten zur Validität von Auswahlmethoden belegen. Diese Zahlen ergeben sich, weil beide Methoden von den Kandidaten verlangen, eine Aufgabe tatsächlich durchzudenken, anstatt nur zwei Bilder zu vergleichen und einen Unterschied zu suchen.
Verständnis ist entscheidend, denn die meisten realen Fehler sind nicht visueller, sondern kontextueller Natur. Eine Abrechnungsdiskrepanz, eine nicht übereinstimmende Vertragsklausel oder ein vertauschter Versandcode erfordert Fachkenntnisse, nicht nur scharfe Augen. Genau hier versagen geschwindigkeitsbasierte Tests und Selbstauskunftsinstrumente:
- Geschwindigkeitstests messen, wie schnell jemand scannt – was Fachleute als eine andere Fähigkeit bezeichnen als das Erkennen eines wesentlichen Fehlers unter realistischem Zeitdruck
- Selbstauskunftsfragebögen („Sind Sie detailorientiert?") begünstigen sozial erwünschtes Antwortverhalten und korrelieren nur schwach mit tatsächlichem Arbeitsverhalten
- Allgemeine Mustererkennnungsaufgaben ähneln selten den tatsächlichen Inhalten, mit denen Kandidaten im Job umgehen werden
Ein Assessment-Stack aufbauen, der wirklich funktioniert
Kein einzelner Test erfasst Detailgenauigkeit allein. Jede Komponente eines soliden Stacks misst etwas, das die anderen nicht erfassen, und das Weglassen einer Komponente hinterlässt eine Lücke in der Vorhersage.
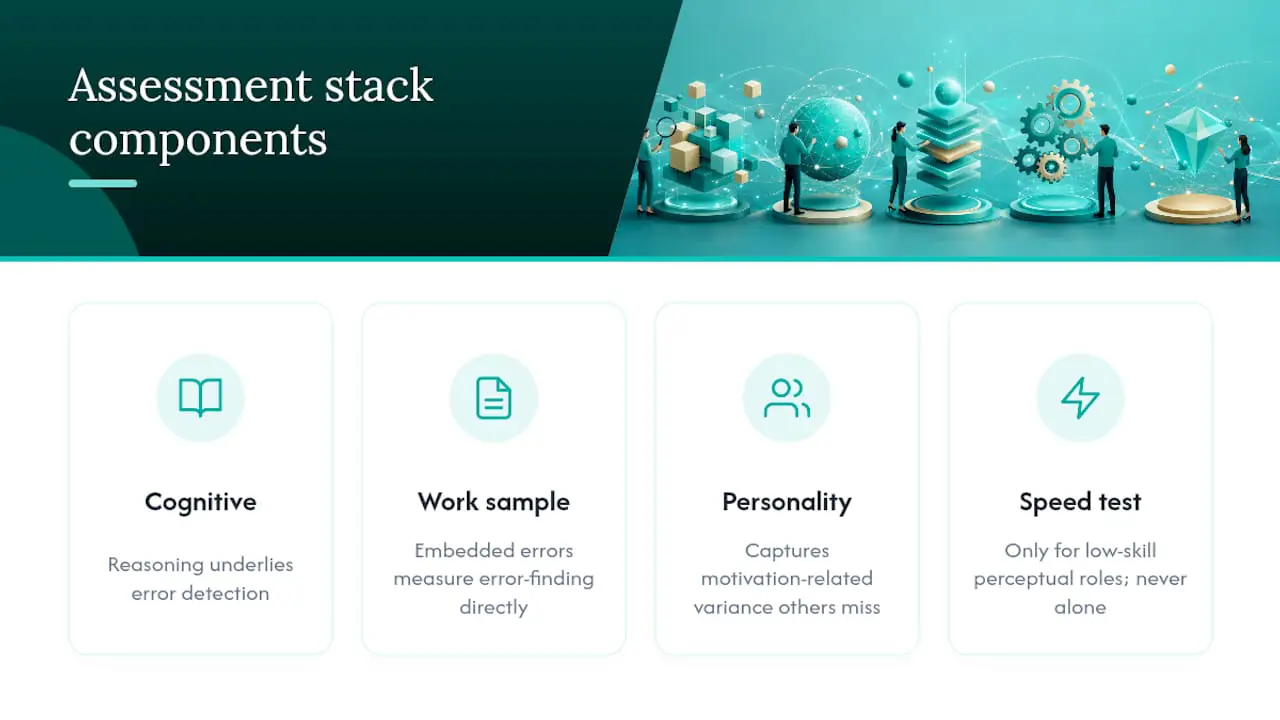
Kognitive Fähigkeitstests stehen an erster Stelle, weil Denkfähigkeit der Fehlererkennung zugrunde liegt. Ein Kandidat, der mehrere Datenpunkte im Arbeitsgedächtnis behalten und gleichzeitig mit einem Regelwerk abgleichen kann, wird einen Kandidaten übertreffen, der lediglich nach visuellen Abweichungen sucht. Kognitive Werte stärken auch die Validität der nachfolgenden Arbeitsprobe, da Kandidaten eine grundlegende Denkfähigkeit benötigen, um Anweisungen korrekt zu interpretieren.
Arbeitsproben mit eingebetteten Fehlern weisen von allen hier genannten Methoden die höchste ökologische Validität auf, da sie das Zielverhalten direkt messen statt einen Ersatzindikator dafür. Ein Kandidat für eine Finanzanalysten-Stelle, der eine Tabelle mit drei eingebetteten Formelfehlern prüft, gibt Ihnen weit mehr Aufschluss als jede abstrakte Aufgabe.
Gewissenhaftigkeit oder Persönlichkeitsmaße fügen eine kleinere, aber reale Ebene hinzu und erfassen motivationsbezogene Varianz, die kognitive Tests und Arbeitsproben nicht vollständig erklären. Ein reiner Geschwindigkeitstest ist nur für gering qualifizierte Wahrnehmungsaufgaben wie einfache Sortierung oder Inspektionslinienarbeit vertretbar, und selbst dort sollte er niemals allein stehen.
Profi-Tipp: Ergänzen Sie jeden kognitiven oder Arbeitsproben-Score durch eine strukturierte Verhaltensfrage, wie zum Beispiel: „Erzählen Sie mir von einer Situation, in der Sie einen Fehler entdeckt haben, den andere übersehen haben." Das bringt reale Ereignisse ans Licht, die Sie überprüfen können – anders als eine selbst bewertete Skala.
Rollenspezifische Arbeitsproben mit eingebetteten Fehlern gestalten
Eine Arbeitsprobe zu erstellen, die tatsächlich Leistung vorhersagt, erfordert mehr als das Einfügen von Tippfehlern in ein Dokument. Gehen Sie dabei in folgender Reihenfolge vor:
- Führen Sie zuerst eine Stellenanalyse durch. Identifizieren Sie die drei bis fünf Aufgaben, bei denen Fehler die höchsten Kosten verursachen, und klassifizieren Sie die häufigen Fehlertypen: Auslassung, Vertauschung, Substitution oder Regelverstoß.
- Passen Sie das Stimulusformat an die tägliche Arbeit an. Eine Finanzstelle benötigt eine Tabelle mit Formelfehlern; eine Logistikstelle benötigt ein Versandmanifest; eine rechtsbezogene Stelle benötigt einen Vertrag mit geänderten Klauseln.
- Betten Sie bewusst verschiedene Fehlertypen ein, kein einzelnes wiederholtes Muster. Kandidaten, die nur eine Art von Fehler sehen, können durch Mustererkennung hohe Punktzahlen erzielen, ohne echte Aufmerksamkeit zu beweisen.
- Setzen Sie großzügige Zeitlimits. Das Ziel ist die Messung von Genauigkeit, nicht Geschwindigkeit – geben Sie Kandidaten also genug Zeit für eine sorgfältige Überprüfung statt einer hastigen Durchsicht.
- Führen Sie einen Pilotversuch mit aktuellen Stelleninhabern durch, bevor Sie den Test für Kandidaten öffnen, und verwenden Sie deren Ergebnisse, um realistische Erkennungsratenziele festzulegen und Fehlalarmraten abzuschätzen.
- Randomisieren Sie die Reihenfolge der Aufgaben und wechseln Sie zwischen mehreren Stimulusversionen, um Auswendiglernen und das Weitergeben von Antworten zwischen Kandidaten zu reduzieren.
Einige Gestaltungsgewohnheiten trennen eine gute Arbeitsprobe von einer schwachen:
- Passen Sie eingebettete Fehler an die tatsächlichen Fehlermuster der Stelle an, statt generische „Suche den Unterschied"-Aufgaben zu verwenden
- Halten Sie Anweisungen eindeutig. Unklare Anweisungen erhöhen Fehlalarmraten aus Gründen, die nichts mit Sorgfalt zu tun haben
- Nehmen Sie Aufgaben aus dem Programm oder überarbeiten Sie sie, wenn alle Pilotteilnehmer sie entweder vollständig richtig oder vollständig falsch beantwortet haben. Keines der beiden Extreme unterscheidet zwischen Kandidaten
Unser Leitfaden zur Gestaltung stellenspezifischer Screening-Tests führt durch diesen Prozess mit weiteren Beispielen, und unser Framework zur Auswahl der zu testenden Fähigkeiten hilft Ihnen dabei, die wichtigsten Fehlertypen für eine bestimmte Stelle einzugrenzen.
Bewertungssysteme, die sorgfältige Kandidaten von Glückspilzen trennen
Rohe Genauigkeit allein verbirgt zu viel. Ein Kandidat, der 9 von 10 eingebetteten Fehlern findet, aber 15 Nicht-Fehler als Probleme markiert, ist nicht sorgfältiger als einer, der 7 von 10 findet und keinen falsch markiert. Genau deshalb ist ein signaldetektionsbasierter Ansatz wichtig: Erfassen Sie sowohl die Erkennungsrate (korrekt identifizierte Fehler) als auch die Fehlalarmrate (fälschlicherweise markierte Nicht-Fehler) für jeden Kandidaten – eine Praxis, die sowohl in akademischen als auch in Practitioner-Quellen zur Messung von Detailgenauigkeit befürwortet wird.
Ein einfacher zusammengesetzter Score kann diese zu einer einzigen Zahl kombinieren, auf die Recruiter reagieren können. Eine praktikable Formel: Zusammengesetzter Detailscore = 0,70 × Genauigkeit + 0,30 × Instruktionstreue, wobei die Rohdatengenauigkeit höher gewichtet wird, während gleichzeitig Kandidaten belohnt werden, die Aufgabenanweisungen präzise befolgen.
Wandeln Sie anschließend zusammengesetzte Scores in Bänder um, die auf Ihren eigenen Pilotdaten basieren – nicht auf geborgten Benchmarks:
| Band | Zusammengesetzter Score-Bereich | Empfohlene Maßnahme |
|---|---|---|
| Einstellen | Oberstes Quartil der Pilotdaten | Direkt zum abschließenden Interview weiterleiten |
| Grenzwertig | Mittlerer Bereich, pilotbasiert | Strukturierte verhaltensbezogene Interviewfrage hinzufügen |
| Entwickeln | Unterstes Quartil der Pilotdaten | Ausschließen oder in eine andere Rollenstufe weiterleiten |
Empfohlene Ausgangspunkte und Zeitrahmen für gängige Rollen – darunter 10- bis 25-minütige Arbeitsproben mit Genauigkeitsschwellen von 80 bis 90 Prozent für Buchhaltungs- und QA-Rollen – geben Ihnen eine vernünftige Ausgangsbasis, bevor Ihre eigenen Pilotdaten diese ersetzen. Präsentieren Sie die Ergebnisse den Einstellungsmanagern in verständlicher Sprache: ein Band-Label sowie zwei oder drei Beispielinterviewfragen, die auf das spezifische Fehlermuster des Kandidaten abgestimmt sind.
Assessments einführen ohne Fairness oder Konsistenz zu verlieren
Konsistenz zwischen den Kandidaten ist kein nettes Extra – sie ist das, was Ihre Scores überhaupt vergleichbar macht. Jeder Kandidat benötigt identische Anweisungen, identische Zeitvorgaben und eine vergleichbare Testumgebung – mit dokumentierten Verfahren für Anpassungen bei Kandidaten, die diese benötigen.
Anti-Cheat-Maßnahmen sind mit echten Kompromissen verbunden, die es vor der Auswahl abzuwägen gilt:
- Browser-Sperrung verhindert Tab-Wechsel, erzeugt jedoch Reibung für Kandidaten mit älteren Geräten
- Sitzungsaufzeichnungen und Webcam-Checks erkennen Zusammenarbeitsversuche, werfen jedoch Datenschutzfragen auf, die einer klaren Offenlegung bedürfen
- Randomisierte Aufgabenversionen reduzieren das Weitergeben von Antworten, ohne dass eine Überwachung erforderlich ist
Auf der Integrationsseite helfen KI-generierte Zusammenfassungen Prüfern dabei, große Bewerberpools schnell zu sichten, aber die endgültige Entscheidung sollte immer ein Mensch treffen – insbesondere bei Grenzwert-Scores. Führen Sie eine Analyse zur Ungleichbehandlung anhand Ihrer Pilotdaten durch, bevor Sie den Test vollständig einführen, und bewahren Sie die Dokumentation Ihres Validierungsprozesses auf. Das ist der Unterschied zwischen einer vertretbaren Einstellungspraxis und einer, die einer rechtlichen Herausforderung nicht standhält.
Profi-Tipp: Führen Sie eine schriftliche Aufzeichnung jeder Pilot-Grenzwertentscheidung und der genehmigenden Person. Wenn eine Einstellungsentscheidung jemals angefochten wird, ist genau dieser Dokumentationsnachweis Ihr Schutz.
Was Recruiter bei der Einstellung detailorientierter Mitarbeiter falsch machen
Die meisten Einstellungsteams behandeln Detailgenauigkeit wie eine Persönlichkeitseigenschaft, die man direkt abfragen kann. Das ist sie nicht, und genau deshalb enttäuschen so viele „detailorientierte" Neueinstellungen innerhalb der ersten neunzig Tage. Die ehrliche Antwort, die in der Validierungsforschung verborgen liegt, lautet: Detailgenauigkeit ist ein beobachtbares Verhalten unter realistischen Aufgabenbedingungen, keine selbst berichtete Eigenschaft – und die einzige zuverlässige Methode, ein Verhalten zu messen, besteht darin, es zu beobachten.
Der konventionelle Rat, „einige Suche-den-Unterschied-Aufgaben in Ihren Screening-Prozess einzubauen", wirkt sich aktiv negativ auf gute Einstellungen aus. Diese Aufgaben messen die visuelle Verarbeitungsgeschwindigkeit – eine reale, aber enge Fähigkeit, die wenig damit zu tun hat, einen falsch angewendeten Rabattcode oder einen nicht übereinstimmenden Patientendatensatz zu erkennen. Recruiter, die sich auf sie verlassen, wählen letztlich schnelle Scanner aus, keine sorgfältigen Denker.
Wenn Sie eine Sache aus diesem Artikel mitnehmen: Priorisieren Sie die Entwicklung einer Arbeitsprobe, bevor Sie einen vorgefertigten Test kaufen. Ein allgemeines Assessment kann nicht wissen, wie die Abrechnungsfehler in Ihrem Unternehmen im Vergleich zu denen Ihrer Konkurrenten aussehen. Stellenspezifische Fehlermuster sind der eigentliche Kern – und das Überspringen dieses Schritts untergräbt alles andere im Stack.
— Jimmie
Einen rollenspezifischen Pilotversuch mit Talent Approved starten
Diesen Stack von Grund auf aufzubauen bedeutete früher wochenlange Aufgabenentwicklung und einen Validierungsberater auf Abruf. Talent Approved reduziert das auf einen Nachmittag – was besonders für Recruiting-Teams wichtig ist, die ein rollenspezifisches Assessment vor Schließung der nächsten Stelle und nicht erst im nächsten Quartal benötigen.
Hier ist eine praktikable Pilotsequenz mit der Plattform. Fügen Sie zunächst Ihre Stellenbeschreibung in Magic Create ein und lassen Sie ein erstes Assessment-Entwurf erstellen, der auf die Rolle abgestimmt ist. Überprüfen Sie dann den Entwurf und betten Sie die spezifischen Fehlertypen ein, die Ihre Stellenanalyse identifiziert hat – ob Vertauschungsfehler in einer Dateneingabe-Rolle oder Regelverstöße in einer Compliance-Checkliste. Aktivieren Sie anschließend die integrierte Anti-Cheat-Überwachung und KI-generierte Zusammenfassungen, damit Ihr Prüfteam Ergebnisse schnell sichten kann und dabei einen vollständigen Prüfpfad behält. Führen Sie das Assessment schließlich mit 10 bis 30 aktuellen Stelleninhabern durch, bevor Sie es für Kandidaten öffnen, und nutzen Sie deren Scores, um Ihre Einstellen-, Grenzwert- und Entwickeln-Bänder festzulegen.
Für Vorlagen und Gestaltungs-Checklisten beim Aufbau bieten unsere Leitfäden zur Gestaltung administrativer Arbeitsproben und zur Durchführung von Assessments in einem ATS-Workflow beide Themen ausführlicher ab. Wenn Sie strukturierte Folgefragen benötigen, sobald die Ergebnisse vorliegen, ist der Generator für verhaltensbezogene Interviewfragen von NueCareer ein solides Begleittool.
Möchten Sie es in Aktion sehen? Beginnen Sie mit der Erstellung Ihres ersten Assessments und haben Sie innerhalb einer Stunde einen pilotfähigen Test.
Quellen
FAQ
Welche Fähigkeiten sollte ein Detailgenauigkeits-Assessment messen?
Es sollte Fehlererkennung unter realistischen Aufgabenbedingungen messen, nicht die visuelle Scangeschwindigkeit. Die stärksten Assessments kombinieren einen validierten kognitiven Fähigkeitstest mit einer rollenspezifischen Arbeitsprobe, die eingebettete Fehler wie Auslassungen, Vertauschungen oder Regelverstöße enthält.
Sind Selbstauskunftsfragen zur Detailgenauigkeit zuverlässig?
Nein. Selbstauskunftsfragen wie „Sind Sie detailorientiert?" begünstigen sozial erwünschtes Antwortverhalten und korrelieren schlecht mit tatsächlicher Genauigkeit im Job – weshalb leistungsbasierte Arbeitsproben die bessere Wahl bleiben.
Wie lange sollte ein Arbeitsproben-Test dauern?
Die meisten rollenspezifischen Arbeitsproben dauern 10 bis 25 Minuten – lang genug, damit Kandidaten eine sorgfältige Überprüfung durchführen können, ohne die Übung in einen Geschwindigkeitstest zu verwandeln.
Kann Talent Approved einen rollenspezifischen Detailgenauigkeitstest erstellen?
Ja. Das Magic Create-Tool von Talent Approved generiert ein maßgeschneidertes Assessment direkt aus einer Stellenbeschreibung, und die integrierte Anti-Cheat-Überwachung sowie KI-generierte Zusammenfassungen unterstützen eine schnelle, vertretbare Auswertung.
Was ist ein guter Ausgangs-Genauigkeitsbenchmark?
Viele QA- und Buchhaltungsrollen beginnen mit Pilot-Benchmarks von etwa 80 bis 90 Prozent Genauigkeit, wobei der richtige Schwellenwert für Ihre Organisation aus einem Pilotversuch mit Ihren eigenen aktuellen Stelleninhabern abgeleitet werden sollte.