
Detaljorienterte jobber: Tester som faktisk forutsier det
Den sterkeste prediktoren for nøyaktighetsprestasjoner er ikke en personlighetsquiz eller en tidtatt mønstergjenkjenningsøvelse. Det er en validert kognitiv evnetest kombinert med en rollespecifik arbeidsoppgave med innplantede feil, støttet av strukturerte atferdsbaserte intervjuspørsmål. Arbeidsoppgaver har en metaanalytisk validitet på omtrent r = .54 for å forutsi jobbprestasjoner, og Attention to Detail Test (ADT) gir prestasjonsbasert dokumentasjon på at denne typen testing forutsier overordnedes vurderinger av detaljorienterte arbeidsoppgaver. Fartsorienterte tester og selvrapporteringsskjemaer holder ikke på langt nær like godt.
Her er stakken vi anbefaler for å evaluere jobber som krever nøyaktighet:
- En validert test for generell mental evne (GMA) for å måle resonneringskapasitet
- En rollespecifik arbeidsoppgave med bevisst innplantede feil, tidsavgrenset for å måle nøyaktighet fremfor hastighet
- Strukturerte atferdsbaserte intervjuspørsmål knyttet til virkelige hendelser, ikke generelle selvvurderingsspørsmål
Talent Approved sitt Magic Create-verktøy bygger disse rollespecifikke vurderingene direkte fra en stillingsbeskrivelse på få minutter, og innebygd juks-overvåkning samt AI-genererte sammendrag gjør gjennomgangsprosessen rask uten å gå på bekostning av grundighet.
Viktige poenger
En validert kombinasjon av kognitiv evnetesting, rollespecifikke arbeidsoppgaver med innplantede feil og strukturerte atferdsbaserte intervjuer forutsier nøyaktighetsprestasjon langt mer pålitelig enn hastighetstester eller selvrapporteringsskjemaer.
| Poeng | Detaljer |
|---|---|
| Unngå fartsorienterte tester | Oppgaver som måler prosesseringshastighet måler skanningshastighet, ikke reell feildeteksjon på jobben. |
| Arbeidsoppgaver leder validiteten | Arbeidsoppgaver viser metaanalytisk validitet rundt r = .54, noe som overgår generelle kognitive evnetester. |
| Skår både treffraten og falsk alarm-raten | En kandidat som flagger for mange ikke-feil er ikke mer nøyaktig, bare mindre treffsikker. |
| Pilottester før du setter grenseverdier | Test eksisterende ansatte først for å sette realistiske deteksjonsrater i stedet for å gjette på terskler. |
| Bygg vurderinger raskt med Talent Approved | Magic Create genererer rollespecifikke tester fra en stillingsbeskrivelse, med innebygd juks-overvåkning og AI-sammendrag. |
Innholdsfortegnelse
- Hvorfor validerte vurderinger er viktige for jobber som krever nøyaktighet
- Bygge en vurderingsstakk som faktisk fungerer
- Slik designer du rollespecifikke arbeidsoppgaver med innplantede feil
- Poengsystemer som skiller nøye kandidater fra heldige
- Rulle ut vurderinger uten å miste rettferdighet eller konsistens
- Hva rekrutterere gjør feil ved ansettelser som krever nøyaktighet
- Prøv et rollespecifikt pilotprosjekt med Talent Approved
- Kilder
- FAQ
Hvorfor validerte vurderinger er viktige for jobber som krever nøyaktighet
Rekrutterere faller ofte tilbake på den første nøyaktighetstesten som dukker opp i et Google-søk, og det er en kostbar vane. Forskningen på utvelgelsesmetoder er utvetydig: generell mental evne forutsier jobbprestasjoner med omtrent r = .51, og arbeidsoppgaver overgår dette noe med r = .54, ifølge Schmidt og Hunters metaanalytiske arbeid om validiteten til utvelgelsesmetoder. Disse tallene eksisterer fordi begge metodene krever at kandidatene faktisk resonnerer gjennom en oppgave, i stedet for å bare kaste et blikk på to bilder og se hvilket som ser annerledes ut.
Forståelse er viktig fordi de fleste feil i den virkelige verden ikke er visuelle – de er kontekstuelle. Et faktureringavvik, en mismatched kontraktsklausul eller en feilstavet fraktkode krever domenekunnskap, ikke bare skarpe øyne. Det er nettopp her fartsorienterte tester og selvrapporteringsverktøy svikter:
- Hastighetstester måler hvor raskt noen skanner, noe praktikere påpeker er en annen ferdighet enn det å oppdage en vesentlig feil under realistisk tidspress
- Selvrapporteringsskjemaer («Er du detaljorientert?») inviterer til sosialt ønskelig svaradferd og korrelerer dårlig med faktisk jobbatferd
- Generiske mønstergjenkjenningspuslespill ligner sjelden det faktiske innholdet kandidatene vil håndtere i jobben
Bygge en vurderingsstakk som faktisk fungerer
Ingen enkelt test fanger opp nøyaktighet alene. Hver komponent i en solid stakk måler noe de andre ikke fanger opp, og å hoppe over én etterlater et hull i prediksjonen din.
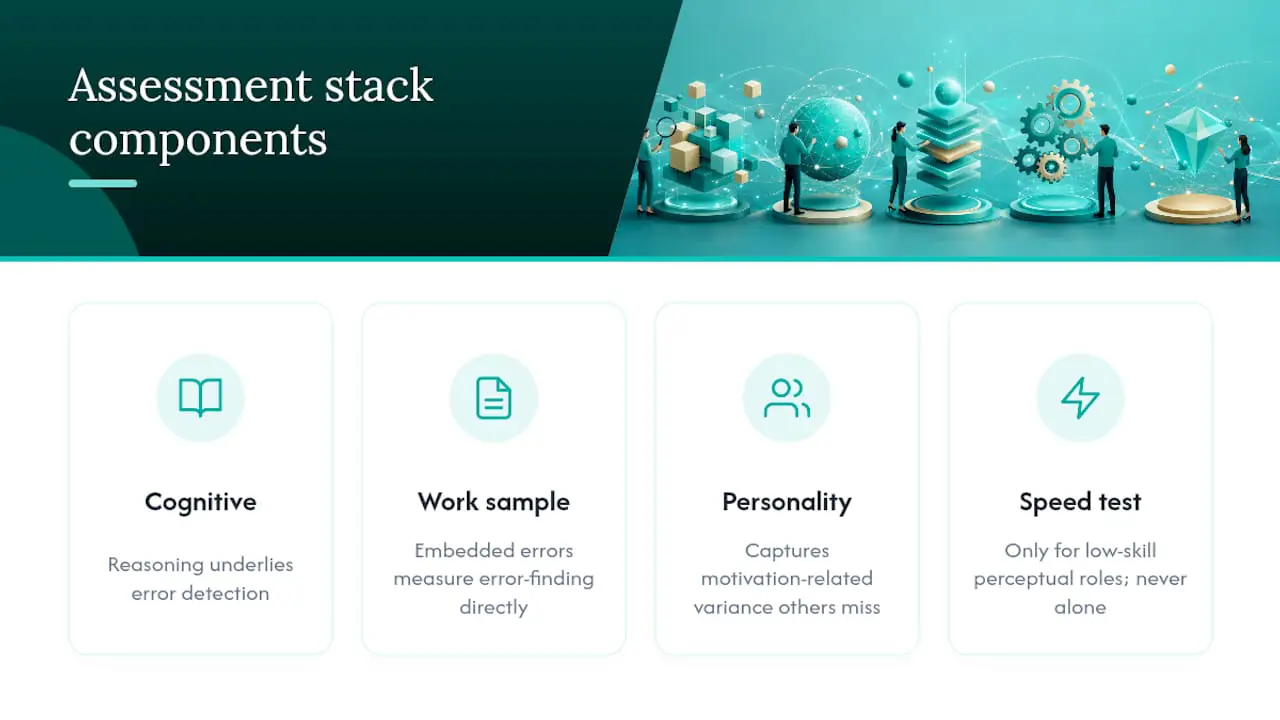
Kognitiv evnetesting kommer først fordi resonnering er grunnlaget for feildeteksjon. En kandidat som kan holde flere datapunkter i arbeidsminnet mens de sammenligner dem mot et regelsett, vil prestere bedre enn en som bare skanner visuelt etter avvik. Kognitive skårer styrker også validiteten til arbeidsoppgaven som følger, siden kandidatene trenger grunnleggende resonneringskapasitet for å tolke instruksjonene korrekt.
Arbeidsoppgaver med innplantede feil har den høyeste økologiske validiteten av alle metodene her, fordi de måler den målrettede atferden direkte i stedet for en stedfortreder for den. En finansanalytikerkanidat som gjennomgår et regneark med tre innplantede formel-feil, forteller deg langt mer enn et abstrakt puslespill noen gang ville gjort.
Personlighets- eller samvittighetsmål tilføyer et mindre, men reelt lag, og fanger opp motivasjonsrelatert varians som kognitive tester og arbeidsoppgaver ikke forklarer fullt ut. En smal hastighetstest er bare forsvarlig for lavkvalifiserte perseptuelle roller som enkel sortering eller inspeksjonslinjejobb, og selv da bør den aldri stå alene.
Proffips: Par alltid en kognitiv eller arbeidsoppgave-skår med ett strukturert atferdsspørsmål, for eksempel «Fortell meg om en gang du fanget opp en feil noen andre overså.» Det avdekker virkelige hendelser du kan verifisere, i motsetning til en selvvurdert skala.
Slik designer du rollespecifikke arbeidsoppgaver med innplantede feil
Å bygge en arbeidsoppgave som faktisk forutsier prestasjon krever mer enn å slippe skrivefeil inn i et dokument. Følg denne rekkefølgen:
- Gjennomfør en jobbanalyse først. Identifiser de tre til fem oppgavene der feil har høyest kostnad, og klassifiser de vanlige feiltypene: utelatelse, transporsisjon, substitusjon eller regelbrudd.
- Match stimulusformatet til daglig arbeid. En finansrolle trenger et regneark med formel-feil; en logistikkrolle trenger et fraktmanifest; en juridisk-tilknyttet rolle trenger en kontrakt med endrede klausuler.
- Integrer en bevisst blanding av feiltyper, ikke et enkelt gjentatt mønster. Kandidater som bare ser én type feil, kan mønstermatchende seg til høy skår uten å demonstrere reell nøyaktighet.
- Sett romslige tidsrammer. Målet er å måle nøyaktighet, ikke hastighet, så gi kandidatene nok tid til å gjennomføre en grundig gjennomgang fremfor en forhastet skanning.
- Pilotttest med nåværende ansatte før testen rulles ut til kandidater, og bruk deres skårer til å sette realistiske deteksjonsratemål og estimere falsk alarm-rater.
- Randomiser rekkefølgen på oppgavene og roter mellom flere stimulusversjoner for å redusere memorering og svarsdeling mellom kandidater.
Noen designvaner skiller en sterk arbeidsoppgave fra en svak:
- Match innplantede feil til rollens faktiske sviktmønstre fremfor generiske «finn forskjellen»-oppgaver
- Hold instruksjonene utvetydige. Forvirrende instruksjoner øker falsk alarm-rater av årsaker som ikke har noe med nøyaktighet å gjøre
- Fjern eller omarbeid oppgaver der alle pilotdeltakerne enten svarer perfekt riktig eller fullstendig feil. Ingen av ytterpunktene diskriminerer mellom kandidater
Vår guide til å designe jobbespecifikke screeningtester går gjennom denne prosessen med flere eksempler, og vårt rammeverk for å velge hvilke ferdigheter som skal testes hjelper deg med å snevre inn hvilke feiltyper som betyr mest for en gitt rolle.
Poengsystemer som skiller nøye kandidater fra heldige
Rå nøyaktighet alene skjuler for mye. En kandidat som fanger opp 9 av 10 innplantede feil, men flagger 15 ikke-feil som problemer, er faktisk ikke mer nøyaktig enn en som fanger opp 7 av 10 og ikke flagger noe. Dette er nettopp grunnen til at et signaldeteksjonsperspektiv er viktig: rapporter både deteksjonsraten (feil som er korrekt identifisert) og falsk alarm-raten (ikke-feil som er feilaktig flagget) for hver kandidat – en praksis støttet av både akademiske og praktiske kilder om nøyaktighetsmåling.
En enkel sammensatt skår kan kombinere disse til ett tall rekrutterere kan handle på. En brukbar formel: Sammensatt detaljskår = 0,70 × nøyaktighet + 0,30 × instruksjonsfidelitet, som vekter rå nøyaktighet høyere mens den fortsatt belønner kandidater som følger oppgaveinstruksjonene nøyaktig.
Deretter konverterer du sammensatte skårer til bånd hentet fra dine egne pilotdata, ikke lånte referanseverdier:
| Bånd | Sammensatt skårområde | Anbefalt handling |
|---|---|---|
| Ansett | Øverste pilotkvartil | Gå direkte videre til sluttintervju |
| Grenseland | Midtområde, pilotbasert | Legg til et strukturert atferdsintervjuspørsmål |
| Utvikle | Nederste pilotkvartil | Sil ut eller henvis til et annet rollenivå |
Foreslåtte utgangspunkter og tidsrammer for vanlige roller – inkludert 10 til 25 minutters arbeidsoppgaver med 80 til 90 prosents nøyaktighetsterskler for regnskaps- og kvalitetssikringsroller – gir deg et rimelig utgangspunkt før dine egne pilotdata erstatter det. Presentér resultater for ansettelsesansvarlige på et enkelt språk: et båndmerke pluss to eller tre eksempelintervjuspørsmål knyttet til kandidatens spesifikke fealmønster.
Rulle ut vurderinger uten å miste rettferdighet eller konsistens
Konsistens på tvers av kandidater er ikke et hyggelig tillegg – det er det som gjør skårene dine sammenlignbare i det hele tatt. Alle kandidater trenger identiske instruksjoner, identisk tid og et sammenlignbart testmiljø, med dokumenterte tilretteleggingsprosedyrer for kandidater som trenger det.
Juks-forebyggende tiltak innebærer reelle avveininger det er verdt å vurdere før du velger en:
- Nettleserlåsing forhindrer fanebytte, men skaper friksjon for kandidater på eldre enheter
- Øktavspilling og webkamerasjekker fanger opp samarbeidsforsøk, men reiser personvernhensyn som krever tydelig opplysning
- Randomiserte oppgaveversjoner reduserer svarsdeling uten å kreve noen overvåkning i det hele tatt
På integrasjonssiden hjelper AI-genererte sammendrag gjennomgangsteam med å triage store kandidatgrupper raskt, men et menneske bør alltid ta den endelige beslutningen – særlig ved grenselandsskårer. Gjennomfør en analyse av uønskede konsekvenser for undergrupper på dine pilotdata før full utrulling, og oppbevar dokumentasjon av valideringsprosessen din. Det er forskjellen mellom en forsvarlig ansettelsespraksis og en som kollapser under en juridisk utfordring.
Proffips: Oppbevar skriftlig dokumentasjon over alle pilotgrenseverdibeslutninger og hvem som godkjente dem. Hvis en ansettelsesavgjørelse noen gang stilles spørsmål ved, er det dette sporløpet som beskytter deg.
Hva rekrutterere gjør feil ved ansettelser som krever nøyaktighet
De fleste ansettelsesgrupper behandler nøyaktighet som et personlighetstrekk man kan spørre direkte om. Det er det ikke, og det er grunnen til at så mange «detaljorienterte» nyansettelser skuffer innen de første nitti dagene. Det ærlige svaret som er begravd i validitetsforskningen er at nøyaktighet er en demonstrert atferd under realistiske oppgaveforhold, ikke en selvrapportert egenskap, og den eneste pålitelige måten å måle atferd på er å observere den.
Det konvensjonelle rådet – «legg til noen finn-forskjellen-puslespill i screeningprosessen» – motvirker aktivt god ansettelse. Disse puslespillene måler visuell prosesseringshastighet, en reell men smal ferdighet som har lite å gjøre med å oppdage en feilaktig brukt rabattkode eller et mismatched pasientregister. Rekrutterere som baserer seg på dem, ender opp med å velge ut raske skannere, ikke nøye tenkere.
Hvis du tar én ting med deg fra dette: prioriter å bygge en arbeidsoppgave før du kjøper noen ferdigpakket test. En generisk vurdering kan ikke vite at fakturafeilene dine ser annerledes ut enn konkurrentens. Jobbespecifikke fealmønstre er hele poenget, og å hoppe over det steget undergraver alt annet i stakken.
— Jimmie
Prøv et rollespecifikt pilotprosjekt med Talent Approved
Å bygge denne stakken fra bunnen av pleide å bety uker med oppgaveutvikling og en valideringskonsulent på fast oppdrag. Talent Approved reduserer dette til en ettermiddag, noe som betyr mest for rekrutteringsteam som trenger en rollespecifik vurdering klar før neste stillingsbehovet lukkes – ikke neste kvartal.
Her er en brukbar pilotsekvens ved hjelp av plattformen. Først mater du stillingsbeskrivelsen din inn i Magic Create og lar den generere et førsteutkast til vurdering tilpasset rollen. Deretter gjennomgår du utkastet og integrerer de spesifikke fealtypene jobbanalysen din identifiserte – enten det er transposisjonsfeil i en datainntastingsrolle eller regelbrudd i en sjekkliste for etterlevelse. For det tredje aktiverer du den innebygde juks-overvåkningsfunksjonen og AI-genererte sammendrag slik at gjennomgangsteamet ditt kan triage resultater raskt med fullstendig revisjonslogg. For det fjerde kjører du vurderingen med 10 til 30 eksisterende ansatte før du åpner den for kandidater, og bruker deres skårer til å sette dine ansett-, grenseland- og utvikle-bånd.
For maler og designsjekklister mens du bygger, dekker våre guider om design av administrative arbeidsoppgaver og pilotering av vurderinger på tvers av en ATS-arbeidsflyt begge deler i mer dybde. Hvis du ønsker strukturerte oppfølgingsspørsmål etter at skårene foreligger, er NueCareer sitt verktøy for atferdsbaserte intervjuspørsmål et solid tilleggsverktøy.
Klar til å se det i praksis? Begynn å bygge din første vurdering og ha en pilotferdig test innen en time.
Kilder
FAQ
Hvilke ferdigheter bør en nøyakthetsvurdering måle?
Den bør måle feildeteksjon under realistiske oppgaveforhold, ikke visuell skanningshastighet. De sterkeste vurderingene kombinerer en validert kognitiv evnetest med en rollespecifik arbeidsoppgave som inneholder innplantede feil som utelatelser, transposisjoner eller regelbrudd.
Er selvrapporterte nøyaktighetsspørsmål pålitelige?
Nei. Selvrapportsspørsmål som «Er du detaljorientert?» inviterer til sosialt ønskelig svaradferd og korrelerer dårlig med faktisk nøyaktighet på jobben, noe som er grunnen til at prestasjonsbaserte arbeidsoppgaver forblir det sterkere valget.
Hvor lang tid bør en arbeidsoppgavetest ta?
De fleste rollespecifikke arbeidsoppgaver tar 10 til 25 minutter – lenge nok til at kandidatene kan gjennomføre en grundig gjennomgang uten at øvelsen blir en hastighetstest.
Kan Talent Approved bygge en rollespecifik nøyaktighetstest?
Ja. Talent Approved sitt Magic Create-verktøy genererer en skreddersydd vurdering direkte fra en stillingsbeskrivelse, og innebygd juks-overvåkning samt AI-genererte sammendrag støtter rask og forsvarlig gjennomgang.
Hva er en god startverdi for nøyaktighetsbenchmark?
Mange kvalitetssikrings- og regnskapsroller starter pilotbenchmarker rundt 80 til 90 prosents nøyaktighet, selv om den riktige terskelen for din organisasjon bør komme fra å pilotteste testen med dine egne eksisterende ansatte først.