
注重细节岗位:真正能预测细节能力的测评方法
预测细节注意力表现最强的指标,既不是人格测验,也不是限时图案识别练习,而是经过验证的认知能力测试,配合包含植入错误的岗位特定工作样本,并辅以结构化行为面试问题。工作样本的元分析效度约为 r = .54,在预测工作绩效方面表现突出;注意力细节测试(ADT)也提供了基于绩效的证据,证明此类测试能够预测主管对细节导向任务的评分。而仅测速度的测试和自我报告问卷的表现则差得多。
以下是我们推荐的细节注意力岗位评估方案:
- 经过验证的一般心理能力(GMA)测试,用于衡量推理能力
- 包含故意嵌入错误的岗位特定工作样本,计时以衡量准确性而非速度
- 与真实事件挂钩的结构化行为面试探针,而非泛泛的自我评估问题
Talent Approved 的 Magic Create 工具可在几分钟内直接根据职位描述生成岗位特定评估,其防作弊监控和 AI 生成摘要功能让审核流程快速高效,同时不牺牲严谨性。
核心要点
经过验证的认知能力测试、包含植入错误的岗位特定工作样本以及结构化行为面试的组合方案,预测细节注意力表现的可靠性远高于速度测试或自我报告问卷。
| 要点 | 详情 |
|---|---|
| 避免仅靠速度测试 | 处理速度类测题衡量的是扫描速度,而非工作中的实际错误检测能力。 |
| 工作样本效度领先 | 工作样本的元分析效度约为 r = .54,略优于一般认知能力测试。 |
| 同时记录命中率和虚报率 | 将过多非错误标记为错误的候选人并非更仔细,只是辨别力更差。 |
| 设定临界值前先试点 | 先对现任员工进行测试,以设定切实可行的检测率区间,而非凭空猜测阈值。 |
| 借助 Talent Approved 快速构建评估 | Magic Create 可根据职位描述生成岗位特定测试,内置防作弊功能和 AI 摘要。 |
目录
- 为什么经过验证的评估对细节注意力岗位至关重要
- 构建真正有效的评估方案组合
- 如何设计包含植入错误的岗位特定工作样本
- 区分谨慎候选人与幸运候选人的评分系统
- 在不失公平性和一致性的前提下推行评估
- 招聘人员在细节注意力招聘中的常见误区
- 使用 Talent Approved 试行岗位特定试点
- 参考来源
- 常见问题
为什么经过验证的评估对细节注意力岗位至关重要
招聘人员往往默认使用 Google 搜索结果中最先出现的细节注意力测试,这是一种代价高昂的习惯。关于选拔方法的研究结论非常明确:一般心理能力预测工作绩效的效度约为 r = .51,而工作样本的效度略高,约为 r = .54,这一结论来自 Schmidt 和 Hunter 关于选拔方法效度的元分析研究。这些数字之所以存在,是因为两种方法都要求候选人真正通过推理完成任务,而不仅仅是扫视两张图片找出不同之处。
理解力至关重要,因为现实中的大多数错误并非视觉层面的,而是情境层面的。账单差异、合同条款不匹配或货运代码转置,需要的是领域理解力,而不仅仅是敏锐的眼力。这正是基于速度的测试和自我报告工具的软肋所在:
- 速度测试衡量的是扫描速度,从业者指出这与在真实时间压力下发现实质性错误是不同的技能
- 自我报告问卷("你注重细节吗?")会引发社会期望偏差,与实际工作行为的相关性较差
- 通用图案匹配测题很少与候选人在工作中实际处理的内容相似
构建真正有效的评估方案组合
没有任何单一测试能够单独衡量细节注意力。一个强大的评估组合中,每个组成部分都能衡量其他部分所遗漏的内容,缺少其中任何一个都会在预测中留下空白。
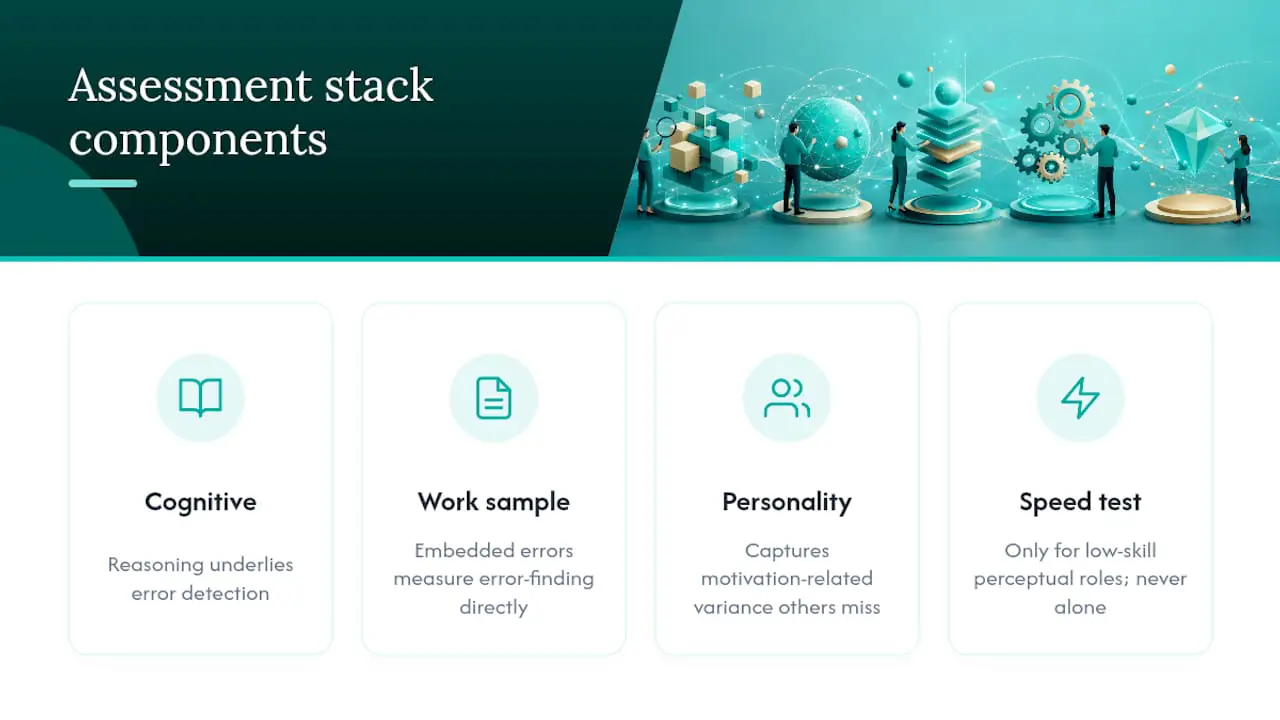
认知能力测试排在首位,因为推理能力是错误检测的基础。能够在工作记忆中同时保持多个数据点并与规则集进行比对的候选人,表现将优于仅凭视觉扫描寻找差异的候选人。认知能力得分还能增强后续工作样本的效度,因为候选人需要具备基本推理能力才能正确理解指令。
包含嵌入错误的工作样本在所有方法中具有最高的生态效度,因为它直接衡量目标行为,而非其替代指标。一名财务分析师候选人审阅一份包含三个植入公式错误的电子表格,所能传达的信息远比任何抽象测题多得多。
尽责性或人格测量增加了一个较小但真实的层面,能够捕捉认知和工作样本测试无法完全解释的动机相关变量。对于基本分拣或流水线检验等低技能感知类岗位,单纯的速度测试勉强可以接受,但即便如此,它也不应单独使用。
专业提示: 将每项认知或工作样本得分与一个结构化行为问题配对,例如"请告诉我一次你发现了别人遗漏的错误的经历。"这能挖掘出可以核实的真实事件,与自评量表不同。
如何设计包含植入错误的岗位特定工作样本
构建一个真正能预测绩效的工作样本,远不止是在文档中随意放入几个错别字。请按照以下步骤操作:
- 首先进行岗位分析。识别错误代价最高的三到五项任务,并对常见的失误类型进行分类:遗漏、转置、替换或规则违反。
- 将刺激材料的格式与日常工作匹配。财务岗位需要包含公式错误的电子表格;物流岗位需要货运清单;法律相关岗位需要包含修改条款的合同。
- 嵌入多种错误类型的刻意组合,而非单一重复的模式。只见过一种错误的候选人可以通过模式匹配获得高分,而不需要展示真正的专注力。
- 设置宽裕的时间限制。目标是衡量准确性而非速度,因此要给候选人足够的时间完成仔细审阅,而不是匆忙浏览。
- 在向候选人推出测试前,先对现任员工进行试点,并利用他们的得分设定切实可行的检测率目标,同时估算虚报率。
- 随机排列题目顺序并轮换多个刺激材料版本,以减少记忆和候选人之间相互传递答案的情况。
以下几种设计习惯能将优秀的工作样本与普通的区分开来:
- 将植入错误与该岗位实际失误模式匹配,而非采用通用的"找不同"题目
- 保持指令清晰无歧义。指令混乱会因与专注力无关的原因而导致虚报率升高
- 淘汰或修改所有试点参与者全部答对或全部答错的题目,两种极端情况都无法区分候选人
我们的岗位特定筛选测试设计指南通过更多示例详细介绍了这一流程,我们的测试技能选择框架可帮助您缩小特定岗位最关键错误类型的范围。
区分谨慎候选人与幸运候选人的评分系统
单纯的原始准确率隐藏了太多信息。一名发现了 10 个植入错误中的 9 个、但将 15 个非错误标记为问题的候选人,实际上并不比发现 10 个中的 7 个且未误报任何内容的候选人更仔细。这正是信号检测视角的价值所在:对每位候选人同时报告检测率(正确识别的错误数)和虚报率(错误标记的非错误数),这一做法得到了细节注意力测量领域学术界和从业者来源的共同支持。
一个简单的综合得分可以将这些指标合并为一个招聘人员可以采取行动的数字。一个可行的公式:综合细节得分 = 0.70 × 准确率 + 0.30 × 指令遵从度,在给予原始准确率更高权重的同时,仍对精确遵循任务指令的候选人予以奖励。
在此基础上,根据您自己的试点数据(而非借用外部基准)将综合得分转化为区间:
| 区间 | 综合得分范围 | 建议操作 |
|---|---|---|
| 录用 | 试点最高四分位 | 直接进入最终面试 |
| 边缘 | 试点中间区间 | 增加一个结构化行为面试探针 |
| 待发展 | 试点最低四分位 | 淘汰或引导至其他岗位层级 |
常见岗位的建议起始点和时间安排,包括会计和质保岗位 10 至 25 分钟的工作样本以及 80% 至 90% 的准确率阈值,在您自己的试点数据取代这些参考值之前,可作为合理的基准。向招聘经理以通俗语言呈现结果:一个区间标签,加上与候选人具体错误模式挂钩的两到三个面试问题。
在不失公平性和一致性的前提下推行评估
候选人之间的一致性不是锦上添花,而是使您的得分具有可比性的根本前提。每位候选人都需要获得相同的指令、相同的时间限制,以及可比的测试环境,同时要为有需要的候选人准备有文档记录的合理便利措施。
防作弊措施存在真实的权衡,值得在选择前仔细权衡:
- 浏览器锁定可防止切换标签页,但会给使用旧设备的候选人增加摩擦
- 会话回放和摄像头检查可发现协作尝试,但会引发隐私方面的顾虑,需要明确披露
- 随机化题目版本可减少答案共享,且完全不需要任何监控措施
在集成方面,AI 生成摘要可帮助审核人员快速筛选大量候选人,但最终决定应始终由人类作出,尤其是在边缘得分的情况下。在全面推出前对试点数据进行不利影响分析,并保存验证过程的文档记录。这是可防御的招聘实践与在法律挑战下崩溃的招聘实践之间的区别。
专业提示: 保留每次试点临界值决定及审批人的书面记录。一旦招聘决定受到质疑,这份纸质记录就是保护您的屏障。
招聘人员在细节注意力招聘中的常见误区
大多数招聘团队将细节注意力视为一种可以直接询问的人格特质。事实并非如此,正因如此,许多"注重细节"的录用者在入职后九十天内便令人失望。埋藏在效度研究中的诚实答案是:细节注意力是在真实任务条件下展现出来的行为,而非自我报告的品质;而衡量行为的唯一可靠方式就是观察它。
常规建议"在筛选流程中加入几道找不同测题",实际上适得其反。这类测题衡量的是视觉处理速度——一种真实但狭窄的技能,与发现错误应用的折扣代码或不匹配的患者记录几乎没有关系。依赖这类测题的招聘人员最终选出的是快速扫描者,而非谨慎的推理者。
如果您只能从本文中带走一点:在购买任何现成测试之前,优先构建工作样本。通用评估无法了解您的账单错误与竞争对手的有何不同。岗位特定的错误模式才是核心所在,跳过这一步会削弱评估组合中的其他一切。
— Jimmie
使用 Talent Approved 试行岗位特定试点
从零开始构建这套方案,过去意味着数周的题目编写和长期聘用验证顾问。Talent Approved 将其压缩到一个下午,这对于需要在下一个职位需求关闭前而非下个季度上线岗位特定评估的招聘团队来说尤为重要。
以下是使用该平台的可行试点流程。第一步,将您的职位描述输入 Magic Create,让它生成与该岗位匹配的初稿评估。第二步,审阅初稿并嵌入您的岗位分析所识别的特定错误类型,无论是数据录入岗位的转置错误还是合规检查表中的规则违反。第三步,开启内置防作弊监控和 AI 生成摘要,让您的审核团队能够快速筛选结果,同时保留完整的审计记录。第四步,在向候选人开放之前,先对 10 至 30 名现任员工进行测试,利用他们的得分设定录用、边缘和待发展区间。
在构建过程中,如需模板和设计检查清单,我们关于行政工作样本设计及在 ATS 工作流程中试行评估的指南,对这两方面均有更深入的介绍。如果您希望在得分出来后获得结构化的跟进问题,NueCareer 的行为面试问题生成工具是一个可靠的配套工具。
准备好亲眼见证效果了吗?立即开始构建您的第一个评估,一小时内即可完成试点就绪的测试。
参考来源
常见问题
细节注意力评估应衡量哪些技能?
它应该衡量在真实任务条件下的错误检测能力,而非视觉扫描速度。最有效的评估将经过验证的认知能力测试与包含植入错误(如遗漏、转置或规则违反)的岗位特定工作样本相结合。
细节注意力自我报告问题可靠吗?
不可靠。"你注重细节吗?"这类自我报告问题会引发社会期望偏差,与实际工作准确性的相关性较差,这正是基于绩效的工作样本仍是更优选择的原因。
工作样本测试应持续多长时间?
大多数岗位特定工作样本持续 10 至 25 分钟,时间足够候选人完成仔细审阅,同时不会将测试变成速度竞赛。
Talent Approved 能否构建岗位特定的细节注意力测试?
可以。Talent Approved 的 Magic Create 工具可直接根据职位描述生成定制化评估,内置防作弊监控和 AI 生成摘要,支持快速、可防御的审核流程。
良好的起始准确率基准是多少?
许多质保和会计岗位的试点基准准确率约为 80% 至 90%,但适合您组织的正确阈值应通过首先对您自己的现任员工进行测试来确定。