
Работа с вниманием к деталям: оценки, которые действительно предсказывают результат
Наиболее надёжный предиктор результативности в области внимания к деталям — это не личностный опросник и не упражнение на скорость распознавания паттернов. Это валидированный тест когнитивных способностей в сочетании с ролевым практическим заданием, содержащим намеренно допущенные ошибки, подкреплённым структурированными поведенческими вопросами на интервью. Практические задания демонстрируют мета-аналитическую валидность порядка r = .54 для прогнозирования результативности на рабочем месте, а Тест внимания к деталям (ADT) предоставляет основанные на результативности свидетельства того, что подобное тестирование предсказывает оценки руководителей по задачам, требующим внимательности к деталям. Тесты, измеряющие только скорость, и самооценочные опросники работают значительно хуже.
Вот набор инструментов, который мы рекомендуем для оценки кандидатов на должности, требующие внимания к деталям:
- Валидированный тест общих умственных способностей (GMA) для измерения способности к рассуждению
- Ролевое практическое задание с намеренно встроенными ошибками, ограниченное по времени так, чтобы измерять точность, а не скорость
- Структурированные поведенческие вопросы на интервью, привязанные к реальным ситуациям, а не к общим вопросам самооценки
Инструмент Magic Create от Talent Approved создаёт эти ролевые оценочные задания прямо из описания вакансии за считанные минуты, а встроенный антиплагиатный мониторинг и сводки на основе ИИ делают процесс проверки быстрым, не жертвуя при этом строгостью.
Ключевые выводы
Валидированный набор инструментов, включающий тест когнитивных способностей, ролевые практические задания с намеренными ошибками и структурированное поведенческое интервью, прогнозирует результативность в области внимания к деталям значительно надёжнее, чем тесты на скорость или самооценочные опросники.
| Пункт | Подробности |
|---|---|
| Откажитесь от тестов, измеряющих только скорость | Задания на скорость обработки информации измеряют скорость сканирования, а не реальное обнаружение ошибок на рабочем месте. |
| Практические задания лидируют по валидности | Практические задания демонстрируют мета-аналитическую валидность порядка r = .54, немного превосходя тесты общих когнитивных способностей. |
| Оценивайте и точность обнаружения, и количество ложных срабатываний | Кандидат, помечающий слишком много несуществующих ошибок, не более внимателен — он просто менее избирателен. |
| Проводите пилотирование до установки пороговых значений | Сначала протестируйте действующих сотрудников, чтобы установить реалистичные диапазоны показателей обнаружения, а не угадывать пороги. |
| Создавайте оценочные задания быстро с Talent Approved | Magic Create генерирует ролевые тесты из описания вакансии со встроенным антиплагиатным контролем и сводками ИИ. |
Содержание
- Почему валидированные оценочные задания важны для должностей, требующих внимания к деталям
- Создание набора оценочных инструментов, который действительно работает
- Как разработать ролевые практические задания с намеренными ошибками
- Системы оценки, отделяющие внимательных кандидатов от везунчиков
- Внедрение оценочных заданий без потери справедливости и последовательности
- Что рекрутеры делают неправильно при найме с акцентом на внимание к деталям
- Попробуйте ролевое пилотирование с Talent Approved
- Источники
- Часто задаваемые вопросы
Почему валидированные оценочные задания важны для должностей, требующих внимания к деталям
Рекрутеры нередко выбирают первый попавшийся тест на внимание к деталям из поисковой выдачи Google — и это дорогостоящая привычка. Исследования в области методов отбора однозначны: общие умственные способности предсказывают результативность на рабочем месте на уровне примерно r = .51, а практические задания незначительно превосходят этот показатель — r = .54, согласно мета-аналитическим работам Шмидта и Хантера по валидности методов отбора. Эти цифры объясняются тем, что оба метода требуют от кандидатов реального решения задач, а не просто беглого взгляда на два изображения с поиском различий.
Понимание контекста имеет значение, потому что большинство реальных ошибок носят не визуальный, а контекстуальный характер. Расхождение в счёте, несоответствующий пункт контракта или переставленный код доставки требуют понимания предметной области, а не просто острого зрения. Именно здесь тесты на скорость и инструменты самооценки дают сбой:
- Тесты на скорость измеряют быстроту сканирования — и практики отмечают, что это совершенно иной навык, нежели обнаружение существенной ошибки в реалистичных условиях с ограничением по времени
- Самооценочные опросники («Вы внимательны к деталям?») провоцируют искажение социальной желательности и слабо коррелируют с реальным поведением на работе
- Обобщённые задания на распознавание паттернов редко напоминают реальный контент, с которым кандидаты будут работать на должности
Создание набора оценочных инструментов, который действительно работает
Ни один тест сам по себе не охватывает внимание к деталям в полной мере. Каждый компонент сильного набора измеряет то, что другие упускают, и пропуск хотя бы одного оставляет пробел в прогнозировании.
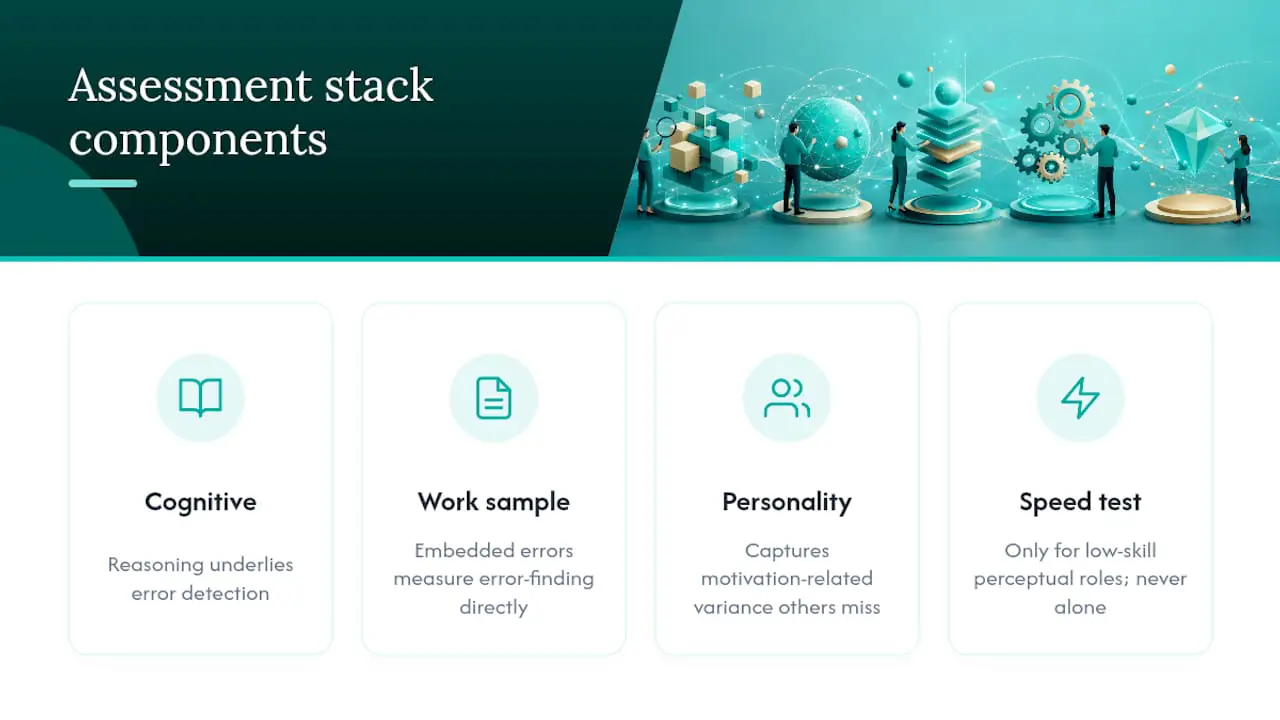
Тестирование когнитивных способностей идёт первым, поскольку именно способность к рассуждению лежит в основе обнаружения ошибок. Кандидат, способный удерживать в рабочей памяти несколько точек данных и одновременно сверять их с набором правил, превзойдёт того, кто просто визуально сканирует информацию. Когнитивные показатели также усиливают валидность любого последующего практического задания, поскольку кандидатам необходим базовый уровень способности к рассуждению для правильной интерпретации инструкций.
Практические задания со встроенными ошибками обладают наивысшей экологической валидностью из всех представленных методов, поскольку измеряют целевое поведение напрямую, а не через его косвенный показатель. Кандидат на должность финансового аналитика, проверяющий таблицу с тремя намеренно допущенными ошибками в формулах, расскажет о себе значительно больше, чем любая абстрактная головоломка.
Показатели добросовестности или личностные измерения добавляют небольшой, но реальный уровень, охватывая дисперсию, связанную с мотивацией, которую когнитивные тесты и практические задания не объясняют в полной мере. Узкий тест на скорость оправдан только для простых перцептивных должностей, таких как базовая сортировка или работа на инспекционной линии, и даже там он никогда не должен применяться в одиночку.
Совет профессионала: Дополняйте каждый когнитивный или практический показатель одним структурированным поведенческим вопросом, например: «Расскажите о случае, когда вы обнаружили ошибку, которую не заметил кто-то другой». Это выявляет реальные инциденты, которые можно проверить, в отличие от самооценочных шкал.
Как разработать ролевые практические задания с намеренными ошибками
Создание практического задания, которое действительно прогнозирует результативность, требует большего, чем просто вставить опечатки в документ. Следуйте этой последовательности:
- Сначала проведите анализ должности. Определите три-пять задач, где ошибки имеют наибольшую цену, и классифицируйте типичные виды сбоев: пропуск, перестановка символов, замена или нарушение правил.
- Подберите формат материала под ежедневную работу. Для финансовой должности нужна таблица с ошибками в формулах; для логистической — транспортная накладная; для должности, связанной с юридической сферой, — контракт с изменёнными пунктами.
- Встройте намеренное разнообразие типов ошибок, а не один повторяющийся паттерн. Кандидаты, видящие только один вид ошибки, могут набрать высокий балл за счёт распознавания паттерна, не демонстрируя реальной внимательности.
- Установите щедрые временны́е ограничения. Цель — измерение точности, а не скорости, поэтому давайте кандидатам достаточно времени для тщательной проверки, а не беглого просмотра.
- Проведите пилотирование с действующими сотрудниками до того, как тест будет применён к кандидатам, и используйте их результаты для установки реалистичных целевых показателей обнаружения и оценки частоты ложных срабатываний.
- Рандомизируйте порядок заданий и ротируйте несколько версий материала, чтобы снизить вероятность запоминания и обмена ответами между кандидатами.
Несколько принципов разработки отличают сильное практическое задание от слабого:
- Подбирайте намеренные ошибки в соответствии с реальными видами сбоев для данной должности, а не в формате общих заданий «найди отличия»
- Делайте инструкции однозначными. Запутанные инструкции повышают частоту ложных срабатываний по причинам, не связанным с внимательностью
- Исключайте или дорабатывайте задания, с которыми все участники пилотирования справились либо идеально, либо полностью не справились. Ни одна из крайностей не позволяет различать кандидатов
Наше руководство по разработке должностно-специфических тестов для отбора подробно рассматривает этот процесс с дополнительными примерами, а наша система выбора навыков для тестирования помогает определить, какие типы ошибок наиболее важны для конкретной должности.
Системы оценки, отделяющие внимательных кандидатов от везунчиков
Необработанная точность сама по себе скрывает слишком многое. Кандидат, обнаруживший 9 из 10 намеренных ошибок, но пометивший 15 правильных фрагментов как проблемные, на самом деле не более внимателен, чем тот, кто нашёл 7 из 10 и не выдал ни одного ложного срабатывания. Именно поэтому важна логика обнаружения сигнала: фиксируйте для каждого кандидата как частоту обнаружения (правильно идентифицированные ошибки), так и частоту ложных срабатываний (ошибочно помеченные правильные фрагменты) — эта практика поддерживается как академическими, так и профессиональными источниками по измерению внимания к деталям.
Простой составной показатель может объединить эти значения в одно число, с которым рекрутеры могут работать. Одна из рабочих формул: Составной показатель внимательности = 0,70 × точность + 0,30 × соблюдение инструкций — она придаёт больший вес точности, при этом поощряя кандидатов, точно следующих инструкциям задания.
Затем переводите составные показатели в диапазоны, основанные на ваших собственных пилотных данных, а не на заимствованных ориентирах:
| Диапазон | Диапазон составного показателя | Рекомендуемое действие |
|---|---|---|
| Нанять | Верхний квартиль пилотирования | Сразу перевести на финальное интервью |
| Пограничный | Средний диапазон, определённый по пилоту | Добавить структурированный поведенческий вопрос на интервью |
| Требует развития | Нижний квартиль пилотирования | Отсеять или перенаправить на другой уровень должности |
Рекомендуемые отправные точки и временны́е рамки для распространённых должностей, включая практические задания продолжительностью от 10 до 25 минут с порогом точности 80–90% для бухгалтерских и контрольно-качественных ролей, дают разумную базу до тех пор, пока её не заменят ваши собственные пилотные данные. Представляйте результаты руководителям по найму понятным языком: диапазонная метка плюс два-три примера вопросов для интервью, привязанных к конкретному паттерну ошибок кандидата.
Внедрение оценочных заданий без потери справедливости и последовательности
Последовательность применения ко всем кандидатам — это не приятный бонус, а условие, делающее ваши результаты сопоставимыми. Каждый кандидат должен получать одинаковые инструкции, одинаковое время и сопоставимые условия тестирования — с задокументированными процедурами адаптации для тех, кто в них нуждается.
Меры защиты от списывания сопряжены с реальными компромиссами, которые стоит взвесить перед выбором:
- Блокировка браузера предотвращает переключение вкладок, но создаёт дополнительную нагрузку для кандидатов на устаревших устройствах
- Запись сессии и проверка через веб-камеру позволяют выявить попытки совместной работы, но поднимают вопросы конфиденциальности, требующие чёткого раскрытия информации
- Рандомизированные версии заданий снижают обмен ответами без какого-либо мониторинга
Что касается интеграции, сводки на основе ИИ помогают рецензентам быстро отсортировать большие пулы кандидатов, однако окончательное решение всегда должен принимать человек — особенно при пограничных показателях. Проводите анализ неблагоприятного воздействия на пилотных данных перед полным запуском и храните документацию по процессу валидации. Именно это отличает защищаемую практику найма от той, которая рухнет при юридическом оспаривании.
Совет профессионала: Ведите письменный учёт каждого решения о пороговом значении при пилотировании и указывайте, кто его утвердил. Если решение о найме когда-либо будет поставлено под сомнение, именно этот документальный след вас защитит.
Что рекрутеры делают неправильно при найме с акцентом на внимание к деталям
Большинство команд по найму воспринимают внимание к деталям как черту личности, о которой можно спросить напрямую. Это не так, и именно поэтому столько «внимательных к деталям» сотрудников разочаровывают в первые девяносто дней. Честный ответ, скрытый в исследованиях валидности, состоит в том, что внимание к деталям — это продемонстрированное поведение в реалистичных рабочих условиях, а не самодекларируемое качество, и единственный надёжный способ измерить поведение — это наблюдать за ним.
Общепринятый совет — «добавьте несколько заданий типа "найди отличия" в свой процесс скрининга» — активно препятствует качественному найму. Такие задания измеряют скорость зрительной обработки — реальный, но узкий навык, имеющий мало общего с выявлением неправильно применённого кода скидки или несовпадающей медицинской записи. Рекрутеры, полагающиеся на них, в итоге отбирают быстрых сканировщиков, а не внимательных аналитиков.
Если вы вынесете из этого только одну мысль: сначала создайте практическое задание, прежде чем покупать какой-либо готовый тест. Универсальная оценка не может знать, что ваши ошибки в счетах выглядят иначе, чем у ваших конкурентов. Специфические для должности паттерны ошибок — это и есть весь смысл, и пропуск этого шага подрывает всё остальное в наборе инструментов.
— Jimmie
Попробуйте ролевое пилотирование с Talent Approved
Раньше создание такого набора инструментов с нуля занимало недели написания заданий и требовало консультанта по валидации на постоянной основе. Talent Approved сокращает это до одного рабочего дня — что особенно важно для рекрутинговых команд, которым нужно запустить ролевую оценку до закрытия следующей заявки на вакансию, а не в следующем квартале.
Вот рабочая последовательность пилотирования с использованием платформы. Во-первых, загрузите описание вакансии в Magic Create и позвольте ему сгенерировать первый вариант оценочного задания, соответствующего должности. Во-вторых, просмотрите черновик и встройте конкретные типы ошибок, выявленных в ходе анализа должности, — будь то перестановка символов в роли по вводу данных или нарушения правил в контрольном списке соответствия требованиям. В-третьих, активируйте встроенный антиплагиатный мониторинг и сводки на основе ИИ, чтобы ваша команда могла быстро обработать результаты, сохраняя полный контрольный след. В-четвёртых, проведите оценку с участием 10–30 действующих сотрудников до открытия тестирования для кандидатов, используя их результаты для установки диапазонов «нанять», «пограничный» и «требует развития».
Для шаблонов и контрольных списков разработки наши руководства по разработке административных практических заданий и пилотированию оценок в рамках рабочего процесса ATS подробно охватывают оба аспекта. Если вам нужны структурированные дополнительные вопросы после получения результатов, генератор поведенческих вопросов для интервью от NueCareer — отличный дополнительный инструмент.
Готовы увидеть это в действии? Начните создавать своё первое оценочное задание и получите тест, готовый к пилотированию, в течение часа.
Источники
Часто задаваемые вопросы
Какие навыки должна измерять оценка внимания к деталям?
Она должна измерять обнаружение ошибок в реалистичных рабочих условиях, а не скорость визуального сканирования. Наиболее сильные оценки сочетают валидированный тест когнитивных способностей с ролевым практическим заданием, содержащим намеренные ошибки — такие как пропуски, перестановки символов или нарушения правил.
Надёжны ли самооценочные вопросы на внимание к деталям?
Нет. Самооценочные вопросы типа «Вы внимательны к деталям?» провоцируют искажение социальной желательности и слабо коррелируют с реальной точностью на рабочем месте — именно поэтому основанные на результативности практические задания остаются более предпочтительным выбором.
Сколько времени должен занимать тест с практическим заданием?
Большинство ролевых практических заданий занимают от 10 до 25 минут — достаточно, чтобы кандидаты могли провести тщательную проверку, не превращая упражнение в тест на скорость.
Может ли Talent Approved создать ролевой тест на внимание к деталям?
Да. Инструмент Magic Create от Talent Approved генерирует адаптированное оценочное задание непосредственно из описания вакансии, а встроенный антиплагиатный мониторинг и сводки на основе ИИ обеспечивают быструю и обоснованную проверку.
Каков хороший отправной ориентир по точности?
Многие контрольно-качественные и бухгалтерские должности начинают пилотирование с ориентиром точности около 80–90%, хотя правильный порог для вашей организации следует определять путём пилотирования теста с вашими собственными действующими сотрудниками.