
3 Formules de Tableur pour la Notation à Crédit Partiel et Rasch
La notation à crédit partiel attribue des points sur une échelle plutôt que selon un résultat tout-ou-rien, en récompensant le candidat pour la partie de sa réponse qui est correcte. Les éducateurs y ont recours parce qu'elle mesure les connaissances partielles que la notation dichotomique juste/faux écarte, et des fonctions de crédit partiel bien conçues réduisent le gain que procure une réponse au hasard. Elle convient le mieux aux questions à plusieurs parties, aux questions à réponses multiples et aux réponses construites évaluées selon une grille, notamment lorsque vous avez besoin d'informations diagnostiques plus fines qu'un simple score de réussite/échec ne peut en fournir.
En bref :
- La notation à crédit partiel capture mieux les connaissances des étudiants sur les questions à plusieurs parties, à réponses multiples et à réponses construites que les approches simples juste/faux.
- Des méthodes comme la sélection de sous-ensembles et la pénalité linéaire contrôlent le hasard, mais nécessitent des instructions claires et peuvent introduire de la complexité dans la notation et la formation des évaluateurs.
- La recherche empirique montre que le crédit partiel améliore la fiabilité et la discrimination, surtout à grande échelle ou avec des questions à réponses multiples sujettes aux réponses au hasard.
- La plupart des évaluations en classe n'ont pas besoin de modèles avancés tels que le crédit partiel de Rasch, réservés aux programmes de tests à grande échelle et aux examens de certification.
- L'utilisation d'outils dédiés qui automatisent l'application des grilles, la cohérence des évaluateurs et la transparence de la notation simplifie la mise en œuvre et garantit une évaluation à crédit partiel juste et cohérente.
Table des matières
- Ce que signifie la notation à crédit partiel et quand l'utiliser
- Méthodes courantes de notation à crédit partiel
- Comment calculer le crédit partiel : exemples pratiques
- Modèles statistiques et TRI : le modèle de crédit partiel de Rasch
- Bonnes pratiques de mise en œuvre : conception, configuration et reporting
- Fiabilité, validité et suppression des réponses au hasard
- Modèles de notation pour les questions à réponses multiples
- Liste de contrôle de gouvernance avant le déploiement à grande échelle
- Quand le crédit partiel justifie sa complexité
- Créer des évaluations à crédit partiel sans construire l'infrastructure vous-même
- Sources
- FAQ
Ce que signifie la notation à crédit partiel et quand l'utiliser
La notation dichotomique traite une réponse comme étant soit entièrement correcte soit entièrement incorrecte, valant un point ou zéro. La notation à crédit partiel brise cette binarité. Un étudiant qui sélectionne trois des quatre options correctes d'une question à réponses multiples, ou qui réussit la mise en place d'un problème en plusieurs étapes mais échoue au calcul final, obtient un crédit proportionnel à ce qu'il a réellement démontré.
L'argument en faveur du crédit partiel repose sur trois résultats pratiques. Premièrement, il capture les connaissances partielles qu'une règle stricte juste/faux efface, ce qui est particulièrement important pour les questions comportant plusieurs sous-réponses défendables. Deuxièmement, des fonctions de notation correctement construites peuvent rendre la valeur attendue d'une réponse aléatoire négative, de sorte que répondre au hasard cesse d'être une stratégie rationnelle — un effet formellement modélisé dans les recherches sur les fonctions de notation. Troisièmement, des comparaisons empiriques sur des questions à réponses multiples ont montré que les méthodes à crédit partiel amélioraient à la fois la fiabilité et la discrimination des items par rapport à la notation dichotomique.
Vous n'avez pas besoin du crédit partiel partout. Un quiz de vocabulaire avec des réponses uniques correctes n'en tire aucun bénéfice et n'ajoute que de la complexité à la notation. Optez pour le crédit partiel lorsque les questions sont véritablement composées de plusieurs parties, lorsque les questions à réponses multiples comportent plus de deux sélections plausibles, ou lorsqu'une réponse construite peut être décomposée en une grille avec des composantes distinctes et évaluables.
Méthodes courantes de notation à crédit partiel
Aucune formule unique ne s'impose dans tous les contextes. Les revues classiques du domaine recensent un éventail de méthodes et constatent systématiquement des compromis plutôt qu'un gagnant universel ; le bon choix dépend donc du format de la question et de ce que vous cherchez à protéger : les réponses au hasard, l'incohérence des évaluateurs ou la complexité de la notation elle-même.
- Notation proportionnelle (nombre de bonnes réponses). Les points sont égaux à la fraction de sélections correctes sur le total des sélections possibles. Simple à calculer, facile à expliquer aux étudiants, mais vulnérable aux stratégies de contournement sur les questions à réponses multiples où sélectionner tout garantit un score de base.
- Notation par sélection de sous-ensemble (SS). Le crédit total n'est accordé que lorsque le sous-ensemble exact correct est choisi ; un crédit partiel est attribué pour les sous-ensembles qui correspondent à la clé, avec des pénalités pour les distracteurs inclus. Meilleur contrôle des réponses au hasard que la notation purement proportionnelle, au prix d'une règle légèrement plus complexe à expliquer.
- Fonctions de style Zapechelnyuk modifié. Ces fonctions utilisent une structure de pénalité dérivée mathématiquement conçue pour rendre la valeur attendue des réponses données aveuglément négative, s'attaquant directement au problème des réponses au hasard plutôt que de simplement le tolérer.
- Modèles à pénalité linéaire. Le score est égal au nombre de sélections correctes moins un nombre pondéré de sélections incorrectes. Ajustable en modifiant le poids de la pénalité, ce qui permet de calibrer l'agressivité avec laquelle vous souhaitez décourager la sur-sélection.
- Fractionnement basé sur la grille. Les réponses construites sont évaluées selon une grille ordonnée (de 0 à 4, par exemple), puis converties en fraction des points totaux de la question. C'est l'approche standard pour les dissertations, les problèmes de mathématiques en plusieurs étapes et les rapports de laboratoire.
La notation proportionnelle convient aux questions à sélection multiple et à plusieurs espaces vides lorsque le format est simple et que le risque de réponse au hasard est faible. Les modèles par sélection de sous-ensemble et à pénalité linéaire conviennent aux questions à réponses multiples où les distracteurs sont suffisamment attrayants pour qu'une sélection aléatoire puisse faire gonfler les scores. Le fractionnement basé sur la grille est vraiment la seule option solide pour les réponses construites ouvertes, car il n'y a pas de « nombre correct » discret à diviser.
Le modèle de compromis est cohérent entre les méthodes : les formules plus simples (notation proportionnelle) sont les plus faciles à comprendre pour les étudiants et les instructeurs, mais les moins efficaces contre les réponses au hasard, tandis que les méthodes basées sur les pénalités et les sous-ensembles contrôlent mieux les réponses au hasard mais exigent des instructions plus claires pour que les étudiants comprennent comment les sélections sont pondérées. La notation basée sur la grille comporte un risque différent : l'incohérence des évaluateurs, qu'aucune formule ne peut corriger à elle seule.
Comment calculer le crédit partiel : exemples pratiques
Les formules ci-dessus sont inutiles jusqu'à ce que vous puissiez faire les calculs vous-même. Voici trois exemples pratiques que vous pouvez transférer directement dans une feuille de calcul.
1. Notation proportionnelle sur une question à sélection multiple avec quatre options.
Supposons qu'une question comporte quatre options correctes sur six choix au total, valant 4 points. Un étudiant sélectionne 3 des 4 options correctes et 0 distracteur.
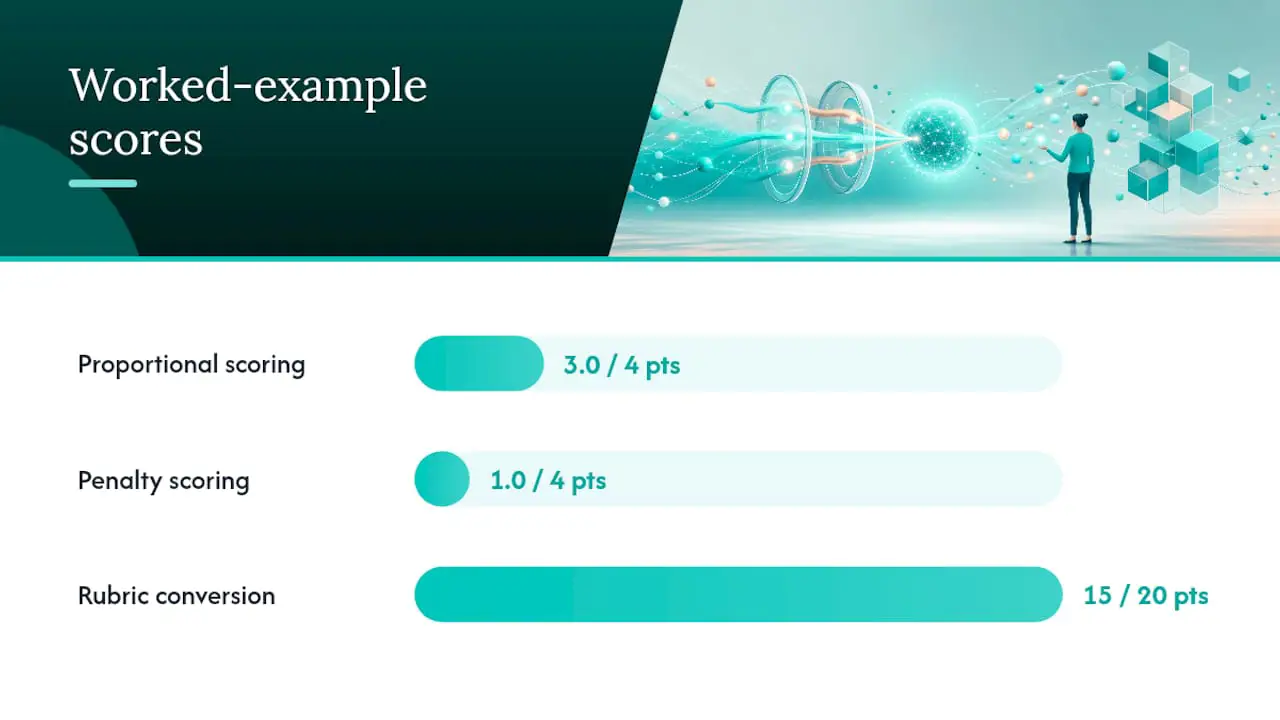
Score = (sélections correctes / total des options correctes) × points de la question Score = (3 / 4) × 4 = 3,0 points
2. Sélection de sous-ensemble avec pénalité pour distracteur.
Même question : 4 options correctes, 2 distracteurs, 4 points au total. Cette fois, l'étudiant sélectionne 3 options correctes et 1 distracteur.
Score = [(sélections correctes / total correct) − (distracteurs sélectionnés / total des distracteurs)] × points de la question, plancher à zéro Score = [(3/4) − (1/2)] × 4 = [0,75 − 0,5] × 4 = 1,0 point
Comparez cela à la méthode purement proportionnelle, qui aurait ignoré le distracteur et attribué 3,0 points pour la réponse identique. Cet écart est l'argument fondamental en faveur des méthodes basées sur les pénalités pour les questions dont les distracteurs sont véritablement tentants.
3. Conversion grille-fraction sur une question de 20 points.
Un problème de mathématiques en plusieurs étapes est noté sur une grille de 0 à 4 : 0 (aucune approche valide), 1 (mise en place correcte uniquement), 2 (méthode correcte, erreur majeure), 3 (méthode correcte, erreur mineure), 4 (entièrement correct). La question vaut 20 points au total.
Score fractionnel = (points de grille obtenus / points de grille maximum) × points de la question Un étudiant qui obtient 3 sur la grille reçoit : (3/4) × 20 = 15 points
Appliquez cette conversion à l'ensemble d'une classe et vous obtenez une distribution qui ne ressemble en rien à un simple histogramme de pourcentage de bonnes réponses : les scores se regroupent autour des niveaux de la grille (0, 5, 10, 15, 20) plutôt que de se répartir de façon continue, ce qui vaut la peine de savoir avant de construire une courbe de notes autour de cela.
Conseil de pro : Construisez ces trois formules en tant que fonctions nommées dans un modèle de feuille de calcul partagé avant l'ouverture de la fenêtre d'examen. Adapter une formule de notation après que les étudiants ont déjà soumis leurs réponses est là où la plupart des litiges de notation commencent.
Modèles statistiques et TRI : le modèle de crédit partiel de Rasch
Les formules de notation fractionnelle répondent à la question « combien de points cette réponse a-t-elle obtenus ». La théorie de réponse à l'item (TRI) répond à une question différente : « quel niveau de compétence cette réponse indique-t-elle réellement, une fois que l'on tient compte de la difficulté de chaque catégorie de réponse ». Cette distinction est importante dès que vous passez de la notation en classe unique à tout contexte où les scores doivent être comparés entre des formes, des cohortes ou des années.
Le modèle de crédit partiel de Rasch, développé par Geoff Masters, étend le modèle de Rasch dichotomique standard aux questions avec des catégories de réponses ordonnées. Au lieu de traiter « l'étape 2 sur 4 » comme valant simplement la moitié de « l'étape 4 sur 4 », le PCM de Rasch estime un paramètre de seuil distinct pour la transition entre chaque paire de catégories adjacentes. Passer d'un score de 1 à 2 sur une grille peut nécessiter une compétence démontrée considérablement plus importante que de passer de 2 à 3, et le modèle capture cela au lieu de supposer que chaque étape est égale.
L'avantage pratique est la séparabilité des paramètres : la compétence estimée d'un candidat et les seuils de catégorie d'une question peuvent être estimés indépendamment l'un de l'autre, ce qui est ce qui rend les comparaisons entre formes statistiquement défendables en premier lieu.
Quand la complexité ajoutée en vaut-elle la peine ?
- Les programmes de tests à grande échelle, où des milliers de réponses nécessitent une interprétation cohérente sur plusieurs formes d'examen.
- La liaison et l'équation, lorsque différents groupes d'étudiants passent des versions différentes d'un test et que les scores doivent avoir la même signification sur chacune.
- L'étalonnage précis des items, lorsque vous devez savoir exactement quelle compétence sépare un « 2 » d'un « 3 » sur une grille, plutôt que de supposer un espacement égal.
- Les vérifications du fonctionnement différentiel des items, où vous devez confirmer que les étapes de crédit partiel d'un item se comportent de manière cohérente entre les groupes démographiques avant de faire confiance au score agrégé.
Un simple quiz de classe n'a presque jamais besoin d'un étalonnage de Rasch. Un examen de certification administré à l'échelle nationale, réutilisé sur plusieurs fenêtres de test et sur lequel reposent des décisions réussite/échec avec de véritables conséquences en a presque toujours besoin. La frontière entre « utiliser une formule de feuille de calcul » et « utiliser un logiciel TRI » est vraiment une question d'enjeux et d'échelle, et non de format de question.
Bonnes pratiques de mise en œuvre : conception, configuration et reporting
Réussir le crédit partiel commence bien avant qu'un étudiant ne voie la question, et cela ne se termine pas lorsque les scores sont générés. Trois phases méritent une attention délibérée : la conception, la configuration de la plateforme et le reporting.
Liste de contrôle de conception. Avant de rédiger un seul item, définissez la règle de notation — pas après que le pilote a révélé une incohérence.
- Rédigez la grille ou la règle d'attribution des points en même temps que vous rédigez la question, et non après.
- Utilisez une échelle de points cohérente pour des questions similaires afin que les étudiants puissent anticiper la distribution du crédit partiel.
- Testez les nouvelles grilles sur un petit échantillon de réponses réelles ou pratiques avant de les déployer à grande échelle, et ajustez les descriptions d'ancrage là où deux évaluateurs sont en désaccord.
- Définissez de 3 à 5 réponses d'ancrage par niveau de score pour les grilles de réponses construites — une pratique soutenue par la recherche sur la notation à crédit partiel basée sur les grilles, qui recommande de former les évaluateurs en s'appuyant sur des scripts exemplaires pour atteindre un accord inter-évaluateurs acceptable.
Configuration du LMS et de la plateforme. La plupart des systèmes de gestion de l'apprentissage enfouissent les paramètres de crédit partiel dans les options au niveau de l'item plutôt que dans les paramètres au niveau de l'examen ; vérifiez donc chaque type de question individuellement plutôt que de supposer qu'un interrupteur global couvre tout. Confirmez si le retour d'information affiché aux étudiants indique le score fractionnel, le niveau de la grille ou les deux, car afficher uniquement un total arrondi peut masquer exactement où les points ont été perdus. Exportez les données de notation brutes non arrondies chaque fois que possible. Arrondir tôt et recalculer ensuite est l'une des façons les plus rapides d'introduire des erreurs de notation silencieuses sur un grand groupe.
Reporting. Communiquez à la fois le score fractionnel brut et le total arrondi, et précisez-le explicitement dans tout rapport de score remis à l'étudiant. Un étudiant qui voit « 15/20 » sans contexte n'a aucun moyen de savoir s'il a perdu 5 points pour une grosse erreur ou plusieurs petites. Une explication d'une ligne sur la façon dont le crédit partiel a été calculé, jointe au rapport de score, résout la plupart des litiges avant qu'ils ne commencent. Les équipes qui élaborent des grilles de notation pour des évaluations structurées peuvent trouver des conseils et modèles de conception de grilles supplémentaires qui s'associent directement aux approches de notation fractionnelle.
Fiabilité, validité et suppression des réponses au hasard
La fiabilité est la question qui détermine si le crédit partiel valait la complexité ajoutée. Si un changement de notation n'améliore pas de façon mesurable la cohérence de votre évaluation, la formation supplémentaire des évaluateurs et la charge de calcul sont difficiles à justifier.
Le bilan empirique penche favorablement ici. Des études comparatives des méthodes de notation sur des questions à réponses multiples ont montré que les approches à crédit partiel amélioraient la fiabilité et la discrimination par rapport à la notation dichotomique simple, en particulier pour les questions avec plus de deux options de réponse où une division juste/faux écarte une variation significative. Par ailleurs, des travaux théoriques sur les fonctions de notation conçues autour d'une valeur attendue de réponse au hasard négative ont montré que ces fonctions tendent à améliorer à la fois la fiabilité et le pouvoir discriminant par rapport à la notation purement juste/faux, notamment une fois qu'une pénalité de réponse au hasard est intégrée.
Trois vérifications pratiques vous indiquent si le changement est payant dans vos propres données :
Corrélation item-total. Recalculez-la après être passé au crédit partiel. Un item dont la corrélation avec le score total s'améliore fait désormais un meilleur travail de séparation des bons candidats des moins bons sous la nouvelle règle de notation.
Alpha de Cronbach avant et après. Faites passer le même ensemble de données de test à travers les deux règles de notation et comparez directement les valeurs alpha. Une augmentation significative est un signal fort que le crédit partiel a capturé des informations que la version binaire avait écartées.
Statistiques d'ajustement TRI, là où un modèle de Rasch ou autre TRI est déjà utilisé. Les seuils de catégorie qui ressortent désordonnés — signifiant qu'un score de grille plus élevé ne correspond pas à une compétence estimée plus élevée — signalent une grille qui nécessite une révision, indépendamment de ce que disent les chiffres bruts de fiabilité.
Rien de tout cela n'est gratuit. La complexité de la notation augmente avec chaque variante de formule ajoutée, la variabilité des évaluateurs devient une préoccupation concrète dès que vous introduisez un composant basé sur la grille, et le coût administratif augmente lorsque vous avez besoin d'un logiciel ou d'une infrastructure de feuille de calcul au-delà d'une simple clé de réponse. Pesez ces coûts par rapport à vos enjeux réels. Un quiz hebdomadaire justifie rarement la surcharge ; un examen de certification le justifie presque toujours.
Modèles de notation pour les questions à réponses multiples
Les questions à réponses multiples — où un étudiant sélectionne plusieurs options dans une liste plus longue — sont celles où les réponses au hasard causent le plus de dommages à la validité d'un test. Un étudiant qui sélectionne toutes les options sur une question « cochez tout ce qui s'applique » avec quatre bonnes réponses sur six choix obtiendra toujours un crédit partiel sous une notation proportionnelle naïve, qu'il sache quelque chose ou non.
La solution est un modèle de notation construit autour de la valeur attendue. Une structure courante : attribuer p1 points lorsque l'étudiant sélectionne exactement la clé (l'ensemble complet correct) ou, dans certaines formulations, lorsque chaque distracteur est correctement exclu ; sinon appliquer une formule pc − m, où pc est la proportion correcte et m est une pénalité proportionnelle aux sélections en dehors de la clé. L'objectif, tel que le définit la recherche formelle sur les fonctions de notation, est de s'assurer que les mathématiques elles-mêmes découragent la sur-sélection négligente.
- Dimensionnez la pénalité (m) de sorte que la valeur attendue de sélectionner toutes les options — ou de sélectionner au hasard — soit négative ou au pire nulle.
- Testez votre pénalité sur une réponse « tout sélectionner » avant de déployer la question. Si cette réponse obtient un score supérieur à zéro, la pénalité est trop faible.
- Testez-la également sur une réponse de connaissance partielle véritablement honnête. Si un étudiant identifie correctement 3 des 4 options correctes et exclut les deux distracteurs, mais obtient un score inférieur à quelqu'un qui a deviné au large, la pénalité est trop grande.
La formulation de la question est tout aussi importante que la formule qui la sous-tend. Des instructions qui indiquent « sélectionnez toutes les réponses correctes » sans aucune indication sur les pénalités poussent les étudiants à deviner, car il n'y a aucun signal négatif dans la formulation elle-même. Ajoutez une courte phrase indiquant que les sélections incorrectes réduisent le score, et vous obtenez un reporting plus honnête des connaissances partielles — parce que les étudiants n'ont plus d'incitation à sélectionner des options dont ils ne sont pas sûrs simplement pour se couvrir.
Liste de contrôle de gouvernance avant le déploiement à grande échelle
Avant de déployer le crédit partiel au-delà d'un groupe pilote, effectuez ces quatre vérifications :
- Clarté de la grille. Confirmez que chaque niveau de la grille dispose d'une description d'ancrage distincte et observable — pas seulement une étiquette vague comme « majoritairement correct ».
- Fiabilité inter-évaluateurs. Faites noter indépendamment les mêmes 20 à 30 réponses échantillons par deux évaluateurs et vérifiez l'accord avant de faire confiance aux scores d'un seul évaluateur à grande échelle.
- Comparaison pilote. Notez le même ensemble de réponses selon l'ancienne règle de notation et selon la nouvelle règle à crédit partiel, et comparez la fiabilité et la distribution des notes côte à côte.
- Analyse de sensibilité. Ajustez légèrement vos pondérations de pénalité ou vos attributions de points et relancez l'analyse. Les conseils sur les modèles de notation recommandent cette étape parce que de petits changements de pondération peuvent inverser les résultats de fiabilité ou réordonner entièrement les classements des candidats.
Documentez chaque décision de notation — y compris la raison pour laquelle une formule ou une taille de pénalité particulière a été choisie — dans un format que les parties prenantes peuvent examiner ultérieurement. C'est ce qui transforme un pilote défendable en une politique défendable.
Quand le crédit partiel justifie sa complexité
Le crédit partiel est une amélioration de mesure avec un véritable coût administratif, et prétendre le contraire nuit à quiconque le teste pour la première fois. Le gain en fiabilité et en discrimination est bien documenté, mais la charge supplémentaire l'est aussi : plus de formation des évaluateurs, des formules plus complexes, plus de place pour le désaccord sur ce que « partiel » signifie réellement pour un item donné.
Ma lecture honnête de la recherche est que la plupart des évaluations au niveau de la classe n'ont pas besoin d'un étalonnage de Rasch, de pénalités par sélection de sous-ensembles, ni d'aucun des mécanismes plus élaborés couverts ci-dessus. Une grille claire et un fractionnement proportionnel couvrent la majorité des besoins réels en classe. Là où le crédit partiel justifie sa complexité, c'est à grande échelle : les examens de certification, les programmes de tests à plusieurs formes, et toute évaluation où une hypothèse de notation incorrecte se répercute sur des milliers de candidats plutôt que sur trente.
La charge opérationnelle est précisément là où de bons outils de plateforme changent le calcul, surtout si vous souhaitez automatiser le recrutement mondial et réduire les risques de conformité. Un outil qui automatise l'application des grilles, suit la cohérence des évaluateurs et enregistre les décisions de notation supprime la majeure partie de la friction qui empêche les éducateurs de tester le crédit partiel. Pilotez d'abord, mesurez le gain de fiabilité par rapport au coût ajouté, et ne déployez l'approche à grande échelle qu'une fois que les chiffres le justifient réellement.
— Jimmie
Créer des évaluations à crédit partiel sans construire l'infrastructure vous-même
La majeure partie de la friction dans la notation à crédit partiel ne vient pas des mathématiques. Elle vient de l'infrastructure : rédiger des grilles cohérentes, maintenir les évaluateurs alignés, et s'assurer que personne n'a triché au test. Talent Approved repose sur un modèle à l'utilisation sans abonnement, de sorte que vous ne payez que par évaluation de candidat complétée, et évitez la surcharge de la licence de logiciels de notation dont vous n'aurez peut-être besoin qu'occasionnellement.
La fonctionnalité Magic Create de la plateforme génère une évaluation prête pour la grille et adaptée au poste directement à partir d'une description de poste ou d'une liste de compétences, ce qui élimine entièrement la phase manuelle de rédaction des items. Les outils anti-triche intégrés — notamment la surveillance de l'écran et de la webcam avec replays de session — protègent l'intégrité des résultats à crédit partiel de la même façon que la formation des évaluateurs protège une grille de réponse construite. Les résumés de performance générés par l'IA transforment les scores fractionnels en classements lisibles des candidats sans obliger votre équipe à interpréter manuellement les mathématiques brutes de la grille.
Si vous évaluez des compétences plutôt que vous ne notez des étudiants, et souhaitez une notation de style crédit partiel sans posséder l'infrastructure de notation, consultez la page de tarification des évaluations de compétences et voyez ce qu'une évaluation pilote coûterait pour votre prochain cycle de recrutement.
Sources
- Evaluating Different Scoring Methods for Multiple Response Items Providing Partial Credit
- Theoretical evaluation of partial credit scoring of the multiple-choice test item
- Partial-Credit Scoring Methods for Multiple-Choice Tests. - ERIC
FAQ
Comment calculer le crédit partiel ?
Divisez les points obtenus (sélections correctes, niveau de la grille ou correspondance de sous-ensemble) par le maximum de points possible pour cet item, puis multipliez par la valeur totale en points de la question. Les méthodes par sélection de sous-ensemble et à pénalité linéaire soustraient une pénalité pondérée pour les sélections incorrectes avant cette multiplication finale.
Quels sont les trois principaux types d'approches de notation par crédit ?
Dans la conception des évaluations, les trois grandes approches sont la notation dichotomique (juste/faux), la notation à crédit partiel (formules proportionnelles, par sélection de sous-ensemble ou basées sur les pénalités), et la notation fractionnelle basée sur la grille pour les réponses construites. Chacune convient à des formats d'items différents, et aucune approche unique n'est supérieure dans tous les contextes.
Qu'est-ce qui compromet le plus souvent un système de notation à crédit partiel ?
Les ancres de grille peu claires et la formation incohérente des évaluateurs sont les points de défaillance les plus courants, car ils introduisent des désaccords entre les correcteurs qu'aucune formule ne peut corriger après coup. En deuxième position, on trouve un terme de pénalité dimensionné trop petit, ce qui laisse les réponses aléatoires statistiquement rentables au lieu d'être supprimées.
Le crédit partiel améliore-t-il réellement la fiabilité du test ?
Des comparaisons empiriques sur des questions à réponses multiples ont montré que la notation à crédit partiel améliorait à la fois la fiabilité et la discrimination par rapport à la notation dichotomique, particulièrement lorsque la fonction de notation pénalise les sélections incorrectes. Le gain n'est pas automatique. Il dépend de la clarté de la grille et du dimensionnement de la pénalité.
Une plateforme peut-elle gérer la notation à crédit partiel pour les évaluations de compétences ?
Oui. Talent Approved prend en charge la notation basée sur la grille aux côtés de son générateur d'évaluations Magic Create et de sa surveillance anti-triche, permettant aux équipes de recrutement d'appliquer une logique de notation fractionnelle sans construire l'infrastructure de calcul eux-mêmes. La tarification actuelle est indiquée sur la page des évaluations de compétences.
Recommandé
- 3 vérifications de fiabilité pour les évaluations à notation pondérée dans le recrutement
- Créer des grilles de notation pour des évaluations que les éducateurs peuvent piloter et déployer à grande échelle avec l'IA
- Comment calculer correctement les seuils de réussite des évaluations
- Équipes de recrutement : 5 étapes vers une analytique d'évaluation axée sur la mesure