
3 Tabellenkalkulationsformeln für Partial-Credit-Scoring und Rasch
Beim Teilbewertungs-Scoring werden Punkte entlang einer Skala vergeben, anstatt ein Alles-oder-Nichts-Ergebnis zu liefern – Prüflinge erhalten Anerkennung für den Teil einer Antwort, der korrekt ist. Lehrende nutzen es, weil es partielles Wissen erfasst, das ein dichotomes Richtig-oder-Falsch-Scoring verwirft, und gut gestaltete Teilbewertungsfunktionen verringern den Anreiz zum zufälligen Raten. Es eignet sich am besten für mehrteilige Aufgaben, Multiple-Response-Fragen und konstruierte Antworten, die anhand einer Rubrik bewertet werden – besonders wenn Sie detailliertere diagnostische Informationen benötigen, als ein einfaches Bestehen/Nichtbestehen-Ergebnis liefern kann.
TL;DR:
- Teilbewertungs-Scoring erfasst das Wissen der Lernenden bei mehrteiligen, Multiple-Response- und konstruierten Antwortaufgaben besser als einfache Richtig-oder-Falsch-Ansätze.
- Methoden wie Teilmengenauswahl und linearer Abzug kontrollieren das Raten, erfordern jedoch klare Anweisungen und können die Bewertung sowie die Schulung von Beurteilern verkomplizieren.
- Empirische Forschung zeigt, dass Teilbewertungen die Zuverlässigkeit und Trennschärfe verbessern, insbesondere bei großem Maßstab oder bei Multiple-Response-Aufgaben, die anfällig für Rateverhalten sind.
- Die meisten Klassenraumprüfungen benötigen keine fortgeschrittenen Modelle wie das Rasch-Teilbewertungsmodell, das für groß angelegte Testprogramme und Zertifizierungsprüfungen reserviert ist.
- Dedizierte Tools, die die Rubrik-Anwendung, die Konsistenz der Beurteiler und die Transparenz der Bewertung automatisieren, vereinfachen die Umsetzung und gewährleisten eine faire und konsistente Teilbewertung.
Inhaltsverzeichnis
- Was Teilbewertungs-Scoring bedeutet und wann man es einsetzt
- Gängige Methoden des Teilbewertungs-Scorings
- Wie man Teilbewertungen berechnet: Durchgerechnete Beispiele
- Statistische Modelle und IRT: Das Rasch-Teilbewertungsmodell
- Best Practices für die Umsetzung: Design, Konfiguration und Reporting
- Zuverlässigkeit, Validität und Rateunterdrückung
- Bewertungsvorlagen für Multiple-Response-Aufgaben
- Governance-Checkliste für Praktizierende vor der Skalierung
- Wann Teilbewertung ihre Komplexität rechtfertigt
- Teilbewertungs-Assessments erstellen, ohne die Infrastruktur selbst aufzubauen
- Quellen
- FAQ
Was Teilbewertungs-Scoring bedeutet und wann man es einsetzt
Dichotomes Scoring behandelt eine Antwort als entweder vollständig richtig oder vollständig falsch – einen Punkt oder null. Teilbewertungs-Scoring bricht dieses Binärsystem auf. Ein Schüler, der drei von vier korrekten Optionen bei einer Multiple-Response-Aufgabe auswählt oder der die Aufstellung eines mehrstufigen Problems perfekt löst, aber die abschließende Berechnung vermasselt, erhält eine Punktzahl proportional zu dem, was er tatsächlich demonstriert hat.
Das Argument für Teilbewertungen beruht auf drei praktischen Ergebnissen. Erstens erfasst es partielles Wissen, das eine strenge Richtig/Falsch-Regel löscht – was bei Aufgaben mit mehreren vertretbaren Teilantworten am meisten zählt. Zweitens können richtig konstruierte Bewertungsfunktionen den Erwartungswert eines zufälligen Ratens negativ machen, sodass Raten keine rationale Strategie mehr ist – ein Effekt, der formell in der Scoring-Funktionsforschung modelliert wurde. Drittens ergaben empirische Vergleiche bei Multiple-Response-Aufgaben, dass Teilbewertungsmethoden sowohl die Zuverlässigkeit als auch die Aufgabentrennschärfe verbesserten gegenüber dichotomem Scoring.
Sie brauchen nicht überall Teilbewertungen. Ein Vokabelquiz mit eindeutig richtigen Antworten profitiert nicht davon und erhöht nur die Bewertungskomplexität. Greifen Sie auf Teilbewertungen zurück, wenn Aufgaben tatsächlich mehrteilig sind, wenn Multiple-Response-Fragen mehr als zwei plausible Auswahlmöglichkeiten haben oder wenn eine konstruierte Antwort in eine Rubrik mit klar abgrenzbaren, bewertbaren Komponenten aufgeteilt werden kann.
Gängige Methoden des Teilbewertungs-Scorings
Keine einzige Formel gewinnt in jedem Kontext. Klassische Übersichten des Fachgebiets katalogisieren eine Reihe von Methoden und stellen durchweg Kompromisse anstatt eines universellen Siegers fest – die richtige Wahl hängt also vom Aufgabenformat und davon ab, wogegen Sie sich schützen möchten: gegen Raten, Inkonsistenz bei Beurteilern oder die Scoring-Komplexität selbst.
- Proportionales Scoring (Anzahl-richtig). Punkte entsprechen dem Anteil der korrekten Auswahlen an der Gesamtzahl möglicher Auswahlen. Einfach zu berechnen, leicht für Lernende verständlich, aber anfällig für Manipulationen bei Multiple-Response-Aufgaben, bei denen die Auswahl aller Optionen eine Basispunktzahl garantiert.
- Teilmengenauswahl-Scoring (SS). Volle Punktzahl nur bei Auswahl der exakt richtigen Teilmenge; Teilpunkte werden für Teilmengen vergeben, die korrekte Übereinstimmungen mit dem Lösungsschlüssel darstellen, mit Abzügen für eingeschlossene Distraktoren. Bessere Ratekontrolle als reines proportionales Scoring, allerdings auf Kosten einer etwas komplexeren Regel, die erklärt werden muss.
- Modifizierte Zapechelnyuk-artige Funktionen. Diese verwenden eine mathematisch abgeleitete Abzugsstruktur, die darauf ausgelegt ist, den Erwartungswert blinden Ratens negativ zu machen, und adressiert das Rateproblem direkt, anstatt es nur zu tolerieren.
- Lineare Abzugsmodelle. Die Punktzahl entspricht der Anzahl der richtigen Auswahlen minus einer gewichteten Anzahl falscher Auswahlen. Durch Anpassung des Abzugsgewichts einstellbar, was eine Kalibrierung ermöglicht, wie aggressiv Sie Über-Auswahl entmutigen möchten.
- Rubrik-basierte Bruchteileinteilung. Konstruierte Antworten werden anhand einer geordneten Rubrik bewertet (z. B. 0 bis 4) und dann in einen Bruchteil der gesamten Aufgabenpunkte umgerechnet. Dies ist der Standardansatz für Aufsätze, mehrstufige Mathematikaufgaben und Laborberichte.
Proportionales Scoring eignet sich für Multiple-Select- und Multiple-Blank-Aufgaben, bei denen das Format unkompliziert und das Raterisiko gering ist. Teilmengenauswahl- und lineare Abzugsmodelle eignen sich für Multiple-Response-Aufgaben, bei denen Distraktoren attraktiv genug sind, dass zufällige Auswahl die Punktzahlen in die Höhe treiben könnte. Rubrik-basierte Bruchteileinteilung ist wirklich die einzig sinnvolle Option für offene konstruierte Antworten, da es keine diskrete „Anzahl richtig" gibt, durch die man dividieren könnte.
Das Kompromissmuster ist bei allen Methoden konsistent: Einfachere Formeln (proportionales Scoring) sind für Lernende und Lehrende am leichtesten zu verstehen, aber am schwächsten gegen Raten, während abzugsbasierte und Teilmengen-Methoden das Raten besser kontrollieren, aber klarere Anweisungen erfordern, damit Lernende verstehen, wie Auswahlen gewichtet werden. Rubrik-basiertes Scoring trägt ein ganz anderes Risiko: Inkonsistenz der Beurteiler – das kann keine Formel allein beheben.
Wie man Teilbewertungen berechnet: Durchgerechnete Beispiele
Die oben genannten Formeln sind nutzlos, bis Sie die Zahlen selbst durchrechnen können. Hier sind drei durchgearbeitete Beispiele, die Sie direkt in eine Tabellenkalkulation übertragen können.
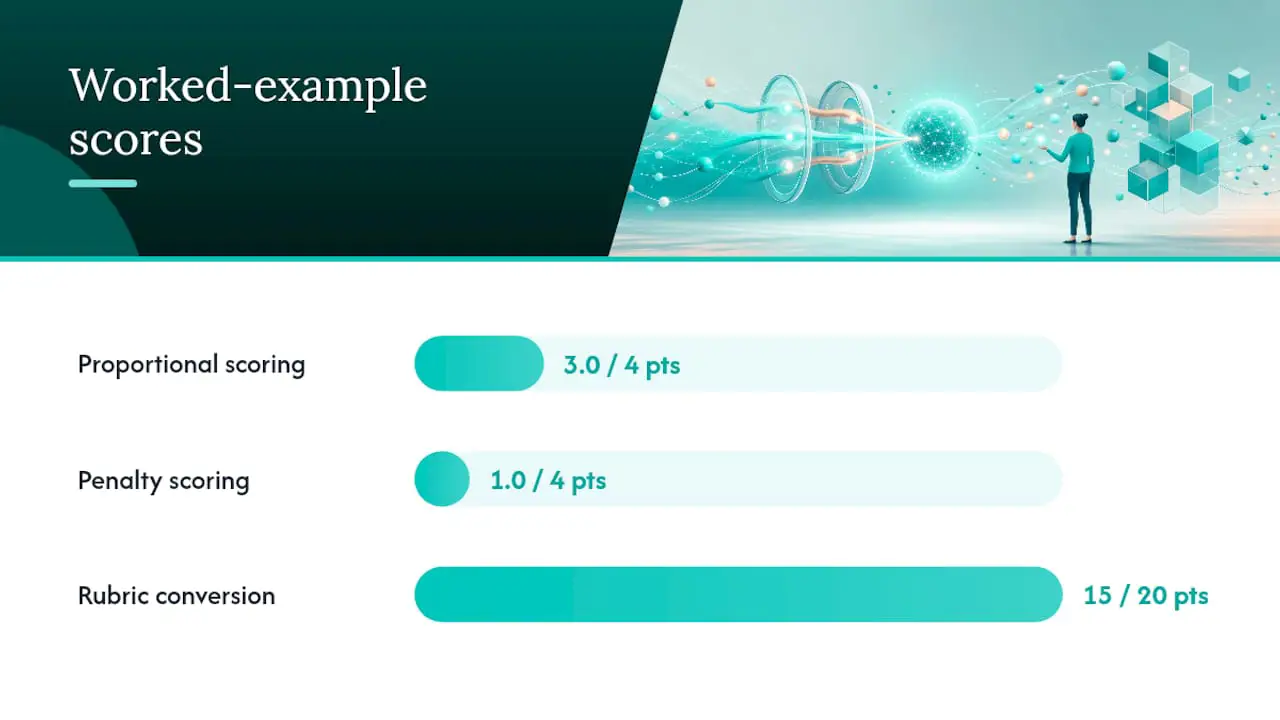
1. Proportionales Scoring bei einer Multiple-Select-Aufgabe mit vier Optionen.
Angenommen, eine Aufgabe hat vier korrekte Optionen aus sechs möglichen Auswahlmöglichkeiten, im Wert von 4 Punkten. Ein Lernender wählt 3 der 4 richtigen Optionen und 0 Distraktoren aus.
Punktzahl = (korrekte Auswahlen / Gesamtzahl korrekter Optionen) × Aufgabenpunkte Punktzahl = (3 / 4) × 4 = 3,0 Punkte
2. Teilmengenauswahl mit Distraktor-Abzug.
Gleiche Aufgabe: 4 korrekte Optionen, 2 Distraktoren, 4 Punkte insgesamt. Diesmal wählt der Lernende 3 richtige Optionen und 1 Distraktor aus.
Punktzahl = [(korrekte Auswahlen / Gesamtzahl korrekt) − (ausgewählte Distraktoren / Gesamtzahl Distraktoren)] × Aufgabenpunkte, mindestens null Punktzahl = [(3/4) − (1/2)] × 4 = [0,75 − 0,5] × 4 = 1,0 Punkt
Vergleichen Sie das mit der rein proportionalen Methode, die den Distraktor völlig ignoriert und 3,0 Punkte für dieselbe Antwort vergeben hätte. Diese Differenz ist das gesamte Argument für abzugsbasierte Methoden bei Aufgaben, bei denen Distraktoren wirklich verlockend sind.
3. Rubrik-zu-Bruchteil-Umrechnung bei einer 20-Punkte-Frage.
Eine mehrstufige Mathematikaufgabe wird auf einer Rubrik von 0 bis 4 bewertet: 0 (kein gültiger Ansatz), 1 (nur korrekte Aufstellung), 2 (korrekte Methode, schwerer Fehler), 3 (korrekte Methode, kleiner Fehler), 4 (vollständig korrekt). Die Frage ist insgesamt 20 Punkte wert.
Bruchteilpunktzahl = (erzielte Rubrikpunkte / maximale Rubrikpunkte) × Aufgabenpunkte Ein Lernender, der auf der Rubrik eine 3 erzielt, erhält: (3/4) × 20 = 15 Punkte
Wenn Sie diese Umrechnung auf eine ganze Klasse anwenden, ergibt sich eine Verteilung, die einem einfachen Prozent-richtig-Histogramm in nichts ähnelt: Punktzahlen häufen sich um Rubrikbänder (0, 5, 10, 15, 20) statt sich gleichmäßig zu verteilen – das ist wichtig zu wissen, bevor Sie eine Benotungskurve darauf aufbauen.
Profi-Tipp: Erstellen Sie diese drei Formeln als benannte Funktionen in einer gemeinsamen Tabellenkalkulationsvorlage, bevor das Prüfungsfenster öffnet. Eine Bewertungsformel nachträglich einzupassen, nachdem Lernende bereits Antworten eingereicht haben, ist der häufigste Ausgangspunkt für Bewertungsstreitigkeiten.
Statistische Modelle und IRT: Das Rasch-Teilbewertungsmodell
Bruchzahlbewertungsformeln beantworten die Frage: „Wie viele Punkte hat diese Antwort erzielt?" Die Item-Response-Theorie (IRT) beantwortet eine andere Frage: „Wie viel Fähigkeit zeigt diese Antwort tatsächlich an, wenn wir berücksichtigen, wie schwierig es ist, jede Antwortkategorie zu erreichen?" Dieser Unterschied ist wichtig, sobald man vom Bewerten in einer einzelnen Klasse zu einem Kontext übergeht, in dem Punktzahlen über verschiedene Testformen, Kohorten oder Jahre hinweg verglichen werden müssen.
Das Rasch-Teilbewertungsmodell, entwickelt von Geoff Masters, erweitert das standardmäßige dichotome Rasch-Modell auf Aufgaben mit geordneten Antwortkategorien. Anstatt „Schritt 2 von 4" einfach als halb so viel wie „Schritt 4 von 4" zu behandeln, schätzt das Rasch-PCM-Modell für den Übergang zwischen jedem Paar benachbarter Kategorien einen separaten Schwellenparameter. Der Übergang von einer Rubrikbewertung von 1 auf 2 erfordert möglicherweise erheblich mehr demonstrierte Fähigkeit als der Übergang von 2 auf 3, und das Modell erfasst das, anstatt anzunehmen, dass jeder Schritt gleich ist.
Der praktische Nutzen liegt in der Parameterseparabilität: Die geschätzte Fähigkeit einer Prüfungsperson und die Kategorieschwellen einer Aufgabe können unabhängig voneinander geschätzt werden, was formübergreifende Vergleiche statistisch vertretbar macht.
Wann rechtfertigt die zusätzliche Komplexität ihren Aufwand?
- Groß angelegte Testprogramme, bei denen Tausende von Antworten über mehrere Prüfungsformen hinweg konsistent interpretiert werden müssen.
- Linking und Equating, wenn verschiedene Gruppen von Lernenden verschiedene Testversionen ablegen und die Punktzahlen auf jeder Version dasselbe bedeuten müssen.
- Präzise Aufgabenkalibrierung, wenn Sie genau wissen müssen, wie viel Fähigkeit eine „2" von einer „3" auf einer Rubrik trennt, anstatt gleiche Abstände anzunehmen.
- Differential Item Functioning-Prüfungen, bei denen Sie bestätigen müssen, dass die Teilbewertungsschritte einer Aufgabe über demografische Gruppen hinweg konsistent funktionieren, bevor Sie dem Gesamtscore vertrauen.
Ein einzelnes Klassenraumquiz braucht fast nie eine Rasch-Kalibrierung. Eine national durchgeführte Zertifizierungsprüfung, die über mehrere Testfenster hinweg wiederverwendet wird und auf der Bestehen/Nichtbestehen-Entscheidungen mit realen Konsequenzen beruhen, braucht sie fast immer. Die Grenze zwischen „Tabellenkalkulationsformel verwenden" und „IRT-Software verwenden" ist wirklich eine Grenze bezüglich Einsatz und Maßstab – nicht bezüglich des Aufgabenformats.
Best Practices für die Umsetzung: Design, Konfiguration und Reporting
Teilbewertungen richtig zu gestalten beginnt weit bevor ein Lernender die Aufgabe sieht, und endet nicht, wenn die Punktzahlen generiert sind. Drei Phasen verdienen besondere Aufmerksamkeit: Design, Plattformkonfiguration und Reporting.
Design-Checkliste. Bevor Sie eine einzige Aufgabe formulieren, legen Sie die Bewertungsregel fest – nicht nachdem das Pilotieren Inkonsistenz aufgedeckt hat.
- Schreiben Sie die Rubrik oder Punkteverteilungsregel gleichzeitig mit der Aufgabe – nicht danach.
- Verwenden Sie eine konsistente Punkteskala über ähnliche Aufgaben hinweg, damit Lernende vorhersehen können, wie Teilpunkte verteilt werden.
- Testen Sie neue Rubriken an einer kleinen Stichprobe echter oder Übungsantworten, bevor Sie sie im großen Maßstab einsetzen, und passen Sie Ankerbeschreibungen an, bei denen zwei Beurteiler nicht übereinstimmen.
- Definieren Sie 3 bis 5 Ankerantworten pro Bewertungsband für konstruierte Antwort-Rubriken – eine Praxis, die von Forschung zum rubrik-basierten Teilbewertungs-Scoring unterstützt wird, die empfiehlt, Beurteiler anhand von Musterantworten zu schulen, um eine akzeptable Interrater-Übereinstimmung zu erreichen.
LMS- und Plattformkonfiguration. Die meisten Lernmanagementsysteme verbergen Teilbewertungseinstellungen innerhalb von Aufgaben-Optionen statt auf Prüfungsebene – überprüfen Sie daher jeden Fragetyp einzeln, anstatt anzunehmen, dass ein globaler Schalter alles abdeckt. Bestätigen Sie, ob das den Lernenden angezeigte Feedback die Bruchteilpunktzahl, die Rubrikstufe oder beides anzeigt, da das Anzeigen nur einer gerundeten Gesamtsumme genau verbergen kann, wo Punkte verloren gingen. Exportieren Sie wann immer möglich rohe, ungerundete Bewertungsdaten. Frühzeitiges Runden und späteres Neuberechnen ist eine der schnellsten Methoden, stille Bewertungsfehler über eine große Liste einzuführen.
Reporting. Berichten Sie sowohl die rohe Bruchteilpunktzahl als auch die gerundete Gesamtsumme und sagen Sie dies ausdrücklich in dem Bewertungsbericht, der den Lernenden erreicht. Ein Lernender, der „15/20" ohne Kontext sieht, hat keine Möglichkeit zu wissen, ob er 5 Punkte durch einen großen Fehler oder mehrere kleine verloren hat. Eine einzeilige Erklärung, wie die Teilbewertung berechnet wurde, dem Bewertungsbericht beigefügt, löst die meisten Streitigkeiten, bevor sie entstehen. Teams, die Bewertungsrubriken für strukturierte Assessments entwickeln, finden zusätzliche Rubrikdesign-Leitlinien und Vorlagen, die direkt mit Bruchteil-Scoring-Ansätzen kombiniert werden können.
Zuverlässigkeit, Validität und Rateunterdrückung
Zuverlässigkeit ist die Frage, die entscheidet, ob die Teilbewertung die zusätzliche Komplexität wert war. Wenn eine Scoring-Änderung die Konsistenz Ihres Assessments nicht messbar verbessert, ist der zusätzliche Aufwand für Beurteilerschulung und Berechnungsaufwand schwer zu rechtfertigen.
Die empirischen Belege fallen hier günstig aus. Vergleichsstudien zu Bewertungsmethoden bei Multiple-Response-Aufgaben ergaben, dass Teilbewertungsansätze die Zuverlässigkeit und Trennschärfe im Vergleich zu einfachem dichotomem Scoring verbesserten – insbesondere bei Aufgaben mit mehr als zwei Antwortoptionen, bei denen eine Richtig/Falsch-Aufteilung bedeutungsvolle Variation verwirft. Getrennt davon ergaben theoretische Arbeiten zu Bewertungsfunktionen, die auf negativem Erwartungsratewert basieren, dass diese Funktionen sowohl die Zuverlässigkeit als auch die Trennschärfe gegenüber einfachem Richtig-oder-Falsch-Scoring verbessern, insbesondere sobald ein Rateabzug eingebaut ist.
Drei praktische Überprüfungen zeigen Ihnen, ob der Wechsel sich in Ihren eigenen Daten auszahlt:
Aufgaben-Gesamtkorrelation. Berechnen Sie sie nach dem Wechsel zur Teilbewertung neu. Eine Aufgabe, deren Korrelation mit der Gesamtpunktzahl steigt, trennt starke von schwachen Leistungsträgern unter der neuen Bewertungsregel besser.
Cronbachs Alpha vor und nach dem Wechsel. Führen Sie denselben Testdatensatz durch beide Bewertungsregeln und vergleichen Sie die Alpha-Werte direkt. Ein bedeutsamer Anstieg ist ein starkes Signal, dass die Teilbewertung Informationen erfasst hat, die die binäre Version verworfen hätte.
IRT-Fit-Statistiken, wo bereits ein Rasch- oder anderes IRT-Modell verwendet wird. Kategorieschwellen, die ungeordnet herauskommen – d. h. eine höhere Rubrikbewertung entspricht nicht einer höheren geschätzten Fähigkeit –, kennzeichnen eine Rubrik, die überarbeitet werden muss, unabhängig davon, was die rohen Zuverlässigkeitswerte sagen.
Nichts davon ist kostenlos. Die Scoring-Komplexität steigt mit jeder zusätzlichen Formelvariante, die Variabilität der Beurteiler wird zu einem realen Problem, sobald Sie eine rubrik-basierte Komponente einführen, und der Verwaltungsaufwand steigt, wenn Sie über einen einfachen Antwortschlüssel hinaus Software oder Tabellenkalkulationsinfrastruktur benötigen. Wägen Sie diese Kosten gegen Ihren tatsächlichen Einsatz ab. Ein wöchentliches Quiz rechtfertigt selten den Aufwand; eine Zertifizierungsprüfung fast immer.
Bewertungsvorlagen für Multiple-Response-Aufgaben
Multiple-Response-Aufgaben, bei denen ein Lernender mehrere Optionen aus einer längeren Liste auswählt, sind der Bereich, in dem Raten der Validität eines Tests am meisten schadet. Ein Lernender, der bei einer „Wählen Sie alle zutreffenden" Aufgabe mit vier richtigen Antworten aus sechs Auswahlmöglichkeiten jede Option auswählt, erhält bei naivem proportionalem Scoring immer Teilpunkte – unabhängig davon, ob er etwas weiß oder nicht.
Die Lösung ist eine Bewertungsvorlage, die auf dem Erwartungswert aufbaut. Eine gängige Struktur: p1 Punkte vergeben, wenn der Lernende genau den Schlüssel auswählt (den vollständigen korrekten Satz) oder, in manchen Formulierungen, wenn jeder Distraktor korrekt ausgeschlossen wird; andernfalls eine pc − m Formel anwenden, wobei pc der Anteil korrekt ist und m ein Abzug ist, der auf Auswahlen außerhalb des Schlüssels skaliert wird. Das Ziel, wie formale Scoring-Funktionsforschung darlegt, ist sicherzustellen, dass die Mathematik selbst sorglose Über-Auswahl entmutigt.
- Bemessen Sie den Abzug (m) so, dass der Erwartungswert der Auswahl aller Optionen oder einer zufälligen Auswahl negativ oder bestenfalls null herauskommt.
- Testen Sie Ihren Abzug anhand einer „Wähle alles aus"-Antwort, bevor Sie die Aufgabe einsetzen. Wenn diese Antwort über null Punkte erzielt, ist der Abzug zu klein.
- Testen Sie es auch anhand einer ehrlich partiellen Wissensantwort. Wenn ein Lernender 3 von 4 richtigen Optionen korrekt identifiziert und beide Distraktoren ausschließt, aber schlechter abschneidet als jemand, der breit geraten hat, ist der Abzug zu groß.
Die Formulierung der Aufgabe ist genauso wichtig wie die dahinterliegende Formel. Anweisungen, die „Wählen Sie alle richtigen Antworten" lauten, ohne Hinweise auf Abzüge, verleiten Lernende zum Raten, da es in der Formulierung selbst kein Negativsignal gibt. Fügen Sie eine kurze Zeile hinzu, die besagt, dass falsche Auswahlen die Punktzahl reduzieren, und Sie erhalten ehrlichere Teilwissensangaben, weil Lernende keinen Anreiz mehr haben, Optionen auszuwählen, bei denen sie unsicher sind, nur um auf Nummer sicher zu gehen.
Governance-Checkliste für Praktizierende vor der Skalierung
Bevor Sie Teilbewertungen über eine Pilotgruppe hinaus einführen, führen Sie diese vier Überprüfungen durch:
- Rubrikklarheit. Bestätigen Sie, dass jede Rubrikkategorie eine klare, beobachtbare Ankerbeschreibung hat – nicht nur eine vage Bezeichnung wie „größtenteils korrekt".
- Interrater-Zuverlässigkeit. Lassen Sie zwei Beurteiler unabhängig voneinander dieselben 20 bis 30 Beispielantworten bewerten und überprüfen Sie die Übereinstimmung, bevor Sie den Bewertungen eines einzelnen Beurteilers im großen Maßstab vertrauen.
- Pilotvergleich. Bewerten Sie denselben Antwortsatz sowohl nach der alten Bewertungsregel als auch nach der neuen Teilbewertungsregel und vergleichen Sie Zuverlässigkeit und Notenverteilung nebeneinander.
- Sensitivitätsanalyse. Justieren Sie Ihre Abzugsgewichte oder Punktzuweisungen leicht und führen Sie die Analyse erneut aus. Leitlinien für Scoring-Modelle empfehlen diesen Schritt, weil kleine Gewichtungsänderungen Zuverlässigkeitsergebnisse umkehren oder Kandidatenrankings vollständig neu ordnen können.
Dokumentieren Sie jede Bewertungsentscheidung – einschließlich der Begründung für eine bestimmte Formel oder Abzugsgröße – in einem Format, das Stakeholder später überprüfen können. Dieses Protokoll ist es, was einen vertretbaren Piloten in eine vertretbare Richtlinie verwandelt.
Wann Teilbewertung ihre Komplexität rechtfertigt
Teilbewertung ist eine Messverbesserung mit einem echten administrativen Preisschild, und so zu tun, als wäre das nicht der Fall, schadet jedem, der sie zum ersten Mal einführt. Der Gewinn an Zuverlässigkeit und Trennschärfe ist gut dokumentiert, aber ebenso die zusätzliche Belastung: mehr Beurteilerschulung, komplexere Formeln, mehr Spielraum für Meinungsverschiedenheiten darüber, was „partial" bei einer bestimmten Aufgabe tatsächlich bedeutet.
Meine ehrliche Einschätzung der Forschung ist, dass die meisten Assessments auf Klassenraumebene keine Rasch-Kalibrierung, Teilmengenauswahlabzüge oder einen der aufwändigeren oben beschriebenen Mechanismen benötigen. Eine klare Rubrik und proportionale Bruchteileinteilung deckt den Großteil der realen Klassenzimmeranforderungen ab. Wo Teilbewertung ihre Komplexität rechtfertigt, ist im großen Maßstab: Zertifizierungsprüfungen, Mehrformtestprogramme und jedes Assessment, bei dem eine falsche Scoring-Annahme sich über Tausende von Prüflingen vervielfacht statt über dreißig.
Die operative Belastung ist genau dort, wo gute Plattform-Tools den Kalkül verändern – besonders wenn Sie globales Hiring automatisieren und Compliance-Risiken reduzieren möchten. Ein Tool, das die Rubrik-Anwendung automatisiert, die Konsistenz der Beurteiler verfolgt und Bewertungsentscheidungen protokolliert, beseitigt den größten Teil der Reibung, die Lehrende davon abhält, Teilbewertungen überhaupt erst zu erproben. Pilotieren Sie zuerst, messen Sie den Zuverlässigkeitsgewinn gegenüber den Mehrkosten, und skalieren Sie den Ansatz erst dann, wenn die Zahlen es tatsächlich rechtfertigen.
— Jimmie
Teilbewertungs-Assessments erstellen, ohne die Infrastruktur selbst aufzubauen
Der größte Teil der Reibung beim Teilbewertungs-Scoring liegt nicht in der Mathematik. Es liegt in der Infrastruktur: konsistente Rubriken schreiben, Beurteiler auf Linie halten und darauf vertrauen, dass niemand den Test manipuliert hat. Talent Approved basiert auf einem Pay-as-you-go-Modell ohne Abonnement, sodass Sie nur pro abgeschlossenem Kandidaten-Assessment bezahlen und den Overhead einer Scoring-Software-Lizenzierung vermeiden, die Sie möglicherweise nur gelegentlich benötigen.
Die Magic Create-Funktion der Plattform erstellt ein rollenspezifisches, rubrik-fertiges Assessment direkt aus einer Stellenbeschreibung oder einer Kompetenzliste, was die manuelle Phase der Aufgabenentwicklung vollständig entfällt. Integrierte Anti-Cheat-Tools, einschließlich Bildschirm- und Webcam-Überwachung mit Sitzungswiederholungen, schützen die Integrität der Teilbewertungsergebnisse auf dieselbe Weise, wie Beurteilerschulung eine konstruierte Antwort-Rubrik schützt. KI-generierte Leistungszusammenfassungen wandeln Bruchteilpunktzahlen in lesbare Kandidatenrankings um, ohne dass Ihr Team die rohe Rubrikmathematik manuell interpretieren muss.
Wenn Sie Fähigkeiten bewerten statt Lernende benoten und Teilbewertungs-Scoring ohne eigene Scoring-Infrastruktur möchten, schauen Sie auf die Preisseite für Skill-Assessments und sehen Sie, was ein Pilotassessment für Ihre nächste Einstellungsrunde kosten würde.
Quellen
- Evaluating Different Scoring Methods for Multiple Response Items Providing Partial Credit
- Theoretical evaluation of partial credit scoring of the multiple-choice test item
- Partial-Credit Scoring Methods for Multiple-Choice Tests. - ERIC
FAQ
Wie berechnet man Teilbewertungen?
Dividieren Sie die erzielten Punkte (korrekte Auswahlen, Rubrikstufe oder Teilmengenübereinstimmung) durch die maximal möglichen Punkte für diese Aufgabe und multiplizieren Sie dann mit dem gesamten Punktwert der Aufgabe. Teilmengenauswahl- und lineare Abzugsmethoden subtrahieren vor dieser abschließenden Multiplikation einen gewichteten Abzug für falsche Auswahlen.
Was sind die drei Haupttypen von Credit-Scoring-Ansätzen?
Im Assessment-Design sind die drei übergeordneten Ansätze dichotomes (Richtig/Falsch) Scoring, Teilbewertungs-Scoring (proportionale, Teilmengenauswahl- oder abzugsbasierte Formeln) und rubrik-basiertes Bruchbewertungs-Scoring für konstruierte Antworten. Jeder eignet sich für unterschiedliche Aufgabenformate, und kein einziger Ansatz ist in jedem Kontext überlegen.
Was untergräbt ein Teilbewertungs-Scoring-System am häufigsten?
Unklare Rubriканker und inkonsistente Beurteilerschulung sind die häufigsten Schwachstellen, da sie Meinungsverschiedenheiten zwischen Bewertern einführen, die keine Formel im Nachhinein beheben kann. An zweiter Stelle steht ein Abzugsbetrag, der zu klein bemessen ist, was zufälliges Raten statistisch profitabel statt unterdrückt lässt.
Verbessert Teilbewertung tatsächlich die Testzuverlässigkeit?
Empirische Vergleiche bei Multiple-Response-Aufgaben ergaben, dass Teilbewertungs-Scoring sowohl die Zuverlässigkeit als auch die Trennschärfe im Vergleich zu dichotomem Scoring verbesserte – insbesondere wenn die Bewertungsfunktion falsche Auswahlen bestraft. Der Gewinn ist nicht automatisch. Er hängt von der Rubrikklarheit und der Abzugsgröße ab.
Kann eine Plattform Teilbewertungs-Scoring für Skill-Assessments übernehmen?
Ja. Talent Approved unterstützt rubrik-basiertes Scoring neben seinem Magic Create Assessment-Builder und der Anti-Cheat-Überwachung, sodass Einstellungsteams Bruchbewertungslogik anwenden können, ohne die Berechnungsinfrastruktur selbst aufzubauen. Die aktuellen Preise sind auf der Skill-Assessments-Seite aufgeführt.
Empfohlen
- 3 Zuverlässigkeitsprüfungen für gewichtete Scoring-Assessments im Einstellungsprozess
- Assessment-Bewertungsrubriken erstellen, die Lehrende pilotieren und mit KI skalieren können
- Wie man Assessment-Bestehensgrenzen richtig berechnet
- Einstellungsteams: 5 Schritte zu messung-zuerst Assessment-Analytics