
3 Fórmulas de Hoja de Cálculo para Puntuación de Crédito Parcial y Rasch
La puntuación de crédito parcial asigna puntos a lo largo de un rango en lugar de un resultado de todo o nada, recompensando al examinado por la parte de una respuesta que es correcta. Los educadores la utilizan porque mide el conocimiento parcial que la puntuación dicotómica de correcto o incorrecto descarta, y las funciones de crédito parcial bien diseñadas reducen el beneficio de adivinar al azar. Se adapta mejor a elementos de varias partes, preguntas de respuesta múltiple y respuestas construidas evaluadas con una rúbrica, especialmente cuando se necesita información diagnóstica más detallada de la que puede ofrecer una simple puntuación de aprobado/suspenso.
Resumen:
- La puntuación de crédito parcial captura mejor el conocimiento del estudiante en elementos de varias partes, de respuesta múltiple y de respuesta construida que los enfoques simples de correcto o incorrecto.
- Métodos como la selección de subconjuntos y la penalización lineal controlan las suposiciones aleatorias, pero requieren instrucciones claras y pueden introducir complejidad en la puntuación y la formación de los evaluadores.
- La investigación empírica demuestra que el crédito parcial mejora la fiabilidad y la discriminación, especialmente a escala o con elementos de respuesta múltiple propensos a las suposiciones aleatorias.
- La mayoría de las evaluaciones en el aula no necesitan modelos avanzados como el crédito parcial de Rasch, que están reservados para programas de pruebas a gran escala y exámenes de certificación.
- El uso de herramientas dedicadas que automatizan la aplicación de rúbricas, la coherencia entre evaluadores y la transparencia de la puntuación simplifica la implementación y garantiza una evaluación de crédito parcial justa y coherente.
Tabla de Contenidos
- Qué significa la puntuación de crédito parcial y cuándo utilizarla
- Métodos comunes de puntuación de crédito parcial
- Cómo calcular el crédito parcial: ejemplos prácticos
- Modelos estadísticos e IRT: el modelo de crédito parcial de Rasch
- Mejores prácticas de implementación: diseño, configuración e informes
- Fiabilidad, validez y supresión de suposiciones aleatorias
- Plantillas de puntuación para elementos de respuesta múltiple
- Lista de verificación de gobernanza para profesionales antes de escalar
- Cuándo el crédito parcial justifica su complejidad
- Crea evaluaciones de crédito parcial sin construir la infraestructura tú mismo
- Fuentes
- Preguntas frecuentes
Qué significa la puntuación de crédito parcial y cuándo utilizarla
La puntuación dicotómica trata una respuesta como completamente correcta o completamente incorrecta, con un valor de un punto o cero. La puntuación de crédito parcial rompe ese esquema binario. Un estudiante que selecciona tres de cuatro opciones correctas en un elemento de respuesta múltiple, o que resuelve correctamente el planteamiento de un problema de varios pasos pero falla en el cálculo final, recibe crédito proporcional a lo que realmente demostró.
El argumento a favor del crédito parcial se basa en tres resultados prácticos. En primer lugar, captura el conocimiento parcial que una regla estricta de correcto/incorrecto elimina, lo que importa más en los elementos con varias sub-respuestas defendibles. En segundo lugar, las funciones de puntuación correctamente construidas pueden hacer que el valor esperado de una suposición aleatoria sea negativo, de modo que adivinar deja de ser una estrategia racional, un efecto modelado formalmente en la investigación sobre funciones de puntuación. En tercer lugar, las comparaciones empíricas sobre elementos de respuesta múltiple encontraron que los métodos de crédito parcial mejoraron tanto la fiabilidad como la discriminación de los elementos en relación con la puntuación dicotómica.
No se necesita crédito parcial en todas partes. Un cuestionario de vocabulario con respuestas correctas únicas no gana nada con él y solo añade complejidad a la puntuación. Recurre al crédito parcial cuando los elementos sean genuinamente de varias partes, cuando las preguntas de respuesta múltiple tengan más de dos selecciones plausibles, o cuando una respuesta construida pueda descomponerse en una rúbrica con componentes distintos y evaluables.
Métodos comunes de puntuación de crédito parcial
Ninguna fórmula única gana en todos los contextos. Las revisiones clásicas del campo catalogan una variedad de métodos y encuentran de manera consistente ventajas e inconvenientes en lugar de un ganador universal, por lo que la elección correcta depende del formato del elemento y de lo que se intenta proteger, ya sea contra las suposiciones aleatorias, la inconsistencia del evaluador o la propia complejidad de la puntuación.
- Puntuación proporcional (número de respuestas correctas). Los puntos equivalen a la fracción de selecciones correctas sobre el total de selecciones posibles. Simple de calcular, fácil de explicar a los estudiantes, pero vulnerable a la manipulación en elementos de respuesta múltiple donde seleccionarlo todo garantiza una puntuación base.
- Puntuación por selección de subconjuntos (SS). Se otorga crédito completo solo cuando se elige el subconjunto exactamente correcto; el crédito parcial se concede por subconjuntos que coinciden de manera adecuada con la clave, con penalizaciones por los distractores incluidos. Mejor control de suposiciones que la puntuación puramente proporcional, a costa de una regla algo más compleja de explicar.
- Funciones de estilo Zapechelnyuk modificado. Estas utilizan una estructura de penalización derivada matemáticamente, diseñada para que el valor esperado de adivinar a ciegas sea negativo, abordando directamente el problema de adivinar en lugar de simplemente tolerarlo.
- Modelos de penalización lineal. La puntuación equivale al número de selecciones correctas menos un recuento ponderado de selecciones incorrectas. Ajustable mediante la modificación del peso de la penalización, lo que permite calibrar la agresividad con la que se desea desincentivar la sobreselección.
- Fraccionamiento basado en rúbricas. Las respuestas construidas se puntúan según una rúbrica ordenada (de 0 a 4, por ejemplo), y luego se convierten en una fracción de los puntos totales del elemento. Este es el enfoque estándar para ensayos, problemas matemáticos de varios pasos e informes de laboratorio.
La puntuación proporcional se adapta a elementos de selección múltiple y de espacios en blanco múltiples donde el formato es sencillo y el riesgo de adivinar es bajo. Los modelos de selección de subconjuntos y de penalización lineal se adaptan a elementos de respuesta múltiple donde los distractores son lo suficientemente atractivos como para que la selección aleatoria pueda inflar las puntuaciones. El fraccionamiento basado en rúbricas es realmente la única opción sólida para las respuestas construidas de tipo abierto, ya que no existe un "número correcto" discreto que dividir.
El patrón de ventajas e inconvenientes es coherente en todos los métodos: las fórmulas más simples (puntuación proporcional) son las más fáciles de entender para estudiantes e instructores, pero las más débiles frente a las suposiciones aleatorias, mientras que los métodos de penalización y de subconjuntos controlan mejor las suposiciones pero exigen instrucciones más claras para que los estudiantes entiendan cómo se ponderan las selecciones. La puntuación basada en rúbricas conlleva un riesgo completamente diferente: la inconsistencia entre evaluadores, que ninguna fórmula puede solucionar por sí sola.
Cómo calcular el crédito parcial: ejemplos prácticos
Las fórmulas anteriores son inútiles hasta que puedas hacer los cálculos tú mismo. Aquí hay tres ejemplos prácticos que puedes transferir directamente a una hoja de cálculo.
1. Puntuación proporcional en un elemento de selección múltiple con cuatro opciones.
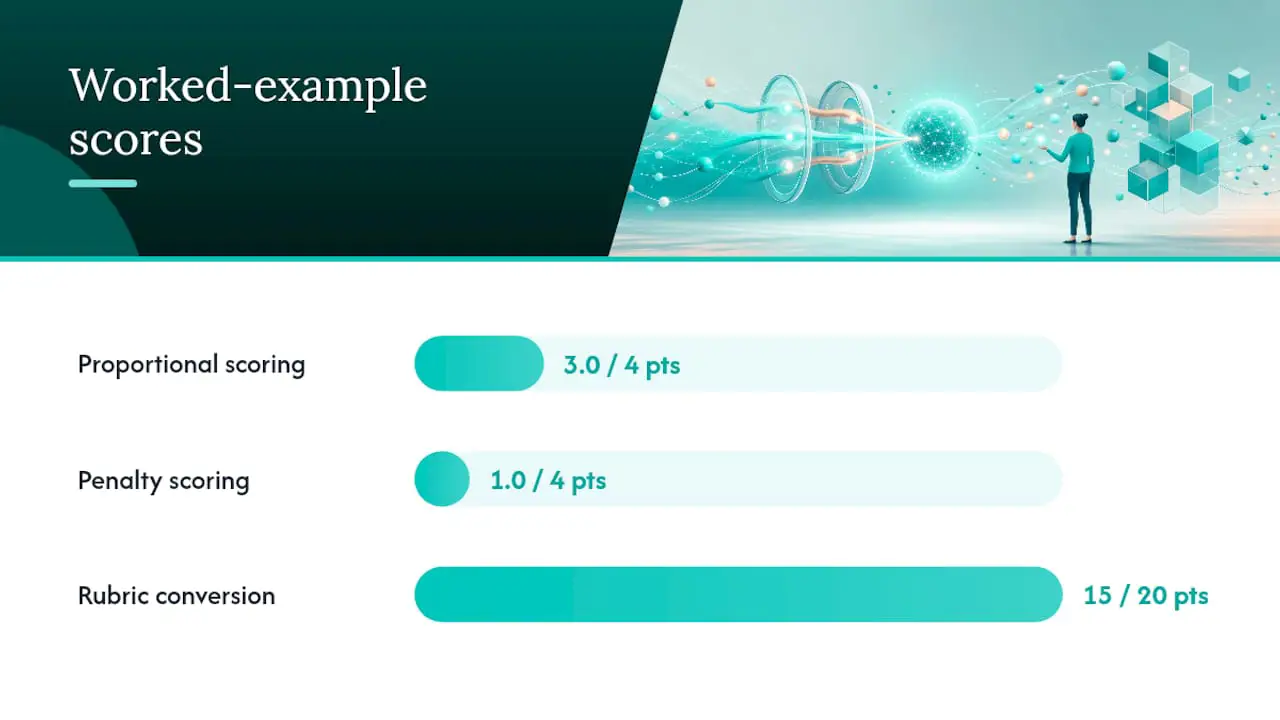
Supón que un elemento tiene cuatro opciones correctas de un total de seis opciones, con un valor de 4 puntos. Un estudiante selecciona 3 de las 4 opciones correctas y 0 distractores.
Puntuación = (selecciones correctas / total de opciones correctas) × puntos del elemento Puntuación = (3 / 4) × 4 = 3,0 puntos
2. Selección de subconjuntos con penalización por distractor.
El mismo elemento: 4 opciones correctas, 2 distractores, 4 puntos en total. Esta vez el estudiante selecciona 3 opciones correctas y 1 distractor.
Puntuación = [(correctas seleccionadas / total correctas) − (distractores seleccionados / total distractores)] × puntos del elemento, con mínimo de cero Puntuación = [(3/4) − (1/2)] × 4 = [0,75 − 0,5] × 4 = 1,0 punto
Compara eso con el método solo proporcional, que habría ignorado completamente el distractor y habría otorgado 3,0 puntos por la respuesta idéntica. Esa diferencia es el argumento completo a favor de los métodos basados en penalizaciones en elementos donde los distractores son genuinamente tentadores.
3. Conversión de rúbrica a fracción en una pregunta de 20 puntos.
Un problema matemático de varios pasos se califica con una rúbrica de 0 a 4: 0 (sin enfoque válido), 1 (solo planteamiento correcto), 2 (método correcto, error importante), 3 (método correcto, error menor), 4 (completamente correcto). La pregunta vale 20 puntos en total.
Puntuación fraccional = (puntos de rúbrica obtenidos / puntos máximos de rúbrica) × puntos del elemento Un estudiante que obtiene un 3 en la rúbrica recibe: (3/4) × 20 = 15 puntos
Aplica esa conversión a toda la lista de la clase y obtienes una distribución que no se parece en nada a un simple histograma de porcentaje de respuestas correctas: las puntuaciones se agrupan en torno a las bandas de la rúbrica (0, 5, 10, 15, 20) en lugar de distribuirse de forma continua, lo cual vale la pena saber antes de construir una curva de calificaciones sobre esa base.
Consejo profesional: Crea estas tres fórmulas como funciones con nombre en una plantilla de hoja de cálculo compartida antes de que se abra el período del examen. Adaptar una fórmula de puntuación después de que los estudiantes ya han enviado sus respuestas es donde comienzan la mayoría de las disputas sobre la puntuación.
Modelos estadísticos e IRT: el modelo de crédito parcial de Rasch
Las fórmulas de puntuación fraccional responden a la pregunta "¿cuántos puntos obtuvo esta respuesta?". La teoría de respuesta al ítem (IRT, por sus siglas en inglés) responde a una pregunta diferente: "¿cuánta habilidad indica realmente esta respuesta, una vez que se tiene en cuenta cuán difícil es alcanzar cada categoría de respuesta?". Esa distinción importa en cuanto se pasa de la calificación en una sola aula a cualquier contexto donde las puntuaciones deban compararse entre formularios, cohortes o años.
El modelo de crédito parcial de Rasch, desarrollado por Geoff Masters, extiende el modelo de Rasch dicotómico estándar a elementos con categorías de respuesta ordenadas. En lugar de tratar el "paso 2 de 4" como simplemente la mitad del "paso 4 de 4", el PCM de Rasch estima un parámetro de umbral separado para la transición entre cada par de categorías adyacentes. Pasar de una puntuación de 1 a 2 en una rúbrica puede requerir considerablemente más habilidad demostrada que pasar de 2 a 3, y el modelo captura eso en lugar de asumir que cada paso es igual.
El beneficio práctico es la separabilidad de parámetros: la habilidad estimada de un examinado y los umbrales de categoría de un elemento pueden estimarse de forma independiente entre sí, lo que es lo que hace que las comparaciones entre formularios sean estadísticamente defendibles en primer lugar.
¿Cuándo justifica la complejidad añadida?
- Programas de pruebas a gran escala, donde miles de respuestas necesitan una interpretación coherente en múltiples formularios de examen.
- Vinculación y equiparación, cuando diferentes grupos de estudiantes realizan diferentes versiones de una prueba y las puntuaciones deben significar lo mismo en cada una.
- Calibración precisa de elementos, cuando se necesita saber exactamente cuánta habilidad separa un "2" de un "3" en una rúbrica, en lugar de asumir un espaciado uniforme.
- Verificaciones de funcionamiento diferencial del ítem, donde se debe confirmar que los pasos de crédito parcial de un elemento se comportan de manera consistente entre grupos demográficos antes de confiar en la puntuación agregada.
Un cuestionario de clase individual casi nunca necesita calibración de Rasch. Un examen de certificación administrado a nivel nacional, reutilizado en diferentes períodos de prueba y del que dependen decisiones de aprobado/suspenso con consecuencias reales, casi siempre lo necesita. La línea entre "usa una fórmula en una hoja de cálculo" y "usa software de IRT" es realmente una línea sobre las apuestas y la escala, no sobre el formato del elemento.
Mejores prácticas de implementación: diseño, configuración e informes
Hacer bien el crédito parcial comienza mucho antes de que cualquier estudiante vea el elemento, y no termina cuando se generan las puntuaciones. Tres fases merecen una atención deliberada: diseño, configuración de la plataforma e informes.
Lista de verificación de diseño. Antes de escribir un solo elemento, establece la regla de puntuación, no después de que el piloto revele inconsistencias.
- Escribe la rúbrica o la regla de asignación de puntos al mismo tiempo que escribes el elemento, no después.
- Usa una escala de puntos consistente en elementos similares para que los estudiantes puedan predecir cómo se distribuye el crédito parcial.
- Prueba las nuevas rúbricas en una pequeña muestra de respuestas reales o de práctica antes de implementarlas a escala, y ajusta las descripciones de anclaje donde dos evaluadores no estén de acuerdo.
- Define de 3 a 5 respuestas de anclaje por banda de puntuación para las rúbricas de respuesta construida, una práctica respaldada por investigaciones sobre puntuación de crédito parcial basada en rúbricas que recomienda formar a los evaluadores con guiones ejemplares para alcanzar un acuerdo aceptable entre evaluadores.
Configuración del LMS y la plataforma. La mayoría de los sistemas de gestión del aprendizaje tienen la configuración de crédito parcial dentro de las opciones a nivel de elemento en lugar de los ajustes a nivel de examen, así que comprueba cada tipo de pregunta individualmente en lugar de asumir que un selector global lo cubre todo. Confirma si los comentarios que se muestran a los estudiantes presentan la puntuación fraccional, el nivel de rúbrica o ambos, ya que mostrar solo un total redondeado puede ocultar exactamente dónde se perdieron los puntos. Exporta datos de puntuación sin procesar y sin redondear siempre que sea posible. Redondear pronto y recalcular después es una de las formas más rápidas de introducir errores de calificación silenciosos en una lista extensa de estudiantes.
Informes. Informa tanto de la puntuación fraccional sin procesar como del total redondeado, y dilo explícitamente en cualquier informe de puntuación que llegue al estudiante. Un estudiante que ve "15/20" sin contexto no tiene manera de saber si perdió 5 puntos por un gran error o por varios pequeños. Una explicación de una línea sobre cómo se calculó el crédito parcial, adjunta al informe de puntuación, resuelve la mayoría de las disputas antes de que empiecen. Los equipos que desarrollan rúbricas de puntuación para evaluaciones estructuradas pueden encontrar orientación sobre diseño de rúbricas y plantillas adicionales que se combinan directamente con los enfoques de puntuación fraccional.
Fiabilidad, validez y supresión de suposiciones aleatorias
La fiabilidad es la pregunta que decide si el crédito parcial valió la complejidad añadida. Si un cambio de puntuación no mejora de manera medible la coherencia de tu evaluación, la formación adicional de evaluadores y la carga de cálculo son difíciles de justificar.
El registro empírico se inclina favorablemente en este sentido. Los estudios comparativos de métodos de puntuación en elementos de respuesta múltiple encontraron que los enfoques de crédito parcial mejoraron la fiabilidad y la discriminación en comparación con la puntuación dicotómica simple, particularmente en elementos con más de dos opciones de respuesta donde una división de correcto/incorrecto descarta variación significativa. Por separado, el trabajo teórico sobre funciones de puntuación diseñadas en torno al valor esperado negativo de adivinar encontró que estas funciones tienden a mejorar tanto la fiabilidad como el poder discriminador en relación con la puntuación simple de correcto o incorrecto, especialmente una vez que se incorpora una penalización por adivinar.
Tres comprobaciones prácticas te indican si el cambio está dando sus frutos en tus propios datos:
Correlación ítem-total. Recalcúlala después de cambiar a crédito parcial. Un elemento cuya correlación con la puntuación total mejora está haciendo ahora un mejor trabajo de separar a los estudiantes con buen rendimiento de los que tienen un rendimiento bajo bajo la nueva regla de puntuación.
Alfa de Cronbach antes y después. Pasa el mismo conjunto de datos de prueba por ambas reglas de puntuación y compara los valores alfa directamente. Un aumento significativo es una señal clara de que el crédito parcial capturó información que la versión binaria descartó.
Estadísticas de ajuste de IRT, donde ya se utiliza un modelo de Rasch u otro modelo de IRT. Los umbrales de categoría que resultan desordenados, lo que significa que una puntuación de rúbrica más alta no corresponde a una habilidad estimada más alta, indican una rúbrica que necesita revisión independientemente de lo que digan los números de fiabilidad sin procesar.
Nada de esto es gratuito. La complejidad de la puntuación aumenta con cada variante de fórmula añadida, la variabilidad del evaluador se convierte en una preocupación real en el momento en que se introduce cualquier componente basado en rúbricas, y el coste administrativo sube cuando se necesita software o infraestructura de hoja de cálculo más allá de una simple clave de respuestas. Sopesa esos costes frente a tus apuestas reales. Un cuestionario semanal rara vez justifica la carga; un examen de certificación casi siempre lo hace.
Plantillas de puntuación para elementos de respuesta múltiple
Los elementos de respuesta múltiple, donde un estudiante selecciona varias opciones de una lista más larga, son donde adivinar causa el mayor daño a la validez de una prueba. Un estudiante que selecciona todas las opciones en un elemento de "elige todas las que correspondan" con cuatro respuestas correctas de seis opciones siempre obtendrá crédito parcial bajo una puntuación proporcional ingenua, independientemente de si sabe algo o no.
La solución es una plantilla de puntuación construida en torno al valor esperado. Una estructura común: otorgar p1 puntos cuando el estudiante selecciona exactamente la clave (el conjunto correcto completo) o, en algunas formulaciones, cuando cada distractor se excluye correctamente; de lo contrario, aplicar una fórmula pc − m, donde pc es la proporción de respuestas correctas y m es una penalización escalada a las selecciones fuera de la clave. El objetivo, como establece la investigación formal sobre funciones de puntuación, es asegurarse de que la propia matemática desaliente la sobreselección descuidada.
- Dimensiona la penalización (m) de modo que el valor esperado de seleccionar todas las opciones, o de seleccionar al azar, resulte negativo o como mucho cero.
- Prueba tu penalización con una respuesta de "seleccionar todo" antes de implementar el elemento. Si esa respuesta puntúa por encima de cero, la penalización es demasiado pequeña.
- Pruébala también con una respuesta de conocimiento parcial genuinamente honesta. Si un estudiante identifica correctamente 3 de 4 opciones correctas y descarta ambos distractores, pero puntúa peor que alguien que adivinó ampliamente, la penalización es demasiado grande.
La formulación del elemento importa tanto como la fórmula que hay detrás. Las instrucciones que dicen "selecciona todas las respuestas correctas" sin ninguna orientación sobre las penalizaciones empujan a los estudiantes a adivinar, ya que no hay ninguna señal negativa en la propia redacción. Añade una breve línea que indique que las selecciones incorrectas reducen la puntuación, y obtendrás informes de conocimiento parcial más honestos, porque los estudiantes ya no tienen incentivo para seleccionar opciones sobre las que no están seguros solo para cubrirse.
Lista de verificación de gobernanza para profesionales antes de escalar
Antes de implementar el crédito parcial más allá de un grupo piloto, realiza estas cuatro comprobaciones:
- Claridad de la rúbrica. Confirma que cada nivel de la rúbrica tiene una descripción de anclaje observable y distinta, no solo una etiqueta vaga como "mayormente correcto".
- Fiabilidad entre evaluadores. Pide a dos evaluadores que puntúen de forma independiente las mismas 20 a 30 respuestas de muestra y comprueba el acuerdo antes de confiar en las puntuaciones de un solo evaluador a escala.
- Comparación piloto. Puntúa el mismo conjunto de respuestas tanto con la regla de puntuación antigua como con la nueva regla de crédito parcial, y compara la fiabilidad y la distribución de calificaciones en paralelo.
- Análisis de sensibilidad. Ajusta ligeramente los pesos de penalización o las asignaciones de puntos y vuelve a ejecutar el análisis. La guía de modelos de puntuación recomienda este paso porque pequeños cambios de ponderación pueden cambiar los resultados de fiabilidad o reordenar completamente el ranking de los candidatos.
Documenta cada decisión de puntuación, incluido el motivo por el que se eligió una fórmula o un tamaño de penalización particular, en un formato que las partes interesadas puedan revisar más adelante. Ese registro es lo que convierte un piloto defendible en una política defendible.
Cuándo el crédito parcial justifica su complejidad
El crédito parcial es una mejora de la medición con un precio administrativo real, y pretender lo contrario hace un flaco favor a cualquiera que lo pilote por primera vez. La ganancia en fiabilidad y discriminación está bien documentada, pero también lo está la carga añadida: más formación de evaluadores, fórmulas más complejas, más margen para el desacuerdo sobre lo que "parcial" significa realmente en un elemento determinado.
Mi lectura honesta de la investigación es que la mayoría de las evaluaciones a nivel de aula no necesitan calibración de Rasch, penalizaciones por selección de subconjuntos ni ninguna de las maquinarias más elaboradas descritas anteriormente. Una rúbrica clara y el fraccionamiento proporcional cubren la mayoría de las necesidades reales del aula. Donde el crédito parcial justifica su complejidad es a escala: exámenes de certificación, programas de pruebas con múltiples formularios y cualquier evaluación donde una suposición de puntuación incorrecta se multiplica entre miles de examinados en lugar de treinta.
La carga operativa es exactamente donde las buenas herramientas de plataforma cambian el cálculo, especialmente si deseas automatizar la contratación global y reducir los riesgos de cumplimiento. Una herramienta que automatiza la aplicación de rúbricas, rastrea la coherencia entre evaluadores y registra las decisiones de puntuación elimina la mayor parte de la fricción que impide a los educadores pilotar el crédito parcial. Pilota primero, mide la ganancia de fiabilidad frente al coste añadido, y escala el enfoque solo cuando los números realmente lo justifiquen.
— Jimmie
Crea evaluaciones de crédito parcial sin construir la infraestructura tú mismo
La mayor parte de la fricción en la puntuación de crédito parcial no es la matemática. Es la infraestructura: escribir rúbricas coherentes, mantener a los evaluadores alineados y confiar en que nadie manipuló la prueba. Talent Approved está construido en torno a un modelo de pago por uso sin suscripción, por lo que solo pagas por cada evaluación de candidato completada y te ahorras los gastos generales de licenciar software de puntuación que quizás solo necesitas ocasionalmente.
La función Magic Create de la plataforma crea una evaluación específica para el puesto, lista para usar con rúbricas, directamente a partir de una descripción del trabajo o una lista de habilidades, lo que elimina completamente la fase de redacción manual de elementos. Las herramientas integradas anti-trampa, incluido el monitoreo de pantalla y cámara web con repeticiones de sesión, protegen la integridad de los resultados de crédito parcial de la misma manera que la formación de evaluadores protege una rúbrica de respuesta construida. Los resúmenes de rendimiento generados por IA convierten las puntuaciones fraccionales en clasificaciones de candidatos legibles sin obligar a tu equipo a interpretar la matemática de rúbricas sin procesar a mano.
Si estás evaluando habilidades en lugar de calificar estudiantes, y deseas una puntuación de estilo crédito parcial sin ser propietario de la infraestructura de puntuación, consulta la página de precios de evaluaciones de habilidades y ve cuánto costaría una evaluación piloto para tu próxima ronda de contratación.
Fuentes
- Evaluación de diferentes métodos de puntuación para elementos de respuesta múltiple que ofrecen crédito parcial
- Evaluación teórica de la puntuación de crédito parcial del ítem de prueba de opción múltiple
- Métodos de puntuación de crédito parcial para pruebas de opción múltiple. - ERIC
Preguntas frecuentes
¿Cómo se calcula el crédito parcial?
Divide los puntos obtenidos (selecciones correctas, nivel de rúbrica o coincidencia de subconjunto) entre los puntos máximos posibles para ese elemento, y luego multiplica por el valor total de puntos del elemento. Los métodos de selección de subconjuntos y de penalización lineal restan una penalización ponderada por selecciones incorrectas antes de esa multiplicación final.
¿Cuáles son los tres principales tipos de enfoques de puntuación de crédito?
En el diseño de evaluaciones, los tres enfoques amplios son la puntuación dicotómica (correcto/incorrecto), la puntuación de crédito parcial (fórmulas proporcionales, de selección de subconjuntos o basadas en penalizaciones) y la puntuación fraccional basada en rúbricas para respuestas construidas. Cada uno se adapta a diferentes formatos de elementos, y ningún enfoque único es superior en todos los contextos.
¿Qué es lo que más a menudo socava un sistema de puntuación de crédito parcial?
Los anclajes de rúbrica poco claros y la formación inconsistente de los evaluadores son los puntos de fallo más comunes, ya que introducen desacuerdo entre los evaluadores que ninguna fórmula puede corregir después del hecho. Un segundo problema muy cercano es un término de penalización demasiado pequeño, que hace que adivinar al azar siga siendo estadísticamente rentable en lugar de quedar suprimido.
¿El crédito parcial mejora realmente la fiabilidad de la prueba?
Las comparaciones empíricas sobre elementos de respuesta múltiple encontraron que la puntuación de crédito parcial mejoró tanto la fiabilidad como la discriminación en comparación con la puntuación dicotómica, particularmente cuando la función de puntuación penaliza las selecciones incorrectas. La ganancia no es automática. Depende de la claridad de la rúbrica y del tamaño de la penalización.
¿Puede una plataforma gestionar la puntuación de crédito parcial para evaluaciones de habilidades?
Sí. Talent Approved admite la puntuación basada en rúbricas junto con su constructor de evaluaciones Magic Create y el monitoreo anti-trampa, lo que permite a los equipos de contratación aplicar lógica de puntuación fraccional sin construir la infraestructura de cálculo ellos mismos. Los precios actuales se encuentran en la página de evaluaciones de habilidades.
Recomendado
- 3 comprobaciones de fiabilidad para evaluaciones de puntuación ponderada en contratación
- Crea rúbricas de puntuación para evaluaciones que los educadores puedan pilotar y escalar con IA
- Cómo calcular los umbrales de aprobado en evaluaciones de la manera correcta
- Equipos de contratación: 5 pasos para un análisis de evaluaciones orientado a la medición