
جزوی کریڈٹ اسکورنگ اور Rasch کے لیے 3 اسپریڈشیٹ فارمولے
جزوی کریڈٹ اسکورنگ پوائنٹس کو ایک حد کے ساتھ تفویض کرتی ہے بجائے اس کے کہ سب کچھ ملے یا کچھ نہیں، اور جواب کے اس حصے کے لیے امتحان دینے والے کو انعام دیتی ہے جو درست ہو۔ اساتذہ اسے اس لیے استعمال کرتے ہیں کیونکہ یہ جزوی علم کو ناپتی ہے جسے دو-قطبی، صحیح-یا-غلط اسکورنگ ضائع کر دیتی ہے، اور اچھی طرح سے ڈیزائن کردہ جزوی کریڈٹ فنکشنز بے ترتیب اندازہ لگانے سے ملنے والے فائدے کو دباتے ہیں۔ یہ کثیر حصوں والے سوالات، متعدد جواب والے سوالات، اور رُبرک کے خلاف درجہ بند تعمیری جوابات پر سب سے بہتر فٹ بیٹھتی ہے، خاص طور پر جب آپ کو ایک سادہ پاس/فیل اسکور سے زیادہ باریک تشخیصی معلومات کی ضرورت ہو۔
خلاصہ:
- جزوی کریڈٹ اسکورنگ سادہ صحیح-یا-غلط طریقوں کے مقابلے میں کثیر حصوں، متعدد جواب، اور تعمیری جواب والے سوالات پر طالب علم کے علم کو بہتر طریقے سے ظاہر کرتی ہے۔
- سب سیٹ سلیکشن اور لینئر پینلٹی جیسے طریقے اندازہ لگانے کو قابو میں رکھتے ہیں لیکن واضح ہدایات کی ضرورت ہوتی ہے اور اسکورنگ اور ریٹر ٹریننگ میں پیچیدگی پیدا کر سکتے ہیں۔
- تجرباتی تحقیق سے پتہ چلتا ہے کہ جزوی کریڈٹ وشوسنییتا اور امتیاز کو بہتر بناتی ہے، خاص طور پر بڑے پیمانے پر یا ایسے متعدد جواب والے سوالات پر جہاں اندازہ لگانے کا امکان زیادہ ہو۔
- زیادہ تر کلاس روم کے جائزوں کو Rasch partial credit جیسے جدید ماڈلز کی ضرورت نہیں ہوتی، جو بڑے پیمانے پر ٹیسٹنگ پروگراموں اور سرٹیفیکیشن امتحانات کے لیے مخصوص ہیں۔
- ایسے مخصوص ٹولز کا استعمال جو رُبرک کے اطلاق، ریٹر کی مستقل مزاجی، اور اسکورنگ کی شفافیت کو خودکار بناتے ہیں، نفاذ کو آسان بناتا ہے اور منصفانہ، مستقل جزوی کریڈٹ تشخیص کو یقینی بناتا ہے۔
فہرست مضامین
- جزوی کریڈٹ اسکورنگ کا مطلب اور اسے کب استعمال کرنا ہے
- جزوی کریڈٹ اسکورنگ کے عام طریقے
- جزوی کریڈٹ کا حساب کیسے لگائیں: کام کیے گئے مثالیں
- شماریاتی ماڈلز اور IRT: Rasch Partial Credit Model
- نفاذ کے بہترین طریقے: ڈیزائن، ترتیب، اور رپورٹنگ
- وشوسنییتا، درستگی، اور اندازہ لگانے کا دباؤ
- متعدد جواب والے سوالات کے لیے اسکورنگ ٹیمپلیٹس
- پیمانے پر جانے سے پہلے پریکٹیشنر گورننس چیک لسٹ
- جب جزوی کریڈٹ اپنی پیچیدگی کا جواز پیش کرے
- بنیادی ڈھانچہ خود بنائے بغیر جزوی کریڈٹ جائزے بنائیں
- ماخذ
- اکثر پوچھے گئے سوالات
جزوی کریڈٹ اسکورنگ کا مطلب اور اسے کب استعمال کرنا ہے
دو-قطبی اسکورنگ کسی جواب کو یا تو مکمل طور پر صحیح یا مکمل طور پر غلط سمجھتی ہے، یعنی ایک پوائنٹ یا صفر۔ جزوی کریڈٹ اسکورنگ اس دو رنگی سوچ کو توڑتی ہے۔ وہ طالب علم جو متعدد جواب والے سوال پر چار درست اختیارات میں سے تین منتخب کرتا ہے، یا جو کثیر مرحلوں والے مسئلے کی ترتیب تو درست کرتا ہے لیکن آخری حساب میں غلطی کرتا ہے، اسے اس کے مطابق کریڈٹ ملتا ہے جو اس نے واقعی ظاہر کیا۔
جزوی کریڈٹ کی دلیل تین عملی نتائج پر قائم ہے۔ پہلا، یہ جزوی علم کو ظاہر کرتی ہے جسے سخت صحیح/غلط قانون مٹا دیتا ہے، جو ان سوالات پر سب سے زیادہ اہمیت رکھتا ہے جن کے کئی قابل دفاع ذیلی جوابات ہوں۔ دوسرا، درست طریقے سے بنائے گئے اسکورنگ فنکشنز بے ترتیب اندازے کی متوقع قدر کو منفی بنا سکتے ہیں، تاکہ اندازہ لگانا ایک عقلی حکمت عملی نہ رہے، یہ اثر اسکورنگ فنکشن تحقیق میں باضابطہ طور پر ماڈل کیا گیا ہے۔ تیسرا، متعدد جواب والے سوالات پر تجرباتی موازنوں میں پایا گیا کہ جزوی کریڈٹ طریقوں نے دو-قطبی اسکورنگ کے مقابلے میں وشوسنییتا اور سوال کی امتیازی صلاحیت دونوں کو بہتر بنایا۔
آپ کو ہر جگہ جزوی کریڈٹ کی ضرورت نہیں ہے۔ ایک واحد درست جوابات والا الفاظ کا کوئز اس سے کوئی فائدہ نہیں اٹھاتا اور صرف اسکورنگ کی پیچیدگی بڑھاتا ہے۔ جزوی کریڈٹ کا استعمال تب کریں جب سوالات واقعی کثیر حصوں پر مشتمل ہوں، جب متعدد جواب والے سوالوں میں دو سے زیادہ قابل قبول انتخاب ہوں، یا جب ایک تعمیری جواب کو الگ، درجہ بند اجزاء والے رُبرک میں توڑا جا سکے۔
جزوی کریڈٹ اسکورنگ کے عام طریقے
کوئی ایک فارمولا ہر تناظر میں کامیاب نہیں ہوتا۔ اس شعبے کے کلاسیکی جائزے مختلف طریقوں کی فہرست دیتے ہیں اور مستقل طور پر کسی ایک عالمی فاتح کے بجائے تجارتی توازن پاتے ہیں، اس لیے درست انتخاب سوال کی شکل اور اس بات پر منحصر ہے کہ آپ کس چیز سے بچنا چاہتے ہیں، چاہے وہ اندازہ لگانا ہو، ریٹر کی عدم مستقل مزاجی ہو، یا خود اسکورنگ کی پیچیدگی ہو۔
- متناسب (صحیح تعداد) اسکورنگ۔ پوائنٹس کل ممکنہ انتخابات میں سے درست انتخابات کے تناسب کے برابر ہوتے ہیں۔ حساب لگانا آسان، طلباء کو سمجھانا آسان، لیکن متعدد جواب والے سوالات پر گیمنگ کا شکار ہو سکتی ہے جہاں سب کچھ منتخب کرنا بیس لائن اسکور کی ضمانت دیتا ہے۔
- سب سیٹ سلیکشن (SS) اسکورنگ۔ مکمل کریڈٹ صرف تب جب بالکل درست سب سیٹ منتخب ہو؛ ان سب سیٹس کے لیے جزوی کریڈٹ دیا جاتا ہے جو کلید کے مناسب میل کھاتے ہوں، اور شامل خلفشار کے لیے جرمانہ ہوتا ہے۔ خالص متناسب اسکورنگ سے بہتر اندازہ لگانے پر قابو، لیکن سمجھانے کے لیے قدرے زیادہ پیچیدہ قانون کی قیمت پر۔
- ترمیم شدہ Zapechelnyuk طرز کے فنکشنز۔ یہ ریاضیاتی طور پر اخذ کردہ جرمانے کی ساخت استعمال کرتے ہیں جو اس طرح ڈیزائن کی جاتی ہے کہ اندھا اندازہ لگانے کی متوقع قدر منفی ہو جائے، اندازہ لگانے کے مسئلے کو صرف برداشت کرنے کے بجائے براہ راست حل کرتی ہے۔
- لینئر پینلٹی ماڈلز۔ اسکور درست انتخابات کی تعداد سے غلط انتخابات کی وزنی تعداد منہا کرنے کے برابر ہوتا ہے۔ جرمانے کے وزن کو ایڈجسٹ کر کے قابل ترتیب، جو آپ کو یہ کیلیبریٹ کرنے دیتا ہے کہ آپ ضرورت سے زیادہ انتخاب کو کتنی جارحانہ طور پر روکنا چاہتے ہیں۔
- رُبرک پر مبنی تقسیم۔ تعمیری جوابات کو ایک ترتیب شدہ رُبرک (مثلاً 0 سے 4) کے خلاف اسکور کیا جاتا ہے، پھر کل سوال کے پوائنٹس کے ایک حصے میں تبدیل کیا جاتا ہے۔ یہ مضامین، کثیر مرحلوں والے ریاضی کے مسائل، اور لیب رپورٹس کے لیے معیاری طریقہ ہے۔
متناسب اسکورنگ ان متعدد انتخاب اور کثیر خانہ والے سوالات کے لیے موزوں ہے جہاں شکل سیدھی ہو اور اندازہ لگانے کا خطرہ کم ہو۔ سب سیٹ سلیکشن اور لینئر پینلٹی ماڈلز ان متعدد جواب والے سوالات کے لیے موزوں ہیں جہاں خلفشار اتنے پرکشش ہوں کہ بے ترتیب انتخاب اسکور کو بڑھا سکے۔ رُبرک پر مبنی تقسیم کھلے تعمیری جوابات کے لیے واقعی واحد درست اختیار ہے، کیونکہ تقسیم کرنے کے لیے کوئی الگ "صحیح تعداد" نہیں ہوتی۔
تبادلے کا نمونہ طریقوں میں یکساں ہے: آسان فارمولے (متناسب اسکورنگ) طلباء اور اساتذہ کے لیے سمجھنا سب سے آسان ہیں لیکن اندازہ لگانے کے خلاف سب سے کمزور ہیں، جبکہ پینلٹی پر مبنی اور سب سیٹ طریقے اندازہ لگانے کو بہتر طور پر قابو کرتے ہیں لیکن واضح ہدایات کی مانگ کرتے ہیں تاکہ طلباء سمجھ سکیں کہ انتخابات کو کس طرح تولا جاتا ہے۔ رُبرک پر مبنی اسکورنگ ایک بالکل مختلف خطرہ رکھتی ہے: ریٹر کی عدم مستقل مزاجی، جسے کوئی فارمولا خود سے ٹھیک نہیں کر سکتا۔
جزوی کریڈٹ کا حساب کیسے لگائیں: کام کیے گئے مثالیں
اوپر دیے گئے فارمولے اس وقت تک بے فائدہ ہیں جب تک آپ خود اعداد و شمار نہ چلا سکیں۔ یہاں تین کام کیے گئے مثالیں ہیں جنہیں آپ براہ راست اسپریڈشیٹ میں منتقل کر سکتے ہیں۔
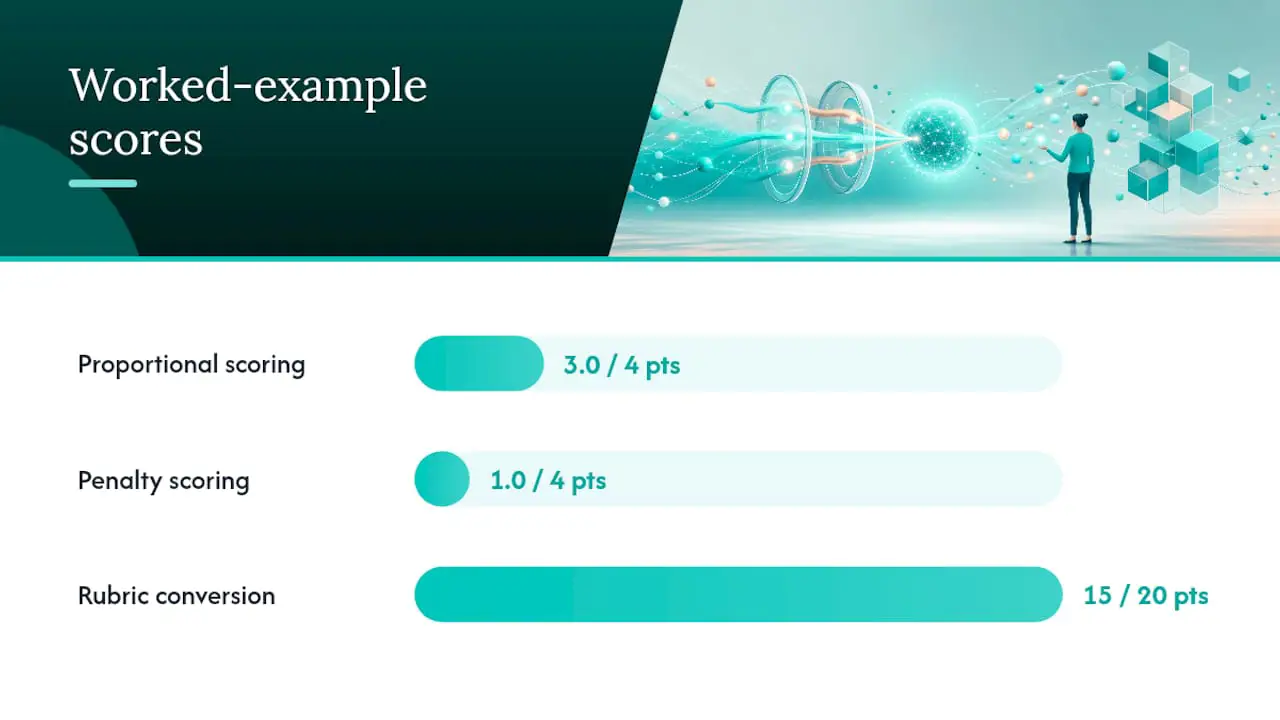
1. چار اختیاری متعدد انتخاب سوال پر متناسب اسکورنگ۔
فرض کریں کہ ایک سوال میں چھ کل اختیارات میں سے چار درست اختیارات ہیں، جو 4 پوائنٹس کے قابل ہیں۔ ایک طالب علم چار میں سے 3 درست اختیارات اور 0 خلفشار منتخب کرتا ہے۔
اسکور = (درست انتخابات / کل درست اختیارات) × سوال کے پوائنٹس اسکور = (3 / 4) × 4 = 3.0 پوائنٹس
2. خلفشار جرمانے کے ساتھ سب سیٹ سلیکشن۔
وہی سوال: 4 درست اختیارات، 2 خلفشار، کل 4 پوائنٹس۔ اس بار طالب علم 3 درست اختیارات اور 1 خلفشار منتخب کرتا ہے۔
اسکور = [(منتخب کردہ درست / کل درست) − (منتخب کردہ خلفشار / کل خلفشار)] × سوال کے پوائنٹس، صفر سے کم نہیں اسکور = [(3/4) − (1/2)] × 4 = [0.75 − 0.5] × 4 = 1.0 پوائنٹ
اس کا موازنہ صرف متناسب طریقے سے کریں جو خلفشار کو یکسر نظر انداز کر کے ایک جیسے جواب کے لیے 3.0 پوائنٹس دیتا۔ یہ فرق ہی ان سوالات پر پینلٹی پر مبنی طریقوں کی پوری دلیل ہے جہاں خلفشار واقعی لبھانے والے ہوں۔
3. 20 پوائنٹ سوال پر رُبرک سے حصے میں تبدیلی۔
ایک کثیر مرحلوں والے ریاضی کے مسئلے کو 0 سے 4 رُبرک پر درجہ بندی کی جاتی ہے: 0 (کوئی درست طریقہ نہیں)، 1 (صرف درست ترتیب)، 2 (درست طریقہ، بڑی غلطی)، 3 (درست طریقہ، چھوٹی غلطی)، 4 (مکمل طور پر درست)۔ سوال کل 20 پوائنٹس کا ہے۔
کسری اسکور = (حاصل کردہ رُبرک پوائنٹس / زیادہ سے زیادہ رُبرک پوائنٹس) × سوال کے پوائنٹس وہ طالب علم جو رُبرک پر 3 حاصل کرتا ہے وہ پاتا ہے: (3/4) × 20 = 15 پوائنٹس
اسے ایک کلاس روسٹر پر چلائیں اور آپ کو ایک تقسیم ملتی ہے جو ایک سادہ فیصد-درست ہسٹوگرام جیسی نہیں دکھتی: اسکور رُبرک بینڈز (0، 5، 10، 15، 20) کے گرد جمع ہوتے ہیں بجائے مسلسل پھیلنے کے، جو یہ جاننے سے پہلے جاننے کے قابل ہے کہ آپ اس کے گرد گریڈ کرو بنائیں۔
مفید مشورہ: امتحان کی ونڈو کھلنے سے پہلے ان تین فارمولوں کو ایک مشترکہ اسپریڈشیٹ ٹیمپلیٹ میں نامزد فنکشن کے طور پر بنائیں۔ طلباء کے جوابات جمع کرانے کے بعد اسکورنگ فارمولا ٹھیک کرنا وہ جگہ ہے جہاں سے زیادہ تر اسکورنگ تنازعات شروع ہوتے ہیں۔
شماریاتی ماڈلز اور IRT: Rasch Partial Credit Model
کسری اسکورنگ فارمولے اس سوال کا جواب دیتے ہیں کہ "اس جواب نے کتنے پوائنٹس حاصل کیے۔" آئٹم رسپانس تھیوری (IRT) ایک مختلف سوال کا جواب دیتی ہے: "یہ جواب واقعی کتنی صلاحیت کی نشاندہی کرتا ہے، جب ہم یہ حساب لگائیں کہ ہر جواب کی کیٹیگری تک پہنچنا کتنا مشکل ہے۔" یہ فرق اہمیت رکھتا ہے جب آپ ایک کمرہ جماعت کی درجہ بندی سے آگے بڑھ کر کسی ایسے تناظر میں جاتے ہیں جہاں اسکورز کا موازنہ فارمز، گروہوں، یا سالوں میں کرنا ہو۔
Rasch partial credit model، جو Geoff Masters نے تیار کیا، معیاری دو-قطبی Rasch ماڈل کو ترتیب شدہ جواب کیٹیگریز والے سوالات تک بڑھاتا ہے۔ "4 میں سے مرحلہ 2" کو محض "4 میں سے مرحلہ 4" کا آدھا سمجھنے کے بجائے، Rasch PCM ہر دو ملحقہ کیٹیگریز کے درمیان منتقلی کے لیے ایک الگ threshold پیرامیٹر کا تخمینہ لگاتا ہے۔ رُبرک پر 1 سے 2 کی طرف جانے کے لیے 2 سے 3 کی طرف جانے سے کہیں زیادہ ظاہر شدہ صلاحیت کی ضرورت ہو سکتی ہے، اور ماڈل اسے ظاہر کرتا ہے بجائے اس کے کہ یہ فرض کرے کہ ہر قدم برابر ہے۔
عملی فائدہ پیرامیٹر علیحدگی ہے: امتحانی کی تخمینہ شدہ صلاحیت اور سوال کی کیٹیگری حدیں ایک دوسرے سے آزادانہ طور پر تخمینہ لگائی جا سکتی ہیں، جو کراس فارم موازنوں کو شماریاتی طور پر قابل دفاع بناتی ہے۔
اضافی پیچیدگی کب اپنا جواز پیش کرتی ہے؟
- بڑے پیمانے پر ٹیسٹنگ پروگرام، جہاں ہزاروں جوابات کو متعدد امتحان فارمز میں مستقل تشریح کی ضرورت ہو۔
- لنکنگ اور ایکویٹنگ، جب طلباء کے مختلف گروہ ٹیسٹ کے مختلف ورژن لیتے ہیں اور اسکورز کا ہر ایک پر یکساں مطلب ہونا ضروری ہو۔
- درست سوال کیلیبریشن، جب آپ کو یہ جاننا ہو کہ رُبرک پر "2" اور "3" کے درمیان بالکل کتنی صلاحیت کا فرق ہے، بجائے مساوی فاصلے کا فرض کرنے کے۔
- تفریقی سوال کام کرنے کی جانچ، جہاں آپ کو یہ تصدیق کرنی ہو کہ سوال کے جزوی کریڈٹ مراحل مجموعی اسکور پر بھروسہ کرنے سے پہلے آبادیاتی گروہوں میں یکساں طور پر برتاؤ کرتے ہیں۔
ایک کمرہ جماعت کے واحد کوئز کو شاید ہی کبھی Rasch کیلیبریشن کی ضرورت ہو۔ ایک سرٹیفیکیشن امتحان جو قومی سطح پر لیا جاتا ہو، ٹیسٹنگ ونڈوز میں دوبارہ استعمال کیا جاتا ہو، اور جس پر حقیقی نتائج کے ساتھ پاس/فیل فیصلوں کا انحصار ہو، اسے تقریباً ہمیشہ ضرورت ہوتی ہے۔ "اسپریڈشیٹ فارمولا استعمال کریں" اور "IRT سافٹ ویئر استعمال کریں" کے درمیان کی لکیر واقعی داؤ اور پیمانے کے بارے میں ہے، نہ کہ سوال کی شکل کے بارے میں۔
نفاذ کے بہترین طریقے: ڈیزائن، ترتیب، اور رپورٹنگ
جزوی کریڈٹ کو درست کرنا کسی بھی طالب علم کے سوال دیکھنے سے بہت پہلے شروع ہوتا ہے، اور یہ اسکور بنتے وقت ختم نہیں ہوتا۔ تین مراحل جان بوجھ کر توجہ کے مستحق ہیں: ڈیزائن، پلیٹ فارم کی ترتیب، اور رپورٹنگ۔
ڈیزائن چیک لسٹ۔ کوئی بھی سوال لکھنے سے پہلے، اسکورنگ کا قانون طے کریں، پائلٹنگ کے بعد عدم مستقل مزاجی ظاہر ہونے سے پہلے نہیں۔
- رُبرک یا پوائنٹ ایلوکیشن قانون اسی وقت لکھیں جب سوال لکھیں، بعد میں نہیں۔
- یکساں سوالات میں مستقل پوائنٹ اسکیل استعمال کریں تاکہ طلباء اندازہ لگا سکیں کہ جزوی کریڈٹ کیسے تقسیم ہوتا ہے۔
- نئے رُبرکس کو بڑے پیمانے پر نافذ کرنے سے پہلے حقیقی یا مشق کے جوابات کے چھوٹے نمونے پر پائلٹ کریں، اور جہاں دو ریٹرز اختلاف کریں وہاں anchor وضاحتیں ایڈجسٹ کریں۔
- تعمیری جواب رُبرکس کے لیے ہر اسکور بینڈ میں 3 سے 5 anchor جوابات متعین کریں، یہ عمل رُبرک پر مبنی جزوی کریڈٹ اسکورنگ پر تحقیق کی حمایت یافتہ ہے جو قابل قبول inter-rater agreement تک پہنچنے کے لیے ریٹرز کو نمونہ اسکرپٹس کے خلاف تربیت دینے کی سفارش کرتی ہے۔
LMS اور پلیٹ فارم کی ترتیب۔ زیادہ تر لرننگ مینجمنٹ سسٹمز جزوی کریڈٹ کی ترتیبات کو امتحان-سطح کی ترتیبات کے بجائے سوال-سطح کے اختیارات کے اندر چھپاتے ہیں، اس لیے ہر سوال کی قسم کو انفرادی طور پر جانچیں بجائے اس کے کہ فرض کریں کہ ایک عالمی ٹوگل سب کچھ کور کرتا ہے۔ تصدیق کریں کہ طلباء کو دکھائی جانے والی رائے کسری اسکور، رُبرک سطح، یا دونوں ظاہر کرتی ہے، کیونکہ صرف ایک گول کل دکھانا ٹھیک اس جگہ کو چھپا سکتا ہے جہاں پوائنٹس گئے۔ جب بھی ممکن ہو خام، غیر گول اسکورنگ ڈیٹا ایکسپورٹ کریں۔ جلدی گول کرنا اور بعد میں دوبارہ حساب لگانا ایک بڑے روسٹر میں خاموش درجہ بندی کی غلطیاں متعارف کروانے کے تیز ترین طریقوں میں سے ایک ہے۔
رپورٹنگ۔ خام کسری اسکور اور گول کل دونوں رپورٹ کریں، اور جو بھی اسکور رپورٹ طالب علم تک پہنچے اس میں واضح طور پر کہیں۔ جو طالب علم بغیر کسی تناظر کے "15/20" دیکھتا ہے اسے معلوم نہیں ہو سکتا کہ آیا اس نے ایک بڑی غلطی یا کئی چھوٹی غلطیوں کی وجہ سے 5 پوائنٹس کھوئے۔ اسکور رپورٹ کے ساتھ منسلک ایک سطر کی وضاحت کہ جزوی کریڈٹ کیسے حساب لگایا گیا، زیادہ تر تنازعات شروع ہونے سے پہلے حل کر دیتی ہے۔ منظم جائزوں کے لیے اسکورنگ رُبرکس بنانے والی ٹیمیں اضافی رُبرک ڈیزائن رہنمائی اور ٹیمپلیٹس تلاش کر سکتی ہیں جو کسری اسکورنگ طریقوں کے ساتھ براہ راست جوڑی بنتے ہیں۔
وشوسنییتا، درستگی، اور اندازہ لگانے کا دباؤ
وشوسنییتا وہ سوال ہے جو فیصلہ کرتا ہے کہ آیا جزوی کریڈٹ اضافی پیچیدگی کے قابل تھا۔ اگر اسکورنگ کی تبدیلی آپ کے جائزے کی مستقل مزاجی کو قابل پیمائش طور پر بہتر نہیں بناتی، تو اضافی ریٹر ٹریننگ اور حساب کتاب کا اضافی بوجھ جواز پیش کرنا مشکل ہے۔
تجرباتی ریکارڈ یہاں موافق ہے۔ متعدد جواب والے سوالات پر اسکورنگ طریقوں کے تقابلی مطالعوں میں پایا گیا کہ جزوی کریڈٹ طریقوں نے سادہ دو-قطبی اسکورنگ کے مقابلے میں وشوسنییتا اور امتیاز دونوں کو بہتر بنایا، خاص طور پر دو سے زیادہ جواب اختیارات والے سوالات کے لیے جہاں صحیح/غلط تقسیم بامعنی تغیر کو ضائع کر دیتی ہے۔ علیحدہ طور پر، منفی متوقع اندازہ قدر کے گرد ڈیزائن کیے گئے اسکورنگ فنکشنز پر نظریاتی کام میں پایا گیا کہ یہ فنکشنز سادہ صحیح-یا-غلط اسکورنگ کے مقابلے میں وشوسنییتا اور امتیازی طاقت دونوں کو بہتر بناتے ہیں، خاص طور پر جب اندازہ لگانے کا جرمانہ شامل کیا جائے۔
تین عملی جانچیں آپ کو بتاتی ہیں کہ آپ کے اپنے ڈیٹا میں تبدیلی فائدہ دے رہی ہے یا نہیں:
سوال-کل ارتباط۔ جزوی کریڈٹ پر سوئچ کرنے کے بعد اسے دوبارہ حساب لگائیں۔ جس سوال کا کل اسکور کے ساتھ ارتباط بہتر ہوتا ہے وہ نئے اسکورنگ قانون کے تحت مضبوط کارکردگی کرنے والوں کو کمزوروں سے الگ کرنے کا بہتر کام کر رہا ہے۔
پہلے اور بعد میں Cronbach کا alpha۔ ایک ہی ٹیسٹ ڈیٹاسیٹ کو دونوں اسکورنگ قوانین سے گزاریں اور alpha قدروں کا براہ راست موازنہ کریں۔ ایک معنی خیز اضافہ ایک مضبوط اشارہ ہے کہ جزوی کریڈٹ نے وہ معلومات حاصل کیں جو دو-قطبی ورژن نے ضائع کر دی تھیں۔
IRT fit statistics، جہاں Rasch یا دیگر IRT ماڈل پہلے سے زیر استعمال ہو۔ Category thresholds جو بے ترتیب نکلیں، یعنی زیادہ رُبرک اسکور زیادہ تخمینہ شدہ صلاحیت کے مطابق نہ ہو، ایک ایسے رُبرک کی نشاندہی کرتے ہیں جسے ترمیم کی ضرورت ہے چاہے خام وشوسنییتا کے اعداد و شمار کچھ بھی کہیں۔
یہ سب مفت نہیں آتا۔ ہر اضافے گئے فارمولے کی تبدیلی کے ساتھ اسکورنگ کی پیچیدگی بڑھتی ہے، ریٹر کی تغیر پذیری ایک اہم مسئلہ بن جاتی ہے جیسے ہی آپ کوئی بھی رُبرک پر مبنی جزء شامل کرتے ہیں، اور انتظامی لاگت بڑھتی ہے جب آپ کو ایک سادہ جواب کلید سے آگے سافٹ ویئر یا اسپریڈشیٹ بنیادی ڈھانچے کی ضرورت ہو۔ ان لاگتوں کا اپنے اصل داؤ کے خلاف وزن کریں۔ ایک ہفتہ وار کوئز شاذ و نادر ہی اس بوجھ کا جواز پیش کرتا ہے؛ ایک سرٹیفیکیشن امتحان تقریباً ہمیشہ کرتا ہے۔
متعدد جواب والے سوالات کے لیے اسکورنگ ٹیمپلیٹس
متعدد جواب والے سوالات، جہاں ایک طالب علم ایک لمبی فہرست سے کئی اختیارات منتخب کرتا ہے، وہ ہیں جہاں اندازہ لگانا ٹیسٹ کی درستگی کو سب سے زیادہ نقصان پہنچاتا ہے۔ وہ طالب علم جو "تمام صحیح جوابات منتخب کریں" والے سوال پر ہر اختیار منتخب کرتا ہے جس میں چھ اختیارات میں سے چار درست جوابات ہیں، وہ بے سوچے سمجھے متناسب اسکورنگ کے تحت ہمیشہ جزوی کریڈٹ حاصل کرے گا، چاہے وہ کچھ بھی جانتا ہو یا نہیں۔
اصلاح متوقع قدر کے گرد بنایا گیا اسکورنگ ٹیمپلیٹ ہے۔ ایک عام ڈھانچہ: p1 پوائنٹس دیں جب طالب علم بالکل key منتخب کرے (مکمل درست سیٹ) یا بعض فارمولیشنز میں جب ہر خلفشار کو درست طور پر خارج کیا جائے؛ ورنہ ایک pc − m فارمولا لگائیں، جہاں pc درست تناسب ہے اور m ایک جرمانہ ہے جو key سے باہر انتخابات کے مطابق scaled ہے۔ ہدف، جیسا کہ باضابطہ اسکورنگ فنکشن تحقیق بیان کرتی ہے، یہ یقینی بنانا ہے کہ ریاضی خود لاپروائی سے زیادہ انتخاب کی حوصلہ شکنی کرے۔
- جرمانے (m) کا سائز اس طرح رکھیں کہ ہر اختیار منتخب کرنے یا بے ترتیب منتخب کرنے کی متوقع قدر منفی یا زیادہ سے زیادہ صفر نکلے۔
- سوال نافذ کرنے سے پہلے اپنے جرمانے کو "سب کچھ منتخب کریں" جواب کے خلاف جانچیں۔ اگر وہ جواب صفر سے اوپر اسکور کرتا ہے، تو جرمانہ بہت چھوٹا ہے۔
- اسے ایک سچے جزوی علم کے جواب کے خلاف بھی جانچیں۔ اگر ایک طالب علم 4 میں سے 3 درست اختیارات صحیح طور پر پہچانتا ہے، اور دونوں خلفشاروں کو رد کر دیتا ہے، لیکن اس سے بدتر اسکور کرتا ہے جس نے کھل کر اندازہ لگایا، تو جرمانہ بہت بڑا ہے۔
سوال کا الفاظ کے پیچھے فارمولے جتنا اہم ہے۔ ہدایات جو "تمام درست جوابات منتخب کریں" پڑھتی ہیں اور جرمانوں پر کوئی رہنمائی نہیں دیتیں، طلباء کو اندازہ لگانے پر مجبور کرتی ہیں، کیونکہ الفاظ میں خود کوئی منفی اشارہ نہیں ہوتا۔ ایک مختصر سطر شامل کریں جس میں لکھا ہو کہ غلط انتخابات اسکور کم کرتے ہیں، اور آپ کو زیادہ ایمانداری سے جزوی علم کی رپورٹنگ ملتی ہے، کیونکہ طلباء کو اب ان اختیارات کو منتخب کرنے کی کوئی ترغیب نہیں رہتی جن کے بارے میں وہ غیر یقینی ہوں صرف حفاظت کے لیے۔
پیمانے پر جانے سے پہلے پریکٹیشنر گورننس چیک لسٹ
پائلٹ گروپ سے آگے جزوی کریڈٹ نافذ کرنے سے پہلے، یہ چار جانچیں کریں:
- رُبرک وضاحت۔ تصدیق کریں کہ ہر رُبرک سطح کی ایک الگ، مشاہدہ کی جا سکنے والی anchor وضاحت ہو، نہ کہ صرف ایک مبہم لیبل جیسے "زیادہ تر درست۔"
- Inter-rater وشوسنییتا۔ دو ریٹرز سے ایک ہی 20 سے 30 نمونہ جوابات کو آزادانہ طور پر اسکور کروائیں اور پیمانے پر ایک ریٹر کے اسکورز پر بھروسہ کرنے سے پہلے اتفاق جانچیں۔
- پائلٹ موازنہ۔ ایک ہی جواب سیٹ کو پرانے اسکورنگ قانون اور نئے جزوی کریڈٹ قانون دونوں کے تحت اسکور کریں، اور وشوسنییتا اور گریڈ کی تقسیم کا موازنہ ساتھ رکھ کر کریں۔
- حساسیت تجزیہ۔ اپنے جرمانے کے وزن یا پوائنٹ مختصات کو تھوڑا سا ہٹائیں اور تجزیہ دوبارہ چلائیں۔ اسکورنگ ماڈل رہنمائی اس قدم کی سفارش کرتی ہے کیونکہ چھوٹی وزن کی تبدیلیاں وشوسنییتا کے نتائج کو پلٹ سکتی ہیں یا امیدوار کی درجہ بندی کو مکمل طور پر تبدیل کر سکتی ہیں۔
ہر اسکورنگ فیصلے کو دستاویز کریں، بشمول کہ ایک خاص فارمولا یا جرمانے کا سائز کیوں چنا گیا، ایک ایسی شکل میں جسے اسٹیک ہولڈرز بعد میں جائزہ لے سکیں۔ وہ ریکارڈ ہی ایک قابل دفاع پائلٹ کو ایک قابل دفاع پالیسی میں تبدیل کرتا ہے۔
جب جزوی کریڈٹ اپنی پیچیدگی کا جواز پیش کرے
جزوی کریڈٹ ایک حقیقی انتظامی قیمت ٹیگ کے ساتھ ایک پیمائش کا اپ گریڈ ہے، اور اس کے برعکس دعوی کرنا کسی بھی ایسے شخص کے ساتھ برا سلوک ہے جو اسے پہلی بار پائلٹ کر رہا ہو۔ وشوسنییتا اور امتیاز میں فائدہ اچھی طرح دستاویز کیا گیا ہے، لیکن اضافی بوجھ بھی: زیادہ ریٹر ٹریننگ، زیادہ پیچیدہ فارمولے، کسی مخصوص سوال پر "جزوی" کا کیا مطلب ہے اس بارے میں اختلاف کی زیادہ گنجائش۔
تحقیق پر میری ایمانداری سے رائے یہ ہے کہ زیادہ تر کمرہ جماعت کی سطح کے جائزوں کو Rasch کیلیبریشن، سب سیٹ سلیکشن جرمانوں، یا اوپر بیان کردہ زیادہ پیچیدہ مشینری میں سے کسی کی ضرورت نہیں ہوتی۔ ایک واضح رُبرک اور متناسب تقسیم زیادہ تر حقیقی کمرہ جماعت کی ضروریات کو پورا کرتی ہے۔ جہاں جزوی کریڈٹ اپنی پیچیدگی کا جواز پیش کرتا ہے وہ پیمانے پر ہے: سرٹیفیکیشن امتحانات، کثیر فارم ٹیسٹنگ پروگرام، اور کوئی بھی جائزہ جہاں غلط اسکورنگ کا مفروضہ تیس طالب علموں کے بجائے ہزاروں امتحانی دینے والوں میں گھومتا ہے۔
آپریشنل بوجھ بالکل وہ جگہ ہے جہاں اچھا پلیٹ فارم ٹولنگ حساب کتاب کو تبدیل کرتا ہے، خاص طور پر اگر آپ عالمی بھرتی کو خودکار بنانا اور تعمیل کے خطرات کو کم کرنا چاہتے ہیں۔ ایک ایسا ٹول جو رُبرک کے اطلاق کو خودکار بناتا ہے، ریٹر کی مستقل مزاجی کو ٹریک کرتا ہے، اور اسکورنگ فیصلوں کو لاگ کرتا ہے، زیادہ تر وہ رگڑ دور کر دیتا ہے جو اساتذہ کو جزوی کریڈٹ کو بالکل پائلٹ کرنے سے روکتی ہے۔ پہلے پائلٹ کریں، اضافی لاگت کے خلاف وشوسنییتا کا فائدہ ناپیں، اور صرف اس وقت پیمانے پر جائیں جب اعداد و شمار اسے واقعی جائز ثابت کریں۔
— Jimmie
بنیادی ڈھانچہ خود بنائے بغیر جزوی کریڈٹ جائزے بنائیں
جزوی کریڈٹ اسکورنگ میں زیادہ تر رگڑ ریاضی نہیں ہے۔ یہ بنیادی ڈھانچہ ہے: مستقل رُبرکس لکھنا، ریٹرز کو ہم آہنگ رکھنا، اور اعتماد کہ کسی نے ٹیسٹ کے ساتھ چھیڑ چھاڑ نہیں کی۔ Talent Approved ایک pay-as-you-go ماڈل کے گرد بنایا گیا ہے جس میں کوئی سبسکرپشن نہیں، اس لیے آپ صرف مکمل امیدوار جائزے کے مطابق ادائیگی کرتے ہیں، اور اسکورنگ سافٹ ویئر لائسنس کا بوجھ چھوڑ دیتے ہیں جس کی آپ کو صرف کبھی کبھی ضرورت ہو سکتی ہے۔
پلیٹ فارم کی Magic Create خصوصیت ایک ملازمت کی تفصیل یا مہارت کی فہرست سے براہ راست کردار کے مطابق، رُبرک کے لیے تیار جائزہ بناتی ہے، جو دستی سوال لکھنے کے مرحلے کو مکمل طور پر ختم کر دیتی ہے۔ بلٹ ان anti-cheat ٹولز، جن میں سیشن ریپلے کے ساتھ اسکرین اور ویب کیم مانیٹرنگ شامل ہے، جزوی کریڈٹ نتائج کی سالمیت کی اسی طرح حفاظت کرتے ہیں جیسے ریٹر ٹریننگ تعمیری جواب رُبرک کی حفاظت کرتی ہے۔ AI سے تیار کردہ کارکردگی کے خلاصے کسری اسکورز کو پڑھنے کے قابل امیدوار درجہ بندی میں تبدیل کرتے ہیں بغیر آپ کی ٹیم کو خام رُبرک ریاضی کی تشریح کرنے پر مجبور کیے۔
اگر آپ طلباء کو درجہ بندی دینے کے بجائے مہارتوں کا جائزہ لے رہے ہیں، اور اسکورنگ بنیادی ڈھانچے کا مالک بنے بغیر جزوی کریڈٹ طرز کی اسکورنگ چاہتے ہیں، تو Skill assessments قیمت کا صفحہ چیک کریں اور دیکھیں کہ آپ کے اگلے بھرتی کے دور کے لیے پائلٹ جائزہ کتنا خرچ ہوگا۔
ماخذ
- جزوی کریڈٹ فراہم کرنے والے متعدد جواب سوالات کے لیے مختلف اسکورنگ طریقوں کا جائزہ
- کثیر انتخابی ٹیسٹ سوال کی جزوی کریڈٹ اسکورنگ کا نظریاتی جائزہ
- کثیر انتخابی ٹیسٹوں کے لیے جزوی کریڈٹ اسکورنگ طریقے - ERIC
اکثر پوچھے گئے سوالات
جزوی کریڈٹ کا حساب کیسے لگائیں؟
حاصل کردہ پوائنٹس (درست انتخابات، رُبرک سطح، یا سب سیٹ میل) کو اس سوال کے لیے زیادہ سے زیادہ ممکنہ پوائنٹس سے تقسیم کریں، پھر سوال کی کل پوائنٹ ویلیو سے ضرب دیں۔ سب سیٹ سلیکشن اور لینئر پینلٹی طریقے اس آخری ضرب سے پہلے غلط انتخابات کے لیے ایک وزنی جرمانہ منہا کرتے ہیں۔
کریڈٹ اسکورنگ کے تین اہم طریقے کیا ہیں؟
جائزے کے ڈیزائن میں، تین وسیع طریقے ہیں: دو-قطبی (صحیح/غلط) اسکورنگ، جزوی کریڈٹ اسکورنگ (متناسب، سب سیٹ سلیکشن، یا پینلٹی پر مبنی فارمولے)، اور تعمیری جوابات کے لیے رُبرک پر مبنی کسری اسکورنگ۔ ہر ایک مختلف سوال کی شکلوں کے لیے موزوں ہے، اور کوئی ایک طریقہ ہر تناظر میں بہتر نہیں ہے۔
جزوی کریڈٹ اسکورنگ سسٹم کو سب سے زیادہ کیا کمزور کرتا ہے؟
غیر واضح رُبرک anchors اور غیر مستقل ریٹر ٹریننگ سب سے عام ناکامی کے مقامات ہیں، کیونکہ یہ اسکورر کے درمیان اختلاف پیدا کرتے ہیں جسے کوئی فارمولا بعد میں درست نہیں کر سکتا۔ اس کے بعد دوسرا سب سے بڑا مسئلہ بہت چھوٹا جرمانے کی اصطلاح ہے، جو بے ترتیب اندازہ لگانے کو شماریاتی طور پر منافع بخش بنائے رکھتی ہے بجائے دبائے۔
کیا جزوی کریڈٹ واقعی ٹیسٹ کی وشوسنییتا بہتر بناتی ہے؟
متعدد جواب والے سوالات پر تجرباتی موازنوں میں پایا گیا کہ جزوی کریڈٹ اسکورنگ نے دو-قطبی اسکورنگ کے مقابلے میں وشوسنییتا اور امتیاز دونوں کو بہتر بنایا، خاص طور پر جب اسکورنگ فنکشن غلط انتخابات کو جرمانہ دیتا ہو۔ فائدہ خودکار نہیں ہے۔ یہ رُبرک کی وضاحت اور جرمانے کے سائز پر منحصر ہے۔
کیا کوئی پلیٹ فارم مہارت کے جائزوں کے لیے جزوی کریڈٹ اسکورنگ سنبھال سکتا ہے؟
ہاں۔ Talent Approved اپنے Magic Create assessment builder اور anti-cheat مانیٹرنگ کے ساتھ رُبرک پر مبنی اسکورنگ کو سپورٹ کرتا ہے، جو بھرتی کرنے والی ٹیموں کو حساب کا بنیادی ڈھانچہ خود بنائے بغیر کسری اسکورنگ منطق لاگو کرنے دیتا ہے۔ موجودہ قیمتیں Skill assessments صفحے پر درج ہیں۔