
3 Regnearkformler for Delvis Kredittvurdering og Rasch
Delvis poenggivning tildeler poeng langs et spekter i stedet for et alt-eller-ingenting-resultat, og belønner en kandidat for den delen av svaret som er korrekt. Lærere bruker det fordi det måler delvis kunnskap som dikotom, rett-eller-galt-scoring kaster bort, og velutformede funksjoner for delvis poenggivning undertrykker gevinsten fra tilfeldig gjetting. Det passer best på flerdelte oppgaver, spørsmål med flere svaralternativer og konstruerte svar som vurderes mot en rubrikk, særlig når du trenger mer detaljert diagnostisk informasjon enn en enkel bestått/ikke bestått-karakter kan gi deg.
TL;DR:
- Delvis poenggivning fanger opp studentkunnskap på flerdelte oppgaver, spørsmål med flere svaralternativer og konstruerte svar bedre enn enkle rett-eller-galt-metoder.
- Metoder som delmengdevalg og lineær straff kontrollerer gjetting, men krever tydelige instruksjoner og kan innføre kompleksitet i poenggivning og opplæring av sensorer.
- Empirisk forskning viser at delvis poenggivning forbedrer pålitelighet og diskriminering, særlig i stor skala eller ved spørsmål med flere svaralternativer der gjetting er vanlig.
- De fleste klasseromsvurderinger trenger ikke avanserte modeller som Rasch delvis poenggivning, som er forbeholdt storskala testprogrammer og sertifiseringseksamener.
- Bruk av dedikerte verktøy som automatiserer rubrikkanvendelse, sensorkonsistens og transparens i poenggivning forenkler implementeringen og sikrer rettferdig, konsekvent evaluering med delvis poenggivning.
Innholdsfortegnelse
- Hva delvis poenggivning betyr og når du bør bruke det
- Vanlige metoder for delvis poenggivning
- Slik beregner du delvis poenggivning: gjennomarbeidede eksempler
- Statistiske modeller og IRT: Rasch-modellen for delvis poenggivning
- Beste praksis for implementering: design, konfigurasjon og rapportering
- Pålitelighet, validitet og undertrykkelse av gjetting
- Poenggivningsmaler for oppgaver med flere svaralternativer
- Styringssjekkliste for praktikere før du skalerer
- Når delvis poenggivning rettferdiggjør sin kompleksitet
- Bygg vurderinger med delvis poenggivning uten å bygge infrastrukturen selv
- Kilder
- FAQ
Hva delvis poenggivning betyr og når du bør bruke det
Dikotom poenggivning behandler et svar som enten helt riktig eller helt feil, verdt ett poeng eller null. Delvis poenggivning bryter opp denne binære modellen. En student som velger tre av fire riktige alternativer på et spørsmål med flere svaralternativer, eller som mestrer oppsettet av et flerstegs problem men tabber seg på den endelige beregningen, får poeng proporsjonalt med hva de faktisk har demonstrert.
Argumentet for delvis poenggivning hviler på tre praktiske utfall. For det første fanger det opp delvis kunnskap som en streng rett/galt-regel visker ut, noe som betyr mest på oppgaver med flere forsvarlige delsvar. For det andre kan riktig utformede poenggivningsfunksjoner gjøre forventet verdi av tilfeldig gjetting negativ, slik at gjetting slutter å være en rasjonell strategi – en effekt som er formelt modellert i forskning på poenggivningsfunksjoner. For det tredje fant empiriske sammenligninger på spørsmål med flere svaralternativer at metoder med delvis poenggivning forbedret både pålitelighet og oppgavediskriminering sammenlignet med dikotom poenggivning.
Du trenger ikke delvis poenggivning overalt. En glosekontroll med enkle riktige svar har ingen nytte av det og tilfører bare kompleksitet i poenggivningen. Bruk delvis poenggivning når oppgaver er genuint flerdelte, når spørsmål med flere svaralternativer har mer enn to plausible valg, eller når et konstruert svar kan brytes ned i en rubrikk med distinkte, gradérbare komponenter.
Vanlige metoder for delvis poenggivning
Ingen enkelt formel vinner i alle sammenhenger. Klassiske gjennomganger av feltet katalogiserer en rekke metoder og finner konsekvent avveininger snarere enn en universell vinner, så det rette valget avhenger av oppgaveformat og hva du forsøker å beskytte mot – enten det er gjetting, inkonsistens blant sensorer eller selve kompleksiteten i poenggivningen.
- Proporsjonal (antall-riktige) poenggivning. Poeng tilsvarer andelen av riktige valg av totalt mulige valg. Enkel å beregne, lett å forklare til studenter, men sårbar for taktisk spill på spørsmål med flere svaralternativer der det å velge alt garanterer en grunnpoengsum.
- Delmengdevalg (SS) poenggivning. Full poengsum kun når den eksakt riktige delmengden er valgt; delvis poengsum tildeles for delmengder som er delvise treff på fasiten, med straff for inkluderte distraktorer. Bedre kontroll av gjetting enn ren proporsjonal poenggivning, til prisen av en noe mer kompleks regel å forklare.
- Modifiserte Zapechelnyuk-lignende funksjoner. Disse bruker en matematisk utledet straffestruktur designet slik at forventet verdi av blind gjetting blir negativ, og adresserer gjettingsproblemet direkte i stedet for bare å tolerere det.
- Lineære straffemodeller. Poengsum tilsvarer antall riktige valg minus et vektet antall feilaktige valg. Kan justeres ved å endre straffevekten, noe som lar deg kalibrere hvor aggressivt du ønsker å motvirke overvalg.
- Rubrikk-basert fraksjonering. Konstruerte svar vurderes mot en ordnet rubrikk (for eksempel 0 til 4) og konverteres deretter til en brøkdel av totale oppgavepoeng. Dette er standardtilnærmingen for essays, matematikkproblemer med flere steg og labrapporter.
Proporsjonal poenggivning passer for spørsmål med flervalg og flerfelts-oppgaver der formatet er enkelt og risikoen for gjetting er lav. Delmengdevalg og lineære straffemodeller passer for spørsmål med flere svaralternativer der distraktorene er attraktive nok til at tilfeldig valg kan blåse opp poengsum. Rubrikk-basert fraksjonering er egentlig det eneste fornuftige alternativet for åpne konstruerte svar, siden det ikke finnes et diskret «antall riktige» å dele på.
Avveiningsmønsteret er konsekvent på tvers av metoder: enklere formler (proporsjonal poenggivning) er lettest for studenter og lærere å forstå, men svakest mot gjetting, mens straff-baserte og delmengdemetoder kontrollerer gjetting bedre, men krever tydeligere instruksjoner slik at studentene forstår hvordan valg vektes. Rubrikk-basert poenggivning bærer en helt annen risiko: inkonsistens blant sensorer, som ingen formel kan fikse alene.
Slik beregner du delvis poenggivning: gjennomarbeidede eksempler
Formlene ovenfor er ubrukelige til du kan kjøre tallene selv. Her er tre gjennomarbeidede eksempler du kan overføre direkte til et regneark.
1. Proporsjonal poenggivning på en oppgave med flervalg og fire alternativer.
Anta at en oppgave har fire riktige alternativer av seks totale valg, verdt 4 poeng. En student velger 3 av de 4 riktige alternativene og 0 distraktorer.
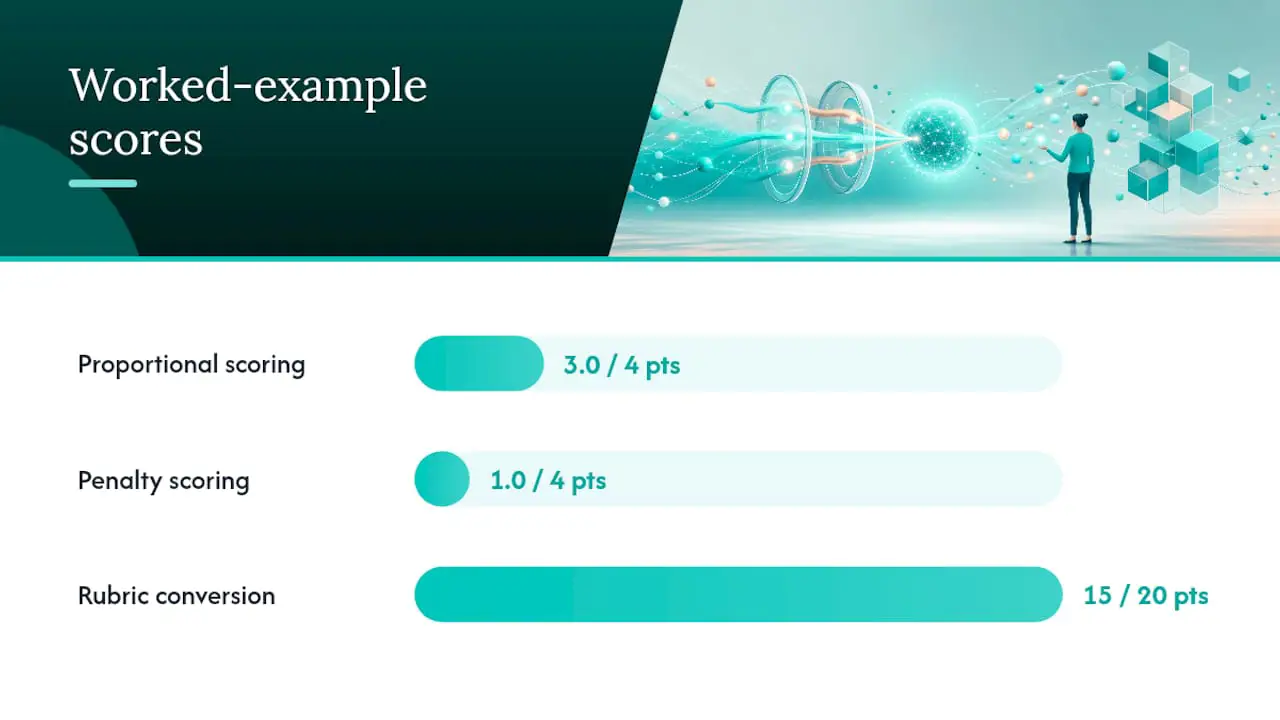
Poengsum = (riktige valg / totalt antall riktige alternativer) × oppgavepoeng Poengsum = (3 / 4) × 4 = 3,0 poeng
2. Delmengdevalg med distraktorstraff.
Samme oppgave: 4 riktige alternativer, 2 distraktorer, 4 poeng totalt. Denne gangen velger studenten 3 riktige alternativer og 1 distraktor.
Poengsum = [(riktige valgt / totalt riktige) − (distraktorer valgt / totalt antall distraktorer)] × oppgavepoeng, gulvet ved null Poengsum = [(3/4) − (1/2)] × 4 = [0,75 − 0,5] × 4 = 1,0 poeng
Sammenlign det med den proporsjonale metoden alene, som ville ha ignorert distraktoren helt og gitt 3,0 poeng for det identiske svaret. Det gapet er hele argumentet for straff-baserte metoder på oppgaver der distraktorer er genuint fristende.
3. Rubrikk-til-fraksjon-konvertering på en oppgave med 20 poeng.
Et matematikkproblem med flere steg vurderes på en 0 til 4-rubrikk: 0 (ingen gyldig tilnærming), 1 (kun riktig oppsett), 2 (riktig metode, stor feil), 3 (riktig metode, liten feil), 4 (fullt korrekt). Oppgaven er verdt 20 poeng totalt.
Fraksjonell poengsum = (rubrikk-poeng oppnådd / maks rubrikk-poeng) × oppgavepoeng En student som får 3 på rubrikken får: (3/4) × 20 = 15 poeng
Kjør den konverteringen gjennom en klasse og du får en fordeling som ikke ligner det minste på et enkelt prosentvis-riktig-histogram: poeng samler seg rundt rubrikknivåer (0, 5, 10, 15, 20) i stedet for å spre seg kontinuerlig, noe som er verdt å vite før du bygger en karakterkurve rundt det.
Tips: Bygg disse tre formlene som navngitte funksjoner i en delt regnearksmal før prøvevinduet åpnes. Å tilpasse en poenggivningsformel etter at studentene allerede har levert svar, er der de fleste poenggivningsdisputt begynner.
Statistiske modeller og IRT: Rasch-modellen for delvis poenggivning
Brøkpoengformler svarer på «hvor mange poeng ga dette svaret». Elementsvarteori (IRT) svarer på et annet spørsmål: «Hvor mye evne indikerer dette svaret faktisk, når vi tar hensyn til hvor vanskelig det er å nå hvert svarkategori?» Det skillet betyr noe når du beveger deg fra poenggivning i ett klasserom til en hvilken som helst kontekst der poengsum må sammenlignes på tvers av oppgaveformer, kohorter eller år.
Rasch-modellen for delvis poenggivning, utviklet av Geoff Masters, utvider den standard dikotome Rasch-modellen til oppgaver med ordnede svarkategorier. I stedet for å behandle «steg 2 av 4» som simpelthen verdt halvparten av «steg 4 av 4», estimerer Rasch PCM en separat terskelparameter for overgangen mellom hvert par av tilstøtende kategorier. Å gå fra en poengsum på 1 til 2 på en rubrikk kan kreve betydelig mer demonstrert evne enn å gå fra 2 til 3, og modellen fanger opp dette i stedet for å anta at hvert steg er likt.
Den praktiske gevinsten er parameteradskillbarhet: en eksaminands estimerte evne og en oppgaves kategoriske terskler kan estimeres uavhengig av hverandre, noe som er det som gjør sammenligninger på tvers av oppgaveformer statistisk forsvarlige i utgangspunktet.
Når rettferdiggjør den ekstra kompleksiteten seg?
- Storskala testprogrammer, der tusenvis av svar trenger konsekvent tolkning på tvers av flere eksamensformer.
- Kobling og ekvivalering, når forskjellige grupper av studenter tar ulike versjoner av en test og poengsum må bety det samme på hver av dem.
- Presis oppgavekalibrering, når du trenger å vite nøyaktig hvor mye evne som skiller en «2» fra en «3» på en rubrikk, i stedet for å anta lik avstand.
- Kontroll for differensielt oppgavefungering, der du trenger å bekrefte at en oppgaves delvise poenggivningssteg oppfører seg konsekvent på tvers av demografiske grupper før du stoler på den samlede poengsummen.
En enkelt klasseromsprøve trenger nesten aldri Rasch-kalibrering. En sertifiseringseksamen som administreres nasjonalt, gjenbrukes på tvers av testevinduer og er avgjørende for bestått/ikke bestått-beslutninger med reelle konsekvenser, gjør det nesten alltid. Grensen mellom «bruk en regnearksformel» og «bruk IRT-programvare» handler egentlig om innsats og omfang, ikke om oppgaveformat.
Beste praksis for implementering: design, konfigurasjon og rapportering
Å få delvis poenggivning riktig begynner lenge før noen student ser oppgaven, og det slutter ikke når poengsum er generert. Tre faser fortjener bevisst oppmerksomhet: design, plattformkonfigurasjon og rapportering.
Designsjekkliste. Før du skriver en eneste oppgave, fastsett poenggivningsregelen – ikke etter at pilotering avslører inkonsistens.
- Skriv rubrikken eller poengfordelingsregelen samtidig som du skriver oppgaven, ikke etterpå.
- Bruk en konsekvent poengskala på tvers av lignende oppgaver slik at studentene kan forutsi hvordan delvis poenggivning fordeles.
- Pilottest nye rubrikker på et lite utvalg av ekte eller øvelsessvar før du tar dem i bruk i stor skala, og juster ankerbeskrivelser der to sensorer er uenige.
- Definer 3 til 5 ankersvar per poengband for rubrikker for konstruerte svar – en praksis støttet av forskning på rubrikk-basert delvis poenggivning som anbefaler at sensorer trenes mot eksempelsvar for å oppnå akseptabel inter-rater-enighet.
LMS- og plattformkonfigurasjon. De fleste læringsplattformer gjemmer innstillingene for delvis poenggivning inne i alternativer på oppgavenivå i stedet for eksamensnivå, så sjekk hvert spørsmålsformat individuelt i stedet for å anta at en global bryter dekker alt. Bekreft om tilbakemelding vist til studenter viser den fraksjonelle poengsummen, rubrikknivået eller begge, siden å vise kun et avrundet totalt kan skjule nøyaktig hvor poeng gikk tapt. Eksporter rådata for poengsum uten avrunding når det er mulig. Å avrunde tidlig og beregne på nytt senere er en av de raskeste måtene å innføre stille poenggivningsfeil på tvers av en stor klasse.
Rapportering. Rapporter både den råe fraksjonelle poengsummen og den avrundede totalen, og si dette eksplisitt i den poengsumrapporten studenten mottar. En student som ser «15/20» uten kontekst har ingen måte å vite om de tapte 5 poeng på én stor feil eller flere små. En setning med forklaring av hvordan delvis poenggivning ble beregnet, vedlagt poengsumrapporten, løser de fleste disputt før de starter. Team som utvikler poenggivningsrubrikker for strukturerte vurderinger kan finne ytterligere veiledning og maler for rubrikk-design som passer direkte med fraksjonelle poenggivningsmetoder.
Pålitelighet, validitet og undertrykkelse av gjetting
Pålitelighet er spørsmålet som avgjør om delvis poenggivning var verdt den ekstra kompleksiteten. Hvis en endring i poenggivning ikke målbart forbedrer konsistensen i vurderingen din, er det vanskelig å rettferdiggjøre ekstra sensoropplæring og beregningsomkostninger.
Det empiriske bildet lener seg fordelaktig her. Komparative studier av poenggivningsmetoder på spørsmål med flere svaralternativer fant at metoder med delvis poenggivning forbedret både pålitelighet og diskriminering sammenlignet med enkel dikotom poenggivning, særlig for oppgaver med mer enn to svaralternativer der en rett/galt-deling kaster bort meningsfull variasjon. Separat fant teoretisk arbeid med poenggivningsfunksjoner designet rundt negativ forventet gjettingsverdi at disse funksjonene tenderer til å forbedre både pålitelighet og diskrimineringsevne sammenlignet med ren rett-eller-galt-poenggivning, særlig når en gjettingsstraff er innebygd.
Tre praktiske kontroller forteller deg om endringen gir resultater i dine egne data:
Oppgave-total-korrelasjon. Beregn den på nytt etter å ha byttet til delvis poenggivning. En oppgave hvis korrelasjon med totalpoengsum forbedres, gjør nå en bedre jobb med å skille sterke fra svake kandidater under den nye poenggivningsregelen.
Cronbachs alfa før og etter. Kjør det samme testdatasettet gjennom begge poenggivningsreglene og sammenlign alfa-verdier direkte. En meningsfull økning er et sterkt signal på at delvis poenggivning fanget opp informasjon som den binære versjonen kastet bort.
IRT-tilpasningsstatistikk, der en Rasch- eller annen IRT-modell allerede er i bruk. Kategoriske terskler som kommer ut i feil rekkefølge – det vil si at en høyere rubrikk-poengsum ikke tilsvarer en høyere estimert evne – markerer en rubrikk som trenger revisjon uansett hva de råe pålitelighetstallene sier.
Ingenting av dette er gratis. Kompleksiteten i poenggivning øker med hvert ekstra formelvariant, sensorvariabilitet blir en reell bekymring i det øyeblikket du innfører en rubrikk-basert komponent, og administrative kostnader stiger når du trenger programvare eller regnearksinfrastruktur utover en enkel fasit. Vei disse kostnadene mot dine faktiske innsatsnivåer. En ukentlig prøve rettferdiggjør sjelden overhead-kostnaden; en sertifiseringseksamen gjør det nesten alltid.
Poenggivningsmaler for oppgaver med flere svaralternativer
Spørsmål med flere svaralternativer – der en student velger flere alternativer fra en lengre liste – er der gjetting gjør størst skade på en tests validitet. En student som velger hvert alternativ på en «velg alle som gjelder»-oppgave med fire riktige svar av seks valg, vil alltid få delvis poengsum under naiv proporsjonal poenggivning, uansett om de kan noe eller ikke.
Løsningen er en poenggivningsmal bygget rundt forventet verdi. En vanlig struktur: tildel p1 poeng når studenten velger eksakt fasiten (den fulle riktige mengden) eller, i noen formuleringer, når alle distraktorer er riktig ekskludert; ellers bruk en pc − m formel, der pc er andelen riktige og m er en straff skalert til valg utenfor fasiten. Målet, slik formell forskning på poenggivningsfunksjoner legger frem, er å sørge for at matematikken i seg selv motvirker uforsiktig overvalg.
- Størrelsesjuster straffen (m) slik at forventet verdi av å velge alle alternativer, eller velge tilfeldig, blir negativ eller i verste fall null.
- Test straffen din mot et «velg alt»-svar før du tar oppgaven i bruk. Hvis det svaret scorer over null, er straffen for liten.
- Test det også mot et genuint ærlig delvis-kunnskap-svar. Hvis en student riktig identifiserer 3 av 4 riktige alternativer og utelukker begge distraktorene, men scorer dårligere enn noen som gjettet bredt, er straffen for stor.
Oppgaveformulering betyr like mye som formelen bak den. Instruksjoner som lyder «velg alle riktige svar» uten noen veiledning om straff presser studenter mot gjetting, siden det ikke er noe negativt signal i selve ordlyden. Legg til en kort setning som sier at feilaktige valg reduserer poengsummen, og du får mer ærlig rapportering av delvis kunnskap – fordi studenter ikke lenger har insentiv til å velge alternativer de er usikre på bare for å sikre seg.
Styringssjekkliste for praktikere før du skalerer
Før du ruller ut delvis poenggivning utover en pilotgruppe, gjennomfør disse fire kontrollene:
- Rubrikk-klarhet. Bekreft at hvert rubrikknivå har en distinkt, observerbar ankerbeskrivelse – ikke bare en vag merkelapp som «stort sett riktig».
- Inter-rater-pålitelighet. La to sensorer uavhengig av hverandre vurdere de samme 20 til 30 eksempelsvarene og kontroller enighet før du stoler på en enkelt sensors vurderinger i stor skala.
- Pilotsammenligning. Vurder det samme svarsettet under både den gamle poenggivningsregelen og den nye regelen for delvis poenggivning, og sammenlign pålitelighet og karakterfordeling side om side.
- Sensitivitetsanalyse. Juster straffevektene eller poengfordelingene litt og kjør analysen på nytt. Veiledning for poenggivningsmodeller anbefaler dette steget fordi små vektendringer kan snu pålitelighetsresultater eller helt endre rangeringen av kandidater.
Dokumenter alle poenggivningsbeslutninger, inkludert hvorfor en bestemt formel eller straffestørrelse ble valgt, i et format som interessenter kan gjennomgå senere. Den dokumentasjonen er det som gjør en forsvarlig pilot om til en forsvarlig policy.
Når delvis poenggivning rettferdiggjør sin kompleksitet
Delvis poenggivning er en målingsforbedring med en reell administrativ kostnad, og å late som noe annet gjør en bjørnetjeneste for alle som piloterer det for første gang. Gevinsten i pålitelighet og diskriminering er godt dokumentert, men det er også den økte byrden: mer sensoropplæring, mer komplekse formler, mer rom for uenighet om hva «delvis» faktisk betyr på en gitt oppgave.
Min ærlige lesning av forskningen er at de fleste vurderinger på klasseromsnivå ikke trenger Rasch-kalibrering, delmengde-seleksjonsstraffer eller noe av det mer avanserte verktøyet beskrevet ovenfor. En tydelig rubrikk og proporsjonal fraksjonering dekker de fleste reelle klasseromsbehovene. Der delvis poenggivning rettferdiggjør sin kompleksitet er i stor skala: sertifiseringseksamener, testprogrammer med flere skjemaer og enhver vurdering der en feil poenggivningsforutsetning forplanter seg over tusenvis av kandidater i stedet for tretti.
Den operative byrden er nøyaktig der gode plattformverktøy endrer regnestykket, særlig hvis du ønsker å automatisere global rekruttering og redusere samsvarsrisiko. Et verktøy som automatiserer rubrikkanvendelse, sporer sensorkonsistens og logger poenggivningsbeslutninger, fjerner mesteparten av fryksjonen som hindrer lærere fra å pilotere delvis poenggivning i det hele tatt. Pilotér først, mål pålitelighetsgevinsten mot den ekstra kostnaden, og skalér bare tilnærmingen når tallene faktisk rettferdiggjør det.
— Jimmie
Bygg vurderinger med delvis poenggivning uten å bygge infrastrukturen selv
Mesteparten av friksjonen i delvis poenggivning er ikke matematikken. Det er infrastrukturen: å skrive konsistente rubrikker, holde sensorer samkjørte og stole på at ingen jukset på prøven. Talent Approved er bygget rundt en betal-per-bruk-modell uten abonnement, så du betaler kun per gjennomført kandidatvurdering og slipper omkostningene ved å lisensiere poengsettingsprogramvare du kanskje bare trenger av og til.
Plattformens Magic Create-funksjon bygger en rollespesifikk, rubrikk-klar vurdering direkte fra en stillingsbeskrivelse eller ferdighetsliste, noe som eliminerer den manuelle oppgaveskrivingsfasen helt. Innebygde anti-juks-verktøy, inkludert skjerm- og webkameraovervåking med sesjonsspilling, beskytter integriteten til resultater fra delvis poenggivning på samme måte som sensoropplæring beskytter en rubrikk for konstruerte svar. KI-genererte ytelsessammendrag gjør fraksjonelle poengsum om til lesbare kandidatrangeringer uten å tvinge teamet ditt til å tolke rå rubrikk-matematikk for hånd.
Hvis du vurderer ferdigheter snarere enn karaktersetter studenter, og ønsker poenggivning i delvis-poenggivning-stil uten å eie poenggivningsinfrastrukturen, sjekk prissiden for ferdighetsvurderinger og se hva en pilotvurdering ville koste for din neste ansettelsesrunde.
Kilder
- Evaluering av ulike poenggivningsmetoder for spørsmål med flere svaralternativer som gir delvis poengsum
- Teoretisk evaluering av delvis poenggivning på flervalgsoppgaver
- Metoder for delvis poenggivning for flervalgstester. – ERIC
FAQ
Hvordan beregner du delvis poenggivning?
Del poengene opptjent (riktige valg, rubrikknivå eller delmengdetreff) på maksimalt mulige poeng for den oppgaven, og multipliser deretter med oppgavens totale poengverdi. Delmengdevalg- og lineære straffemodeller trekker fra en vektet straff for feilaktige valg før den endelige multiplikasjonen.
Hva er de tre hovedtypene av tilnærminger til poenggivning?
Innen vurderingsdesign er de tre brede tilnærmingene dikotom (rett/galt) poenggivning, delvis poenggivning (proporsjonale, delmengdevalg- eller straff-baserte formler) og rubrikk-basert fraksjonell poenggivning for konstruerte svar. Hver passer for ulike oppgaveformater, og ingen enkelt tilnærming er overlegen i alle sammenhenger.
Hva undergraver oftest et system for delvis poenggivning?
Uklare rubrikk-ankere og inkonsekvent sensoropplæring er de vanligste sviktpunktene, siden de skaper uenighet mellom sensorer som ingen formel kan rette opp i etterkant. En nær andreplass er en straffevariabel som er for liten, noe som gjør tilfeldig gjetting statistisk lønnsomt i stedet for å undertrykke det.
Forbedrer delvis poenggivning faktisk testpåliteligheten?
Empiriske sammenligninger på spørsmål med flere svaralternativer fant at delvis poenggivning forbedret både pålitelighet og diskriminering sammenlignet med dikotom poenggivning, særlig når poenggivningsfunksjonen straffer feilaktige valg. Gevinsten er ikke automatisk. Den avhenger av rubrikk-klarhet og straffestørrelse.
Kan en plattform håndtere delvis poenggivning for ferdighetsvurderinger?
Ja. Talent Approved støtter rubrikk-basert poenggivning ved siden av sin Magic Create-vurderingsbygger og anti-juks-overvåking, slik at ansettelsesgrupper kan bruke fraksjonell poenggivningslogikk uten å bygge beregningsinfrastrukturen selv. Gjeldende priser er oppgitt på siden for ferdighetsvurderinger.