
3 Fórmulas de Planilha para Pontuação de Crédito Parcial e Rasch
A pontuação de crédito parcial atribui pontos ao longo de uma escala, em vez de um resultado tudo-ou-nada, recompensando o candidato pela parte da resposta que está correta. Os educadores utilizam-na porque mede o conhecimento parcial que a pontuação dicotómica, de certo ou errado, descarta, e funções de crédito parcial bem concebidas suprimem a recompensa das tentativas aleatórias. Adapta-se melhor a itens com várias partes, questões de resposta múltipla e respostas construídas avaliadas com base numa rubrica, especialmente quando se necessita de informação de diagnóstico mais detalhada do que uma simples pontuação de aprovado/reprovado pode fornecer.
Resumo:
- A pontuação de crédito parcial capta melhor o conhecimento dos estudantes em itens de múltiplas partes, de resposta múltipla e de resposta construída do que as abordagens simples de certo ou errado.
- Métodos como a seleção de subconjuntos e a penalização linear controlam as tentativas aleatórias, mas exigem instruções claras e podem introduzir complexidade na pontuação e na formação dos avaliadores.
- A investigação empírica mostra que o crédito parcial melhora a fiabilidade e a discriminação, especialmente em grande escala ou em itens de resposta múltipla propensos a tentativas aleatórias.
- A maioria das avaliações em sala de aula não necessita de modelos avançados como o crédito parcial de Rasch, que estão reservados para programas de testes em larga escala e exames de certificação.
- A utilização de ferramentas dedicadas que automatizam a aplicação de rubricas, a consistência dos avaliadores e a transparência da pontuação simplifica a implementação e garante uma avaliação de crédito parcial justa e consistente.
Índice
- O Que Significa a Pontuação de Crédito Parcial e Quando Utilizá-la
- Métodos Comuns de Pontuação de Crédito Parcial
- Como Calcular o Crédito Parcial: Exemplos Práticos
- Modelos Estatísticos e TRI: O Modelo de Crédito Parcial de Rasch
- Melhores Práticas de Implementação: Conceção, Configuração e Relatórios
- Fiabilidade, Validade e Supressão de Tentativas Aleatórias
- Modelos de Pontuação para Itens de Resposta Múltipla
- Lista de Verificação de Governação para Profissionais Antes de Escalar
- Quando o Crédito Parcial Justifica a Sua Complexidade
- Crie Avaliações de Crédito Parcial Sem Construir a Infraestrutura Você Mesmo
- Fontes
- FAQ
O Que Significa a Pontuação de Crédito Parcial e Quando Utilizá-la
A pontuação dicotómica trata uma resposta como totalmente certa ou totalmente errada, valendo um ponto ou zero. A pontuação de crédito parcial abre esse binário. Um estudante que seleciona três das quatro opções corretas num item de resposta múltipla, ou que acerta a configuração de um problema em várias etapas mas erra no cálculo final, recebe crédito proporcional ao que efetivamente demonstrou.
O argumento a favor do crédito parcial assenta em três resultados práticos. Em primeiro lugar, capta o conhecimento parcial que uma regra estrita de certo/errado apaga, o que é mais relevante em itens com várias sub-respostas defensáveis. Em segundo lugar, funções de pontuação adequadamente construídas podem tornar negativo o valor esperado de uma tentativa aleatória, de modo que adivinhar deixa de ser uma estratégia racional — um efeito formalmente modelado na investigação sobre funções de pontuação. Em terceiro lugar, comparações empíricas em itens de resposta múltipla verificaram que os métodos de crédito parcial melhoraram tanto a fiabilidade como a discriminação dos itens em relação à pontuação dicotómica.
Não é necessário utilizar crédito parcial em todo o lado. Um teste de vocabulário com respostas corretas únicas não ganha nada com isso e apenas acrescenta complexidade à pontuação. Recorra ao crédito parcial quando os itens são genuinamente compostos por várias partes, quando as questões de resposta múltipla têm mais de duas seleções plausíveis, ou quando uma resposta construída pode ser decomposta numa rubrica com componentes distintos e avaliáveis.
Métodos Comuns de Pontuação de Crédito Parcial
Nenhuma fórmula única é vencedora em todos os contextos. Revisões clássicas da área catalogam uma variedade de métodos e encontram consistentemente compromissos em vez de um vencedor universal, pelo que a escolha certa depende do formato do item e do que se pretende proteger — seja contra tentativas aleatórias, inconsistência dos avaliadores ou a própria complexidade da pontuação.
- Pontuação proporcional (número de respostas certas). Os pontos equivalem à fração de seleções corretas em relação ao total de seleções possíveis. Simples de calcular, fácil de explicar aos estudantes, mas vulnerável a manipulação em itens de resposta múltipla onde selecionar tudo garante uma pontuação de base.
- Pontuação por seleção de subconjuntos (SS). Crédito total apenas quando o subconjunto correto exato é escolhido; crédito parcial concedido para subconjuntos que correspondam parcialmente à chave, com penalizações para distratores incluídos. Melhor controlo de tentativas aleatórias do que a pontuação puramente proporcional, ao custo de uma regra ligeiramente mais complexa de explicar.
- Funções modificadas ao estilo Zapechelnyuk. Estas utilizam uma estrutura de penalização matematicamente derivada, concebida para que o valor esperado de tentativas cegas se torne negativo, abordando diretamente o problema das tentativas aleatórias em vez de simplesmente tolerá-lo.
- Modelos de penalização linear. A pontuação é igual ao número de seleções corretas menos uma contagem ponderada de seleções incorretas. Ajustável mediante a modificação do peso da penalização, o que permite calibrar a agressividade com que se pretende desencorajar a seleção excessiva.
- Fracionamento baseado em rubricas. As respostas construídas são pontuadas com base numa rubrica ordenada (de 0 a 4, por exemplo) e depois convertidas numa fração dos pontos totais do item. Esta é a abordagem padrão para ensaios, problemas matemáticos em várias etapas e relatórios de laboratório.
A pontuação proporcional é adequada para itens de seleção múltipla e de preenchimento de espaços múltiplos onde o formato é direto e o risco de tentativas aleatórias é baixo. Os modelos de seleção de subconjuntos e de penalização linear são adequados para itens de resposta múltipla onde os distratores são suficientemente atrativos para que a seleção aleatória possa inflar as pontuações. O fracionamento baseado em rubricas é realmente a única opção sólida para respostas construídas abertas, uma vez que não existe um "número correto" discreto para dividir.
O padrão de compromisso é consistente entre os métodos: fórmulas mais simples (pontuação proporcional) são mais fáceis de compreender para estudantes e instrutores, mas as mais fracas contra tentativas aleatórias, enquanto os métodos baseados em penalizações e subconjuntos controlam melhor as tentativas aleatórias, mas exigem instruções mais claras para que os estudantes entendam como as seleções são ponderadas. A pontuação baseada em rubricas acarreta um risco diferente: a inconsistência entre avaliadores, que nenhuma fórmula consegue corrigir por si só.
Como Calcular o Crédito Parcial: Exemplos Práticos
As fórmulas acima são inúteis até poder executar os cálculos por si mesmo. Aqui estão três exemplos práticos que pode transferir diretamente para uma folha de cálculo.
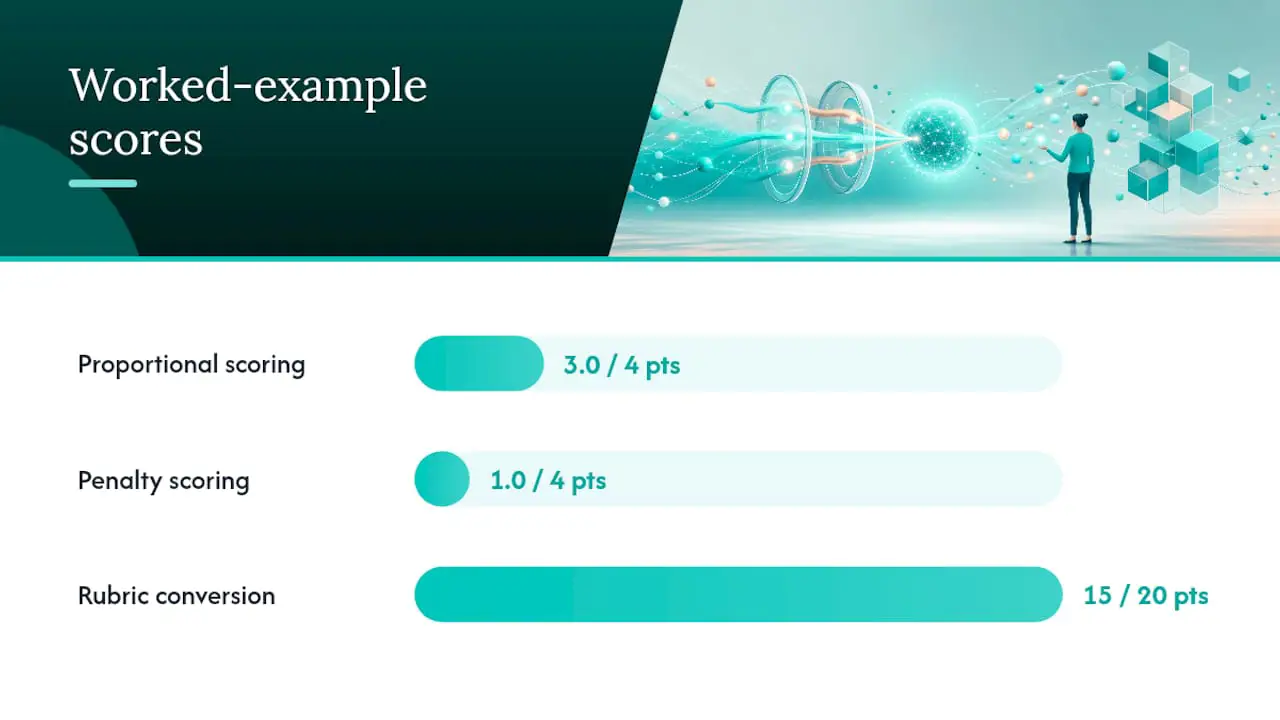
1. Pontuação proporcional num item de seleção múltipla com quatro opções.
Suponha que um item tem quatro opções corretas de um total de seis escolhas, valendo 4 pontos. Um estudante seleciona 3 das 4 opções corretas e 0 distratores.
Pontuação = (seleções corretas / total de opções corretas) × pontos do item Pontuação = (3 / 4) × 4 = 3,0 pontos
2. Seleção de subconjuntos com penalização por distrator.
Mesmo item: 4 opções corretas, 2 distratores, 4 pontos no total. Desta vez o estudante seleciona 3 opções corretas e 1 distrator.
Pontuação = [(corretas selecionadas / total corretas) − (distratores selecionados / total de distratores)] × pontos do item, com mínimo de zero Pontuação = [(3/4) − (1/2)] × 4 = [0,75 − 0,5] × 4 = 1,0 ponto
Compare isso com o método puramente proporcional, que teria ignorado o distrator por completo e atribuído 3,0 pontos pela resposta idêntica. Essa diferença é o argumento central dos métodos baseados em penalizações em itens onde os distratores são genuinamente tentadores.
3. Conversão de rubrica em fração numa questão de 20 pontos.
Um problema matemático em várias etapas é avaliado numa rubrica de 0 a 4: 0 (nenhuma abordagem válida), 1 (apenas configuração correta), 2 (método correto, erro grave), 3 (método correto, erro menor), 4 (totalmente correto). A questão vale 20 pontos no total.
Pontuação fracionada = (pontos da rubrica obtidos / pontos máximos da rubrica) × pontos do item Um estudante que obtém 3 na rubrica recebe: (3/4) × 20 = 15 pontos
Execute essa conversão em toda a lista da turma e obterá uma distribuição que em nada se assemelha a um simples histograma de percentagem de respostas corretas: as pontuações agrupam-se em torno das bandas da rubrica (0, 5, 10, 15, 20) em vez de se espalharem de forma contínua, o que vale a pena saber antes de construir uma curva de classificação com base nisso.
Dica Pro: Crie estas três fórmulas como funções nomeadas num modelo de folha de cálculo partilhada antes de o período de exame começar. Reformular uma fórmula de pontuação depois de os estudantes já terem submetido as respostas é onde começam a maioria das disputas de pontuação.
Modelos Estatísticos e TRI: O Modelo de Crédito Parcial de Rasch
As fórmulas de pontuação fracionada respondem à pergunta "quantos pontos esta resposta obteve". A teoria de resposta ao item (TRI) responde a uma pergunta diferente: "quanta capacidade esta resposta indica efetivamente, uma vez que tenhamos em conta a dificuldade de alcançar cada categoria de resposta". Essa distinção importa a partir do momento em que se passa da avaliação numa única sala de aula para qualquer contexto onde as pontuações precisam de ser comparadas entre formas, coortes ou anos.
O modelo de crédito parcial de Rasch, desenvolvido por Geoff Masters, estende o modelo de Rasch dicotómico padrão a itens com categorias de resposta ordenadas. Em vez de tratar "etapa 2 de 4" como simplesmente valendo metade de "etapa 4 de 4", o Modelo de Crédito Parcial de Rasch estima um parâmetro de limiar separado para a transição entre cada par de categorias adjacentes. Passar de uma pontuação de 1 para 2 numa rubrica pode exigir consideravelmente mais capacidade demonstrada do que passar de 2 para 3, e o modelo capta isso em vez de assumir que cada etapa é igual.
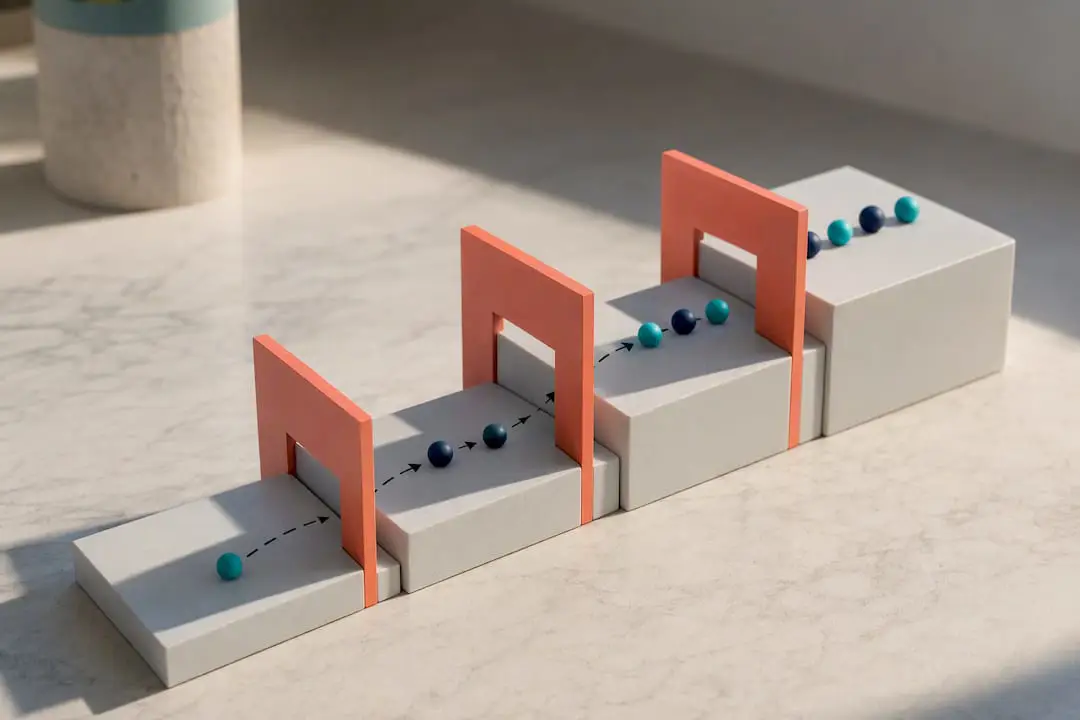
A recompensa prática é a separabilidade de parâmetros: a capacidade estimada de um examinando e os limiares de categoria de um item podem ser estimados independentemente um do outro, o que é o que torna as comparações entre formas estatisticamente defensáveis em primeiro lugar.
Quando é que a complexidade adicional se justifica?
- Programas de testes em larga escala, onde milhares de respostas precisam de interpretação consistente em múltiplas formas de exame.
- Ligação e equiparação, quando diferentes grupos de estudantes realizam versões diferentes de um teste e as pontuações devem ter o mesmo significado em cada uma.
- Calibração precisa de itens, quando se precisa saber exatamente quanta capacidade separa um "2" de um "3" numa rubrica, em vez de assumir espaçamento igual.
- Verificações de funcionamento diferencial dos itens, onde é necessário confirmar que as etapas de crédito parcial de um item se comportam de forma consistente em diferentes grupos demográficos antes de confiar na pontuação agregada.
Um teste de uma única turma quase nunca precisa de calibração de Rasch. Um exame de certificação administrado a nível nacional, reutilizado em múltiplas janelas de avaliação e utilizado para decisões de aprovação/reprovação com consequências reais, quase sempre precisa. A linha entre "usar uma fórmula em folha de cálculo" e "usar software de TRI" é realmente uma linha sobre stakes e escala, não sobre o formato do item.
Melhores Práticas de Implementação: Conceção, Configuração e Relatórios
Fazer o crédito parcial corretamente começa muito antes de qualquer estudante ver o item, e não termina quando as pontuações são geradas. Três fases merecem atenção deliberada: conceção, configuração da plataforma e elaboração de relatórios.
Lista de verificação de conceção. Antes de escrever um único item, defina a regra de pontuação — não depois de o piloto revelar inconsistências.
- Escreva a rubrica ou a regra de alocação de pontos ao mesmo tempo que escreve o item, não depois.
- Use uma escala de pontos consistente em itens semelhantes para que os estudantes possam prever como o crédito parcial é distribuído.
- Teste novas rubricas numa pequena amostra de respostas reais ou de prática antes de as implementar em grande escala, e ajuste as descrições de âncora onde dois avaliadores discordam.
- Defina 3 a 5 respostas de âncora por banda de pontuação para rubricas de resposta construída — uma prática apoiada por investigação sobre pontuação de crédito parcial baseada em rubricas que recomenda a formação de avaliadores com base em exemplos para alcançar um acordo inter-avaliadores aceitável.
Configuração do LMS e da plataforma. A maioria dos sistemas de gestão de aprendizagem oculta as definições de crédito parcial dentro das opções ao nível do item em vez das definições ao nível do exame, por isso verifique cada tipo de questão individualmente em vez de assumir que um interruptor global cobre tudo. Confirme se o feedback mostrado aos estudantes exibe a pontuação fracionada, o nível da rubrica ou ambos, uma vez que mostrar apenas um total arredondado pode ocultar exatamente onde os pontos foram perdidos. Exporte dados de pontuação brutos e não arredondados sempre que possível. Arredondar cedo e recalcular mais tarde é uma das formas mais rápidas de introduzir erros de avaliação silenciosos em listas numerosas.
Relatórios. Relate tanto a pontuação fracionada bruta como o total arredondado, e diga-o explicitamente em qualquer relatório de pontuação que chegue ao estudante. Um estudante que vê "15/20" sem contexto não tem forma de saber se perdeu 5 pontos por um grande erro ou por vários pequenos. Uma explicação de uma linha sobre como o crédito parcial foi calculado, anexada ao relatório de pontuação, resolve a maioria das disputas antes de começarem. As equipas que constroem rubricas de pontuação para avaliações estruturadas podem encontrar orientação e modelos adicionais de conceção de rubricas que se combinam diretamente com abordagens de pontuação fracionada.
Fiabilidade, Validade e Supressão de Tentativas Aleatórias
A fiabilidade é a questão que decide se o crédito parcial valeu a complexidade adicional. Se uma mudança na pontuação não melhorar mensuravelmente a consistência da sua avaliação, a formação extra dos avaliadores e o esforço adicional de cálculo são difíceis de justificar.
O registo empírico é favorável neste aspeto. Estudos comparativos de métodos de pontuação em itens de resposta múltipla verificaram que as abordagens de crédito parcial melhoraram a fiabilidade e a discriminação em comparação com a pontuação dicotómica simples, particularmente para itens com mais de duas opções de resposta onde uma divisão certo/errado descarta variação significativa. Separadamente, trabalhos teóricos sobre funções de pontuação concebidas em torno de um valor esperado de tentativas aleatórias negativo verificaram que estas funções tendem a melhorar tanto a fiabilidade como o poder discriminativo em relação à pontuação simples de certo ou errado, especialmente quando uma penalização por tentativas aleatórias está incorporada.
Três verificações práticas indicam se a mudança está a ter resultados nos seus próprios dados:
Correlação item-total. Recalcule-a após mudar para crédito parcial. Um item cuja correlação com a pontuação total melhora está agora a fazer um melhor trabalho a separar os melhores dos piores desempenhos sob a nova regra de pontuação.
Alfa de Cronbach antes e depois. Execute o mesmo conjunto de dados de teste com ambas as regras de pontuação e compare os valores de alfa diretamente. Um aumento significativo é um sinal forte de que o crédito parcial capturou informação que a versão binária descartou.
Estatísticas de ajustamento da TRI, quando um modelo de Rasch ou outro modelo de TRI já está a ser utilizado. Limiares de categoria que saem desordenados — ou seja, uma pontuação de rubrica mais alta não corresponde a uma capacidade estimada mais alta — sinalizam uma rubrica que precisa de revisão, independentemente do que os números brutos de fiabilidade indicam.
Nada disto é gratuito. A complexidade da pontuação aumenta com cada variante de fórmula adicional, a variabilidade entre avaliadores torna-se uma preocupação imediata no momento em que se introduz qualquer componente baseado em rubricas, e o custo administrativo sobe quando se precisa de software ou infraestrutura de folhas de cálculo para além de uma simples chave de respostas. Pese esses custos em função dos seus stakes reais. Um teste semanal raramente justifica o esforço; um exame de certificação quase sempre o faz.
Modelos de Pontuação para Itens de Resposta Múltipla
Os itens de resposta múltipla — onde um estudante seleciona várias opções de uma lista mais longa — são onde as tentativas aleatórias mais prejudicam a validade de um teste. Um estudante que seleciona todas as opções num item "selecione todas as que se aplicam" com quatro respostas corretas de seis escolhas obterá sempre crédito parcial sob uma pontuação proporcional ingénua, independentemente de saber alguma coisa ou não.
A solução é um modelo de pontuação construído em torno do valor esperado. Uma estrutura comum: atribua p1 pontos quando o estudante seleciona exatamente a chave (o conjunto correto completo) ou, nalgumas formulações, quando todos os distratores são corretamente excluídos; caso contrário, aplique uma fórmula pc − m, onde pc é a proporção correta e m é uma penalização escalada para as seleções fora da chave. O objetivo, como a investigação formal sobre funções de pontuação estabelece, é garantir que a própria matemática desencoraje a seleção excessiva descuidada.
- Dimensione a penalização (m) de modo que o valor esperado de selecionar todas as opções, ou selecionar aleatoriamente, seja negativo ou, na pior das hipóteses, zero.
- Teste a sua penalização contra uma resposta "selecionar tudo" antes de implementar o item. Se essa resposta pontuar acima de zero, a penalização é demasiado pequena.
- Teste-a também contra uma resposta de conhecimento parcial genuinamente honesto. Se um estudante identifica corretamente 3 das 4 opções corretas e exclui ambos os distratores, mas pontua pior do que alguém que adivinhou amplamente, a penalização é demasiado grande.
A formulação do item é tão importante quanto a fórmula subjacente. Instruções que dizem "selecione todas as respostas corretas" sem qualquer orientação sobre penalizações empurram os estudantes para adivinhar, uma vez que não há nenhum sinal de desvantagem nas próprias palavras. Acrescente uma linha curta a indicar que as seleções incorretas reduzem a pontuação, e obterá uma comunicação mais honesta do conhecimento parcial, porque os estudantes já não têm incentivo para selecionar opções sobre as quais têm dúvidas apenas para se precaverem.
Lista de Verificação de Governação para Profissionais Antes de Escalar
Antes de implementar o crédito parcial para além de um grupo piloto, execute estas quatro verificações:
- Clareza da rubrica. Confirme que cada nível da rubrica tem uma descrição de âncora distinta e observável, não apenas um rótulo vago como "maioritariamente correto".
- Fiabilidade inter-avaliadores. Peça a dois avaliadores que pontuem de forma independente as mesmas 20 a 30 respostas de amostra e verifique o acordo antes de confiar nas pontuações de um único avaliador em grande escala.
- Comparação piloto. Pontue o mesmo conjunto de respostas com a antiga regra de pontuação e com a nova regra de crédito parcial, e compare a fiabilidade e a distribuição de classificações lado a lado.
- Análise de sensibilidade. Ajuste ligeiramente os pesos das penalizações ou as alocações de pontos e reexecute a análise. As orientações sobre modelos de pontuação recomendam este passo porque pequenas mudanças de ponderação podem inverter os resultados de fiabilidade ou reordenar completamente as classificações dos candidatos.
Documente cada decisão de pontuação — incluindo o motivo pelo qual uma fórmula ou tamanho de penalização específico foi escolhido — num formato que os intervenientes possam rever mais tarde. Esse registo é o que transforma um piloto defensável numa política defensável.
Quando o Crédito Parcial Justifica a Sua Complexidade
O crédito parcial é uma melhoria de medição com um custo administrativo real, e fingir o contrário prejudica qualquer pessoa que o esteja a experimentar pela primeira vez. O ganho em fiabilidade e discriminação está bem documentado, mas também o é o encargo adicional: mais formação de avaliadores, fórmulas mais complexas, mais espaço para discordância sobre o que "parcial" realmente significa num determinado item.
A minha leitura honesta da investigação é que a maioria das avaliações ao nível da sala de aula não necessita de calibração de Rasch, penalizações de seleção de subconjuntos, ou qualquer outra maquinaria mais elaborada abordada acima. Uma rubrica clara e o fracionamento proporcional cobrem a maioria das necessidades reais em sala de aula. Onde o crédito parcial justifica a sua complexidade é em grande escala: exames de certificação, programas de testes com múltiplas formas, e qualquer avaliação onde um pressuposto de pontuação errado se multiplica por milhares de candidatos em vez de trinta.
O encargo operacional é exatamente onde as boas ferramentas de plataforma mudam o cálculo, especialmente se quiser automatizar a contratação global e reduzir os riscos de conformidade. Uma ferramenta que automatize a aplicação de rubricas, acompanhe a consistência dos avaliadores e registe as decisões de pontuação remove a maior parte da fricção que impede os educadores de experimentar o crédito parcial. Experimente primeiro, meça o ganho de fiabilidade em relação ao custo adicional, e só escale a abordagem quando os números o justificarem realmente.
— Jimmie
Crie Avaliações de Crédito Parcial Sem Construir a Infraestrutura Você Mesmo
A maior parte da fricção na pontuação de crédito parcial não é a matemática. É a infraestrutura: escrever rubricas consistentes, manter os avaliadores alinhados e confiar que ninguém manipulou o teste. Talent Approved é construído em torno de um modelo de pagamento por utilização sem subscrição, pelo que só paga por avaliação de candidato concluída, e evita o custo de licenciar software de pontuação que pode precisar apenas ocasionalmente.
A funcionalidade Magic Create da plataforma constrói uma avaliação específica para a função, pronta para rubrica, diretamente a partir de uma descrição de cargo ou lista de competências, o que elimina completamente a fase manual de redação de itens. As ferramentas anti-batota integradas — incluindo monitorização de ecrã e webcam com reproduções de sessão — protegem a integridade dos resultados de crédito parcial da mesma forma que a formação de avaliadores protege uma rubrica de resposta construída. Os resumos de desempenho gerados por IA transformam pontuações fracionadas em classificações de candidatos legíveis sem obrigar a sua equipa a interpretar manualmente a matemática bruta das rubricas.
Se está a avaliar competências em vez de classificar estudantes, e quer uma pontuação ao estilo de crédito parcial sem ser dono da infraestrutura de pontuação, consulte a página de preços de avaliações de competências e veja quanto custaria uma avaliação piloto para a sua próxima ronda de contratação.
Fontes
- Evaluating Different Scoring Methods for Multiple Response Items Providing Partial Credit
- Theoretical evaluation of partial credit scoring of the multiple-choice test item
- Partial-Credit Scoring Methods for Multiple-Choice Tests. - ERIC
FAQ
Como Se Calcula o Crédito Parcial?
Divida os pontos obtidos (seleções corretas, nível da rubrica ou correspondência de subconjunto) pelos pontos máximos possíveis para esse item, e depois multiplique pelo valor total de pontos do item. Os métodos de seleção de subconjuntos e de penalização linear subtraem uma penalização ponderada pelas seleções incorretas antes dessa multiplicação final.
Quais São os Três Principais Tipos de Abordagens de Pontuação?
No design de avaliações, as três abordagens gerais são a pontuação dicotómica (certo/errado), a pontuação de crédito parcial (fórmulas proporcionais, de seleção de subconjuntos ou baseadas em penalizações) e a pontuação fracionada baseada em rubricas para respostas construídas. Cada uma é adequada a diferentes formatos de itens, e nenhuma abordagem é superior em todos os contextos.
O Que Mais Frequentemente Prejudica um Sistema de Pontuação de Crédito Parcial?
As âncoras de rubrica pouco claras e a formação inconsistente dos avaliadores são os pontos de falha mais comuns, uma vez que introduzem discordância entre avaliadores que nenhuma fórmula consegue corrigir após o facto. Em segundo lugar muito próximo está um termo de penalização demasiado pequeno, que mantém as tentativas aleatórias estatisticamente rentáveis em vez de suprimidas.
O Crédito Parcial Melhora Realmente a Fiabilidade do Teste?
Comparações empíricas em itens de resposta múltipla verificaram que a pontuação de crédito parcial melhorou tanto a fiabilidade como a discriminação em comparação com a pontuação dicotómica, particularmente quando a função de pontuação penaliza as seleções incorretas. O ganho não é automático. Depende da clareza da rubrica e do dimensionamento da penalização.
Uma Plataforma Pode Gerir a Pontuação de Crédito Parcial para Avaliações de Competências?
Sim. Talent Approved suporta pontuação baseada em rubricas juntamente com o seu construtor de avaliações Magic Create e monitorização anti-batota, permitindo que as equipas de contratação apliquem lógica de pontuação fracionada sem construir a infraestrutura de cálculo elas próprias. Os preços atuais estão listados na página de avaliações de competências.
Recomendado
- 3 Verificações de Fiabilidade para Avaliações com Pontuação Ponderada em Recrutamento
- Crie Rubricas de Pontuação para Avaliações que os Educadores Possam Experimentar e Escalar com IA
- Como Calcular Notas Mínimas de Aprovação da Forma Correta
- Equipas de Recrutamento: 5 Passos para uma Análise de Avaliações Baseada em Medição