
3 Kalkylbladsformler för Delpoängsättning och Rasch
Poängsättning med delkredit tilldelar poäng längs en skala snarare än ett allt-eller-inget-utfall och belönar den som gör ett test för den del av svaret som är korrekt. Lärare använder det eftersom det mäter partiell kunskap som dikotom, rätt-eller-fel-poängsättning kastar bort, och väldesignade delkreditfunktioner dämpar utdelningen av slumpmässiga gissningar. Det passar bäst på flerdelsuppgifter, flervalsfrågor och konstruerade svar som bedöms mot en rubrik, särskilt när du behöver mer detaljerad diagnostisk information än ett enkelt godkänd/underkänd-betyg kan ge.
Sammanfattning:
- Poängsättning med delkredit fångar studentkunskap bättre på flerdels-, flervalssvars- och konstruerade svarsuppgifter än enkla rätt-eller-fel-metoder.
- Metoder som delmängdsval och linjär straffavdrag kontrollerar gissningar men kräver tydliga instruktioner och kan introducera komplexitet i poängsättning och bedömarträning.
- Empirisk forskning visar att delkredit förbättrar tillförlitlighet och diskriminering, särskilt i stor skala eller med flersvarsuppgifter som är benägna till gissningar.
- De flesta klassrumsbedömningar behöver inte avancerade modeller som Rasch delkredit, som är reserverade för storskaliga testprogram och certifieringsexamina.
- Att använda dedikerade verktyg som automatiserar rubriktillämpning, bedömningskonsistens och poängsättningstransparens förenklar implementeringen och säkerställer rättvis och konsekvent delkreditbedömning.
Innehållsförteckning
- Vad poängsättning med delkredit innebär och när du ska använda det
- Vanliga metoder för poängsättning med delkredit
- Hur man beräknar delkredit: bearbetade exempel
- Statistiska modeller och IRT: Rasch delkreditmodell
- Bästa praxis för implementering: design, konfiguration och rapportering
- Tillförlitlighet, validitet och gissningssuppression
- Poängsättningsmallar för flersvarsuppgifter
- Checklista för styrning av utövare innan du skalar upp
- När delkredit motiverar sin komplexitet
- Bygg delkreditbedömningar utan att bygga infrastrukturen själv
- Källor
- FAQ
Vad poängsättning med delkredit innebär och när du ska använda det
Dikotom poängsättning behandlar ett svar som antingen helt rätt eller helt fel, värt en poäng eller noll. Poängsättning med delkredit bryter upp den binären. En student som väljer tre av fyra korrekta alternativ på en flersvarsuppgift, eller som klarar uppställningen av ett flerstegsprolem men misslyckas med den slutliga beräkningen, får poäng proportionellt mot vad de faktiskt har visat.
Argumentet för delkredit vilar på tre praktiska utfall. För det första fångar det partiell kunskap som en strikt rätt/fel-regel raderar, vilket spelar störst roll på uppgifter med flera försvarliga delsvar. För det andra kan korrekt konstruerade poängsättningsfunktioner göra förväntat värde av en slumpmässig gissning negativt, så att gissning upphör att vara en rationell strategi – en effekt som formellt modellerats i forskning om poängsättningsfunktioner. För det tredje fann empiriska jämförelser på flersvarsuppgifter att delkreditmetoder förbättrade både tillförlitlighet och uppgiftsdiskriminering jämfört med dikotom poängsättning.
Du behöver inte delkredit överallt. Ett ordförrådstest med enskilda korrekta svar vinner ingenting på det och tillför bara poängsättningskomplexitet. Använd delkredit när uppgifter är genuint flerdels, när flervalsfrågor har fler än två rimliga val, eller när ett konstruerat svar kan delas upp i en rubrik med distinkta, bedömningsbara komponenter.
Vanliga metoder för poängsättning med delkredit
Ingen enskild formel vinner i alla sammanhang. Klassiska genomgångar av området katalogiserar ett antal metoder och finner konsekvent avvägningar snarare än en universell vinnare, så rätt val beror på uppgiftsformat och vad du försöker skydda mot – om det är gissningar, bedömares inkonsistens eller poängsättningens komplexitet i sig.
- Proportionell (antal rätt) poängsättning. Poäng motsvarar andelen korrekta val av totalt möjliga val. Enkelt att beräkna, lätt att förklara för studenter, men sårbart för manipulation på flersvarsuppgifter där att välja allt garanterar en baspoäng.
- Delmängdsvals-poängsättning (SS). Full poäng ges bara när exakt rätt delmängd väljs; delpoäng ges för delmängder som är korrekta matchningar av svarsnyckeln, med straffavdrag för inkluderade distraktorer. Bättre gissningskontroll än ren proportionell poängsättning, till kostnaden av en något mer komplex regel att förklara.
- Modifierade Zapechelnyuk-liknande funktioner. Dessa använder en matematiskt härledd straffstruktur utformad så att förväntat värde av blind gissning blir negativt, vilket direkt adresserar gissningsproblemet snarare än att bara tolerera det.
- Linjära straffmodeller. Poäng är lika med antalet korrekta val minus ett viktat antal felaktiga val. Justerbart genom att ändra straffvikten, vilket låter dig kalibrera hur aggressivt du vill avskräcka från för många val.
- Rubrikbaserad fraktionering. Konstruerade svar poängsätts mot en ordnad rubrik (0 till 4, till exempel), och konverteras sedan till en andel av uppgiftens totala poäng. Det här är standardmetoden för uppsatser, flerstegsmatematikproblem och laborationsrapporter.
Proportionell poängsättning passar flervals- och flerblankettuppgifter där formatet är enkelt och gissningsrisken är låg. Delmängdsvals- och linjära straffmodeller passar flersvarsuppgifter där distraktorer är tillräckligt attraktiva för att slumpmässiga val skulle kunna blåsa upp poängen. Rubrikbaserad fraktionering är verkligen det enda solida alternativet för öppna konstruerade svar, eftersom det inte finns något diskret "antal rätt" att dela.
Avvägningsmönstret är konsekvent över metoder: enklare formler (proportionell poängsättning) är enklast för studenter och lärare att förstå men svagast mot gissningar, medan straffbaserade metoder och delmängdsmetoder kontrollerar gissningar bättre men kräver tydligare instruktioner så att studenter förstår hur val viktas. Rubrikbaserad poängsättning bär en helt annan risk: bedömares inkonsistens, som ingen formel kan åtgärda på egen hand.
Hur man beräknar delkredit: bearbetade exempel
Formlerna ovan är värdelösa tills du kan köra siffrorna själv. Här är tre bearbetade exempel som du kan föra direkt in i ett kalkylblad.
1. Proportionell poängsättning på en fyra-alternativs flersvalsuppgift.
Anta att en uppgift har fyra korrekta alternativ av sex totala val, värt 4 poäng. En student väljer 3 av de 4 korrekta alternativen och 0 distraktorer.
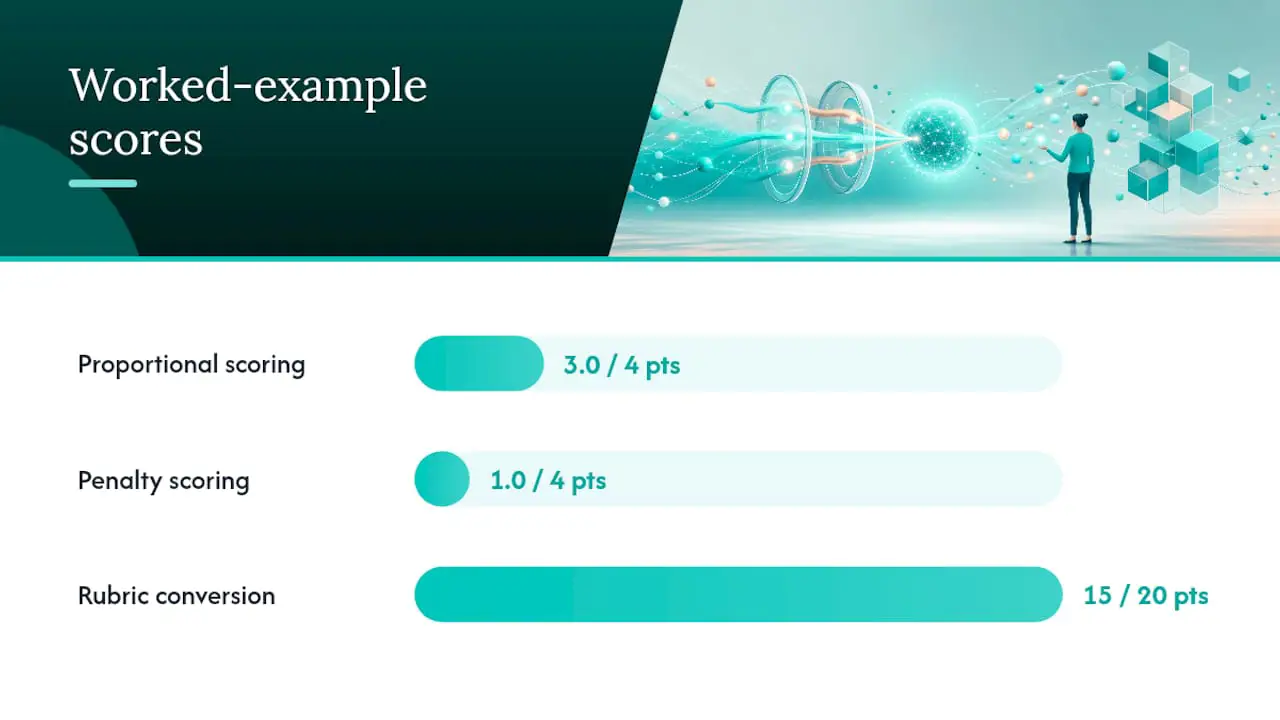
Poäng = (korrekta val / totalt korrekta alternativ) × uppgiftspoäng Poäng = (3 / 4) × 4 = 3,0 poäng
2. Delmängdsval med distraktorsstraffavdrag.
Samma uppgift: 4 korrekta alternativ, 2 distraktorer, 4 poäng totalt. Den här gången väljer studenten 3 korrekta alternativ och 1 distraktor.
Poäng = [(korrekta valda / totalt korrekta) − (valda distraktorer / totalt distraktorer)] × uppgiftspoäng, nedre gräns noll Poäng = [(3/4) − (1/2)] × 4 = [0,75 − 0,5] × 4 = 1,0 poäng
Jämför det med den rent proportionella metoden, som helt hade ignorerat distraktorn och tilldelat 3,0 poäng för identiskt svar. Den skillnaden är hela argumentet för straffbaserade metoder på uppgifter där distraktorer är genuint lockande.
3. Rubrik-till-fraktion-konvertering på en 20-poängsfråga.
Ett flerstegsmatematikproblem bedöms på en 0 till 4-rubrik: 0 (ingen giltig metod), 1 (korrekt uppställning enbart), 2 (korrekt metod, stort fel), 3 (korrekt metod, litet fel), 4 (helt korrekt). Frågan är värd 20 poäng totalt.
Fraktionerat poäng = (rubrikpoäng erhållna / max rubrikpoäng) × uppgiftspoäng En student som får 3 på rubriken får: (3/4) × 20 = 15 poäng
Kör den konverteringen över ett klassregister och du får en distribution som inte alls liknar ett enkelt procenträtt-histogram: poäng klustrar runt rubrikband (0, 5, 10, 15, 20) snarare än att spridas kontinuerligt, vilket är värt att veta innan du bygger en betygskurva kring det.
Proffstips: Bygg dessa tre formler som namngivna funktioner i en delad kalkylbladsmall innan examensfönstret öppnar. Att i efterhand anpassa en poängsättningsformel efter att studenter redan har lämnat in svar är där de flesta poängsättningstvister börjar.
Statistiska modeller och IRT: Rasch delkreditmodell
Fraktionerade poängsättningsformler svarar på frågan "hur många poäng förtjänade detta svar". Item response theory (IRT) svarar på en annan fråga: "hur mycket förmåga indikerar detta svar faktiskt, när vi tar hänsyn till hur svårt varje svarskategori är att nå". Denna distinktion spelar roll så snart du rör dig från betygsättning i ett enda klassrum till vilket sammanhang som helst där poäng behöver jämföras över formulär, kohorter eller år.
Rasch delkreditmodell, utvecklad av Geoff Masters, utvidgar den standardiserade dikotoma Rasch-modellen till uppgifter med ordnade svarskategorier. Istället för att behandla "steg 2 av 4" som helt enkelt värd hälften av "steg 4 av 4", uppskattar Rasch PCM en separat tröskelparameter för övergången mellan varje par av angränsande kategorier. Att gå från ett poäng på 1 till 2 på en rubrik kan kräva avsevärt mer demonstrerad förmåga än att gå från 2 till 3, och modellen fångar det istället för att anta att varje steg är lika.
Den praktiska vinsten är parameteravskiljbarhet: en examinands uppskattade förmåga och en uppgifts kategoritrösklar kan uppskattas oberoende av varandra, vilket är det som gör korsoformjämförelser statistiskt försvarsbara från första början.
När motiverar den tillkomna komplexiteten sin plats?
- Storskaliga testprogram, där tusentals svar behöver konsekvent tolkning över flera examsformulär.
- Länkning och utjämning, när olika grupper av studenter gör olika versioner av ett test och poäng måste betyda samma sak i varje version.
- Exakt uppgiftskalibrering, när du behöver veta exakt hur mycket förmåga som skiljer ett "2" från ett "3" på en rubrik, snarare än att anta lika avstånd.
- Kontroller för differentiell uppgiftsfunktion, där du behöver bekräfta att en uppgifts delkreditsteg beter sig konsekvent över demografiska grupper innan du litar på det aggregerade poänget.
Ett enskilt klassrumsquiz behöver nästan aldrig Rasch-kalibrering. Ett certifieringsexamen som administreras nationellt, återanvänds över testfönster och används för godkänd/underkänd-beslut med verkliga konsekvenser behöver det nästan alltid. Gränsen mellan "använd en kalkylbladsformel" och "använd IRT-programvara" handlar verkligen om insatser och skala, inte om uppgiftsformat.
Bästa praxis för implementering: design, konfiguration och rapportering
Att få delkredit rätt börjar långt innan någon student ser uppgiften, och det slutar inte när poängen genereras. Tre faser förtjänar genomtänkt uppmärksamhet: design, plattformskonfiguration och rapportering.
Designchecklista. Innan du skriver en enda uppgift, bestäm poängsättningsregeln – inte efter att pilotering avslöjat inkonsistens.
- Skriv rubriken eller poängallokeringsregeln samtidigt som du skriver uppgiften, inte efteråt.
- Använd en konsekvent poängskala över liknande uppgifter så att studenter kan förutsäga hur delkredit fördelas.
- Testa nya rubriker på ett litet urval av riktiga eller övningssvar innan du driftsätter dem i stor skala, och justera ankarbeskrivningar där två bedömare inte är överens.
- Definiera 3 till 5 ankarsvar per poängband för rubriker för konstruerade svar – en praxis som stöds av forskning om rubrikbaserad delkreditpoängsättning som rekommenderar att träna bedömare mot exempelskript för att nå acceptabel bedömarsamstämmighet.
LMS och plattformskonfiguration. De flesta lärplattformar gömmer inställningar för delkredit inuti alternativ på uppgiftsnivå snarare än examensnivåinställningar, så kontrollera varje frågetyp individuellt snarare än att anta att en global växel täcker allt. Bekräfta om feedback som visas för studenter visar det fraktionerade poänget, rubriknivån, eller båda, eftersom att bara visa ett avrundat totalt kan dölja exakt var poäng förlorades. Exportera råa, orundade poängdata när det är möjligt. Att runda tidigt och räkna om senare är ett av de snabbaste sätten att introducera tysta bedömningsfel över ett stort register.
Rapportering. Rapportera både det råa fraktionerade poänget och det rundade totalet, och säg det uttryckligen i vilket poängrapport som når studenten. En student som ser "15/20" utan kontext har inget sätt att veta om de förlorade 5 poäng på ett stort fel eller flera små. En enrads förklaring av hur delkredit beräknades, bifogad poängrapporten, löser de flesta tvister innan de börjar. Team som bygger ut bedömningsrubriker för strukturerade bedömningar kan hitta ytterligare vägledning och mallar för rubrikdesign som direkt kompletterar fraktionerade poängsättningsmetoder.
Tillförlitlighet, validitet och gissningssuppression
Tillförlitlighet är den fråga som avgör om delkredit var värt den tillkomna komplexiteten. Om en poängsättningsändring inte mätbart förbättrar din bedömnings konsistens är den extra bedömarträningen och beräkningsomkostnaden svår att motivera.
Den empiriska dokumentationen lutar gynnsamt här. Jämförande studier av poängsättningsmetoder på flersvarsuppgifter fann att delkreditmetoder förbättrade tillförlitlighet och diskriminering jämfört med enkel dikotom poängsättning, särskilt för uppgifter med fler än två svarsalternativ där en rätt/fel-uppdelning kastar bort meningsfull variation. Separat fann teoretiskt arbete om poängsättningsfunktioner utformade kring negativt förväntat gissningsvärde att dessa funktioner tenderar att förbättra både tillförlitlighet och diskriminerande kraft jämfört med vanlig rätt-eller-fel-poängsättning, särskilt när ett gissningsstraffavdrag är inbyggt.
Tre praktiska kontroller berättar om bytet lönar sig i dina egna data:
Uppgifts-totalkorrelation. Räkna om den efter att ha bytt till delkredit. En uppgift vars korrelation med totalpoänget förbättras gör nu ett bättre jobb med att separera starka prestationer från svaga under den nya poängsättningsregeln.
Cronbachs alfa före och efter. Kör samma testdataset genom båda poängsättningsreglerna och jämför alfavärden direkt. En meningsfull ökning är en stark signal att delkredit fångade information som den binära versionen kastade bort.
IRT-anpassningsstatistik, där en Rasch eller annan IRT-modell redan används. Kategoritrösklar som kommer ut oordnade – det vill säga ett högre rubrikpoäng inte motsvarar en högre uppskattad förmåga – flaggar en rubrik som behöver revideras oavsett vad de råa tillförlitlighetssiffrorna säger.
Inget av detta är gratis. Poängsättningens komplexitet ökar med varje tillagd formelvariant, bedömarvariabilitet blir ett levande problem i det ögonblick du introducerar en rubrikbaserad komponent, och administrativ kostnad ökar när du behöver programvara eller kalkylbladsinfrastruktur bortom en enkel svarsnyckel. Väg dessa kostnader mot dina faktiska insatser. Ett veckoquiz motiverar sällan omkostnaden; ett certifieringsexamen gör det nästan alltid.
Poängsättningsmallar för flersvarsuppgifter
Flersvarsuppgifter – där en student väljer flera alternativ från en längre lista – är där gissningar gör störst skada på ett tests validitet. En student som väljer alla alternativ på en "välj alla som stämmer"-uppgift med fyra korrekta svar av sex val får alltid delpoäng under naiv proportionell poängsättning, oavsett om de kan något eller inte.
Lösningen är en poängsättningsmall byggd kring förväntat värde. En vanlig struktur: tilldela p1 poäng när studenten väljer exakt nyckeln (hela den korrekta uppsättningen), eller i vissa formuleringar när varje distraktor korrekt utesluts; annars tillämpa en pc − m-formel, där pc är andelen korrekt och m är ett straffavdrag skalat till val utanför nyckeln. Målet, som formell forskning om poängsättningsfunktioner fastslår, är att se till att matematiken i sig avskräcker från sorglöst överval.
- Dimensionera straffavdraget (m) så att förväntat värde av att välja alla alternativ, eller välja slumpmässigt, blir negativt eller i värsta fall noll.
- Testa ditt straffavdrag mot ett "välj allt"-svar innan du driftsätter uppgiften. Om det svaret ger poäng över noll är straffavdraget för litet.
- Testa det också mot ett genuint ärligt partiellt kunskapssvar. Om en student korrekt identifierar 3 av 4 korrekta alternativ och utesluter båda distraktorer men ändå får sämre poäng än någon som gissade brett, är straffavdraget för stort.
Uppgiftsformuleringar spelar lika stor roll som formeln bakom det. Instruktioner som lyder "välj alla korrekta svar" utan vägledning om straffavdrag driver studenter mot gissningar, eftersom det inte finns någon nedsidesignal i formuleringen. Lägg till en kort rad som anger att felaktiga val minskar poängen, så får du mer ärlig rapportering av partiell kunskap, eftersom studenter inte längre har incitament att välja alternativ de är osäkra på bara för att säkra sig.
Checklista för styrning av utövare innan du skalar upp
Innan du rullar ut delkredit bortom en pilotgrupp, kör dessa fyra kontroller:
- Rubrikklarhet. Bekräfta att varje rubrknivå har en distinkt, observerbar ankarbeskrivning – inte bara en vag etikett som "mestadels korrekt".
- Bedömarsamstämmighet. Låt två bedömare oberoende av varandra poängsätta samma 20 till 30 exempelsvar och kontrollera samstämmigheten innan du litar på en enskild bedömares poäng i stor skala.
- Pilotjämförelse. Poängsätt samma uppsättning svar under både den gamla poängsättningsregeln och den nya delkreditregeln, och jämför tillförlitlighet och betygsfördelning sida vid sida.
- Känslighetsanalys. Justera dina straffvikter eller poängallokeringar något och kör analysen på nytt. Vägledning för poängsättningsmodeller rekommenderar detta steg eftersom små viktförändringar kan vända tillförlitlighetsresultat eller helt omrangordna kandidater.
Dokumentera varje poängsättningsbeslut – inklusive varför en viss formel eller ett visst straffavdrag valdes – i ett format som intressenter kan granska senare. Det är den dokumentationen som förvandlar en försvarbar pilot till en försvarbar policy.
När delkredit motiverar sin komplexitet
Delkredit är en mätningsuppgradering med en verklig administrativ prislapp, och att låtsas annat gör en björntjänst åt alla som piloterar det för första gången. Vinsten i tillförlitlighet och diskriminering är väl dokumenterad, men så är den tillkomna bördan: mer bedömarträning, mer komplexa formler, mer utrymme för oenighet om vad "partiell" faktiskt betyder på en given uppgift.
Min ärliga läsning av forskningen är att de flesta klassrumsbedömningar inte behöver Rasch-kalibrering, delmängdsvals-straffavdrag eller någon av de mer elaborerade mekanismer som täcks ovan. En tydlig rubrik och proportionell fraktionering täcker de flesta verkliga klassrumsbehov. Där delkredit motiverar sin komplexitet är i stor skala: certifieringsexamina, flerfomulär-testprogram och alla bedömningar där ett felaktigt poängsättningsantagande förstärks över tusentals testdeltagare istället för trettio.
Den operativa bördan är exakt där goda plattformsverktyg förändrar kalkylen, särskilt om du vill automatisera global rekrytering och minska efterlevnadsrisker. Ett verktyg som automatiserar rubriktillämpning, spårar bedömningskonsistens och loggar poängsättningsbeslut tar bort det mesta av friktionen som hindrar lärare från att pilottera delkredit överhuvudtaget. Pilota först, mät tillförlitlighetsvinsten mot den tillkomna kostnaden, och skala bara upp metoden när siffrorna faktiskt motiverar det.
— Jimmie
Bygg delkreditbedömningar utan att bygga infrastrukturen själv
Det mesta av friktionen i poängsättning med delkredit är inte matematiken. Det är infrastrukturen: att skriva konsekventa rubriker, hålla bedömare i linje och lita på att ingen manipulerade testet. Talent Approved är byggt kring en betala-per-användning-modell utan prenumeration, så du betalar bara per genomförd kandidatbedömning och slipper omkostnaden för att licensiera poängsättningsprogramvara du kanske bara behöver ibland.
Plattformens Magic Create-funktion bygger en rollspecifik, rubrikfärdig bedömning direkt från en jobbeskrivning eller kompetenslista, vilket tar bort den manuella uppgiftsskrivningsfasen helt. Inbyggda fuskskyddsverktyg, inklusive skärm- och webbkameraövervakning med sessionsuppspelningar, skyddar integriteten hos delkreditresultat på samma sätt som bedömarträning skyddar en rubrik för konstruerade svar. AI-genererade prestandasammanfattningar omvandlar fraktionerade poäng till läsbara kandidatrankningar utan att ditt team behöver tolka rå rubrikmatematik för hand.
Om du utvärderar kompetenser snarare än betygsätter studenter, och vill ha delkreditliknande poängsättning utan att äga poängsättningsinfrastrukturen, kolla prissättningssidan för kompetensbedömningar och se vad en pilotbedömning skulle kosta för din nästa rekryteringsomgång.
Källor
- Evaluating Different Scoring Methods for Multiple Response Items Providing Partial Credit
- Theoretical evaluation of partial credit scoring of the multiple-choice test item
- Partial-Credit Scoring Methods for Multiple-Choice Tests. - ERIC
FAQ
Hur beräknar man delkredit?
Dela poängen som tjänades (korrekta val, rubriknivå eller delmängdsmatchning) med de maximalt möjliga poängen för den uppgiften, multiplicera sedan med uppgiftens totala poängvärde. Delmängdsvals- och linjära straffmetoder subtraherar ett viktat straffavdrag för felaktiga val innan den slutliga multiplikationen.
Vad är de tre huvudtyperna av poängsättningsmetoder?
Inom bedömningsdesign är de tre breda metoderna dikotom (rätt/fel) poängsättning, poängsättning med delkredit (proportionella, delmängdsvals- eller straffbaserade formler) och rubrikbaserad fraktionell poängsättning för konstruerade svar. Var och en passar olika uppgiftsformat, och ingen enskild metod är överlägsen i alla sammanhang.
Vad underminerar oftast ett system för poängsättning med delkredit?
Oklara rubrikankare och inkonsekvent bedömarträning är de vanligaste bristpunkterna, eftersom de introducerar oenighet mellan bedömare som ingen formel kan korrigera i efterhand. En nära tvåa är ett straffavdrag dimensionerat för litet, vilket lämnar slumpmässig gissning statistiskt lönsam istället för undertryckt.
Förbättrar delkredit faktiskt testets tillförlitlighet?
Empiriska jämförelser på flersvarsuppgifter fann att poängsättning med delkredit förbättrade både tillförlitlighet och diskriminering jämfört med dikotom poängsättning, särskilt när poängsättningsfunktionen straffar felaktiga val. Vinsten är inte automatisk. Den beror på rubriklarhet och straffavdragsdimensionering.
Kan en plattform hantera poängsättning med delkredit för kompetensbedömningar?
Ja. Talent Approved stöder rubrikbaserad poängsättning vid sidan av sin Magic Create-bedömningsbyggare och fuskskyddsövervakning, vilket låter rekryteringsteam tillämpa fraktionell poängsättningslogik utan att bygga beräkningsinfrastrukturen själva. Aktuell prissättning listas på sidan för kompetensbedömningar.