
Las evaluaciones en línea de libro abierto predicen los resultados a 90 días para los equipos de contratación
Las evaluaciones en línea de libro abierto son pruebas programadas, específicas para cada puesto y realizadas de forma remota, en las que los candidatos pueden consultar recursos que usarían de manera realista en el trabajo, como documentación, hojas de cálculo o herramientas de búsqueda. Funcionan mejor cuando el puesto en sí requiere investigación, criterio o uso de herramientas, y fallan rotundamente en roles de cumplimiento normativo, seguridad o acreditación, donde el objetivo es evaluar el conocimiento sin ayuda. Algunas plataformas ofrecen herramientas que crean estas pruebas directamente a partir de una descripción de puesto en cuestión de minutos.
Resumen:
- Las evaluaciones de libro abierto son más adecuadas para puestos que requieren el uso de investigación, documentación o herramientas, y son menos apropiadas para cargos de seguridad o cumplimiento donde la memorización importa.
- El modo de entrega debe depender de las exigencias del puesto: las evaluaciones sin supervisión favorecen el cribado de alto volumen y las pruebas supervisadas son necesarias para roles que requieren una validación estricta.
- El diseño de evaluaciones válidas implica un análisis del puesto, el uso de tareas breves y específicas para el rol, la redacción de rúbricas antes de recibir las respuestas de los candidatos y la calibración de las puntuaciones de los evaluadores para garantizar equidad y precisión predictiva.
- Las medidas antitrampa, como la supervisión por cámara web y las repeticiones de sesión, deben ser transparentes, contar con el consentimiento del candidato y equilibrarse con adaptaciones de accesibilidad para evitar sesgos.
- Las puntuaciones de las evaluaciones deben complementar las entrevistas estructuradas y los datos de rendimiento, con seguimientos periódicos para validar y mejorar el poder predictivo del proceso de evaluación.
Tabla de contenidos
- Qué significan las evaluaciones en línea de libro abierto para los equipos de selección
- Libro abierto vs. supervisada: cómo elegir
- Cómo crear una evaluación de libro abierto válida: reglas de diseño que resisten el análisis
- Antitrampa, privacidad y equidad en las evaluaciones remotas
- Cómo convertir las puntuaciones de las evaluaciones en decisiones de contratación
- Por qué las rúbricas importan más que la prueba en sí
- Comienza con las evaluaciones de habilidades de Talent Approved
- Fuentes
- Preguntas frecuentes
Qué significan las evaluaciones en línea de libro abierto para los equipos de selección
Olvida la versión escolar de este término. En el ámbito de la contratación, una evaluación en línea de libro abierto es una tarea puntuada y específica para el puesto en la que los candidatos utilizan los recursos que tendrían disponibles en el trabajo real. Aquí no se evalúan datos memorizados de forma trivial. El objetivo es la capacidad, no la memoria.
La entrega se presenta en tres variantes, cada una con ventajas e inconvenientes reales:
- Libro abierto sin supervisión: los candidatos trabajan de forma independiente con acceso completo a los recursos. Es la más rápida de implementar, genera menos fricción y ofrece la mejor experiencia al candidato.
- Supervisada de forma remota: la cámara web y el monitoreo de pantalla registran la sesión. Es más adecuada para roles donde el rendimiento sin ayuda importa.
- Híbrida: recursos abiertos para las tareas de investigación y navegador bloqueado para segmentos específicos. Es habitual en pruebas técnicas donde parte de la tarea evalúa la habilidad pura y otra parte evalúa la resolución de problemas.
La mayoría de las evaluaciones bien diseñadas duran entre 30 y 90 minutos, según la guía de estructura para pruebas de habilidades en contratación remota. Establecer límites de tiempo es tan importante para la equidad como para la logística. Una tarea sin un límite de tiempo claro premia a los candidatos que invierten un tiempo excesivo en algo que debería llevar considerablemente menos, lo que mide el tiempo libre, no la habilidad.
Libro abierto vs. supervisada: cómo elegir
El modo de entrega debe seguir directamente lo que el puesto exige en la práctica, no la configuración predeterminada de tu herramienta de evaluación.
- Elige libro abierto cuando la tarea refleje el trabajo real. Si el puesto implica depurar código con la documentación abierta, escribir con una guía de estilo a mano o analizar datos con una calculadora, evaluar a los candidatos sin esas herramientas mide lo equivocado.
- Elige supervisada o libro cerrado para roles de cumplimiento y seguridad. Los puestos donde una respuesta incorrecta sin ayuda indica una brecha real —juicio clínico, controles financieros, operaciones de seguridad críticas— requieren controles más estrictos. Los grandes sistemas de contratación del sector público reservan las evaluaciones supervisadas específicamente para roles que exigen una estricta validación y fiabilidad.
- Ten en cuenta el volumen y la experiencia del candidato. Las evaluaciones de libro abierto escalan más fácilmente en situaciones de alto volumen de candidatos porque requieren menos configuración, ninguna infraestructura de supervisión y menos fricción para el candidato, lo que importa cuando estás evaluando a cientos de solicitantes para una única vacante.
Elegir mal en cualquier dirección tiene un coste. Supervisar un puesto que no lo necesitaba ahuyenta a candidatos fuertes que lo perciben como invasivo. Omitir la supervisión en un puesto donde la habilidad sin ayuda importa te deja con puntuaciones ruidosas e infladas.
Cómo crear una evaluación de libro abierto válida: reglas de diseño que resisten el análisis
Toda evaluación fiable comienza antes de redactar una sola pregunta. El análisis del puesto —el mapeo de las tareas y resultados reales que el rol exige— es la base, según la guía de procesos de contratación basada en evidencia. Si omites este paso, estarás evaluando a los candidatos en habilidades que no predicen el rendimiento.
A partir de ahí, cuatro reglas de diseño separan las evaluaciones que realmente funcionan de las que simplemente tienen buena apariencia:
- Usa muestras de trabajo breves y reales para el puesto. Una tarea que refleja los primeros 90 días probables del candidato supera a un ejercicio genérico en todo momento. Las guías de diseño práctico señalan las muestras estandarizadas puntuadas con rúbricas predefinidas como el formato más predictivo.
- Establece un límite de tiempo para cada tarea. Mantén el tiempo del candidato en un rango razonable —generalmente entre 30 y 90 minutos— y nunca asignes trabajo de producción no remunerado disfrazado de "prueba".
- Redacta tu rúbrica antes de ver una sola respuesta. Los criterios de puntuación decididos después de revisar a los candidatos invitan al sesgo —incluso al sesgo no intencionado— hacia quien haya escrito la respuesta que suene más impresionante.
- Calibra a los evaluadores entre sí. Dos responsables de contratación que puntúen la misma respuesta deberían diferir en un punto o dos, no en tres niveles.
El lenguaje de la rúbrica importa tanto como su estructura. La guía sobre comportamientos observados recomienda criterios específicos y observables frente a etiquetas vagas. "Buen comunicador" no le dice nada útil a un evaluador. "Explica las ventajas y desventajas técnicas en lenguaje sencillo en dos frases" le da a cada evaluador el mismo baremo. Herramientas como las plantillas de evaluación de Talent Approved ayudan a estandarizar esto entre familias de puestos, de modo que una rúbrica redactada para una vacante no tenga que construirse desde cero para la siguiente.
Consejo profesional: Prueba tu rúbrica con dos o tres respuestas de muestra antes de abrir la evaluación a candidatos reales. Si tus evaluadores no coinciden en las puntuaciones, la rúbrica necesita trabajo, no los candidatos.
Para profundizar en cómo elegir qué habilidades evaluar, comienza por los resultados que el puesto necesita producir y trabaja hacia atrás hasta la tarea que los revela.
Antitrampa, privacidad y equidad en las evaluaciones remotas
La entrega en formato de libro abierto sigue necesitando salvaguardas. Los recursos están permitidos, pero la identidad de la persona que realiza la prueba y la integridad de su trabajo no son opcionales.
Las herramientas antitrampa habituales conllevan compromisos de privacidad reales que los candidatos merecen conocer de antemano:
- Los bloqueos de navegador restringen el cambio de pestañas durante los segmentos cronometrados; informa de esto antes de que comience la sesión, no después.
- La supervisión por cámara web confirma que la persona que realiza la prueba coincide con el solicitante; siempre requiere un lenguaje de consentimiento claro, no una casilla enterrada en el formulario.
- La repetición de sesión permite a los evaluadores ver cómo un candidato resolvió un problema —valioso para detectar ayuda externa— pero debe limitarse a la revisión relacionada con la contratación y no al almacenamiento indefinido.
La accesibilidad no puede ser algo añadido como complemento del diseño antitrampa. Ofrece formatos alternativos, tiempo extendido como opción de adaptación estándar, y un proceso de solicitud que no obligue al candidato a explicar un diagnóstico en un campo de formulario. Evita la jerga. "Solicitar una adaptación" es mejor que un menú desplegable lleno de terminología clínica.
Cada decisión automatizada necesita un registro exportable: quién realizó la prueba, cuándo, qué señaló el sistema y qué revisó un humano antes de cualquier rechazo de alto impacto. La guía de SHRM sobre contratación basada en habilidades es directa en este punto: combinar evaluaciones de habilidades con evaluación ciega amplía el grupo de talento y reduce el sesgo, pero las evaluaciones por sí solas no lo eliminan. La revisión humana sigue siendo el último recurso.
La recompensa predictiva es real. Fast Company informa que el 90% de los empleadores que utilizan evaluaciones basadas en habilidades observaron una reducción en las contrataciones incorrectas, y el 91% reportó una mejora en la retención. Ese es el retorno de hacer bien el trabajo de diseño.
Cómo convertir las puntuaciones de las evaluaciones en decisiones de contratación
Una puntuación es un dato, no un veredicto. Trátala así y tu proceso de contratación será más rápido y más preciso al mismo tiempo.
- Combina las puntuaciones de la evaluación con entrevistas estructuradas y comprobaciones de referencias. Ninguna fuente de evidencia única debería sostener una decisión de contratación por sí sola, según la guía sobre el uso de los resultados de las evaluaciones. Construye una matriz de decisión documentada que pondere cada aportación antes de que nadie empiece a comparar candidatos.
- Pide a los evaluadores que puntúen de forma independiente antes del debate en grupo. El sesgo de anclaje aparece rápidamente en cuanto un evaluador expresa una opinión en voz alta.
- Realiza seguimientos a los 30 y 90 días. Compara las puntuaciones de la evaluación con el rendimiento real en el puesto para validar tu rúbrica y luego revísala. Aquí es donde la mayoría de los equipos de contratación se detienen, y es el paso que realmente demuestra que la evaluación funciona.
- Automatiza el cribado, no el juicio. Los resúmenes generados por IA y los flujos de trabajo de evaluación rápida de candidatos aceleran la revisión en volumen, pero la decisión final sobre los candidatos en el límite debe seguir en manos de una persona.
Las evaluaciones realizadas justo después de un cribado inicial de currículum y una primera entrevista estructurada —no antes— concentran el tiempo del evaluador en candidatos que ya han superado un primer filtro, respetando el tiempo de todos en el proceso.
Por qué las rúbricas importan más que la prueba en sí
La mayoría de los equipos de contratación se obsesionan con la pregunta de la evaluación y apenas prestan atención a la rúbrica que la puntúa. Eso es al revés. La pregunta es solo el mecanismo de entrega. La rúbrica es lo que hace que el resultado sea defendible, comparable entre candidatos y útil tres meses después cuando alguien pregunta por qué se rechazó a un candidato.
Yo diría que el mayor error en el diseño de evaluaciones de libro abierto no es elegir el modo de entrega equivocado, sino omitir el análisis del puesto y redactar una tarea genérica porque es más rápido. Un ejercicio de codificación genérico o un ejemplo de redacción predefinido no te dice casi nada sobre cómo se desempeñará alguien en tu puesto específico. Algunas soluciones utilizan IA para generar evaluaciones vinculadas a lo que el puesto realmente requiere en lugar de una plantilla estándar. Combinar eso con resúmenes generados por IA y supervisión antitrampa ayuda a los evaluadores a concentrar su tiempo en las decisiones de juicio, no en la limpieza administrativa.
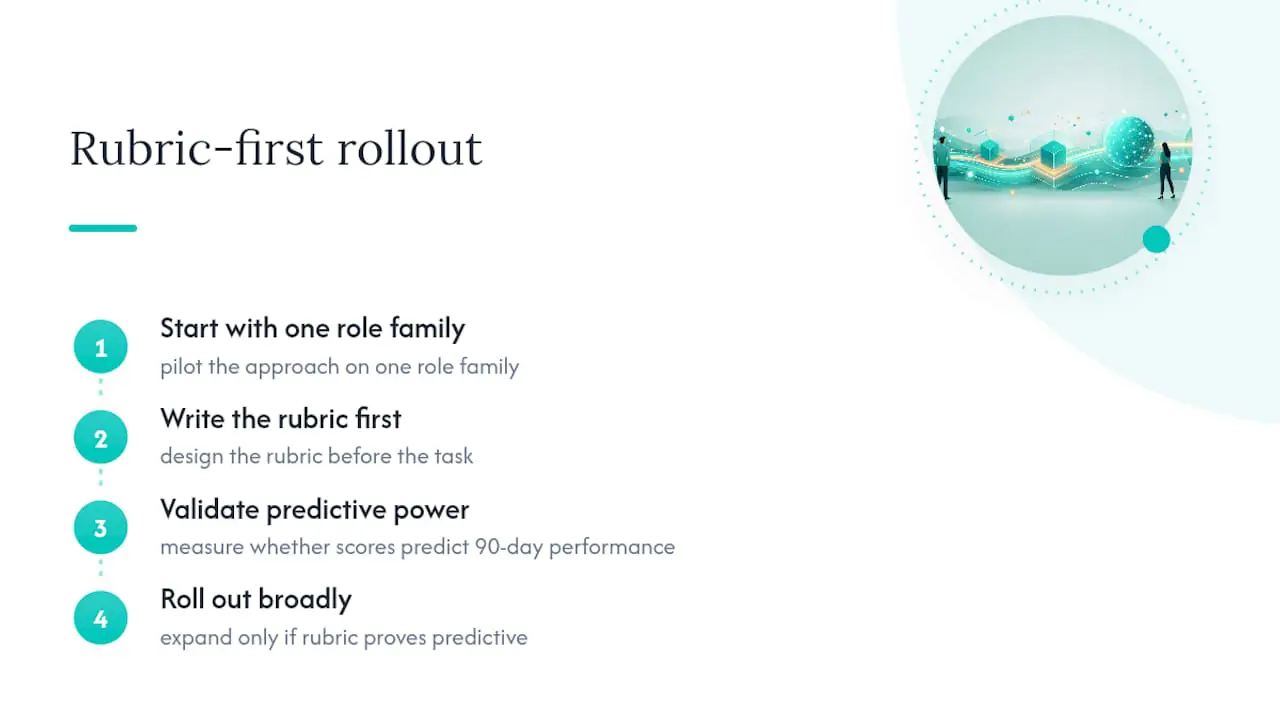
Empieza con una familia de puestos. Redacta primero la rúbrica. Mide si las puntuaciones predicen el rendimiento a los 90 días antes de extender el enfoque al resto.
— Jimmie
Comienza con las evaluaciones de habilidades de Talent Approved
Existen plataformas diseñadas para el flujo de trabajo que describe este artículo: evaluaciones específicas para cada puesto, generadas rápidamente y puntuadas de forma coherente. Algunas herramientas pueden convertir una descripción de puesto en una muestra de trabajo a medida y con límite de tiempo en cuestión de minutos, evitando la necesidad de reutilizar plantillas genéricas para cada vacante abierta.
La supervisión antitrampa y los resúmenes de candidatos generados por IA se encargan del trabajo pesado en la revisión, permitiendo que tu equipo se centre en las decisiones de juicio que realmente requieren una persona. Como el precio es de pago por uso a 5 $ por candidato completado, no hay ningún compromiso de suscripción pendiente en tus cuentas entre ciclos de contratación. Si deseas registros de validez listos para auditoría vinculados a cada evaluación que realice tu equipo, eso está integrado en la misma tarifa de 5 $. Consulta la página de precios y realiza tu primera evaluación en una vacante abierta hoy mismo.
Fuentes
- Habilidades sobre títulos: el futuro de la contratación y el crecimiento organizacional — Fast Company
- Contratación basada en habilidades: construir equipos más sólidos con evaluaciones ciegas — SHRM
- Proceso de contratación: una guía basada en evidencia — ScientificHiring
- Cómo estructurar una evaluación de habilidades para contrataciones remotas — Claude Library
Preguntas frecuentes
¿Qué es una evaluación en línea de libro abierto en el proceso de contratación?
Es una prueba cronometrada y específica para el puesto que se realiza de forma remota, en la que los candidatos pueden utilizar recursos como documentación o herramientas de investigación, reflejando cómo realizarían el trabajo en la práctica. Mide la habilidad aplicada en lugar del conocimiento memorizado.
¿Cuánto tiempo debe durar una evaluación de candidatos?
La mayoría de las evaluaciones bien diseñadas duran entre 30 y 90 minutos. Las tareas más largas generan preocupaciones sobre trabajo no remunerado y tasas de finalización más bajas sin mejorar la precisión predictiva.
¿Cuándo debo usar una prueba supervisada en lugar de una de libro abierto?
Elige la entrega supervisada para roles de cumplimiento normativo, seguridad o acreditación donde el rendimiento sin ayuda es la habilidad real que se mide. El libro abierto funciona mejor cuando el puesto en sí implica investigación, documentación o uso de herramientas.
¿Las pruebas de libro abierto aumentan el riesgo de trampa?
Desplazan el riesgo en lugar de eliminarlo, por eso existen la supervisión por cámara web, la repetición de sesión y los bloqueos de navegador como capas opcionales. El consentimiento y la divulgación claros antes de la sesión importan tanto como las propias herramientas.
¿Cuánto cuesta Talent Approved por evaluación?
Talent Approved cobra 5 $ por evaluación de candidato completada, sin necesidad de suscripción. Solo pagas cuando un candidato termina la prueba.
Recomendado
- Gestionar evaluaciones de contratación de alto volumen: un manual para 2026
- Cómo capacitar a los responsables de contratación para usar evaluaciones
- Cómo funcionan las evaluaciones instantáneas para los equipos de contratación
- Equipos de contratación: 5 pasos hacia una analítica de evaluación orientada a la medición