
Öppna Online-Bedömningar Förutsäger 90-Dagarsresultat för Rekryteringsteam
Öppna onlinebedömningar är tidsbegränsade, rollspecifika tester som genomförs på distans, där kandidater får använda resurser de realistiskt sett skulle använda i jobbet – som dokumentation, kalkylblad eller sökverktyg. De fungerar bäst när rollen i sig kräver research, omdöme eller verktygsanvändning, och misslyckas rejält för efterlevnads-, säkerhets- eller behörighetsroller där poängen är att testa oassisterat minne. Vissa plattformar erbjuder verktyg som bygger dessa tester direkt från en jobbbeskrivning på några minuter.
TL;DR:
- Öppna bedömningar är mest lämpliga för roller som kräver research, dokumentation eller verktygsanvändning, och är mindre lämpliga för säkerhets- eller efterlevnadspositioner där minnesförmåga spelar roll.
- Leveranssättet bör bero på jobbkraven, där oproctorerade bedömningar gynnar storskalig screening och proctorerade tester är nödvändiga för roller som kräver strikt validering.
- Att utforma giltiga bedömningar innebär jobbanalys, användning av korta rollspecifika uppgifter, att skriva rubriker innan kandidatinlämningar och att kalibrera bedömarpoäng för att säkerställa rättvisa och prediktiv noggrannhet.
- Anti-fusk-åtgärder som webbkameraövervakning och sessionsuppspelningar bör vara transparenta, godkännas av kandidaterna och balanseras med tillgänglighetsanpassningar för att förhindra bias.
- Bedömningspoäng bör komplettera strukturerade intervjuer och prestandadata, med regelbunden uppföljning för att validera och förbättra utvärderingsprocessens prediktiva kraft.
Innehållsförteckning
- Vad öppna onlinebedömningar betyder för rekryteringsteam
- Öppen bok vs. proctorerat: Hur du väljer
- Att bygga en giltig öppen bedömning: Designregler som håller
- Anti-fusk, integritet och rättvisa i distansbedömningar
- Att omvandla bedömningspoäng till anställningsbeslut
- Varför rubriker spelar större roll än testet i sig
- Kom igång med Talent Approveds kompetensbedömningar
- Källor
- Vanliga frågor
Vad öppna onlinebedömningar betyder för rekryteringsteam
Glöm klassrumsversionen av begreppet. I rekryteringssammanhang är en öppen onlinebedömning en poängsatt, rollspecifik uppgift där kandidater använder vilka resurser som helst som de skulle ha i det faktiska jobbet. Det finns inget test av memorerade fakta här. Målet är kompetens, inte minnesförmåga.
Leveransen finns i tre varianter, var och en med verkliga avvägningar:
- Öppen bok, oproctorerad: Kandidater arbetar självständigt med full tillgång till resurser. Snabbast att driftsätta, lägst friktion, bäst kandidatupplevelse.
- Fjärrproctorerad: Webbkamera och skärmövervakning spårar sessionen. Bättre för roller där oassisterad prestation spelar roll.
- Hybrid: Öppna resurser för researchtuppgifter, låst webbläsare för specifika segment. Vanligt i tekniska urvalstester där en del av uppgiften testar ren kompetens och en del testar problemlösning.
De flesta väldesignade bedömningar tar 30 till 90 minuter, enligt struktureringsvägledning för kompetensbedömningar vid distansrekrytering. Tidsbegränsning spelar roll för rättvisa lika mycket som för logistik. En uppgift utan tydlig tidsgräns belönar kandidater som lägger överdrivet mycket tid på en uppgift som borde ta avsevärt kortare tid, vilket mäter fritid, inte kompetens.
Öppen bok vs. proctorerat: Hur du väljer
Leveranssättet bör direkt följa vad jobbet faktiskt kräver, inte vilket standardläge ditt bedömningsverktyg har.
- Välj öppen bok när uppgiften speglar verkligt arbete. Om jobbet innebär felsökning med dokumentation öppen, skrivande med en stilguide till hands eller dataanalys med en kalkylator, mäter man fel sak om man testar kandidater utan dessa verktyg.
- Välj proctorerat eller stängd bok för efterlevnads- och säkerhetsroller. Positioner där ett felaktigt oassisterat svar signalerar en verklig brist – kliniskt omdöme, finansiell kontroll, säkerhetskritiska operationer – behöver striktare kontroller. Stora offentliga rekryteringssystem reserverar proctorerade bedömningar specifikt för roller som kräver strikt validering och tillförlitlighet.
- Ta hänsyn till volym och kandidatupplevelse. Öppna bedömningar skalas enklare vid hög sökandeволym eftersom de kräver mindre förberedelse, ingen proctoringsinfrastruktur och mindre kandidatfriktionon – vilket spelar roll när du screener hundratals sökande till en enda tjänst.
Fel val i endera riktningen kostar dig. Att proctora en roll som aldrig behövde det skrämmer bort starka kandidater som uppfattar det som intrång. Att hoppa över proctoring för en roll där oassisterad kompetens spelar roll ger dig brusiga, uppblåsta poäng.
Att bygga en giltig öppen bedömning: Designregler som håller
Varje tillförlitlig bedömning börjar innan du skriver en enda fråga. Jobbanalys – att kartlägga de faktiska uppgifter och resultat som rollen kräver – är grunden, enligt evidensbaserad vägledning för rekryteringsprocessen. Hoppa över det här steget och du testar kandidater på kompetenser som inte förutsäger prestation.
Därifrån separerar fyra designregler bedömningar som faktiskt fungerar från sådana som bara ser bra ut:
- Använd korta, jobbrealistiska arbetsprover. En uppgift som speglar kandidatens troliga första 90 dagar slår ett generiskt pussel varje gång. Praktisk designvägledning pekar på standardiserade prover som poängsätts mot förskrivna rubriker som det mest prediktiva formatet.
- Tidsbegränsa varje uppgift. Håll kandidatens tid rimlig – generellt 30 till 90 minuter – och tilldela aldrig oavlönat produktionsarbete förklädda till ett "test."
- Skriv din rubrik innan du ser en enda inlämning. Bedömningskriterier som beslutas efter granskning av kandidater inbjuder till bias – till och med oavsiktlig bias – mot den som skrev det mest imponerande klingande svaret.
- Kalibrera bedömare mot varandra. Två rekryteringschefer som poängsätter samma inlämning bör landa inom ett poäng eller två, inte tre nivåer ifrån varandra.
Rubrikens språk spelar lika stor roll som rubrikens struktur. Vägledning om observerade beteenden rekommenderar specifika, observerbara kriterier framför vaga etiketter. "Skicklig kommunikatör" ger inte en bedömare någon handlingsbar information. "Förklarar tekniska avvägningar på enkelt språk inom två meningar" ger varje bedömare samma måttstock. Verktyg som Talent Approveds bedömningsmallar hjälper till att standardisera detta över rollgrupper så att en rubrik skriven för en tjänst inte behöver byggas om från grunden för nästa.
Proffstips: Pilottesta din rubrik på två eller tre exempelinlämningar innan du öppnar bedömningen för riktiga kandidater. Om dina bedömare är oense om poäng behöver rubriken arbetas om, inte kandidaterna.
För en djupare titt på att välja vilka kompetenser att testa, börja från de resultat rollen behöver producera och arbeta sedan bakåt till uppgiften som avslöjar dem.
Anti-fusk, integritet och rättvisa i distansbedömningar
Öppen boksleverans behöver fortfarande skyddsräcken. Resurserna är tillåtna, men identiteten hos personen som genomför testet och integriteten i deras arbete är inte valfria.
Vanliga anti-fusk-verktyg medför verkliga integritetsavvägningar som kandidater förtjänar att veta om i förväg:
- Webbläsarlåsning begränsar flikbyte under tidsbegränsade segment; informera om detta innan sessionen börjar, inte efteråt.
- Webbkameraövervakning bekräftar att personen som genomför testet matchar sökanden; kräver alltid tydligt samtyckessspråk, inte en dold kryssruta.
- Sessionsuppspelning låter bedömare se hur en kandidat arbetade sig igenom ett problem – värdefullt för att fånga extern hjälp – men bör begränsas till rekryteringsrelevant granskning, inte obegränsad lagring.
Tillgänglighet kan inte vara en eftertanke som skruvats fast på anti-fusk-designen. Erbjud alternativa format, förlängd tid som ett standardanpassningsalternativ och en ansökningsprocess som inte kräver att en kandidat förklarar en diagnos i ett formulärfält. Undvik fackspråk. "Begär en anpassning" slår en rullgardinsmeny full av klinisk terminologi.
Varje automatiserat beslut behöver ett exporterbart register: vem som genomförde testet, när, vilka indata systemet flaggade och vad en människa granskade innan ett högriskavslag. SHRMs vägledning om kompetensbaserad rekrytering är tydlig på denna punkt: att kombinera kompetensbedömningar med blind utvärdering utvidgar talangpoolen och minskar bias, men bedömningar eliminerar det inte ensamma. Mänsklig granskning kvarstår som skyddsnät.
Den prediktiva utdelningen är verklig. Fast Company rapporterar att 90 % av arbetsgivare som använder kompetensbaserade bedömningar såg en minskning av felrekryteringar, och 91 % rapporterade förbättrad retention. Det är avkastningen på att göra designarbetet rätt.
Att omvandla bedömningspoäng till anställningsbeslut
En poäng är en datapunkt, inte ett domslut. Behandla den på det sättet så blir din rekryteringsprocess både snabbare och mer träffsäker.
- Kombinera bedömningspoäng med strukturerade intervjuer och referenskontroller. Ingen enskild evidenskälla bör ensamt bära ett anställningsbeslut, enligt vägledning om att använda bedömningsresultat. Bygg en dokumenterad beslutsmatris som viktar varje input innan någon börjar jämföra kandidater.
- Låt bedömare poängsätta självständigt innan gruppdiskussion. Förankringsbias smyger sig in snabbt när en bedömare uttrycker en åsikt högt.
- Genomför uppföljningar efter 30 och 90 dagar. Jämför bedömningspoäng mot faktisk arbetsprestation för att validera din rubrik och revidera den sedan. Det är här de flesta rekryteringsteam slutar, och det är det steget som faktiskt bevisar att bedömningen fungerar.
- Automatisera sortering, inte omdöme. AI-genererade sammanfattningar och snabba kandidatutvärderingsarbetsflöden snabbar upp granskning vid stora volymer, men det slutgiltiga beslutet om gränsfall bör stanna hos en människa.
Bedömningar som körs direkt efter ett inledande CV och strukturerad screening – inte före – fokuserar bedömarnas tid på kandidater som redan passerat ett första filter och respekterar allas tid i processen.
Varför rubriker spelar större roll än testet i sig
De flesta rekryteringsteam är besatta av bedömningsfrågan och knappt tittar på rubriken som poängsätter den. Det är bakvänt. Frågan är bara leveransmekanismen. Rubriken är det som gör resultatet försvarbart, jämförbart mellan kandidater och användbart tre månader senare när någon frågar varför en kandidat nekades.
Jag skulle hävda att det största misstaget i designen av öppna bedömningar inte är att välja fel leveranssätt – det är att hoppa över jobbanalysen och skriva en generisk uppgift för att det är snabbare. Ett generiskt kodpussel eller en standardiserad skrivuppgift säger dig nästan ingenting om hur någon kommer att prestera i din specifika roll. Vissa lösningar använder AI för att generera bedömningar kopplade till vad rollen faktiskt kräver snarare än en standardmall. Att kombinera det med AI-genererade sammanfattningar och anti-fusk-övervakning hjälper bedömare att lägga sin tid på omdömessamtal, inte administrativt städarbete.
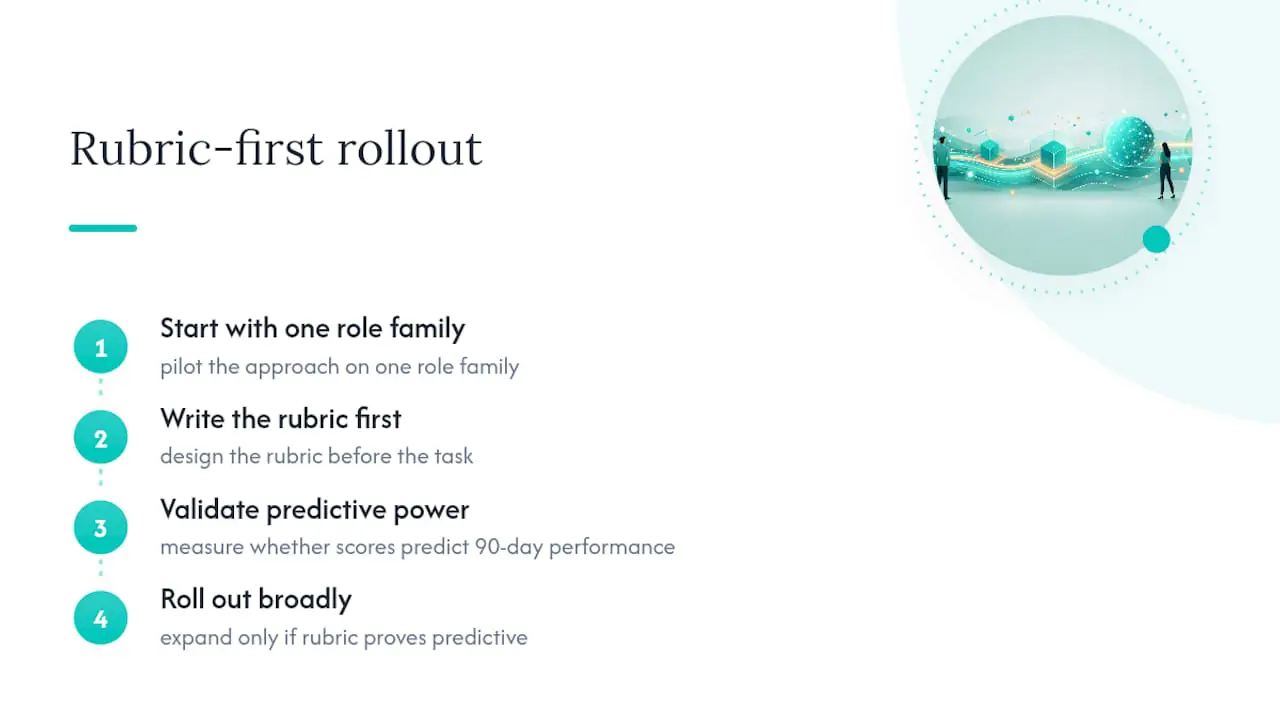
Börja med en rollgrupp. Skriv rubriken först. Mät om poäng förutsäger prestation efter 90 dagar innan du rullar ut tillvägagångssättet överallt annars.
— Jimmie
Kom igång med Talent Approveds kompetensbedömningar
Det finns plattformar byggda för det arbetsflöde som den här artikeln beskriver: rollspecifika bedömningar, genererade snabbt, poängsatta konsekvent. Vissa verktyg kan förvandla en jobbbeskrivning till ett skräddarsytt, tidsbegränsat arbetsprov på några minuter – utan behov av att återanvända generiska mallar för varje öppen tjänst.
Anti-fusk-övervakning och AI-genererade kandidatsammanfattningar sköter det tunga lyftandet vid granskning och låter ditt team fokusera på de omdömessamtal som faktiskt kräver en människa. Eftersom prissättningen körs som betala per användning för 5 USD per genomförd kandidat finns det inget prenumerationsåtagande som ligger och tickar på dina böcker mellan rekryteringscykler. Om du vill ha granskningsklara validitetsposter kopplade till varje bedömning ditt team kör ingår det i samma avgift på 5 USD. Kolla prissidan och kör din första bedömning på en öppen tjänst idag.
Källor
- Kompetens framför examensbevis: framtiden för rekrytering och organisatorisk tillväxt — Fast Company
- Kompetensbaserad rekrytering: att bygga starkare team med blind utvärdering — SHRM
- Rekryteringsprocess: en evidensbaserad guide — ScientificHiring
- Hur man strukturerar en kompetensbedömning för distansrekryteringar — Claude Library
Vanliga frågor
Vad är en öppen onlinebedömning i rekryteringssammanhang?
Det är ett tidsbegränsat, rollspecifikt test som genomförs på distans där kandidater får använda resurser som dokumentation eller sökverktyg – vilket speglar hur de faktiskt skulle utföra jobbet. Det mäter tillämpad kompetens snarare än memorerade kunskaper.
Hur lång tid bör en kandidatbedömning ta?
De flesta väldesignade bedömningar tar 30 till 90 minuter. Längre uppgifter riskerar att ge upphov till oro kring oavlönat arbete och lägre genomförandegrader utan att förbättra prediktiv noggrannhet.
När bör jag använda proctorerat istället för öppen bok-testning?
Välj proctorerad leverans för efterlevnads-, säkerhets- eller behörighetsroller där oassisterad prestation är den faktiska kompetens som mäts. Öppen bok fungerar bättre när jobbet i sig innebär research, dokumentation eller verktygsanvändning.
Ökar öppen bok-testning risken för fusk?
Det förskjuter risken snarare än att eliminera den, vilket är varför webbkameraövervakning, sessionsuppspelning och webbläsarlåsning finns som valfria lager. Tydligt samtycke och information innan sessionen spelar lika stor roll som verktygen i sig.
Hur mycket kostar Talent Approved per bedömning?
Talent Approved tar ut 5 USD per genomförd kandidatbedömning utan krav på prenumeration. Du betalar bara när en kandidat slutför testet.